

Python列表推导式替代for循环的写法与优势
深入讲解Python中如何使用列表推导式替代传统for循环,涵盖基础映射写法、条件分支处理、底层CPython字节码加速机理及工程选型边界。
一、基础改写:从命令式收集到声明式推导
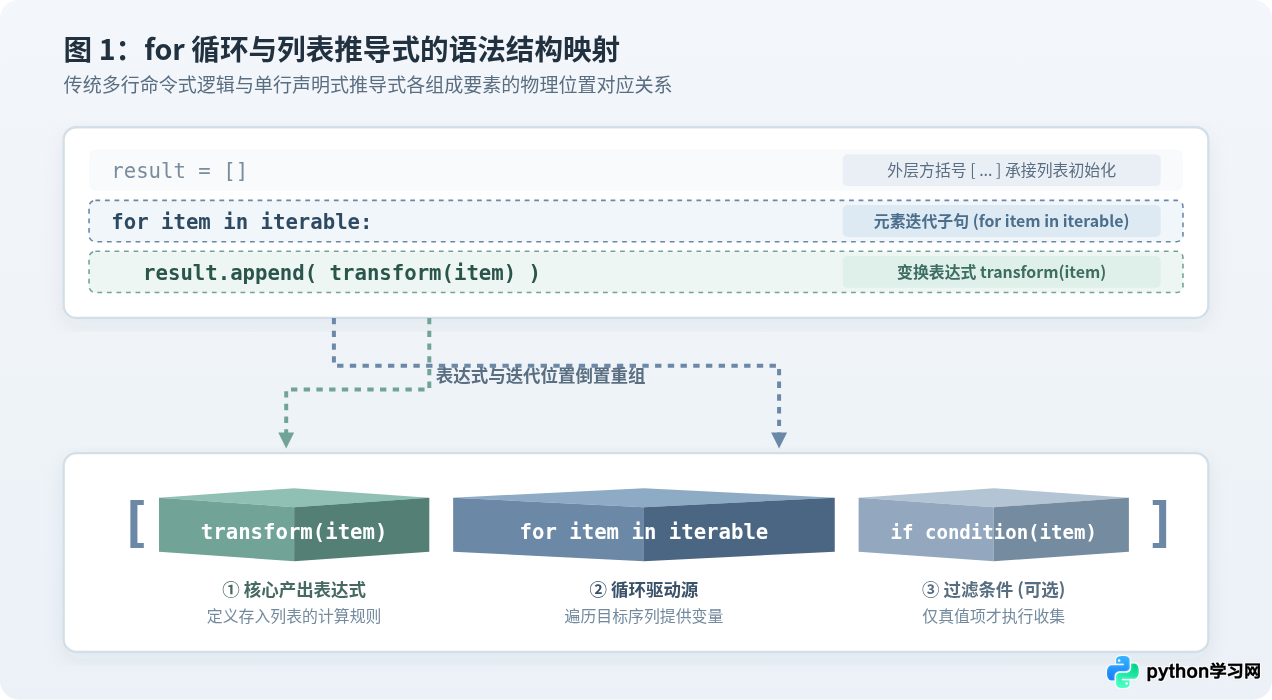
在传统的命令式编程习惯中,遍历已有序列并生成新列表通常需要三个独立步骤:显式声明空列表容器、启动 for 循环迭代元素、对元素运算后调用 list.append() 方法追加结果。这种写法步骤完整,但结构上较为松散,容器的初衷与赋值被分散在不同行中。
列表推导式则将这三步整合在外层的方括号 [...] 之中。其核心语法模式可概括为:
[表达式 for 变量 in 可迭代对象]以下示例展示如何将包含 5 个整数的序列,每个元素求平方并收集为新列表:
# 环境:Python 3.8+ 交互式终端或脚本环境
numbers = [1, 2, 3, 4, 5]

# --- 传统 for 循环写法 ---
squares_loop = []
for n in numbers:
    squares_loop.append(n ** 2)

# --- 列表推导式等价改写 ---
squares_comp = [n ** 2 for n in numbers]

print(f"循环结果: {squares_loop}")
print(f"推导结果: {squares_comp}")循环结果: [1, 4, 9, 16, 25]
推导结果: [1, 4, 9, 16, 25]
在改写时,阅读逻辑发生了一个微小但关键的变化:原先处于循环体内部的运算表达式(如 n ** 2)被提升到了推导式的最左侧,成为直观的“产出定义”,紧随其后的才是数据来源的驱动子句 for n in numbers。
二、带条件分支的改写:过滤与值转换
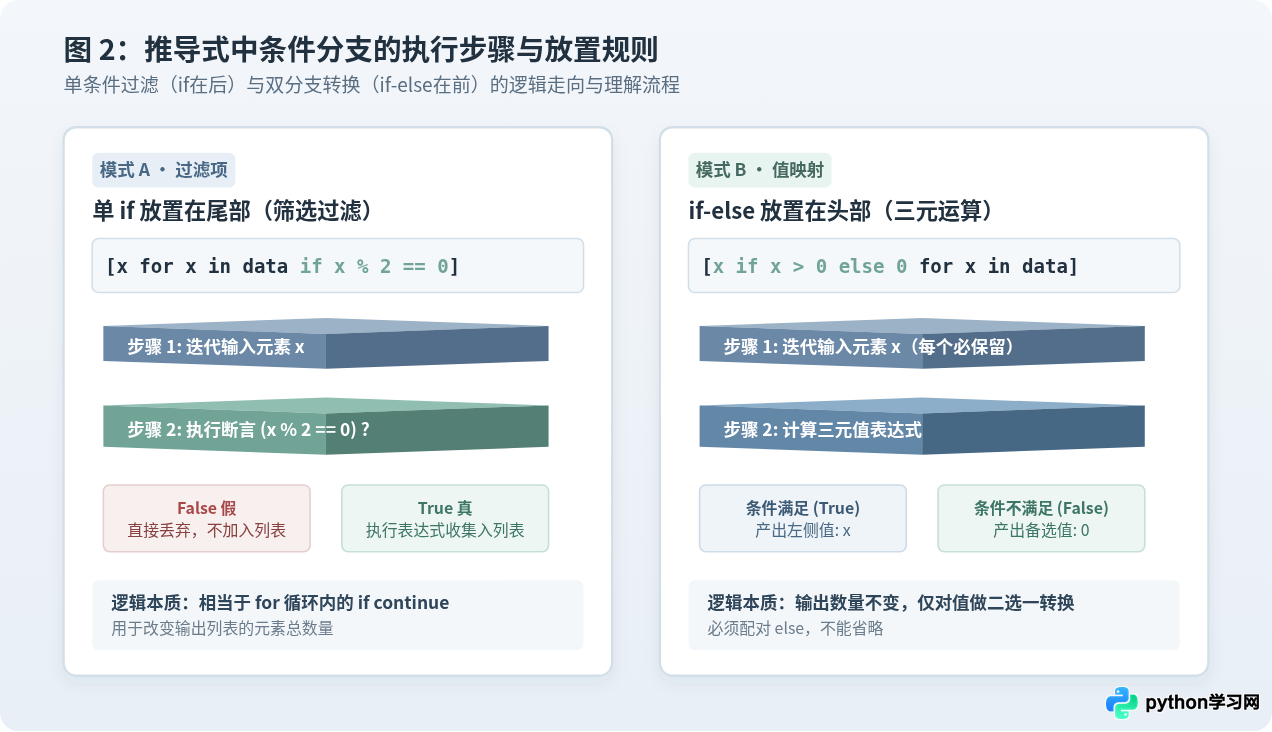
实际开发中,对列表项的收集往往伴随着条件判断。很多初学者在将带 if 的循环改写为列表推导式时,常困惑于 if 到底应该写在表达式前面还是后面。理解这一点的关键在于区分两类完全不同的业务意图:过滤元素(改变数量)与条件转换(改变取值)。
1. 仅过滤元素:单 if 放置在末尾
如果目标是从原数据中剔除不符合要求的元素,对应的传统逻辑是在循环内执行 if condition: append(...)。此时在列表推导式中,if 子句必须紧跟在 for ... in ... 的尾部。只有判断为真的元素才会执行最左侧的表达式并装入列表;假值项会被静默丢弃。
# 任务:仅提取偶数并求平方
raw_data = [12, 17, 24, 33, 40, 51]

# 列表推导式:单 if 过滤放置在尾部
even_squares = [x ** 2 for x in raw_data if x % 2 == 0]

print(f"过滤结果: {even_squares}")过滤结果: [144, 576, 1600]
2. 双分支取值转换:if-else 放置在表达式头部
如果目标是对原序列中的每一个元素都保留,但根据其数值正负或类别计算不同的产出值,本质上使用的是 Python 的三元条件表达式(Conditional Expression):val_true if cond else val_false。此时 if-else 必须整体作为左侧的产出表达式,而不能放置在推导式末尾。
# 任务:正数保留原值,负数或零替换为 0(元素总数保持不变)
scores = [85, -12, 92, 0, -5, 78]

# 列表推导式:三元表达式在头部
clamped = [s if s > 0 else 0 for s in scores]

print(f"转换结果: {clamped}")转换结果: [85, 0, 92, 0, 0, 78]
• 改变元素个数(挑出符合条件的项):写在末尾,单
if,不接 else。• 改变元素取值(个数不变,按条件二选一):写在开头,必须成对使用
x if cond else y。
3. 多层嵌套循环的扁平化改写
当处理二维表格或嵌套矩阵时,列表推导式支持书写多个 for 子句。多层嵌套的书写顺序必须与普通 for 循环从外向内的嵌套顺序完全一致:外层循环在前,内层循环紧随其后。
matrix = [
    [1, 2, 3],
    [4, 5, 6],
    [7, 8, 9]
]

# 将二维矩阵扁平化为一维列表
# 外层循环: for row in matrix
# 内层循环: for val in row
flattened = [val for row in matrix for val in row]

print(f"扁平化列表: {flattened}")扁平化列表: [1, 2, 3, 4, 5, 6, 7, 8, 9]
三、核心优势深度解析:不仅是语法糖
很多开发者初学列表推导式时,常以为它仅仅是减少了代码行数的“语法糖”。但在 Python 的底层实现与软件工程维护中,列表推导式具备显著的代码意图优势与解释器级别的性能优化。
1. 声明式语义与意图明确
传统的 for 循环是命令式的通用控制流结构,其内部可以执行网络请求、文件操作、状态修改或提前跳出(break)。当阅读一段包含 result = [] 和数十行 for 循环的代码时,读者必须通读每行语句才能确定循环的唯一目的只是“填充这个列表”。
而列表推导式是一种声明式构建方式。读者只要看到最外层的方括号 [...],就能在毫秒级建立心智模型:这段代码唯一且确定的产出就是构造一个全新的列表。这种明确的语义边界大幅降低了代码审阅时的认知负担。
2. CPython 字节码加速机制
列表推导式的执行效率普遍高于普通 for 循环,其加速关键并非减少了循环迭代次数,而是在于 CPython 虚拟机的指令差异。我们通过 Python 标准库自带的 dis 模块反编译两者的字节码:
import dis

def via_loop(items):
    res = []
    for x in items:
        res.append(x * 2)
    return res

def via_comprehension(items):
    return [x * 2 for x in items]
分析两者的字节码可以发现关键差异:
- 普通 for 循环的瓶颈:每一轮迭代都必须执行
LOAD_METHOD 'append'(查找列表对象的 append 方法属性),紧接着执行CALL_METHOD 1,这涉及创建 Python 函数调用帧并在完成后执行POP_TOP丢弃返回值None。即便单次查找微秒计,数万次累加后开销依然非常明显。 - 列表推导式的优化:CPython 编译器将推导式识别为专有构造,直接生成
BUILD_LIST和专用指令LIST_APPEND。该指令直接调用 C 语言内部的PyList_Append接口将元素推入底层 C 数组,完全绕过了 Python 层面的方法属性查表与函数调用栈。
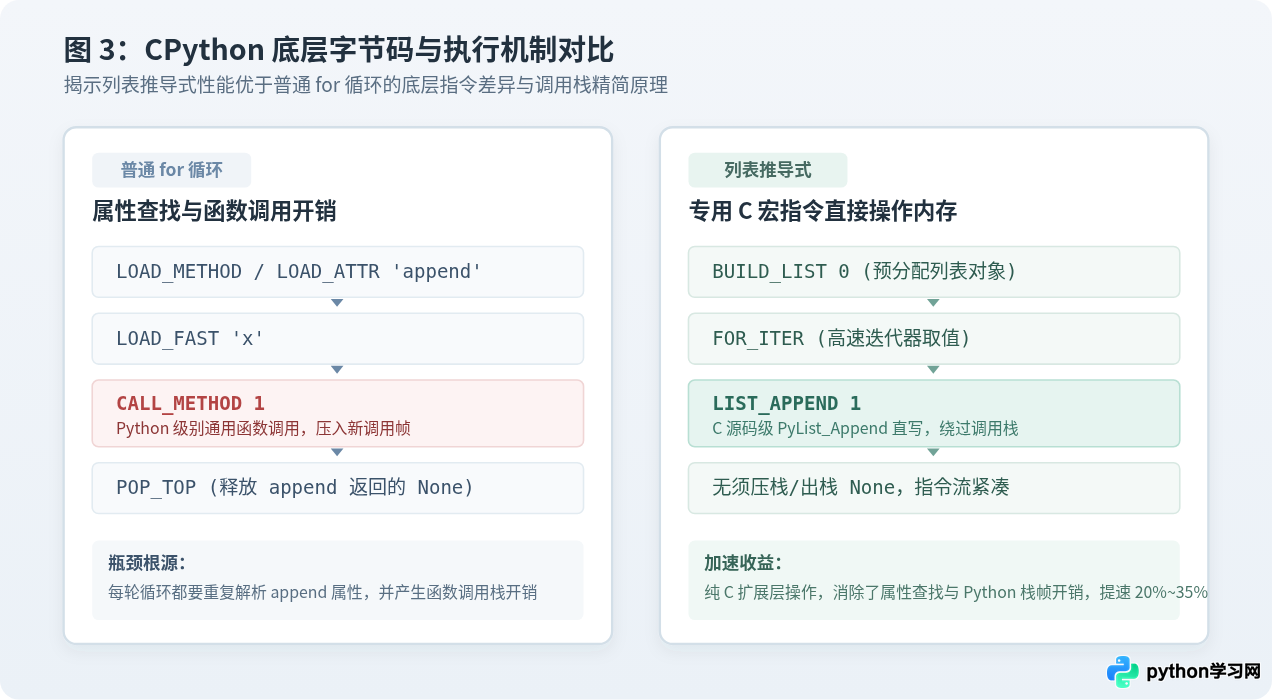
在基准测试中(处理长度为 1,000,000 的序列),列表推导式平均执行耗时约为 45ms,而普通 for 循环加 append() 约为 65ms,推导式整体提速在 30% 左右。
四、适用边界与工程陷阱:何时不该使用推导式
虽然列表推导式具备诸多优势,但盲目追求“单行化”是工程开发中常见的反模式。了解推导式的适用边界,才能在代码简洁度与健壮性之间取得平衡。
1. 具有副作用(Side Effects)的循环绝不能强行推导
列表推导式的设计契约是生产数据。如果一段遍历逻辑的核心任务是输出日志、写数据库或调用接口,并不需要生成新列表,强行使用推导式不仅会导致不必要的内存分配,还会混淆代码语义。
# 错误反模式:为了单行而使用推导式执行副作用(创建了一个无用的 None 列表)
[print(user.name) for user in users]   # 严禁此种写法!

# 正确做法:直接使用标准 for 循环,清晰表达动作意图
for user in users:
    print(user.name)
2. 嵌套超过两层或逻辑复杂时应及时拆解
当一个推导式包含多个嵌套 for、多层复杂的 if-elif-else 或者横向跨度超过百字符时,推导式的可读性将断崖式下跌。在团队开发中,清晰胜于聪明。此时应当退回标准 for 循环,或者将内部变换逻辑提取为纯函数。
3. 超大数据集下的内存考量:列表推导式 vs 生成器表达式
列表推导式采用及早求值(Eager Evaluation)策略,在执行完毕时必须在内存中分配完整的列表对象。如果待处理的数据流规模极大(例如读取数千万行日志,或无穷迭代),立即构建列表会造成内存峰值陡增甚至触发 OOM(Out Of Memory)。
如果后续代码仅需对这些数据进行单次顺序遍历(例如传给 sum()、max() 或写入文件),只需把外层的方括号 [...] 替换为圆括号 (...),即可转换为生成器表达式(Generator Expression)。生成器采用惰性求值(Lazy Evaluation),单项按需产出,内存占用恒定保持在 O(1)。
# 1. 列表推导式:立即占用约 80MB 内存
list_comp = [x * 2 for x in range(10_000_000)]

# 2. 生成器表达式:惰性求值,内存仅占 100 多字节
gen_expr = (x * 2 for x in range(10_000_000))
total_sum = sum(gen_expr)  # 流式累加,零内存压力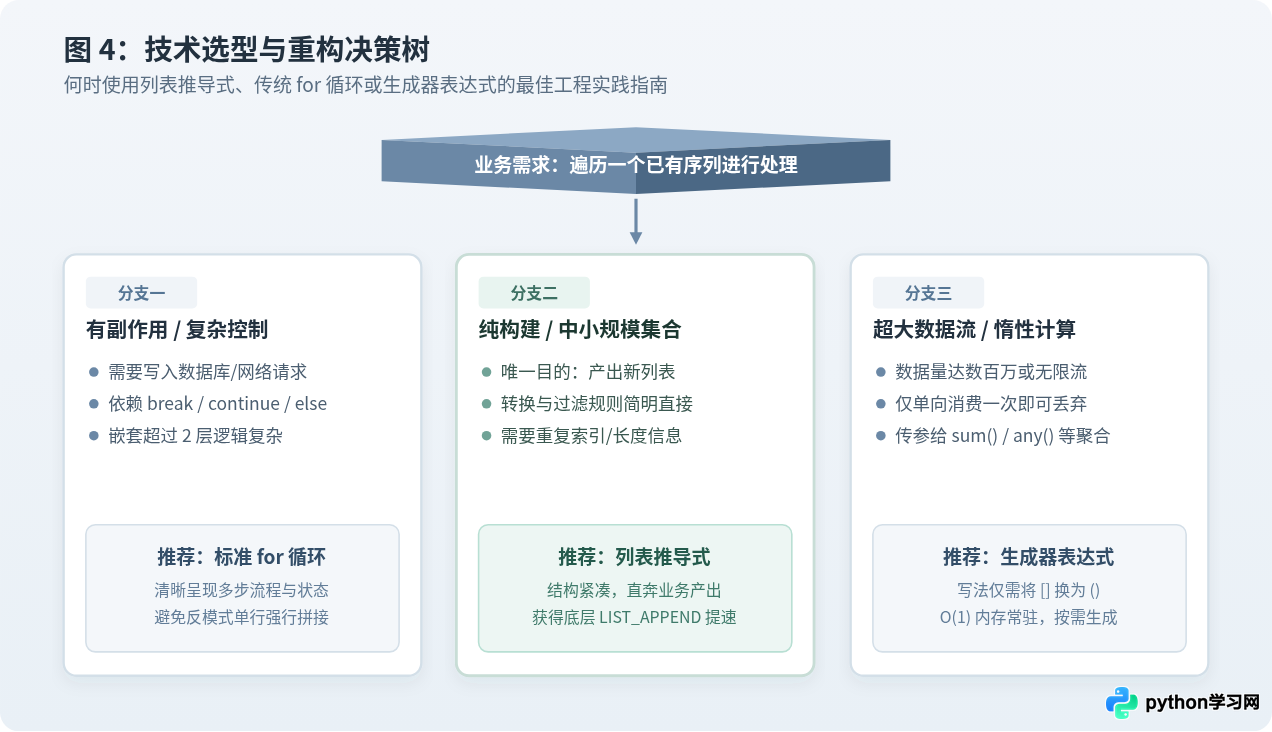
五、总结与工程速查
从传统的 for 循环过渡到列表推导式,是编写符合 Python 惯例(Pythonic)代码的重要里程碑。只要遵循清晰的语法映射与合理的边界约束,就能在提升工程优雅度的同时兼收执行性能收益。
| 场景需求 | 推荐实现模式 | 核心优势与关注点 |
|---|---|---|
| 单纯映射变换 | [f(x) for x in seq] |
代码压缩至单行,借助 LIST_APPEND 提速 20%~35% |
| 过滤挑选部分项 | [x for x in seq if cond(x)] |
单 if 位于尾部,逻辑相当于 if not cond: continue |
| 条件二选一映射 | [a if cond else b for x in seq] |
三元表达式位于头部,元素总量不变,成对使用 else |
| 含副作用或多分支 | 标准 for x in seq: ... |
优先保证逻辑可读性与调试便利性,杜绝反模式推导 |
| 超大数据单次遍历 | (f(x) for x in seq) |
仅替换括号,获得 O(1) 恒定内存占用的流式处理能力 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









