

Python自学路线规划:新手怎么分阶段高效学习
针对Python初学者容易陷入语法背诵与教程地狱的痛点,本文提供一份涵盖基础语法、标准库封装、方向突破与工程素养的四阶段高效自学路线规划及避坑指南。
假设你刚刚下载了 Python 解释器,照着网上的入门教程敲完了 print("Hello, World!"),随后翻开了一份长达数百集的视频合集或千页巨著。前几天的兴奋感很快会被无尽的语法细节磨灭:循环还没完全搞懂,后面又接踵而至面向对象、高阶装饰器、多线程与深层元类;每章的练习题照着抄都能运行,但一旦新建一个空白的 .py 文件准备做点什么,思路立刻卡壳。这种“看得懂代码却写不出东西”的现象,通常被称为自学者的“教程地狱(Tutorial Hell)”。
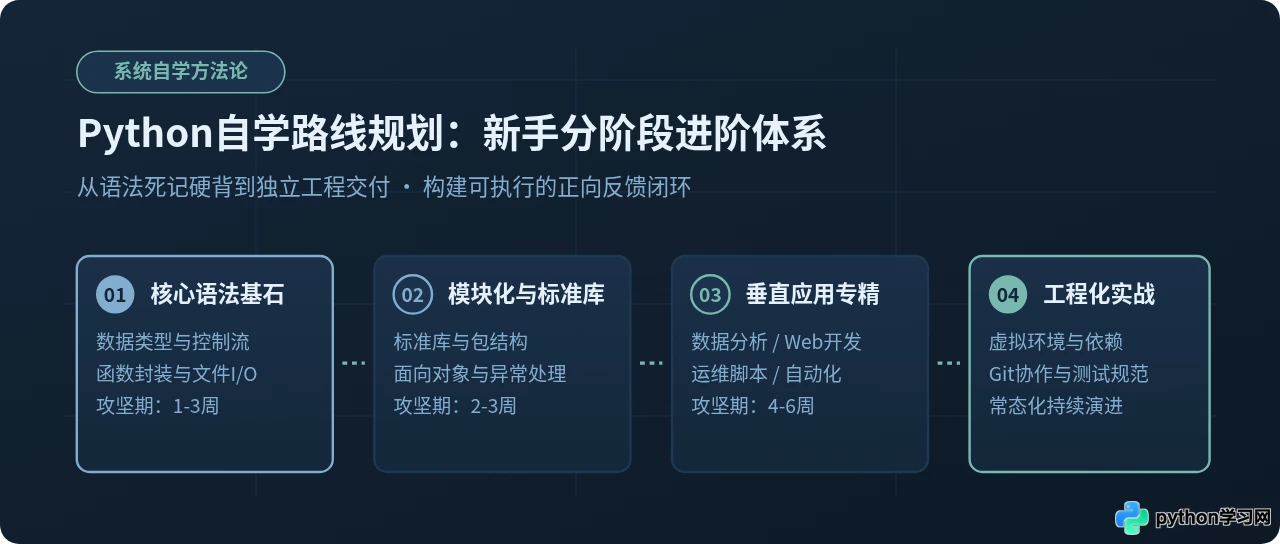
自学 Python 的高效路径绝不是把所有语言特性囫囵吞枣地过一遍,而是按能力阶段建立“学习-编码-验证-交付”的正向反馈闭环。本文将 Python 自学过程合理划分为四个清晰的进阶阶段,明确每个阶段的攻坚目标、验收标准与避坑指南,帮助初学者用最少的时间成本建立起真正能够用于解决实际问题的编程能力。
一、四阶段演进模型:明确每一步的交付物
学习编程类似于学习组装机械:新手不需要在第一天就掌握发动机的热力学原理,而应该先学会使用螺丝刀和扳手组装出一个能滚动的轮子。将 Python 自学分解为四个连续阶段,能够让你在每一个时间节点都清楚自己处于什么位置,以及学完当下的内容之后能做出什么具体成果。
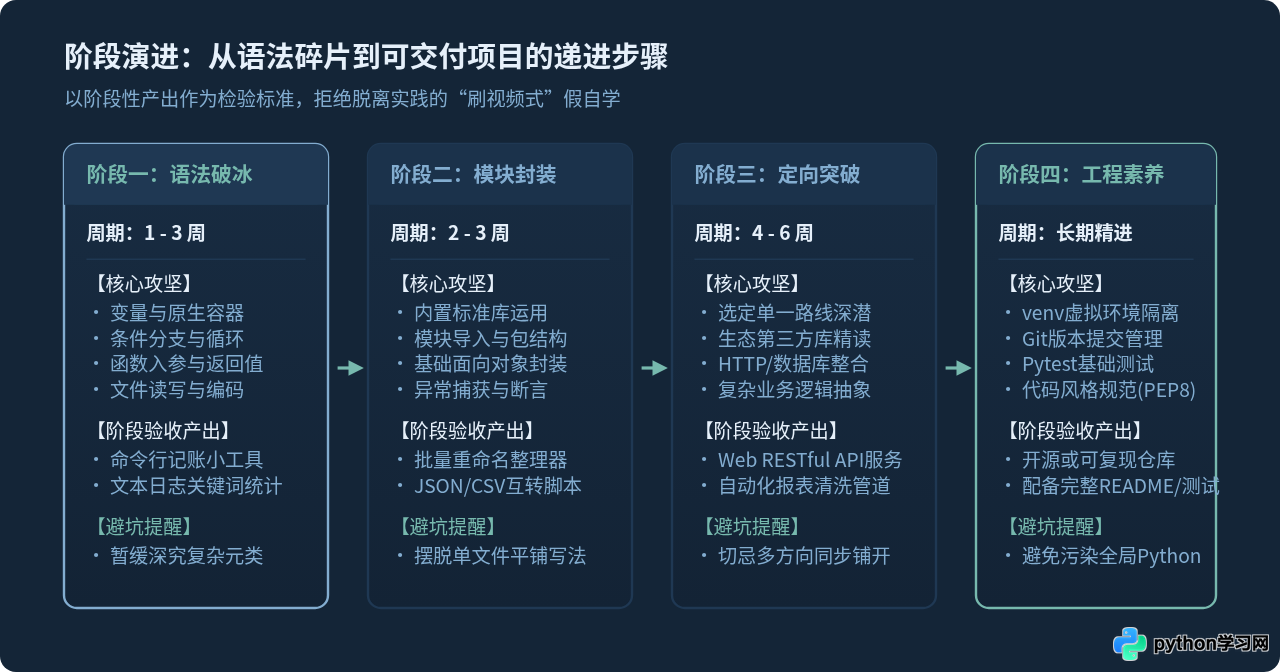
四个阶段的侧重点各不相同,切忌越级学习:
- 阶段一:语法破冰(1-3周)——掌握变量、基本数据类型、控制流、函数与基础文件读写。验收标准是能独立编写一个交互式控制台小工具或简单的文本过滤脚本。
- 阶段二:模块化与标准库(2-3周)——掌握标准库核心模块、异常处理机制及面向对象封装基础。验收标准是能够将代码拆解为多个文件,完成本地文件归档或格式互转任务。
- 阶段三:垂直应用专精(4-6周)——在数据分析、Web开发、自动化测试/网络采集等主流方向中挑选单一方向深耕,掌握该领域核心第三方库。验收标准是交付一个带业务逻辑的独立项目。
- 阶段四:工程素养与规范(长期)——补齐虚拟环境、Git版本管理、单元测试与代码格式规范。验收标准是代码具备可维护性,能够清晰呈现于版本仓库中。
二、第一阶段:核心语法与最小可行能力构建(1-3周)
这一阶段的目标是快速跨越语法门槛,建立计算机“输入-处理-输出”的逻辑直觉。新手最容易犯的错误是一开始就试图背完所有语法点。实际上,日常 80% 的脚本开发只依赖不到 20% 的核心语法。
1. 本阶段必须重点掌握的内容
- 基础数据类型与运算:整数(
int)、浮点数(float)、字符串(str)和布尔值(bool),理解类型转换的原理。 - 原生数据结构(核心重点):列表(
list)的增删查改与切片、字典(dict)的键值映射与查找、元组(tuple)的不可变性以及集合(set)的去重特性。 - 控制流程:
if / elif / else条件分支逻辑,for循环(尤其是配合range()和迭代容器)与while条件循环,以及break / continue的边界控制。 - 函数封装:函数的定义(
def)、位置参数与默认参数、返回值(return)的作用域边界。 - 基础文件读写:使用
with open(...)上下文管理器安全读写纯文本文件,理解文件编码(如encoding="utf-8")的重要性。
2. 本阶段应主动跳过的内容
3. 阶段一验收实操:简易服务器日志过滤器
学完第一阶段后,你应该能够脱离教程,独立写出类似下面这样的文本解析脚本。代码从文本读取多行日志,统计出现 ERROR 的频次并将结果保存到新文件:
# parse_log.py: 统计日志中错误级别并提取对应信息
def filter_errors(input_file: str, output_file: str):
    error_count = 0
    collected_errors = []

    # 使用 with 语句确保文件操作完成后自动关闭句柄
    with open(input_file, "r", encoding="utf-8") as f:
        for line in f:
            if "ERROR" in line:
                error_count += 1
                collected_errors.append(line.strip())

    # 将提取到的错误记录单独输出
    with open(output_file, "w", encoding="utf-8") as out:
        out.write(f"Total Errors Found: {error_count}
")
        for err in collected_errors:
            out.write(err + "
")

    print(f"处理完成,共发现 {error_count} 处错误已写入 {output_file}")

# 测试调用(确保同目录下存在 server.log 样本文件)
if __name__ == "__main__":
    filter_errors("server.log", "error_summary.txt")
三、第二阶段:从零散脚本到模块化编程(2-3周)
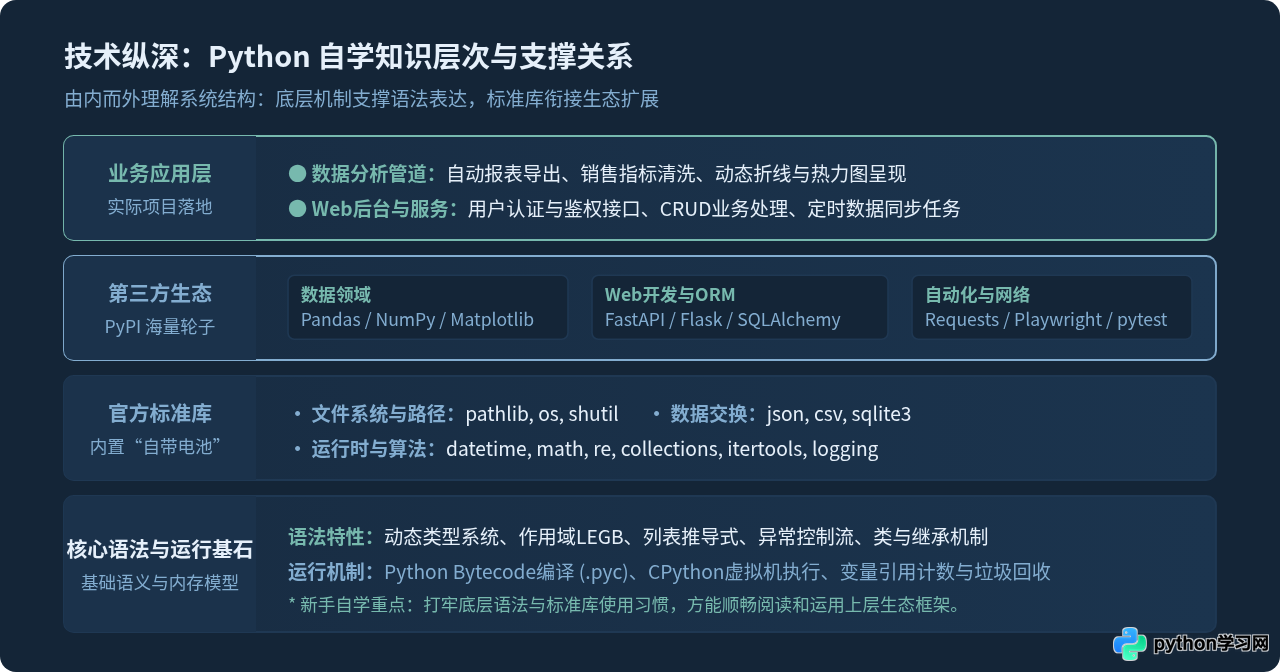
完成了第一阶段后,初学者往往会写出一种代码:所有的变量和函数全部平铺在同一个长达数百行的 main.py 脚本里。这种代码一旦逻辑变复杂,就会极难维护和调试。第二阶段的核心任务是学会利用 Python 内置的“自带电池(Batteries Included)”,并将逻辑组织为清晰的模块与类。
1. 重点挖掘的核心标准库
很多新手在需要操作文件或时间时,第一反应是上网搜第三方包安装,这往往走入了弯路。Python 官方标准库功能极其强大且无需额外安装配置:
pathlib:取代老旧的os.path,使用面向对象的方式处理路径拼接、文件遍历与后缀判断。json与csv:解析结构化数据交换格式的标准工具。datetime:时间戳获取、日期计算与字符串格式化(strftime / strptime)。collections:提供比原生字典更丰富的容器,如defaultdict(避免键不存在的 KeyError)和Counter(高频计数器)。re:正则表达式库,用于从杂乱文本中匹配邮箱、手机号或特定模式字符串。
2. 建立模块化与面向对象认知
在这个阶段,开始理解并实践面向对象编程(OOP)。重点不是背诵概念术语,而是掌握“数据与行为的绑定”:
- 类的基本定义:通过
class组织相关数据与方法,理解__init__构造函数和self的具体含义。 - 异常防御:用
try ... except SpecificError ... finally替代让程序直接崩溃报错的裸奔写法,学会捕获特定的异常类型。 - 多文件组织:将业务拆分为
config.py、parser.py和main.py,通过import互相调用,并养成在入口文件中加入if __name__ == "__main__":的规范习惯。
四、第三阶段:方向分化与生态深潜(4-6周)
进入第三阶段,意味着你已经具备了通用的 Python 编程能力。此时绝对不要试图把“爬虫、数据分析、Web开发、自动化运维、人工智能”全部学一遍,这种广而不深的学习方式是导致新手放弃的最常见诱因。
正确的策略是:根据当前工作痛点或明确的求职/项目目标,选择单一垂直分支,集中精力完成一个有业务意义的中型项目。
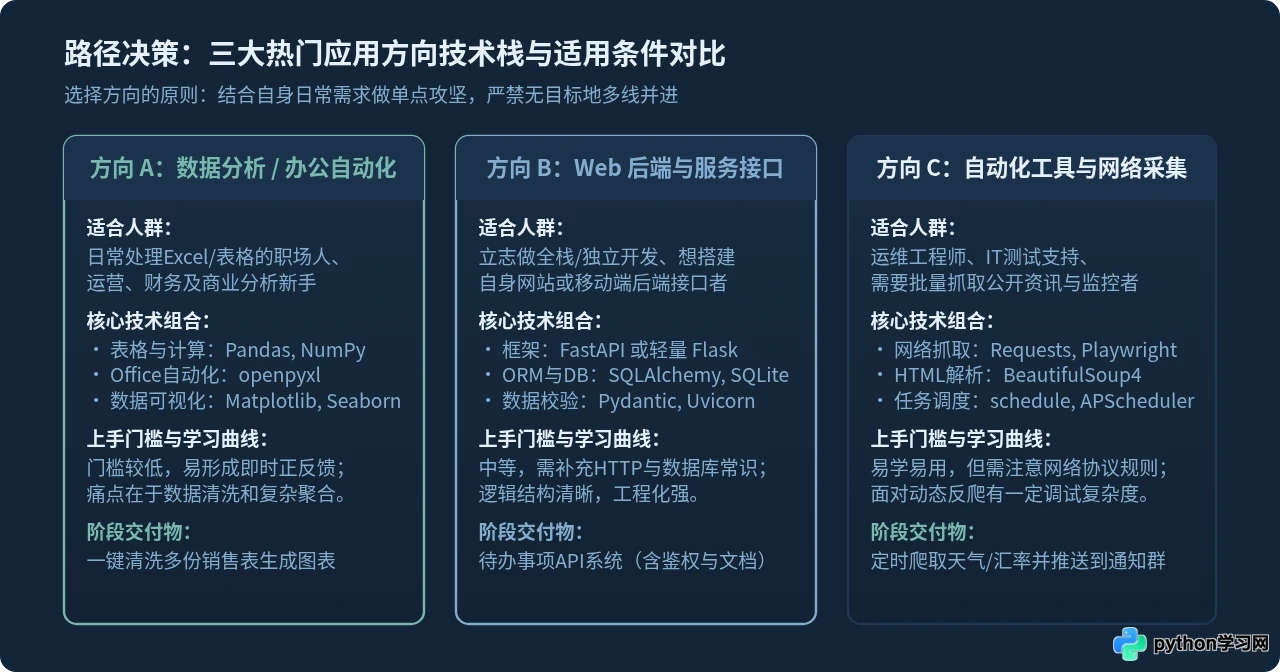
1. 三大主流方向选型指南
| 学习方向 | 典型应用场景 | 核心第三方库 | 阶段成果指标 |
|---|---|---|---|
| 数据分析 / 自动化 | 运营报表汇总、财务对账、批量Excel处理、销售走势分析 | Pandas, NumPy, openpyxl, Matplotlib | 编写自动化脚本,将分散的多个CSV/Excel数据聚合清洗并输出可视化图表。 |
| Web 后端开发 | 为前端或移动端提供 RESTful API,开发管理后台、内部系统 | FastAPI 或 Flask, SQLAlchemy, Pydantic, Uvicorn | 独立设计并交付一个具备数据库增删改查、JWT用户身份认证的接口服务。 |
| 网络采集 / 自动化运维 | 日常巡检报警、竞品公开价格追踪、跨系统数据同步 | Requests, Playwright, BeautifulSoup4, schedule | 实现一个带重试机制、反爬解析以及定时通知(如飞书/钉钉机器人)的数据抓取机器人。 |
2. 选型后的落地策略
无论选定哪个方向,都不要沉溺于按部就班看书。建议采用“逆向工程法”:找一个行业成熟项目的开源源码或经典案例模板,尝试读懂其项目目录结构,然后不看源码,从零重新实现一遍相同功能。在这个过程中遇到的报错和查阅官方文档的经历,其吸收效率远胜于被动阅读。
五、第四阶段:工程化素养与规范闭环(持续精进)
能够写出运行成功的代码只是第一步,能让代码在不同计算机上稳定复现、长期维护,靠的是工程化素养。很多初学者在换了一台电脑后,原本的代码就报错崩溃,根本原因在于缺乏环境与依赖管理意识。
1. 新手必须建立的四大工程规范
- 虚拟环境隔离(venv):永远不要把第三方包全部
pip install安装到操作系统的全局环境中。每个项目都应当拥有独立的虚拟环境:# 在当前项目根目录下创建虚拟环境 python -m venv .venv # 激活虚拟环境 (macOS/Linux) source .venv/bin/activate # 激活虚拟环境 (Windows PowerShell) # .venv\Scripts\Activate.ps1 # 导出与还原项目依赖 pip freeze > requirements.txt pip install -r requirements.txt - 版本控制习惯(Git):养成小步提交(Commit)的习惯。每当完成一个小功能或修复一个 Bug 时进行一次记录,而不是在项目结束时一锅端提交。编写清晰的提交说明,让代码变更历史可追溯。
- 代码风格规范(PEP 8):保持一致的缩进(4个空格)、符合规范的命名(函数和变量使用
snake_case,类名使用CamelCase)。可以借助工具flake8进行静态检查,或者使用black自动格式化。 - 基础单元测试(pytest):开始为关键的业务处理函数编写测试用例。测试不仅能够保证当前代码逻辑正确,更能防止你在后续重构时无意破坏原有功能。
六、高效自学方法论:构建正向反馈闭环
为什么很多人反复拿起入门教程却始终学不会?根本原因在于缺乏及时的正向反馈。如果在学了两个星期后,所学的内容依然停留在“在终端打印两行星星符号”,大脑就会自然产生疲倦与排斥。
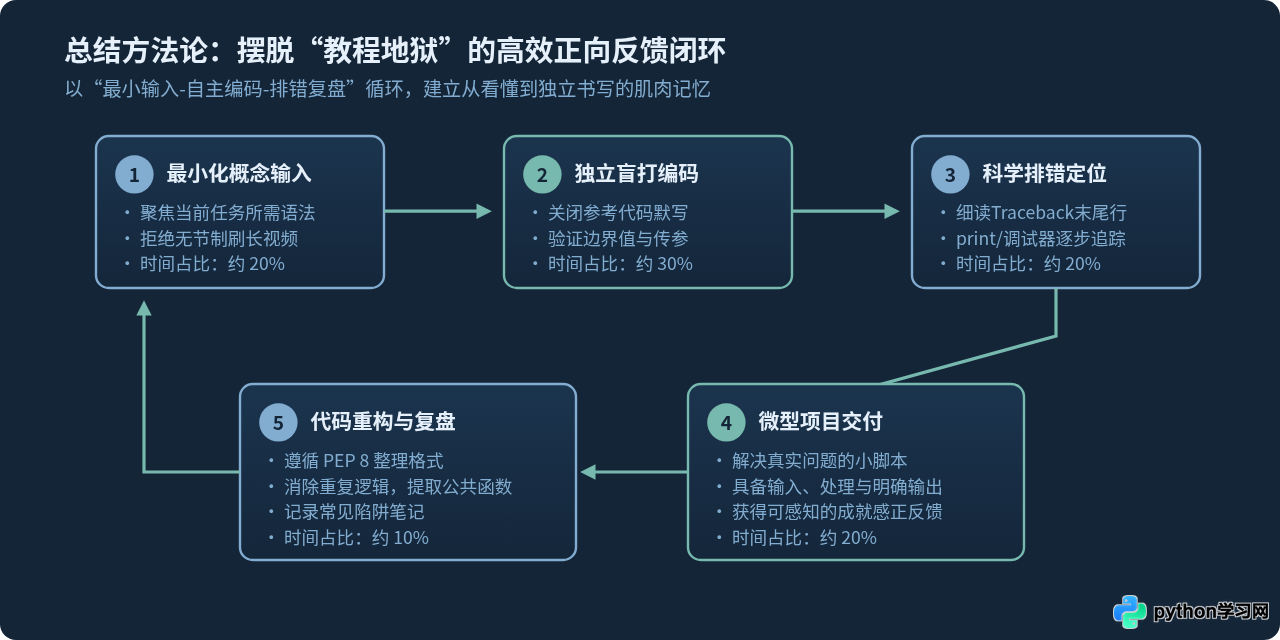
1. 落实“5:5 输入输出法则”
当你花 1 个小时阅读文档或观看教学内容时,必须紧接着安排至少 1 个小时用于独立编写代码。所谓的独立编写,是指合上教程、关掉示例代码窗口,只凭记忆和思考在编辑器里敲出能够运行的代码。如果遇到卡壳,只允许回到文档查阅函数参数,严禁直接复制粘贴整段答案。
2. 科学排查报错(Traceback)的四步法
很多新手一看到终端弹出一长串红色的报错信息就会产生慌乱情绪,甚至直接放弃。实际上,Python 的 Traceback 是世界上最友好的排错提示:
- 第一步:直接看最后一行。报错类型(如
KeyError,TypeError,FileNotFoundError)以及具体的错误原因总是在最底部。 - 第二步:自下往上找到第一个属于你自己的代码文件与行号。框架库底层的报错通常是由你传入的非法参数引发的。
- 第三步:在可疑行前后添加
print()或断点。核实此时变量的实际类型和数值是否符合预期(例如判断是否把字符串传给了需要整数的函数)。 - 第四步:精确定位关键词检索。如果无法直观解决,将最后一行的错误提示脱敏后放入搜索引擎或官方文档查找,切忌无目的地盲目改动代码。
3. 学习路径总览与行动清单
总而言之,学习 Python 不是一场看谁背得快的记忆力比赛,而是一次把抽象逻辑转化为实用工具的技能构建过程。从最简单的文本脚本起步,逐步掌握标准库封装,果断选定一个能解决日常实际问题的应用方向,最后以工程化标准来规范项目代码。按照这套分阶段的路径持续迭代,你就能够摆脱无休止的从头入门,真正建立起独立用代码解决问题的核心能力。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









