

Python爬虫能自动完成哪些日常网络任务
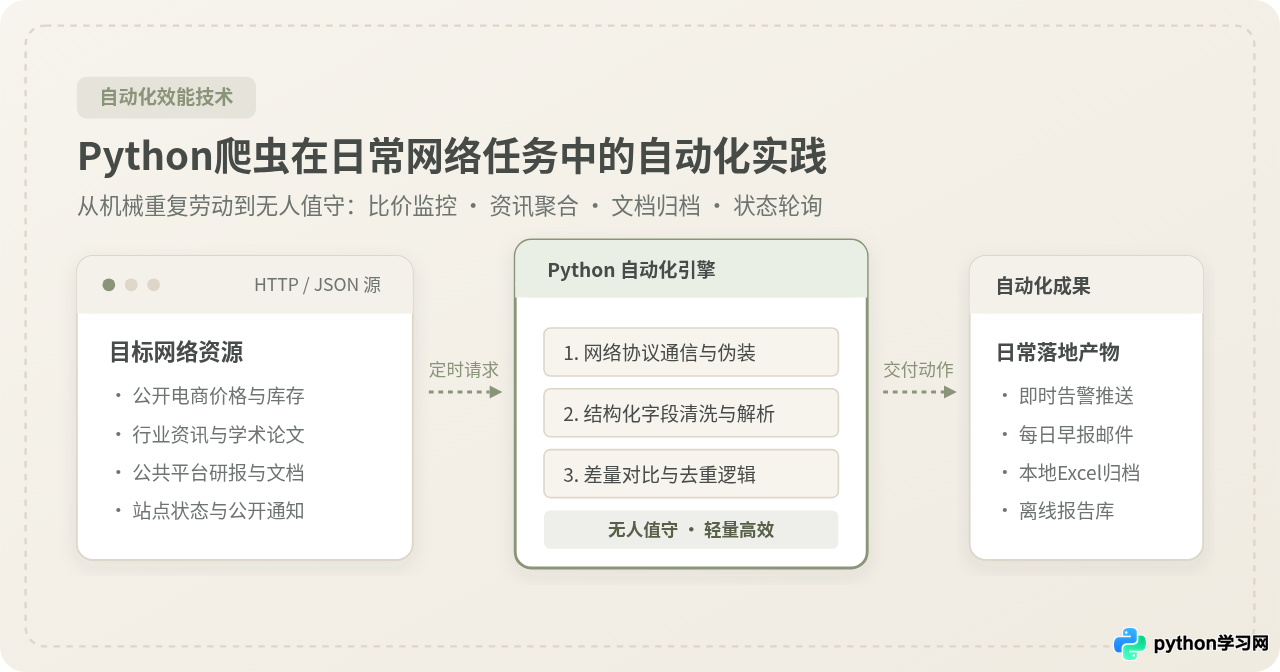
系统介绍Python爬虫如何自动化处理日常网络中的机械重复任务,涵盖价格监测、资讯聚合、文件归档、状态巡检四大场景,以及技术实现步骤与常见认知误区辨析。
Python 爬虫的核心价值在于将人在浏览器里的机械重复操作——比如定期刷新页面、跨站复制对比、批量点击下载与盯盘巡检——转化为轻量稳定的代码程序。凡是具有固定访问规律且面向公开网络的数据流,都可以通过 Python 自动化完成抓取、清洗、判别与转存。本文梳理日常工作与生活中落地门槛最低的四大典型任务,拆解从接口抓包到常驻调度的完整实施链路,并厘清容易混淆的技术误区与合规边界。
一、日常网络任务的四大典型自动化场景
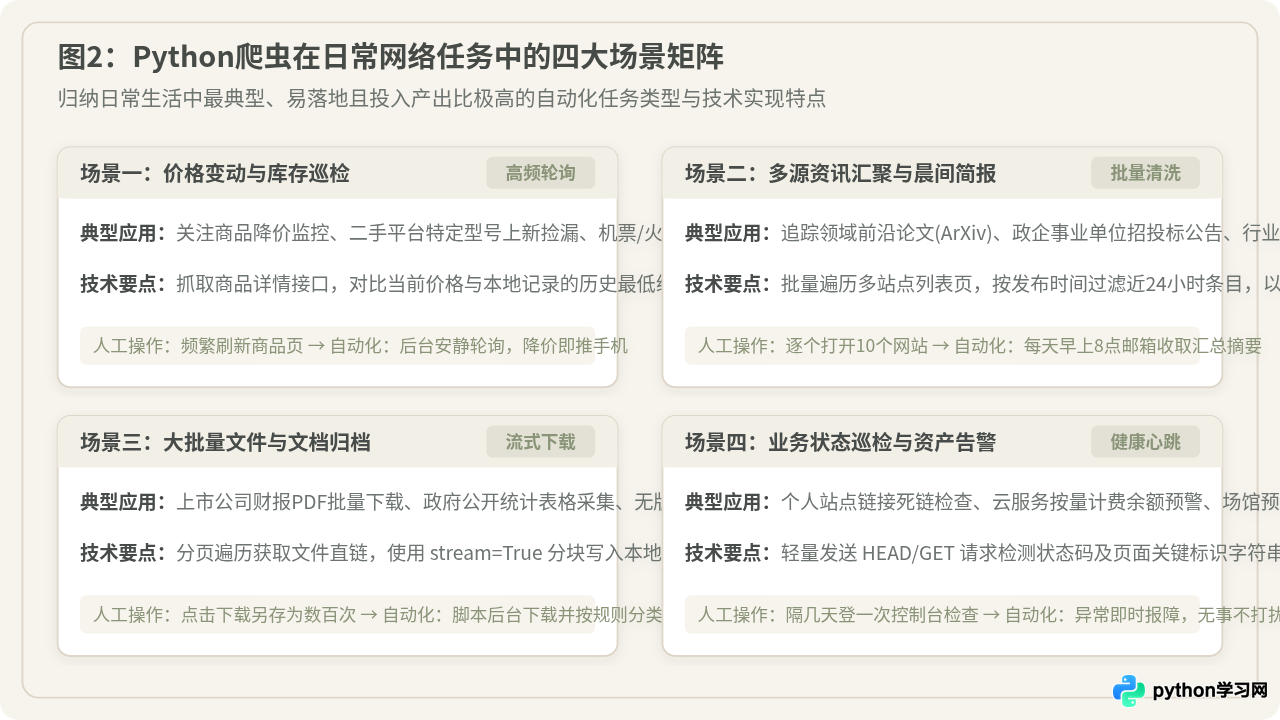
在不涉及高并发与复杂逆向的日常个人应用中,爬虫并不需要庞大的分布式集群。只要几十行简洁的 Python 脚本,配合系统的计划任务,就能解决大量耗费精力的琐碎工作。结合实践中的高频诉求,最适宜交由爬虫自动化处理的任务集中在以下四个方向:
1. 价格变动与库存监控 变动差量对比
购物时人工盯盘往往费时费力。通过定时向电商平台、二手闲置交易区或差旅票务接口发送轻量请求,爬虫能够精确解析出当前标价与余票数量。
- 心仪数码/家电降价提醒:记录商品历史价格,当价格低于预设心理阈值时,自动向手机发送即时通知。
- 二手平台特定商品捡漏:设定搜索关键词与价格区间,脚本每隔 15 分钟巡检一次,第一时间捕捉新上架的低价个人转让商品。
- 退票与候补票余量轮询:在特定节假日出行时,定时查询直达车次余票状态,出现余量即刻推送信鸽或邮件。
2. 多源信息聚合与定制早报 跨源批量清洗
当需要每天浏览十几个互不相通的网站获取行业动态时,在各个网页间频繁切换会耗费大量注意力。
- 领域前沿论文追踪:定时抓取 arXiv、PubMed 或专业预印本平台特定分类下的新论文,提取标题、摘要与 PDF 链接,过滤出包含目标关键词的文献。
- 政企事业单位招投标与招聘公告:很多地方人事考试网、教育局或企事业单位官网不提供邮件订阅。爬虫可在每日清晨抓取列表第一页,比对更新日期,汇总新公告。
- 垂直行业快讯与博客聚合:替代日渐式微的 RSS,将不提供订阅源的优质自媒体博客统一收拢,排版为一份晨间 Markdown 或 HTML 简报投递到个人邮箱。
3. 批量多媒体与结构化文档归档 流式下载存储
人工手动“右键另存为”数十次甚至上百次极易遗漏且效率低下。爬虫能够自主完成分页遍历,保持统一规范的文件命名并进行本地分类整理。
- 上市公司财报与行业研报归档:在证券公开信息披露平台或券商研报库,按股票代码或行业标签自动化下载近五年的年度报告与分析 PDF。
- 公共统计数据与开放表格抓取:将分散在多页 HTML 静态表格中的城市统计指标、天气历史数据逐页解析并拼接合并为一个干净的本地 CSV/Excel 文件。
- 设计素材与无版权图库整理:按指定分辨率与分类标签,批量采集免版税壁纸库或图表素材,按标签自动建立归档子目录。
4. 站点服务状态巡检与个人资产预警 健康心跳检查
针对开发者或网站站长,无需付费采购第三方商业监控套件,利用极简爬虫即可完成日常站务巡检。
- 个人博客与站点死链扫描:递归抓取自己博客的所有文章页面,探测所有外链的 HTTP 响应码,挑出返回 404 或超时的失效链接以便修正。
- 云服务按量计费余额与 SSL 证书过期预警:定时请求控制台概览接口,提取账户账户可用金余额及域名证书的剩余天数,防止因遗忘充值或断更证书造成服务瘫痪。
- 公共场馆预约号源状态刷新:监控图书馆研讨室、体育场馆公开预约页面的开放状态,释放名额时第一时间获取反馈。
二、容易混淆的常见认知误区与技术辨析
在初次尝试用爬虫解决日常问题时,初学者往往会受到网络流行碎片教程的影响,产生一些典型误区。这些看法在特定场景下有其由头,但如果生搬硬套到日常网络任务中,往往会导致方案过重、稳定性差或难以长期维护。
误区辨析一:“只要页面是动态加载的,就必须启动无头浏览器(Selenium / Playwright)”
<div id="app"></div>,直接用 requests.get() 获取到的页面完全看不到目标文字或数字。初学者很容易得出结论:必须运行一个完整的浏览器把 JS 执行完毕,才能提取内容。
F12 打开浏览器开发者工具,在 Network(网络) 面板中筛选 Fetch/XHR,往往能直接发现返回结构极其清晰的标准 JSON 接口。直接向该接口发起请求,响应速度在百毫秒以内,内存消耗不到 20MB,解析逻辑也从复杂的 DOM 提取转变为直接读取字典字段,稳定性和优雅度远高于浏览器模拟方案。
误区辨析二:“写爬虫的核心难点在于编写精确的 HTML 解析选择器”
<tr> 下的 <td>。初学者自然以为“只要能准确定位标签,爬虫就算写成了”。
try...except、默认空值保护)就会直接崩溃退出;而在无人值守阶段,偶尔发生的公网丢包、连接超时(Timeout)、目标站临时 502 错误若没有配合指数退避重试,程序也会立刻抛出异常中断。此外,请求头的完善程度(合理设置 User-Agent、Referer)以及请求频率控制(避免对服务器造成瞬时突增压力),才是保障脚本长期可用、不被拦截的主因。
三、从零构建日常爬虫任务的实施步骤
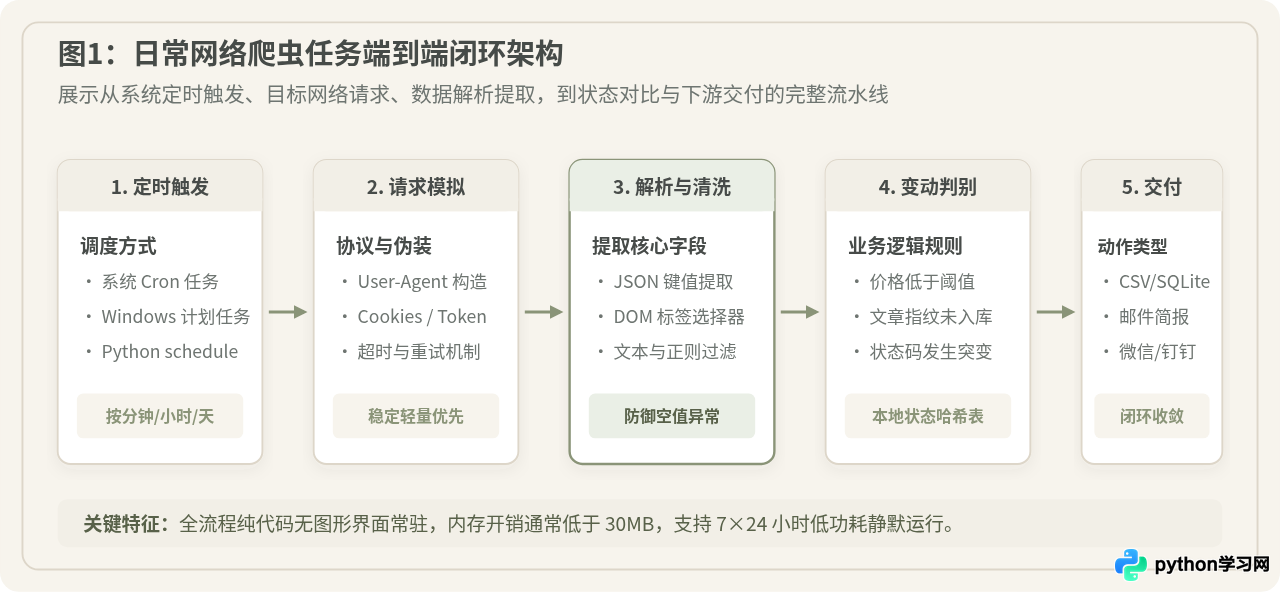
要实现一个可靠的日常网络自动化任务,工程流程可以标准化为五个步骤。下面以一个实际常见任务——“每天早上自动获取关注技术专栏最新文章,过滤出包含目标关键词的更新,存入本地数据库并发送邮件/推送”为例,展示完整的工程实现脉络。
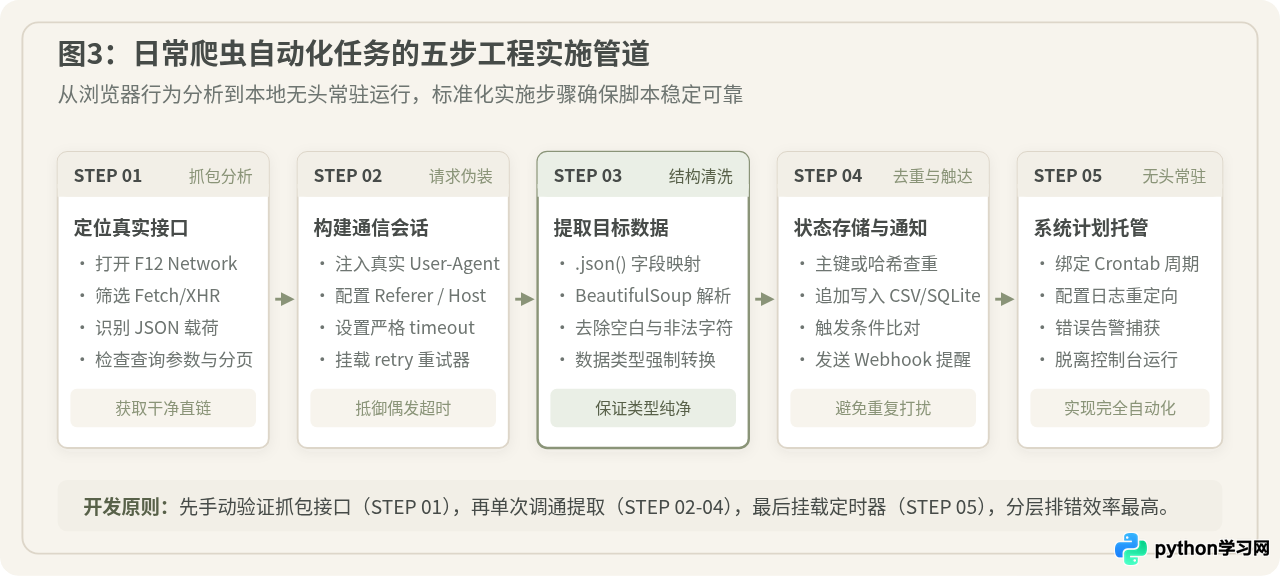
步骤一:浏览器 DevTools 抓包定位数据源
在 Chrome 或 Edge 浏览器中访问目标页面,按 F12 打开开发者工具,切换到 Network 标签页,并勾选 Fetch/XHR 过滤器。刷新网页或触发一次分页加载,观察列表中新出现的网络请求。
逐一检查请求的 Response 内容,找到包含所需文章标题、链接与时间戳的请求。在请求详情中记录下目标 Request URL、请求方法(通常为 GET 或 POST)、Query String 参数以及必要的前端请求头。
步骤二:构建稳健的网络请求会话(Session & Retry)
直接使用裸 requests.get(url) 往往存在两个隐患:一是没有设置浏览器常用的 User-Agent,容易被对端网关直接以 403 阻断;二是遇到网络波动时没有超时机制,导致进程无限期挂起。
在 Python 中,最佳做法是初始化一个带连接池的 requests.Session(),统一挂载现代浏览器的通用 Header,并使用 urllib3.util.retry.Retry 配置网络级自动重试。
import time
import hashlib
import sqlite3
import requests
from urllib3.util.retry import Retry
from requests.adapters import HTTPAdapter

def create_resilient_session() -> requests.Session:
    # 创建具备自动重试与标准请求头的网络会话
    session = requests.Session()
    # 模拟通用桌面浏览器头部,避免被识别为默认的 Python-requests 用户代理
    session.headers.update({
        "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) "
                      "AppleWebKit/537.36 (KHTML, like Gecko) "
                      "Chrome/124.0.0.0 Safari/537.36",
        "Accept": "application/json, text/plain, */*",
        "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8",
    })
    # 遇到 500/502/503/504 等偶发服务器错误时,最多重试 3 次,间隔指数增长
    retries = Retry(total=3, backoff_factor=1, status_forcelist=[500, 502, 503, 504])
    adapter = HTTPAdapter(max_retries=retries)
    session.mount("http://", adapter)
    session.mount("https://", adapter)
    return session

def init_local_database(db_path: str = "tasks_record.db"):
    # 初始化本地状态记录库,避免重复提醒或录入
    with sqlite3.connect(db_path) as conn:
        conn.execute("""
            CREATE TABLE IF NOT EXISTS processed_items (
                item_hash TEXT PRIMARY KEY,
                title TEXT,
                url TEXT,
                created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP
            )
        """)
        conn.commit()

def is_item_seen(item_hash: str, db_path: str = "tasks_record.db") -> bool:
    # 检查条目是否已被处理过
    with sqlite3.connect(db_path) as conn:
        cursor = conn.cursor()
        cursor.execute("SELECT 1 FROM processed_items WHERE item_hash = ?", (item_hash,))
        return cursor.fetchone() is not None

def record_item(item_hash: str, title: str, url: str, db_path: str = "tasks_record.db"):
    # 持久化新处理的条目
    with sqlite3.connect(db_path) as conn:
        conn.execute(
            "INSERT INTO processed_items (item_hash, title, url) VALUES (?, ?, ?)",
            (item_hash, title, url)
        )
        conn.commit()
步骤三:数据解析与清洗提取
如果是 JSON 接口,直接调用 response.json() 得到字典或列表结构。在提取字段时,务必使用 .get() 语法提供默认缺省值,规避因某个单独条目缺少键而抛出 KeyError 导致整个流程崩溃:
def fetch_and_filter_news(session: requests.Session, target_keyword: str):
    # 请求数据接口并根据业务关键词过滤
    # 示例模拟公开接口 URL,实际应用中替换为第一步抓取的 API
    api_url = "https://api.example.com/public/articles?page=1&limit=20"

    try:
        # 设置严格的连接和读取超时(connect: 5s, read: 10s)
        resp = session.get(api_url, timeout=(5.0, 10.0))
        resp.raise_for_status()
        data = resp.json()
    except requests.exceptions.RequestException as e:
        print(f"[网络异常] 请求接口失败: {e}")
        return []

    articles = data.get("items", [])
    matched_results = []

    for article in articles:
        title = article.get("title", "").strip()
        link = article.get("url", "")
        # 生成唯一哈希指纹,防止重复推送
        item_fingerprint = hashlib.md5(link.encode("utf-8")).hexdigest()

        if target_keyword in title and not is_item_seen(item_fingerprint):
            matched_results.append({
                "hash": item_fingerprint,
                "title": title,
                "url": link
            })

    return matched_results
步骤四:本地去重持久化与下游触达
日常自动化脚本不能在每次扫描时把所有旧内容重新推送一遍。通过上面建立的 SQLite 本地数据库,利用文章链接或商品 ID 生成 MD5 唯一标识,在推送前先进行查重。仅针对“首次发现的匹配项”触发即时推送(如通过企业微信 Webhook、飞书机器人、Telegram 或系统邮件):
def notify_webhook(title: str, url: str):
    # 通过 Webhook 向即时通讯工具发送通知
    # 以常见机器人 Webhook 为例
    webhook_url = "https://qyapi.weixin.qq.com/cgi-bin/webhook/send?key=YOUR_BOT_KEY"
    payload = {
        "msgtype": "markdown",
        "markdown": {
            "content": f"### 发现关注更新\n- **标题**: {title}\n- **链接**: [点击查看]({url})"
        }
    }
    try:
        requests.post(webhook_url, json=payload, timeout=5)
    except Exception as err:
        print(f"[通知失败] 消息推送未送达: {err}")
步骤五:无监督常驻定时调度
自动化任务的最后一环是将其从“每次手动点运行”解放出来。日常场景最推荐直接借用操作系统成熟的计划任务管理器,无需为脚本额外引入沉重的常驻守护进程框架:
- macOS / Linux 环境:使用系统自带的
crontab。终端执行crontab -e,添加如下规则即可每天早上 8:30 自动执行一次脚本并将日志重定向保存:30 8 * * * /usr/bin/python3 /path/to/task_monitor.py >> /path/to/task.log 2>&1 - Windows 环境:使用“任务计划程序”(Task Scheduler),创建一个基本任务,触发器设为“每天”,操作选择“启动程序”,程序填入
python.exe的完整路径,参数填入脚本路径。
四、方案选型与合规使用边界
利用爬虫处理日常网络事务时,技术工具选型的原则是“够用即可,极简优先”。盲目堆砌工具会增加调试和长期维护的负担。同时,技术必须建立在合法与尊重服务提供方的底线上。
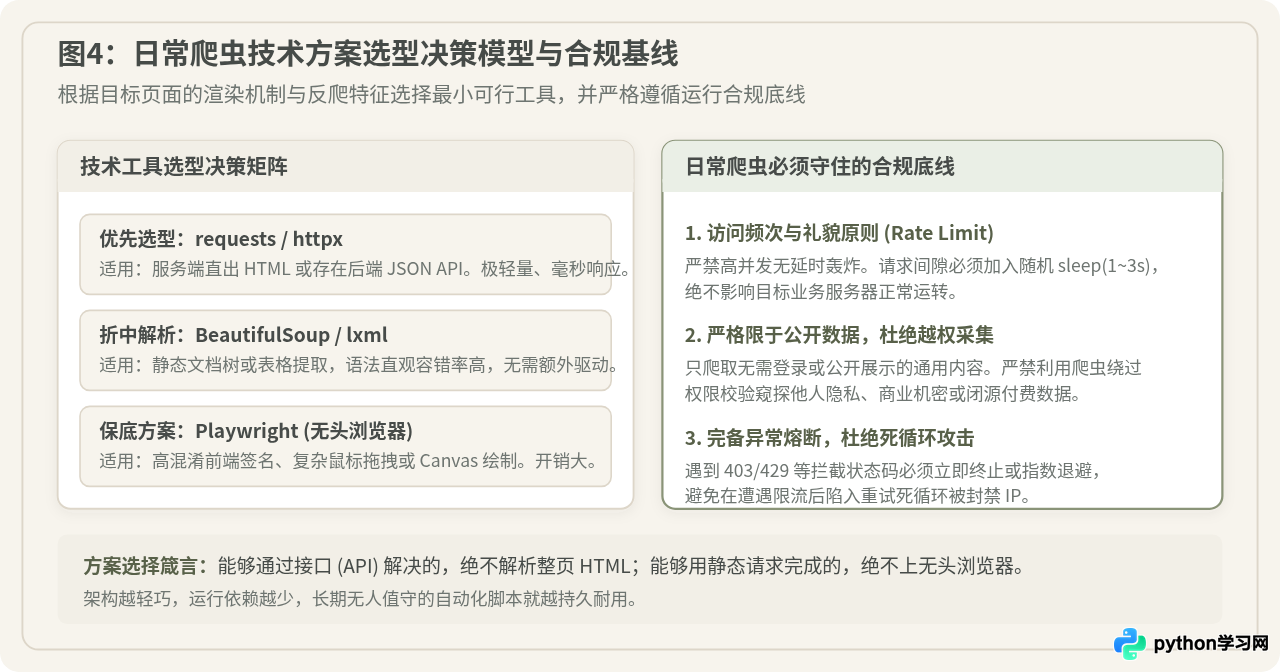
日常爬虫的技术选型矩阵
针对不同页面特征,推荐的工具组合如下:
- 首选方案(接口直连):
requests或httpx。只要能够抓出后端的 JSON/XML 接口,直接请求该接口永远是最优雅、性能最强、消耗资源最少的方式。 - 次选方案(静态 HTML 提取):
requests+BeautifulSoup4或lxml。适合传统的服务端直出页面,语法简单易读,解析容错率高。 - 兜底方案(强动态/强验证页面):
Playwright(优先于 Selenium)。仅在目标页面涉及重度混淆签名、无法绕过的人机交互操作时使用。编写时注意设置headless=True,并在用完后显式关闭页面与上下文释放内存。
安全与合规三要素(必须遵守的底线):
1. 访问频次控制与礼貌延时:日常爬虫绝非压测工具。在遍历多个页面或执行循环扫描时,必须在每次请求之间添加 time.sleep(random.uniform(1, 3)) 随机延迟,严禁无间隙高频刷屏,确保对目标业务服务器的负载影响完全可忽略。
2. 严格限于公开可见数据:脚本应仅针对公开可访问的信息进行采集。严禁利用技术手段探测未授权接口、越权读取个人隐私、绕过付费围墙或违背商业服务条款窃取非公开数据。
3. 完善错误熔断机制:当遇到 HTTP 429 Too Many Requests 或 403 Forbidden 响应时,说明已经触发目标服务器的流控规则,脚本必须立即中断执行并记录告警,切忌在死循环中持续发起重试,避免导致个人公网 IP 被永久封禁。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









