

Python多进程join设置timeout参数防止程序卡死
深入解析Python多进程multiprocessing.Process的join方法设置timeout参数的运行机制。讲解默认join阻塞卡死的成因、带超时参数的标准四步处理流程、terminate强杀的次生死锁风险以及多进程批处理防卡死最佳实践。
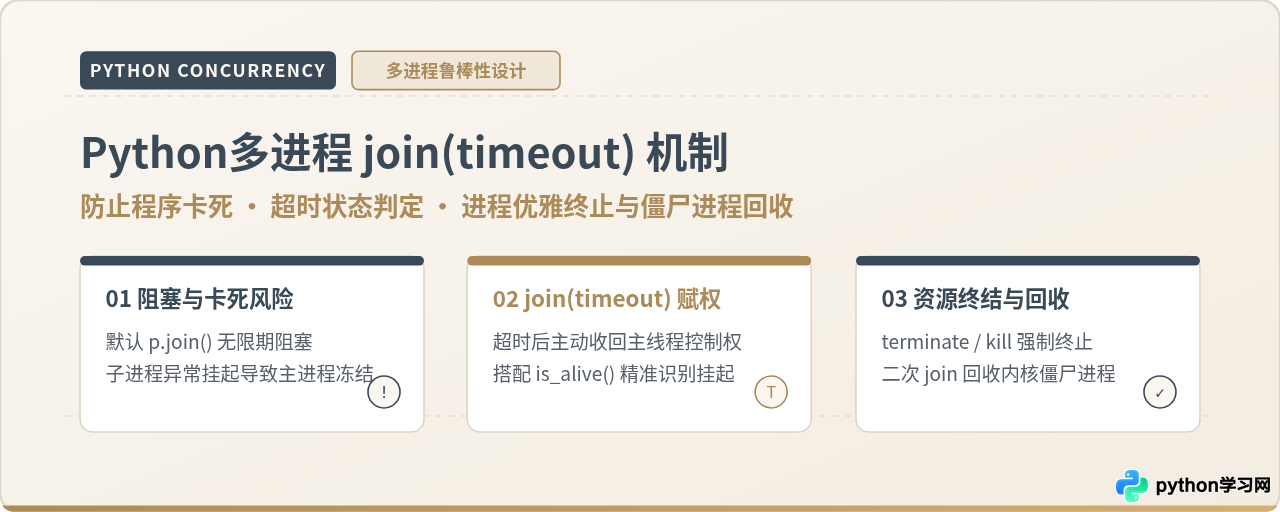
multiprocessing.Process.join() 默认会无期限阻塞主进程,直到目标子进程完全终止。一旦子进程因网络 I/O 挂起、死循环、共享资源死锁或第三方底层库阻塞而未能按时退出,整个主程序便会彻底陷入永久假死状态。通过为 join(timeout) 设置正数超时阈值,主进程可以在指定秒数后主动脱离阻塞态并重新夺回执行控制权;但关键在于,join(timeout) 超时后并不会自动终止子进程,开发者必须配合 p.is_alive() 精准识别超时状态,并配合优雅退出或强行终止与二次 join() 回收资源,才能构建出真正不会卡死的健壮多进程程序。
一、默认 join() 的阻塞机制与程序卡死根因
Python 标准库的 multiprocessing.Process 是利用多核 CPU 算力的核心利器。当主进程通过 p.start() 启动一个子进程后,通常会在后续调用 p.join()。join() 方法的底层本质是调用操作系统的 waitpid(在 POSIX 系统下)或内核等待事件句柄(在 Windows 系统下),目的是让调用方(通常是主进程)等待被调用进程退出,从而获取其退出码并完成资源清理。
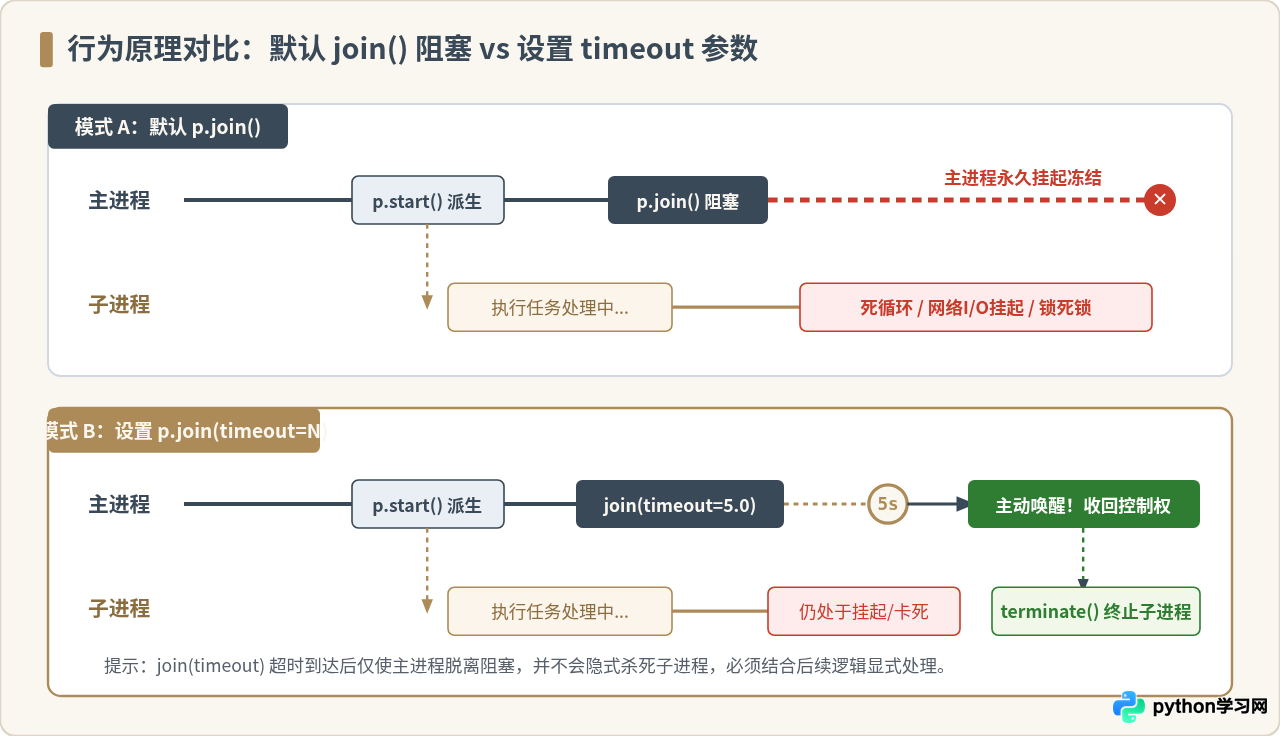
在默认情况下,p.join() 的超时参数为 None,这意味着主进程会无限期挂起当前执行线程,直到子进程完全退出。如果在单机环境或简单的批处理脚本中,子进程总能正常结束,这种写法直观且无害。然而,在复杂任务、长时间运行的服务或与外部交互的场景下,子进程极易由于各种不可预测的原因陷入假死:
- 网络与硬件 I/O 悬挂:子进程在请求未配置超时的下游 HTTP API、Socket 接口或挂载的远程网络文件系统(NFS)时发生连接中断,导致底层 I/O 系统调用长期挂起。
- 不可中断的死循环与计算阻塞:数据结构解析异常或边界值引发无限循环,或者调用了未释放 GIL 且内部发生死锁的第三方 C/C++ 动态链接库。
- 进程间通信(IPC)死锁:子进程与主进程或其他兄弟进程共享
multiprocessing.Queue、Pipe或Lock时,由于获取锁顺序不当或跨进程缓冲区填满引发交叉等待死锁。
在上述任意一种情况下,若主进程执行了没有设置超时限制的 p.join(),主进程自身将被完全冻结,无法响应退出信号、无法记录异常日志,也无法继续调度其他任务,导致整个应用程序彻底卡死。
二、join(timeout) 的核心工作特性与常见误区
为了避免程序无限期停滞,multiprocessing.Process.join([timeout]) 提供了可选的 timeout 参数。该参数接收一个表示秒数的正整数或浮点数(例如 5 或 2.5)。它指示主进程在子进程结束前最多等待指定的时长。
初学者在使用 join(timeout) 时,最普遍且致命的认知误区是:误以为设置了超时后,当超时发生时 Python 会自动杀死卡死的子进程,或者会像 socket 操作那样抛出 TimeoutError 异常。
1. join(timeout) 超时不会抛出异常:无论子进程是正常结束还是由于到达时限返回,join() 永远固定返回 None。主进程不会收到任何自动报错信号。
2. join(timeout) 不会主动终止子进程:超时仅仅意味着“主进程不再继续等待并恢复执行”,那个卡死或仍在计算的子进程依然在后台操作系统进程表中继续运行,继续消耗 CPU 和内存。
正因为这一设计机制,单单写下一行 p.join(timeout=10) 并不能彻底解决卡死问题;它只是把控制权还给了主进程。主进程接下来必须立即对子进程的存活状态进行判断并采取补救动作,否则卡死的子进程将沦为后台孤儿进程,继续占用系统端口、内存和句柄资源。
三、join(timeout) 防卡死标准执行四步法
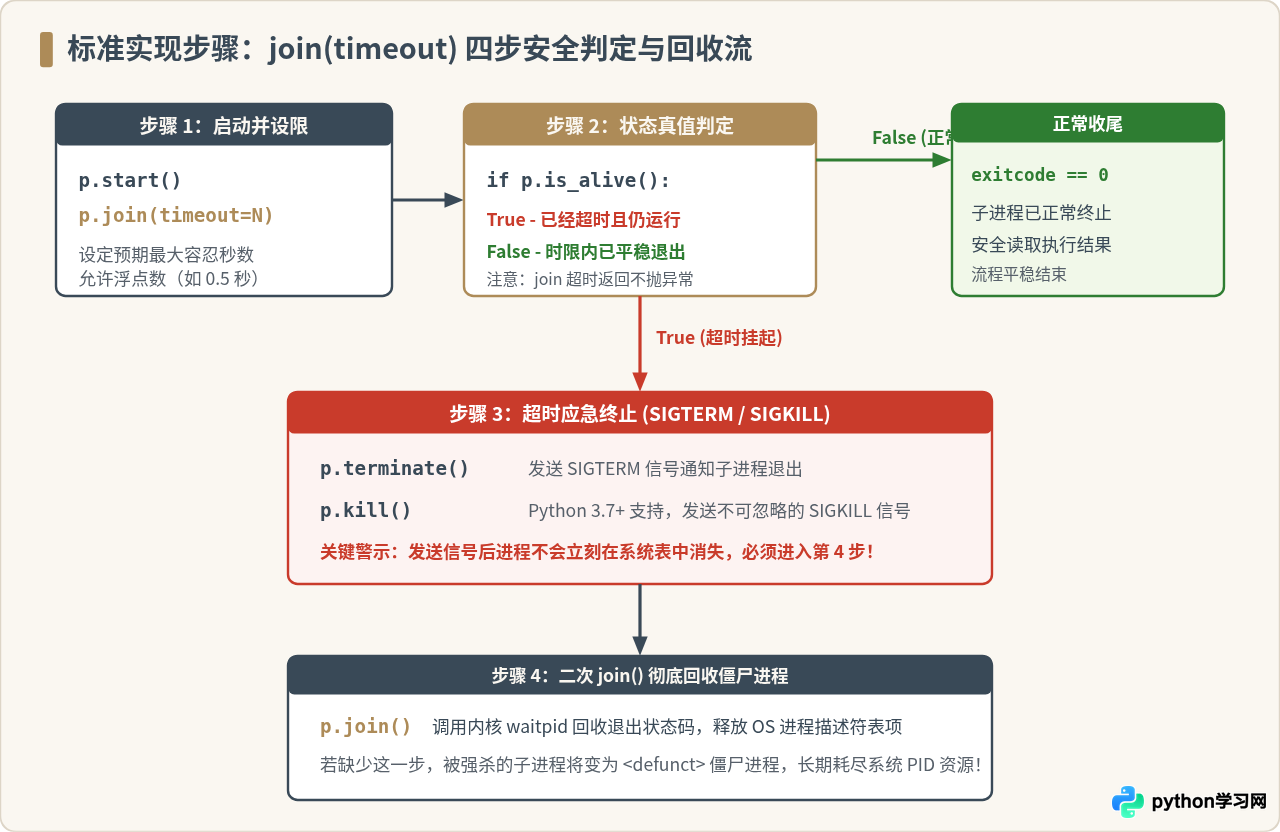
编写工业级防卡死的多进程控制代码,必须严格遵循“启动设限 → 状态判定 → 应急终止 → 二次回收”的四步闭环逻辑。
第 1 步:设置合理的超时时长
调用 p.join(timeout=N),将 N 设定为该业务操作在最不利条件下的合理完成上限。对于快速验证类任务可设置为数秒,对于批量重计算任务可按需设为数十秒。
第 2 步:调用 p.is_alive() 确认进程实际状态
在 join(timeout) 执行完毕后,必须紧跟 if p.is_alive(): 条件判断。如果 is_alive() 返回 False,说明子进程在限定时间内顺利运行结束;如果返回 True,则毫无疑问表明子进程已经超时且仍在运行,进入超时处理分支。
第 3 步:对超时子进程执行强制终止
当确认超时后,主进程需发出终止信号。标准库提供了两个终止方法:
p.terminate():向目标子进程发送SIGTERM信号(Windows 下调用TerminateProcessAPI)。该方法请求操作系统立即终结该进程。p.kill():在 Python 3.7+ 中引入,直接向目标进程发送强力不可屏蔽的SIGKILL信号。当子进程处于某些特定挂起状态导致terminate()无法生效时,kill()具有更高的强制力。
第 4 步:必须执行二次 p.join() 回收资源
这是极容易被遗漏的关键步骤。即使调用了 terminate() 或 kill(),子进程在操作系统层面上并不会立即被抹去。子进程退出后,内核会保留其退出状态码(exit status),此时该进程会进入僵尸状态(Zombie / <defunct>)。主进程必须紧随其后再次调用一次无参数或短超时的 p.join(),促使操作系统完成进程控制块(PCB)的销毁,彻底释放 PID 句柄。
完整可运行的标准代码示例
以下代码演示了上述四步完整流程,包含正常退出与模拟超时的双分支处理:
import multiprocessing
import time
import os

def worker_task(task_name: str, duration: int):
    '''模拟一个可能正常完成,也可能耗时过长卡死的子进程任务'''
    pid = os.getpid()
    print(f"[子进程 PID={pid}] 任务 '{task_name}' 开始执行,预计耗时 {duration} 秒...")

    # 模拟工作负荷
    time.sleep(duration)

    print(f"[子进程 PID={pid}] 任务 '{task_name}' 顺利完成!")

def run_process_with_timeout(task_name: str, task_duration: int, timeout_limit: float):
    print(f"
===== 启动任务: {task_name} (限时 {timeout_limit} 秒) =====")
    p = multiprocessing.Process(
        target=worker_task,
        args=(task_name, task_duration),
        name=f"Worker-{task_name}"
    )

    # 第 1 步:启动进程并进入带超时的等待
    p.start()
    p.join(timeout=timeout_limit)

    # 第 2 步:判断进程是否超时存活
    if p.is_alive():
        print(f"[主进程警告] 任务 '{task_name}' 在 {timeout_limit} 秒内未完成,触发超时防护!")

        # 第 3 步:发出终止信号
        print(f"[主进程处理] 正在强制终止子进程 PID={p.pid}...")
        p.terminate()

        # 第 4 步:必须进行二次 join,回收僵尸进程
        p.join()
        print(f"[主进程确认] 子进程已终止回收,最终 exitcode = {p.exitcode}")
    else:
        print(f"[主进程正常] 任务 '{task_name}' 顺利在超时前结束,exitcode = {p.exitcode}")

if __name__ == "__main__":
    # 示例 A:正常在时限内完成的任务(耗时 2 秒,限制 4 秒)
    run_process_with_timeout("数据下载任务_正常", task_duration=2, timeout_limit=4.0)

    # 示例 B:严重超时卡死的任务(耗时 10 秒,限制 3 秒)
    run_process_with_timeout("报表计算任务_超时", task_duration=10, timeout_limit=3.0)
从示例输出中可以观察到,当发生超时时,主进程在第 3.0 秒准时收回控制权,通过 terminate() 中止了子进程,随后通过二次 join() 测出退出码为 -15(代表进程被 15 号信号 SIGTERM 终止)。主进程全程流畅,没有任何假死停顿。
四、强行终止 (terminate/kill) 的次生陷阱与安全防御
虽然 terminate() 能够迅速切断超时的子进程,但强行终止进程属于破坏性的操作系统底层操作。如果使用不慎,极易在应用程序中埋下隐蔽更深的次生死锁陷阱。
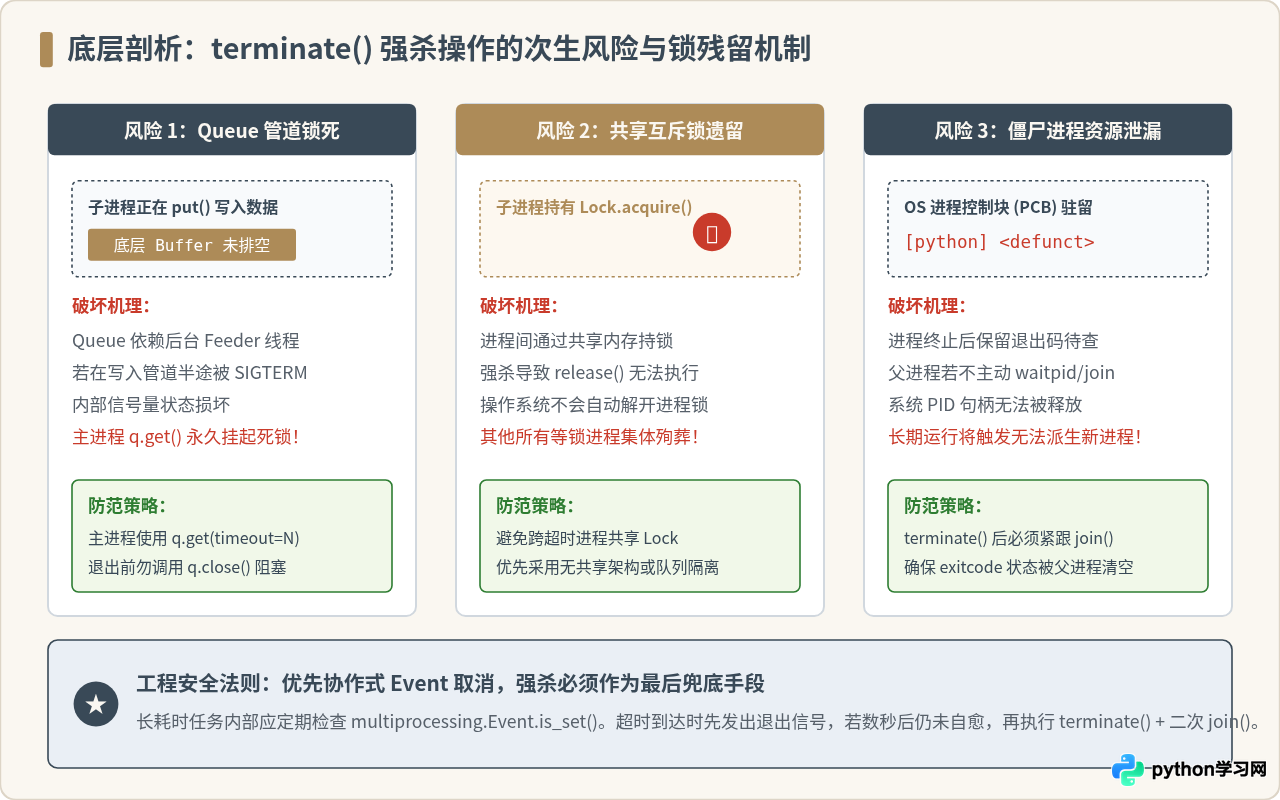
1. 陷阱一:Queue 管道损坏导致主进程后续死锁
multiprocessing.Queue 的底层机制包含操作系统 Pipe、底层的互斥锁以及负责将 Python 对象序列化并写入管道的独立后台 Feeder 线程。如果子进程恰好在向队列中执行 q.put() 的微秒瞬间被 p.terminate() 强制强杀:
- 子进程在管道底层写入的数据可能只写了一半,破坏了协议完整性;
- Queue 内部维护的底层信号量或无名互斥锁可能永久处于被占用状态;
- 主进程如果在后续继续调用
q.get(),或者在程序准备退出时试图刷新队列内部缓冲区,主进程将会直接在底层 C 级管道读写处发生永久死锁。
防御建议:对于需要在超时后强制强杀的子进程,尽量避免让其与主进程频繁通过共享 Queue 传输高频数据。如果必须传输,可在主进程中为 q.get(timeout=...) 同样设置超时,并在强杀子进程后丢弃该队列实例,或者使用独立磁盘文件、数据库作为数据暂存中间介质。
2. 陷阱二:共享互斥锁 Lock 未被释放
如果子进程持有了跨进程共享的 multiprocessing.Lock 或 Semaphore,并在临界区代码执行期间被外部强制终止,操作系统的内核并不负责帮它调用 release()。这把共享锁将永久失效并锁死,其他排队等待该锁的正常子进程将一个接一个地全部卡死。
防御建议:在可能超时的子进程任务内部,尽量杜绝跨进程锁的竞争,遵循“无共享内存架构(Share Nothing)”。
3. 最佳实践:Event 协作退出优先,强杀作为最终兜底
在设计长耗时任务时,最优雅的超时控制架构是“协作式取消”与“强杀兜底”并行的双层机制。通过 multiprocessing.Event 设置一个中断信号,子进程在主循环内部定期检查该事件是否置位:
import multiprocessing
import time

def cooperative_worker(stop_event: multiprocessing.Event):
    print("子进程开始执行长循环任务...")
    while True:
        # 内部检查主进程是否发出了取消信号
        if stop_event.is_set():
            print("子进程捕获到退出事件,正在执行清理并平稳退出...")
            # 在此处关闭文件句柄、清理连接、释放资源
            break

        # 模拟每次循环的工作
        time.sleep(0.5)

if __name__ == "__main__":
    stop_event = multiprocessing.Event()
    p = multiprocessing.Process(target=cooperative_worker, args=(stop_event,))
    p.start()

    # 主进程等待指定时长
    p.join(timeout=3.0)

    if p.is_alive():
        print("超时到达,首先发出协作式退出信号通知子进程自愈...")
        stop_event.set()

        # 给予子进程 1 秒缓冲期完成优雅收尾
        p.join(timeout=1.0)

        # 如果缓冲期过后依然没退出,再实施强制手段
        if p.is_alive():
            print("子进程未响应协作退出信号,执行强制终止!")
            p.terminate()
            p.join()

    print("主程序安全结束,无锁死与资源残留。")
五、工程实践:多子进程批量管理与进阶防卡死方案
在实际生产项目中,开发者往往需要并发启动数十甚至上百个子进程。如果直接在一个简单的 for 循环中为每个进程串行调用 p.join(timeout),就会掉入超时时长串行累加的陷阱。
例如,启动了 10 个子进程,若对每个进程执行 p.join(timeout=5)。一旦这 10 个进程全部由于网络故障陷入假死,主进程处理第 1 个需要 5 秒,处理第 2 个又需要 5 秒……最终累计等待时间长达 50 秒,完全失去了并发处理的意义。
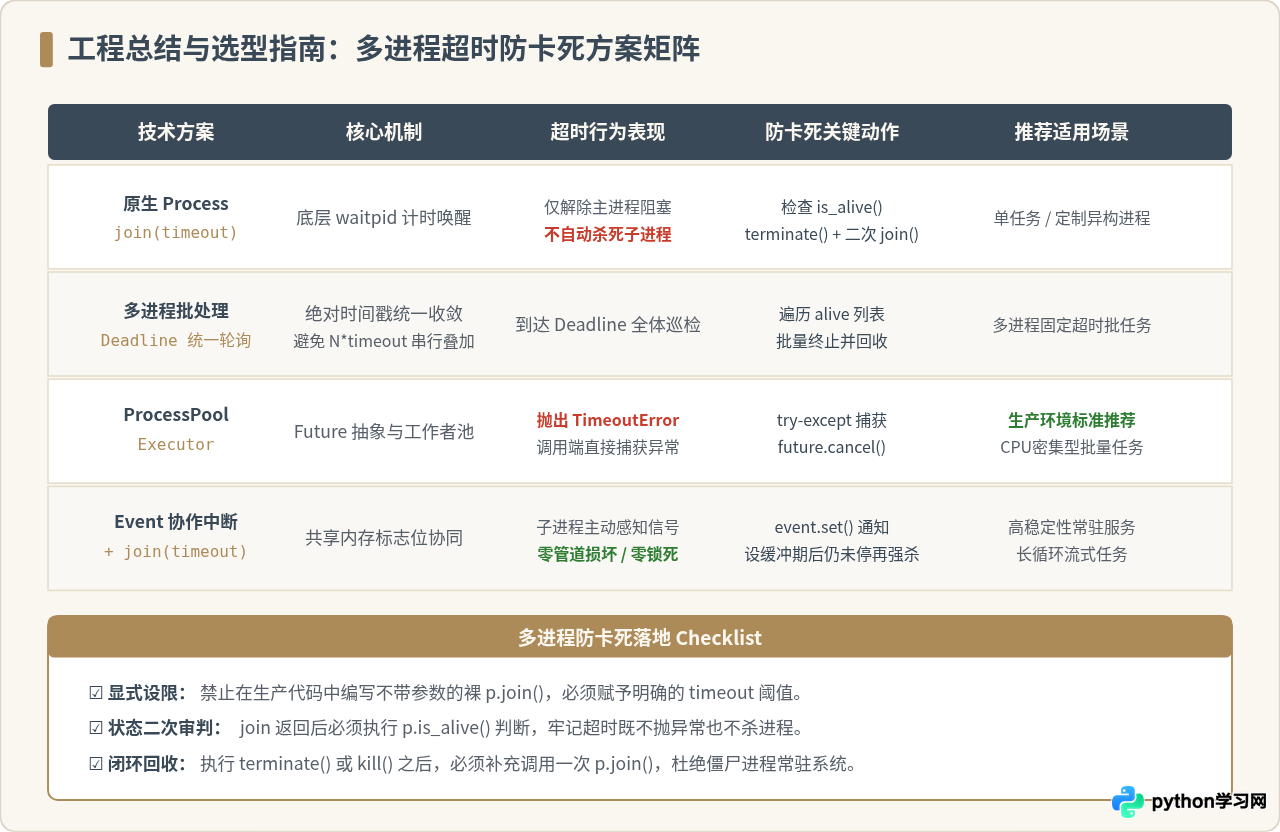
方案一:基于全局 Deadline 的统一轮询监控
对于批量原生 Process,推荐使用计算截止时间戳(Deadline)的轮询机制,让所有进程共享统一的超时窗口:
import multiprocessing
import time

def batch_worker(index: int):
    # 模拟偶发性死锁或超长耗时
    sleep_time = 2 if index % 2 == 0 else 10
    time.sleep(sleep_time)

def run_batch_with_global_deadline(process_count: int, total_timeout: float):
    processes = []
    for i in range(process_count):
        p = multiprocessing.Process(target=batch_worker, args=(i,), name=f"BatchProc-{i}")
        processes.append(p)
        p.start()

    deadline = time.time() + total_timeout

    # 统一轮询监控
    while time.time() < deadline:
        # 检查是否全部已经完成
        if not any(p.is_alive() for p in processes):
            print("所有子进程已在全局截止时间前顺利完成!")
            break
        time.sleep(0.1)
    else:
        print(f"到达全局截止时间 {total_timeout} 秒,开始清理仍在运行的卡死进程...")
        for p in processes:
            if p.is_alive():
                print(f"强行终止卡死子进程: {p.name} (PID={p.pid})")
                p.terminate()
                p.join()

    # 回收已完成进程
    for p in processes:
        if p.is_alive():
            p.join()
    print("全部批量子进程回收完毕。")

if __name__ == "__main__":
    run_batch_with_global_deadline(process_count=6, total_timeout=4.0)
方案二:现代标准库最佳实践 —— ProcessPoolExecutor
在现代 Python(Python 3.5+)编程中,针对批量 CPU 密集型计算任务,标准库推荐优先采用 concurrent.futures.ProcessPoolExecutor 代替底层的原生 multiprocessing.Process。它提供了天然支持超时的 Future 接口:
import concurrent.futures
import time

def cpu_heavy_task(item_id: int) -> str:
    if item_id == 3:
        time.sleep(20)  # 模拟异常卡死
    else:
        time.sleep(1)
    return f"任务 {item_id} 结果"

if __name__ == "__main__":
    with concurrent.futures.ProcessPoolExecutor(max_workers=4) as executor:
        # 提交一组任务
        future_to_id = {executor.submit(cpu_heavy_task, i): i for i in range(5)}

        for future in future_to_id:
            task_id = future_to_id[future]
            try:
                # 直接在结果获取处设定超时阈值!
                result = future.result(timeout=3.0)
                print(f"[成功] 任务 {task_id}: {result}")
            except concurrent.futures.TimeoutError:
                print(f"[超时] 任务 {task_id} 执行超过 3.0 秒,已触发异常拦截!")
                future.cancel()
ProcessPoolExecutor 内部自动维护了进程复用、通信缓冲管理与退出状态回收,能够显著降低手动管理底层进程句柄带来的出错概率。
六、排查与防卡死 Checklist 检查清单
为确保生产环境中的多进程程序长期稳定运行且不发生假死,请对照以下检查清单进行代码审计:
| 核查项 | 规范要求与行为准则 | 未达标的典型后果 |
|---|---|---|
| 禁用裸 join | 生产代码中严禁出现不传参的 p.join(),必须显式指明业务合理的 timeout 浮点秒数。 |
子进程一旦 I/O 阻塞,主程序陷入无限期死等。 |
| 必须审判 is_alive | join(timeout) 之后紧跟 if p.is_alive(): 分支,不得盲目假定子进程已结束。 |
超时子进程沦为孤儿进程在后台继续死跑。 |
| 强杀必须跟二次 join | 调用 p.terminate() 或 p.kill() 后,必须紧跟 p.join() 销毁内核描述符。 |
系统进程表被 <defunct> 僵尸进程塞满。 |
| 隔离跨进程共享锁 | 避免在可能被超时的子进程中执行 Lock.acquire() 操作。 |
子进程被杀后锁未释放,后续进程全面瘫痪。 |
| 防止批量超时叠加 | 对多个子进程监控时,采用全局时间戳 Deadline 统一收敛,或使用 ProcessPoolExecutor。 |
串行等待导致实际总阻塞时长以倍数级膨胀。 |
通过理解 join(timeout) 的本质、认清超时返回并不等于进程销毁的关键事实,并配合完善的状态检测与二次回收闭环,开发者便能够从容驾驭 Python 多进程的高性能并发优势,构建出在面对各种异常阻塞场景下依然稳如磐石的健壮系统。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









