

Python多进程并行遇到pickle序列化错误怎么解决?
全面分析Python多进程并行计算中pickle序列化错误产生机理,从函数作用域重构、句柄延迟初始化、dill扩展库替换到多线程架构降级,提供可落地的排查步骤与实操代码。
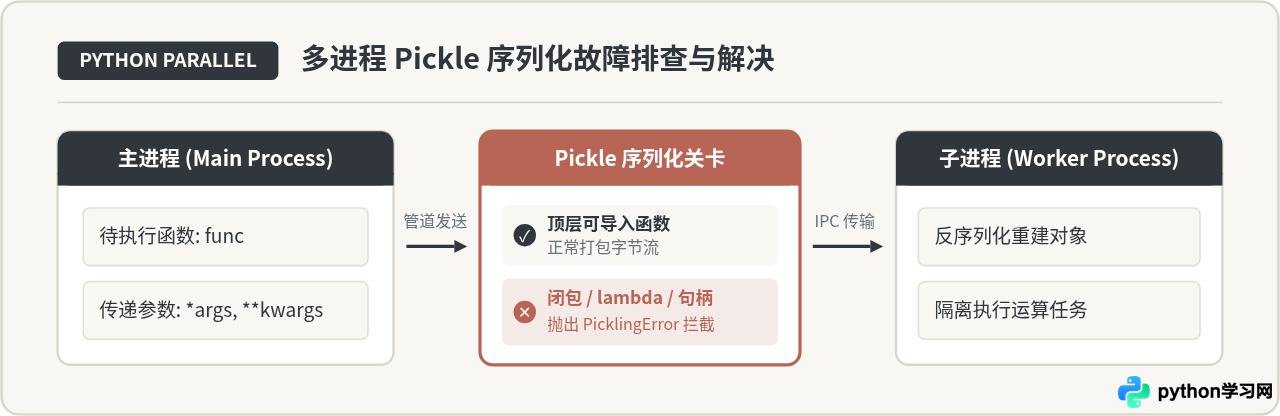
multiprocessing.Pool 或 ProcessPoolExecutor)中,主进程向子进程分发任务函数与参数时,必须经过 pickle 库将对象序列化为二进制字节流。若待分发的对象属于匿名函数(lambda)、嵌套闭包(local object)、或者持有了文件句柄与数据库连接等系统底层资源,pickle 无法按照规范解析导出,便会立刻抛出 PicklingError、AttributeError: Can't pickle local object 或 TypeError。彻底解决此问题主要有四条路径:将内部函数提升为模块顶层函数、将不可序列化资源延迟至子进程内部初始化、改用支持复杂对象的 multiprocess/dill 库,以及在 I/O 密集型场景下直接降级为线程池。
一、常见报错表现与底层触发机制
当开发者使用 Python 的标准多进程模块调度计算任务时,最常遇到的序列化报错通常集中在以下几种形式:
-
嵌套函数与闭包报错:
AttributeError: Can't pickle local object 'main.<locals>.worker'。这通常发生在把定义在另一个函数内部的局部函数作为子进程目标函数时。 -
匿名函数报错:
_pickle.PicklingError: Can't pickle <function <lambda> at 0x...>: attribute lookup <lambda> on __main__ failed。直接使用lambda表达式作为多进程任务时必定触发。 -
系统句柄与非序列化对象报错:
TypeError: cannot pickle '_io.BufferedReader' object或TypeError: cannot pickle 'generator' object。当把已打开的文件句柄、数据库连接、线程锁或生成器传递给进程池时抛出。
理解这一系列报错的关键,在于搞清楚 Python 多进程的工作模型。与多线程共享同一份进程内存空间不同,多个操作系统进程之间的内存是严格隔离的。主进程要把一个计算任务交给子进程执行,必须将两样东西打包送入 IPC(进程间通信)管道或队列:待执行的函数对象以及传入的实参对象。
Python 标准库默认且深度绑定了 pickle 协议进行打包。然而,pickle 在序列化函数对象时,并不会将函数的 Python 字节码打包传输。相反,它仅提取并保存该函数的模块名(__module__)与限定名称(__qualname__)。当子进程收到这串字节流时,它在自己的独立内存空间里重新执行 import 操作,并尝试从对应模块中按照限定名查找该函数。
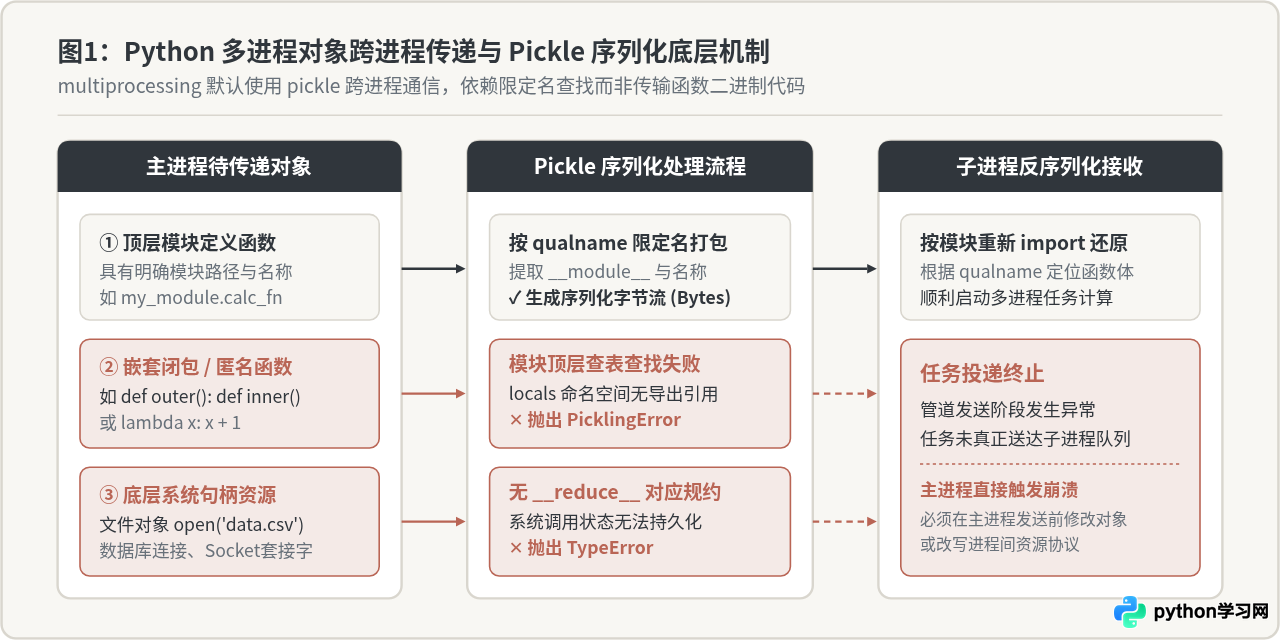
正如上面图示所示:如果函数是在某个局部作用域内动态定义的(如嵌套在 main() 函数体里的 worker),模块的全局命名空间里根本不存在它的引用,子进程无法“按名索引”导入,序列化机制直接宣布失败。同理,像文件描述符、网络 Socket 这种依赖操作系统内核状态的句柄,也无法被转化为通用字节流而在另一片内存中还原。
二、四步排查法:快速定位不可序列化的对象
在复杂项目中,多进程调度往往涉及多个参数、复杂的对象结构和深层调用栈。遇到报错时切忌盲目乱改代码,建议按照以下四个步骤由浅入深定位源头。
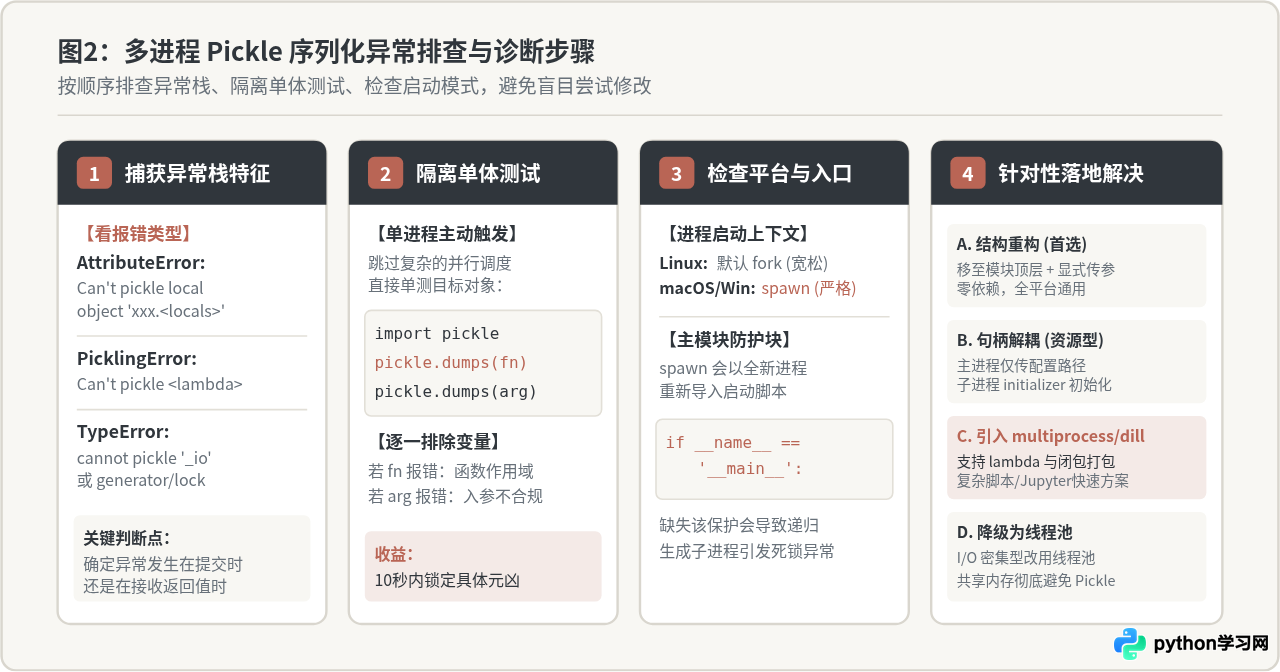
步骤 1:判断异常发生的时机
仔细审视完整的错误堆栈(Traceback):
- 若异常在调用
pool.apply_async(...)或executor.submit(...)的瞬间就立刻抛出,说明是目标任务函数或输入的实参不可序列化。 - 若任务正常提交并在后台跑了一段时间,但在调用
result.get()或遍历future.result()时抛出序列化错误,说明任务函数已经执行完毕,但函数的返回值包含了无法序列化的对象。
步骤 2:使用单进程单元测试精确定位
不要在多进程并发的混乱日志中排查。可以在主线程中写一段简单的隔离测试代码,对疑似问题对象直接执行 pickle.dumps():
# 示例:快速隔离定位哪一个对象导致序列化失败
import pickle

def diagnose_pickling(target_func, *args, **kwargs):
    try:
        pickle.dumps(target_func)
        print("[PASS] 任务函数可正常序列化")
    except Exception as err:
        print(f"[FAIL] 任务函数无法序列化: {err}")

    for idx, arg in enumerate(args):
        try:
            pickle.dumps(arg)
            print(f"[PASS] 传入参数 [{idx}] 可正常序列化")
        except Exception as err:
print(f"[FAIL] 传入参数 [{idx}] 无法序列化: {err}")executor.submit(func, arg1, arg2) 的参数直接传入诊断函数。一旦某一行打印 [FAIL],就能明确知道是函数自身作用域受限,还是具体某一个参数(如未转换为列表的 generator)拖累了流程。
步骤 3:核对操作系统与进程启动模式
在 Linux 上,默认的进程创建模式为 fork,子进程会直接复制父进程的内存页,因此有时即使函数定义不规范也能侥幸跑通;但在 macOS(Python 3.8+ 默认)和 Windows 上,默认使用 spawn 模式。spawn 会启动一个全新的干净 Python 解释器并重新导入入口模块。
因此,如果在 Windows 或 macOS 上运行多进程,必须在主入口放置防护语句,否则会导致子进程递归导入自身而引发严重错误:
if __name__ == '__main__':
    # 所有进程池的初始化与启动代码必须放在此处
    run_multiprocessing_tasks()
三、解决方案一:重构代码结构为顶层函数(标准推荐)
在所有解决方案中,将任务函数提升为模块顶层定义是官方最推崇、执行性能最高、且完全不依赖第三方扩展库的标准解法。
场景表现与重构对照
很多开发者习惯在某个封装函数内部定义临时计算任务,或者借助外部闭包变量进行计算,这种写法在单线程中非常优雅,但在多进程中是典型的反模式。
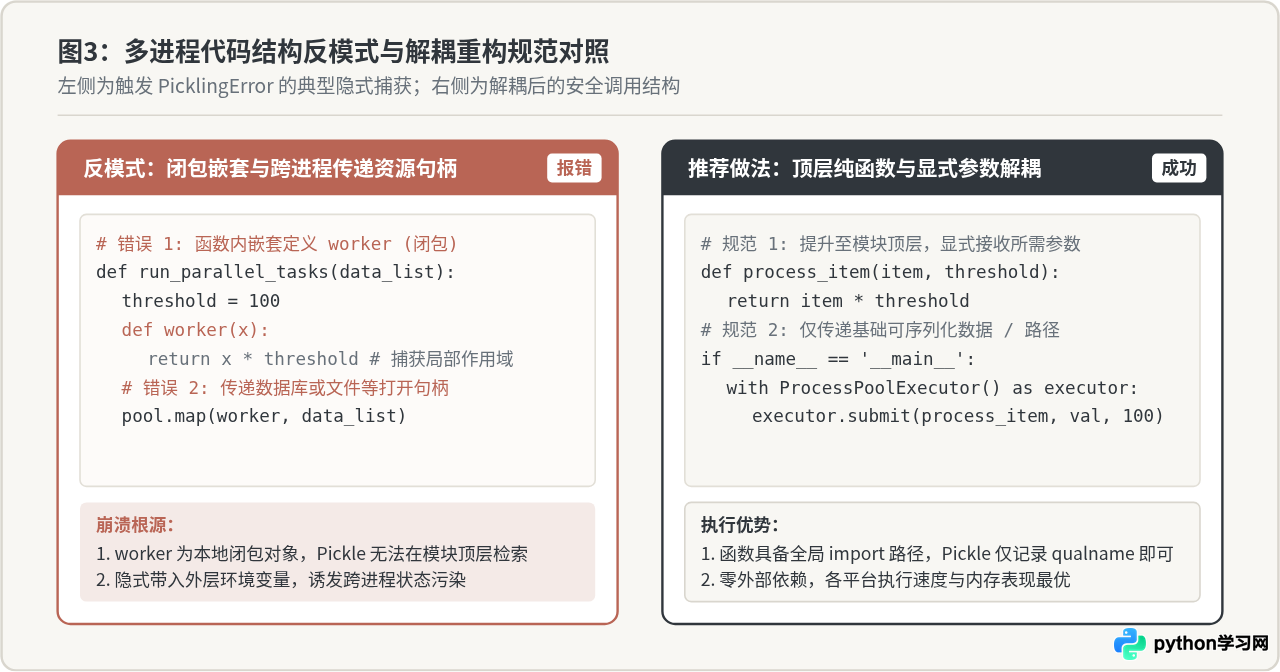
完整可运行重构示例
以下展示了如何将一个触发 AttributeError: Can't pickle local object 的闭包逻辑,规范重构为可平稳运行的多进程程序:
# 文件名:task_processor.py
from concurrent.futures import ProcessPoolExecutor

# 【重构前:报错写法】
# def process_all_data(data_list):
#     scale_factor = 2.5
#     def inner_calc(val):              # 错误!局部嵌套函数,子进程无法查找
#         return val * scale_factor     # 隐式捕获外层闭包变量
#     with ProcessPoolExecutor() as executor:
#         return list(executor.map(inner_calc, data_list))

# 【重构后:规范写法】
# 1. 提升到模块顶层,保证具备清晰的 module.qualname 路径
# 2. 闭包捕获的变量改为显式形参传递
def calculate_item(val, scale_factor):
    """顶层纯函数:计算逻辑独立,参数全部显式传入"""
    return val * scale_factor

def run_pipeline():
    data_list = [10, 20, 30, 40, 50]
    scale_factor = 2.5

    with ProcessPoolExecutor() as executor:
        # 显式提交参数
        results = [executor.submit(calculate_item, item, scale_factor) for item in data_list]
        output = [r.result() for r in results]

    print(f"执行完成,结果为: {output}")

if __name__ == '__main__':
run_pipeline()执行完成,结果为: [25.0, 50.0, 75.0, 100.0, 125.0]
若将类的实例方法
self.work 传入进程池,pickle 在打包该方法时会将整个 self 实例对象连同其内部的所有属性完整序列化。如果 self 中包含了未关闭的文件、不可序列化的属性(如线程锁 threading.Lock),就会立刻报错。解决办法是将该方法标记为 @staticmethod 或独立移出类外,只传递计算所需的具体字段。
四、解决方案二:解耦系统资源与进程边界(延迟初始化)
多进程开发中另一类高频报错是 TypeError: cannot pickle '_io.BufferedReader' 或类似数据库 Connection、Socket 句柄错误。
为什么不能在主进程创建句柄传给子进程?
很多初学者写出如下代码:在主进程中连上数据库 conn = pymysql.connect(...) 或打开大文件 f = open('data.bin', 'rb'),然后试图把 conn 或 f 作为参数分发给 pool.apply_async(worker, args=(conn, chunk))。
这必然会报错:因为操作系统底层的文件描述符(FD)和网络套接字是内核层面的指针状态,在跨进程序列化协议中没有对应的规约(无 __reduce__ 方法支持)。即便在某些 UNIX 系统的 fork 下句柄被子进程复制继承,多个子进程同时读写同一个 Socket 或文件指针,也会造成致命的协议错乱、文件指针覆盖与数据损坏。
正确的工程实践:仅传递配置,子进程内部建联
处理系统资源时,应当遵循“跨进程只传递可序列化的配置字符串,在进程内部按需创建独占句柄”的原则。推荐两种实现方式:
方式 A:在 Worker 函数内部独立创建并释放资源
import os
from concurrent.futures import ProcessPoolExecutor

def process_file_chunk(file_path, start_offset, length):
    """在子进程内部独立打开并读取自己负责的区间"""
    with open(file_path, 'rb') as f:  # 在子进程中自行打开,避开跨进程传输句柄
        f.seek(start_offset)
        data = f.read(length)
    return len(data)

if __name__ == '__main__':
    target_file = "sample.dat"
    # 仅传递字符串路径与整数偏移量,均为天然可序列化对象
    with ProcessPoolExecutor() as executor:
        future = executor.submit(process_file_chunk, target_file, 0, 1024)
        print(f"处理字节数: {future.result()}")
方式 B:使用进程池 initializer 初始化共享上下文
如果每个任务都反复创建数据库连接太耗时,可以使用 multiprocessing.Pool 的 initializer 参数。每个 Worker 进程启动时仅初始化一次连接,并将其赋给进程内的全局变量:
import multiprocessing as mp

# 进程级全局变量,每个子进程拥有一份独立的实例
worker_db_client = None

def init_worker_env(db_url):
    global worker_db_client
    # 在每个子进程初始化时单独建立连接
    worker_db_client = MockDbClient(db_url)
    print(f"子进程 [{mp.current_process().pid}] 数据库初始化成功")

def fetch_record_task(record_id):
    # 直接复用当前子进程内的客户端
    return worker_db_client.query(record_id)

class MockDbClient:
    def __init__(self, url):
        self.url = url
    def query(self, rid):
        return f"Record-{rid} from {self.url}"

if __name__ == '__main__':
    db_config = "sqlite:///cluster_node.db"
    # 将不可序列化的连接创建工作委托给 initializer
    with mp.Pool(processes=2, initializer=init_worker_env, initargs=(db_config,)) as pool:
        records = pool.map(fetch_record_task, [101, 102, 103])
print(f"查询完成: {records}")db_config 通过 initargs 传递过去。由于字符串是标准的 Pickle 对象,传输毫无阻碍;真实的数据库连接在各子进程内部独立创建,既保障了性能,又避免了序列化冲突。
五、解决方案三:采用 multiprocess / dill 扩展库
在某些特定场景下,比如使用 Jupyter Notebook 进行数据探索、或者需要大量分发动态闭包、类内动态方法时,将每一个函数都拆解重构为顶层模块函数会破坏现有业务封装,甚至在交互式 REPL 环境中根本没有实体 .py 模块供 __qualname__ 查找。
此时,最佳选择是使用更强大的第三方序列化库 dill 替换 Python 默认的 pickle。
原理与替代优势
dill 扩展了标准 pickle 模块,它通过解析 Python 抽象语法与栈帧环境,支持对 lambda 表达式、嵌套函数、闭包上下文、甚至运行时动态生成的类进行深度字节码序列化。
更方便的是,社区维护了 multiprocess 库——它是 Python 官方 multiprocessing 的完整分支版本,内部已将序列化底层完全切换为 dill,对外 API 与标准库保持 100% 兼容。
使用步骤与代码对比
首先安装依赖包:
pip install multiprocess dill
只需将代码中的 import multiprocessing 替换为 import multiprocess,原先因为闭包而报错的代码即可直接运行:
# 使用 multiprocess 代替原生 multiprocessing
import multiprocess as mp

def execute_complex_pipeline():
    captured_offset = 500
    # 这里的 lambda 和闭包在标准 multiprocessing 下必死无疑
    # 但在 multiprocess (dill) 驱动下可以顺利跨进程序列化
    dynamic_worker = lambda x: x ** 2 + captured_offset

    task_data = [1, 2, 3, 4, 5]

    with mp.Pool(processes=2) as pool:
        results = pool.map(dynamic_worker, task_data)

    print(f"multiprocess 执行成功: {results}")

if __name__ == '__main__':
execute_complex_pipeline()multiprocess 执行成功: [501, 504, 509, 516, 525]
1. 传输性能开销:因为
dill 打包了完整的闭包上下文与字节码,序列化后的体积远大于标准 pickle 的轻量限定名,通信延迟略有增加。2. 无法突破底层硬件句柄限制:
dill 依然不能把一个打开的操作系统 Socket 或文件描述符打包给子进程,涉及硬件资源仍须使用“延迟初始化”方案。
六、架构选型与场景降级:什么时候不该用多进程?
在解决序列化报错时,应当反向审视当前任务的技术架构:我们真的必须使用多进程吗?
许多开发者在遇到 PicklingError 时,其业务实质往往是爬虫抓取、网络接口轮询、批量写入文件等 I/O 密集型任务。
- I/O 密集型任务:瓶颈在于网络延迟和磁盘读写,Python 的 GIL(全局解释器锁)在进行 I/O 操作时会自动释放。改用
ThreadPoolExecutor(线程池)或asyncio(协程),所有线程共享同一个内存空间,根本不需要经过任何序列化步骤,无论是lambda、闭包还是本地对象都能原生共享,同时省去了进程创建和 IPC 的巨大资源消耗。 - CPU 密集型任务:如图像处理、矩阵运算、大规模数据特征计算,GIL 会锁死多线程算力,必须使用多进程。此时应坚决采用“顶层函数重构”或“延迟初始化”。
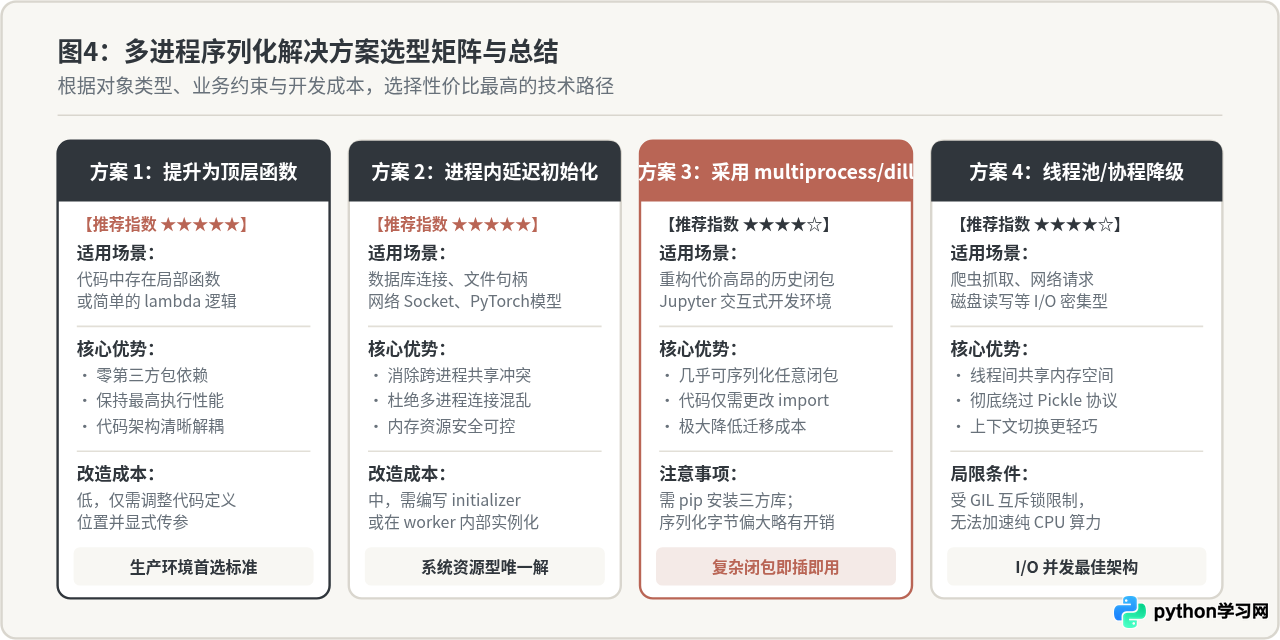
七、总结与排查自检清单
为了帮助大家在日常开发中迅速定位并解决问题,我们将核心排查项整理为自检表格:
| 报错场景与特征 | 根本原因 | 最佳解决方案 | 典型修复耗时 |
|---|---|---|---|
AttributeError: Can't pickle local object |
将函数定义在其他函数内部或类内部动态方法中,无全局模块限定名 | 将目标函数提升到模块顶层,改为显式参数传递 | < 5 分钟(改动极小) |
PicklingError: Can't pickle <lambda> |
任务为 lambda 匿名函数,Pickle 无法在模块命名空间查表 | 使用 def 定义正式函数,或改用 multiprocess 库 |
< 2 分钟 |
TypeError: cannot pickle '_io.xxx' |
将文件句柄、数据库连接、套接字直接作为入参跨进程分发 | 主进程仅传递路径/连接配置,在子进程内或 initializer 中建联 |
10 - 20 分钟 |
TypeError: cannot pickle 'generator' |
将生成器对象直接作为实参传入任务 | 在传入前显式转为列表 list(gen) 或按需分批切片 |
< 1 分钟 |
| 子进程递归启动死锁(macOS/Win) | spawn 启动模式下重新加载模块,缺少入口守护条件 |
将多进程调度逻辑严格包裹在 if __name__ == '__main__': 之后 |
< 1 分钟 |
遇到多进程 Pickle 序列化错误时,只需记住核心原则:函数要独立且全局可导入,资源要各进程自建自销,复杂闭包借助 dill 突破,I/O 并发优选多线程。按照这一套清晰的逻辑排查并重构代码,即可保证多进程并行系统稳定高效运行。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









