

Python多进程怎么合理设置进程数:避免资源耗尽与性能下降
深入解析Python多进程中合理设置进程数的科学方法,涵盖CPU密集型与IO密集型的决策模型、物理核与容器配额获取、内存预算与OOM防御策略。
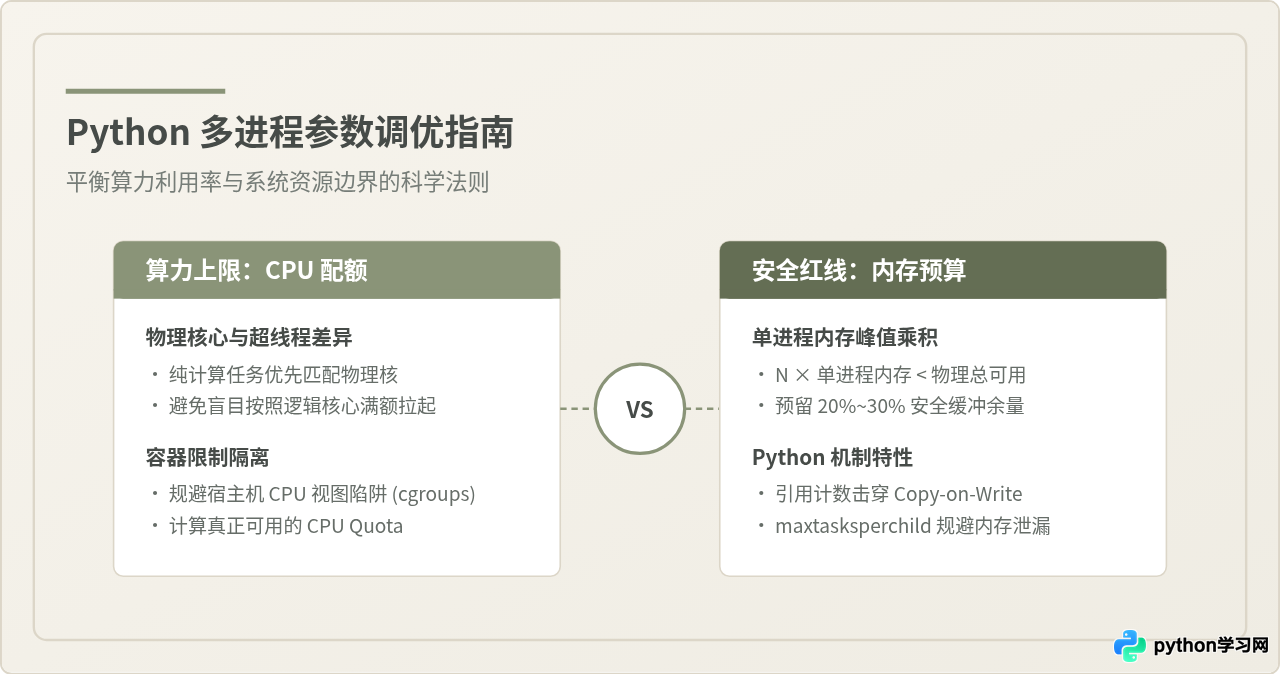
合理设置 Python 多进程的进程数,核心原则是在任务类型(CPU密集 vs IO密集)与物理资源边界(真实CPU配额、峰值内存容量)之间找到交集。盲目将进程数设为等于或数倍于 os.cpu_count(),不仅无法获得线性加速,反而极易触发频繁上下文切换、IPC通信拥堵乃至系统级 OOM(内存溢出崩溃)。本文将给出明确的计算公式、推导逻辑与容器适配方案。
一、核心结论与速查公式
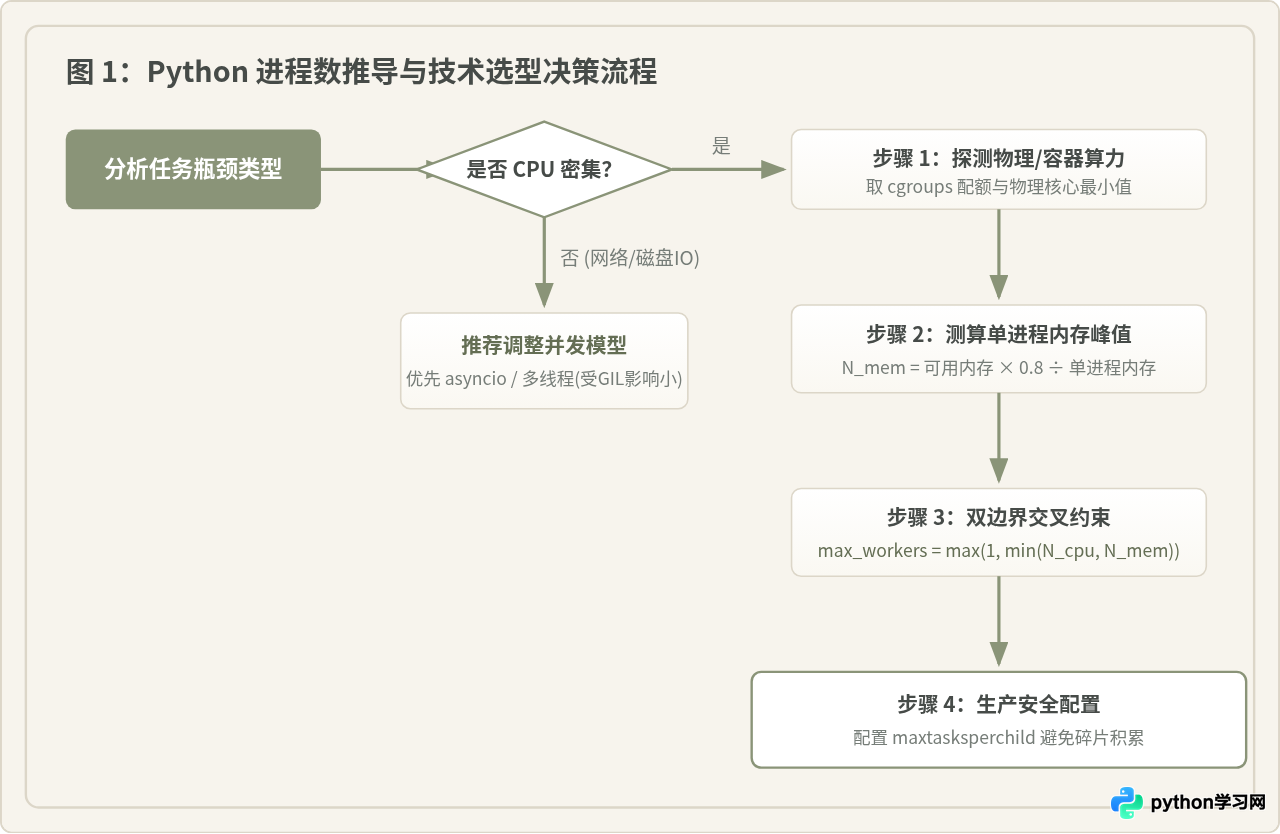
在实际工程中,进程数(processes 或 max_workers)不应该是一个主观估计的魔法数值。针对不同负载场景,推荐遵循以下基准公式进行设值:
| 业务场景类型 | 推荐进程数公式 | 核心决策依据与主要风险 |
|---|---|---|
| CPU 密集型(裸机/虚机) | N_cpu = 物理核心数 或 逻辑核心数 - 1 |
受制于计算单元饱和度。超过核心数会导致上下文切换,甚至引起 CPU 缓存频繁失效。 |
| 容器化环境(Docker/K8s) | N_cpu = min(物理核心数, floor(cgroup_quota)) |
os.cpu_count() 在容器中默认返回宿主机核数,若超出容器配额将导致严重 CPU 限流(Throttle)。 |
| 内存占用较大任务 | N_mem = floor(可用物理内存 × 0.8 ÷ 单进程峰值内存) |
内存为硬性红线。必须取 min(N_cpu, N_mem),否则直接触发 Linux OOM Killer 杀进程。 |
| IO 密集型任务 | 不推荐首选多进程,优先改用 asyncio 或 ThreadPoolExecutor |
进程创建与通信代价巨大;若必须使用,进程数设为 CPU核心数 × (1 + 等待时间/计算时间) 且需严格监控内存。 |
二、为什么进程数不能“贪多”:性能下降与资源耗尽机理
由于 Python 存在全局解释器锁(GIL),为了利用多核 CPU 处理密集型计算,开发者通常会使用 multiprocessing 模块启动独立进程。每一个子进程都是一个完整的 Python 解释器实例。当盲目增加进程数量时,系统将面临以下三重负面效应:
1. 内存膨胀与 Copy-on-Write 机制失效
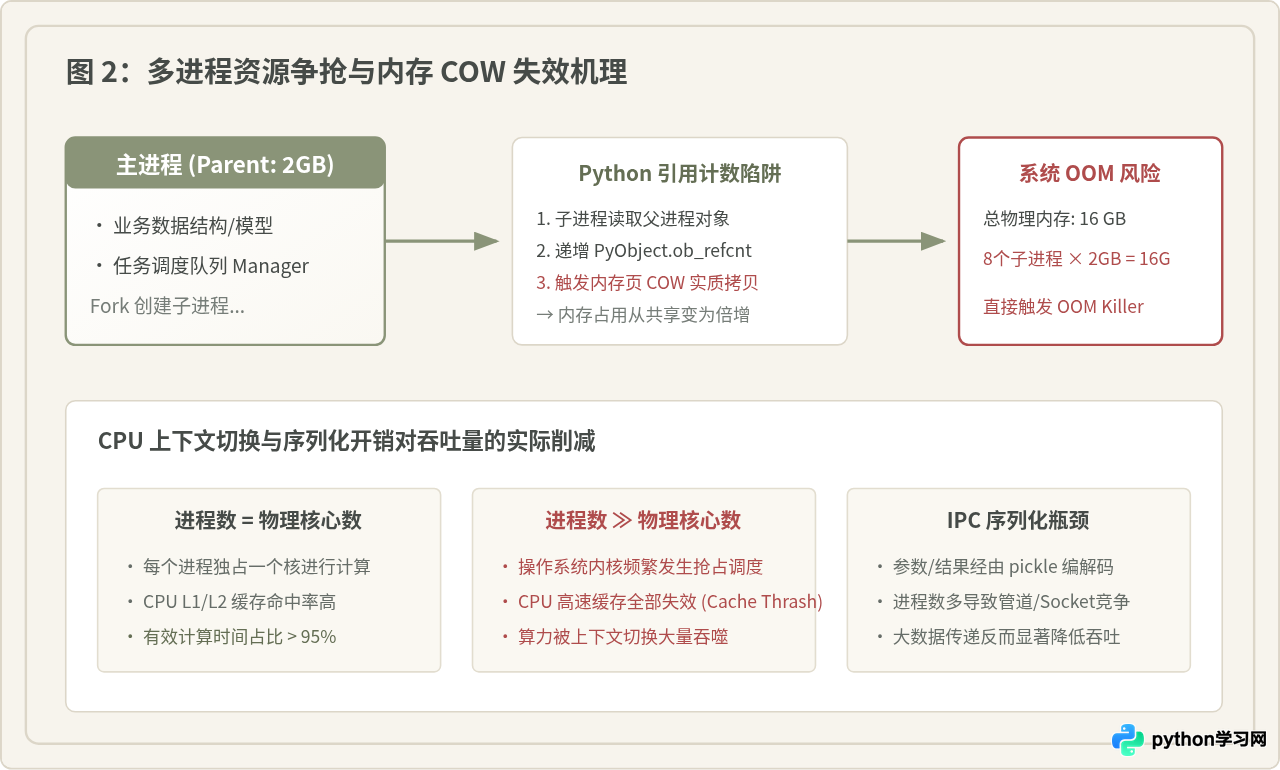
在 Linux 或 macOS 系统上,默认通过 fork 系统调用创建子进程时,操作系统宣称支持“写时复制”(Copy-on-Write, COW),即父子进程初始共享同一份内存物理页。然而在 Python 内部,对象的引用计数机制(Reference Counting)和垃圾回收周期检测会在对象被读取时修改元数据内存。这就意味着,即便子进程只是在读取父进程预先加载的大模型、字典或数据矩阵,由于引用计数的递增,内存页也会迅速发生实质性的私有拷贝(Dirty Copy)。
若父进程占用了 2GB 内存,启动 10 个子进程并开始执行任务后,整体物理内存占用并非共享的 2GB,而是可能迅速飙升至 15GB~20GB,导致物理内存耗尽并触发系统的 OOM Killer,直接将正在运行的主进程或关键服务强行杀死。
2. CPU 缓存失效与上下文切换震荡
每一个处于运行态的进程在切换时,操作系统都需要保存寄存器状态、刷新页表映射(TLB 换页),并破坏 CPU 的一级/二级指令与数据缓存。当设置的进程数远超 CPU 计算单元时,CPU 就会在不断切换进程上下文的损耗中空转,最终呈现出“CPU 利用率高达 100%,而业务实际吞吐量却直线下降”的假死特征。
3. 进程间通信(IPC)与 Pickle 序列化瓶颈
在 Python 的 multiprocessing.Pool 中,主进程向子进程分派任务参数、子进程向主进程返回执行结果,底层依赖操作系统管道(Pipe)或套接字,并使用 pickle 模块进行二进制序列化与反序列化。如果单次任务传递的数据体积较大(如数千行 Pandas DataFrame 或高维 NumPy 数组),进程数越多,主进程与队列锁的争抢就越激烈,反倒导致大部分时间消耗在数据打包传输与排队等待上。
三、常见认知误区辨析
在关于多进程优化的讨论中,存在几个广为流传但条件极其严苛的说法。辨析这些观点有助于避开生产事故:
为什么看似合理:直觉上,有多少个 CPU 核心就跑多少个工作进程,能够实现硬件算力的 100% 榨取。
在什么条件下成立:当程序运行在独立无外部干扰的物理裸机上、任务完全是纯 CPU 算术运算,且单进程内存占用极低(例如仅几十 MB)、系统无其他常驻守护进程时,此结论成立。
在哪里需要修正:
1. 超线程(SMT)误区:os.cpu_count() 返回的是逻辑核心数。对于严重依赖浮点单元或缓存带宽的任务,两个逻辑核心共享同一个物理运算核心,设为逻辑核心数会导致资源争用,通常按物理核心数设值性能反而更稳定。
2. 容器陷阱:在 Docker / K8s 环境中,即使给容器配置了 2 CPUs 配额,如果宿主机有 64 核,os.cpu_count() 依然会返回 64。盲目开启 64 个进程会导致容器瞬时触发 cgroup cpu quota 限流(CPU Throttling),严重降级响应速度。
为什么看似合理:当一个进程在等待网络请求或磁盘读取时,它会阻塞并让出 CPU,因此增加进程似乎能让更多请求并发进行。
在什么条件下成立:只有在并发数量较小(如 5~8 个)、且无法引入外部事件驱动库的极少数老旧系统下可以临时应急。
在哪里需要修正:每个 Python 进程的基础内存开销通常在 30MB~80MB 以上。如果为了并发 500 个 HTTP 请求而启动 500 个进程,内存开销将高达 30GB+,进程创建与销毁的系统调用也会将内核拖垮。对于 IO 密集型,正确的解决方案是协程(asyncio)或轻量级线程池(ThreadPoolExecutor),线程能共享主进程内存,且在网络 IO 阻塞时 Python 会自动释放 GIL。
四、四步实操:合理计算并配置生产级进程数
合理确定进程数,可以按以下四个明确步骤进行推导与落地:
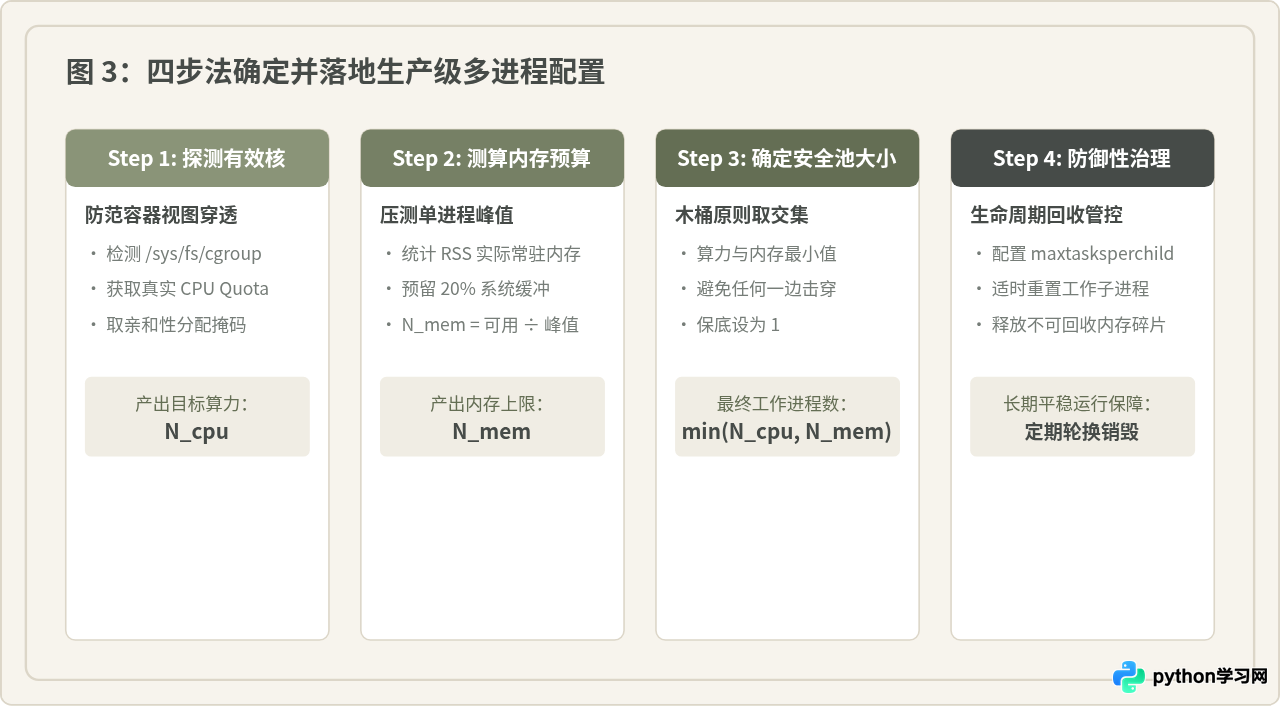
步骤 1:精确探测真实可用核心数(适配裸机与容器)
在现代部署环境中,直接调用 os.cpu_count() 存在隐患。推荐优先使用 Python 3.4+ 提供的 os.sched_getaffinity(0) 获取当前进程被允许绑定的 CPU 核心集合;在容器环境下,需读取 cgroups 的配额参数计算实际核数。
import os
import math

def get_available_cpus() -> int:
    """获取当前运行环境真正可用的 CPU 核心数(兼容 Docker/K8s 容器与裸机)"""
    # 1. 尝试读取 Linux cgroups 配额 (cgroup v2 或 v1)
    # cgroup v2: /sys/fs/cgroup/cpu.max
    # cgroup v1: /sys/fs/cgroup/cpu/cpu.cfs_quota_us & cpu.cfs_period_us
    try:
        if os.path.exists('/sys/fs/cgroup/cpu.max'):
            with open('/sys/fs/cgroup/cpu.max', 'r') as f:
                parts = f.read().strip().split()
                if len(parts) == 2 and parts[0] != 'max':
                    quota, period = int(parts[0]), int(parts[1])
                    return max(1, math.floor(quota / period))
        elif os.path.exists('/sys/fs/cgroup/cpu/cpu.cfs_quota_us'):
            with open('/sys/fs/cgroup/cpu/cpu.cfs_quota_us', 'r') as f_quota,                  open('/sys/fs/cgroup/cpu/cpu.cfs_period_us', 'r') as f_period:
                quota = int(f_quota.read().strip())
                period = int(f_period.read().strip())
                if quota > 0 and period > 0:
                    return max(1, math.floor(quota / period))
    except Exception:
        pass

    # 2. 读取进程调度亲和性 (获取实际分配给本进程的CPU集)
    if hasattr(os, 'sched_getaffinity'):
        try:
            return max(1, len(os.sched_getaffinity(0)))
        except OSError:
            pass

    # 3. 回退为基础核心探测
    return max(1, os.cpu_count() or 1)
步骤 2:测算单进程内存峰值并划定内存红线
单进程内存峰值可以通过标准库 resource 模块在单次任务执行完毕后获取(resource.getrusage(resource.RUSAGE_SELF).ru_maxrss)。获取后,必须按照以下规则计算允许的最大并发进程数:
import psutil

def calculate_safe_process_count(single_task_mem_mb: float) -> int:
    """
    根据可用物理内存与单进程峰值估算安全进程数
    :param single_task_mem_mb: 单个子进程在任务峰值时的内存开销 (MB)
    """
    cpu_limit = get_available_cpus()

    # 获取系统当前空闲物理内存 (MB)
    available_mem_mb = psutil.virtual_memory().available / (1024 * 1024)

    # 预留 20% 安全余量用于主进程及系统关键开销
    safe_mem_budget = available_mem_mb * 0.80

    # 计算内存上限允许的进程数
    mem_limit = max(1, math.floor(safe_mem_budget / single_task_mem_mb))

    # 最终取两者的交集
    recommended_workers = min(cpu_limit, mem_limit)
    return recommended_workers
步骤 3:防止内存碎片累积(必须设置 maxtasksperchild)
C 端扩展库(例如 NumPy、Pandas、TensorFlow、OpenCV)以及 Python 内部的内存分配器(pymalloc)在频繁申请、释放大型对象时,容易产生堆内存空洞(Memory Fragmentation),导致进程向操作系统索要的虚拟内存持续增长而不归还。
在生产环境中,使用 multiprocessing.Pool 时务必指定 maxtasksperchild 参数(例如设为 100~500)。当子进程执行满指定数量任务后会自动退出,主进程会透明地创建一个崭新的子进程接替工作,从而彻底释放不可回收的堆内存碎片。
from multiprocessing import Pool
import time

def process_heavy_task(item_id: int):
    # 模拟数据处理
    return item_id * 2

if __name__ == '__main__':
    # 动态评估出的安全工作进程数
    safe_workers = 4

    # 关键参数:maxtasksperchild=100
    # 每个子进程处理 100 个任务后自动销毁重建,彻底阻断内存隐式泄露
    with Pool(processes=safe_workers, maxtasksperchild=100) as pool:
        data_inputs = list(range(1000))
        results = pool.map(process_heavy_task, data_inputs)
        print(f"成功完成 {len(results)} 个任务处理")
五、总结与多场景参数速查
为了在排查与架构设计时迅速选定最佳参数,可以将常见的典型业务场景归纳为下方的全景速查图与对比规范:
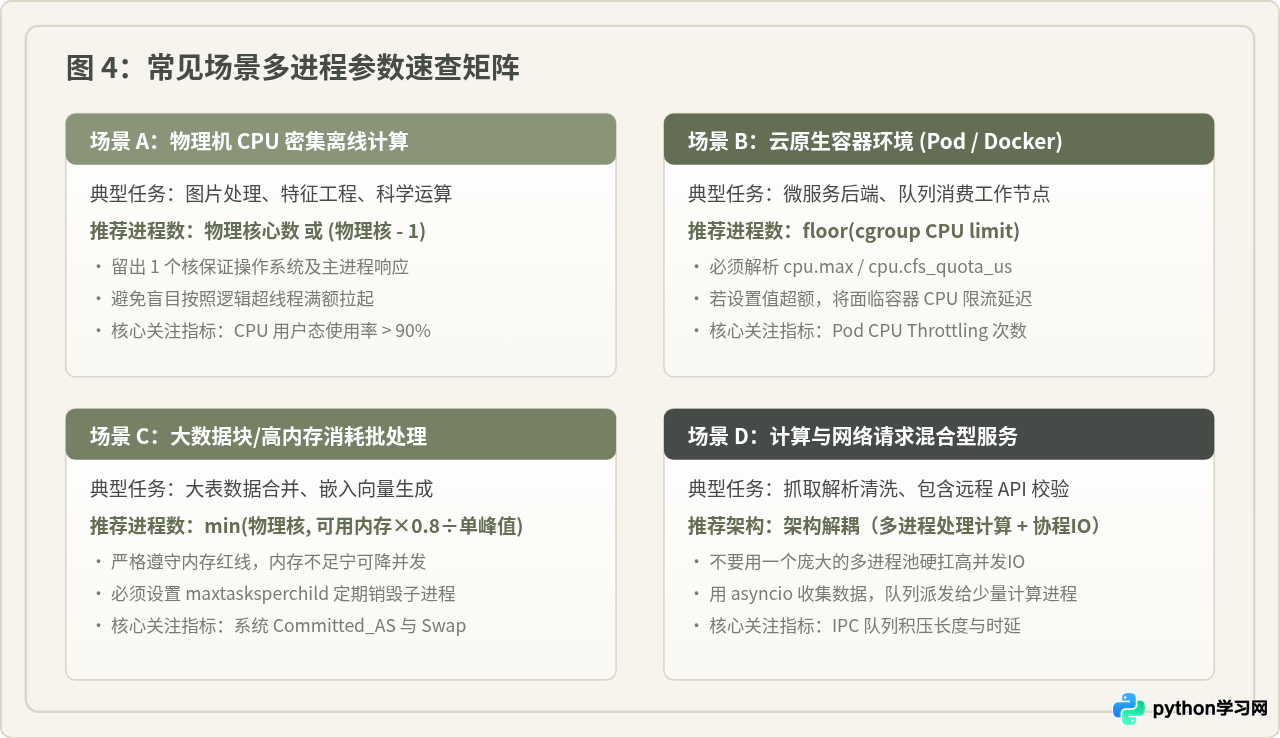
合理设置 Python 进程数的本质,是在硬件承受能力与任务算力需求之间建立平衡。永远先通过实测厘清单进程内存占用,利用系统亲和性或容器配额探测算力上限,并取两者的保守交集。在代码层面,配合 maxtasksperchild 防范不可逆的堆碎片累积,才能让多进程并发稳定高效地服务于生产环境。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









