

Python正则匹配中文:常用Unicode范围与re模块写法

系统梳理Python中利用内置re模块匹配中文文本的实现方案,详解常用Unicode汉字区块与标点符号范围、经典正则模式、生僻字处理及常见应用场景。
在 Python 中匹配中文字符,核心在于掌握 Unicode 字符集中的汉字及中文标点编码区间,并结合标准库 re 的字符类语法进行提取、校验或清洗。常规场景下,基础汉字范围 [\u4e00-\u9fa5] 能够满足绝大多数需求;若涉及新近收录汉字、生僻字或中文专用标点,则需要将范围适当扩展至 [\u4e00-\u9fff] 及相关辅助区块。
一、核心 Unicode 汉字范围解析
Python 3 原生支持 Unicode 编码体系,程序中的字符串类型(str)默认均以 Unicode 码点形式存储。因此,在 Python 正则表达式中匹配中文字符,无需将其转换为十六进制字节流,只需指明字符对应的 Unicode 码位十六进制区间即可。
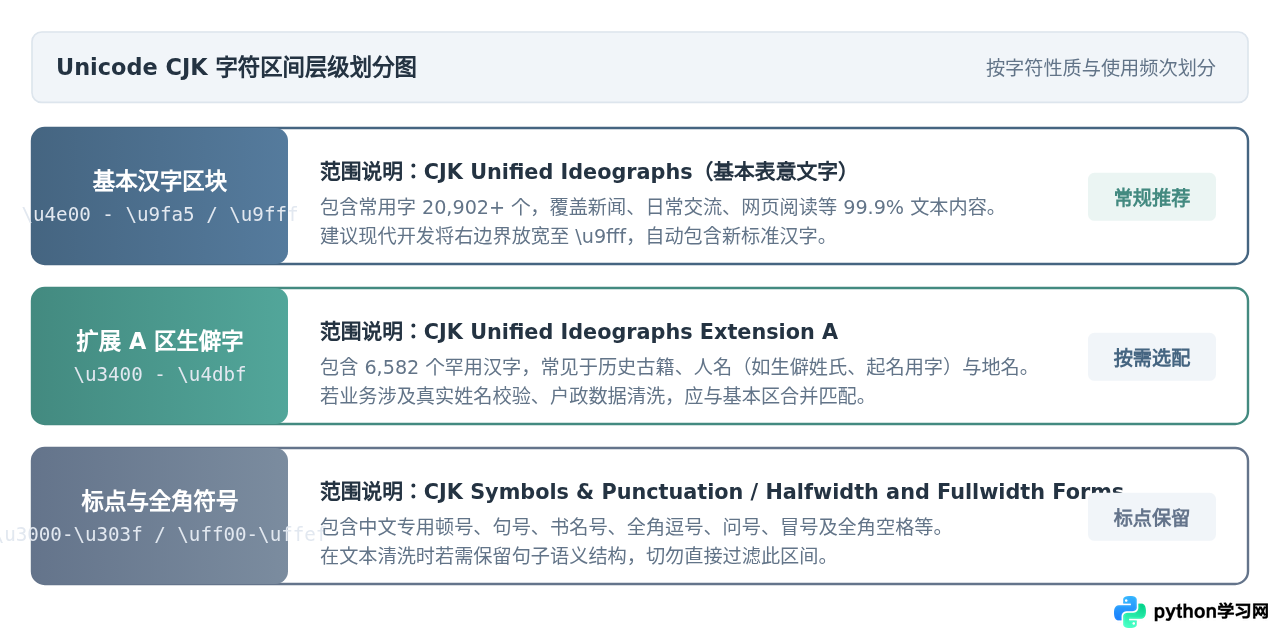
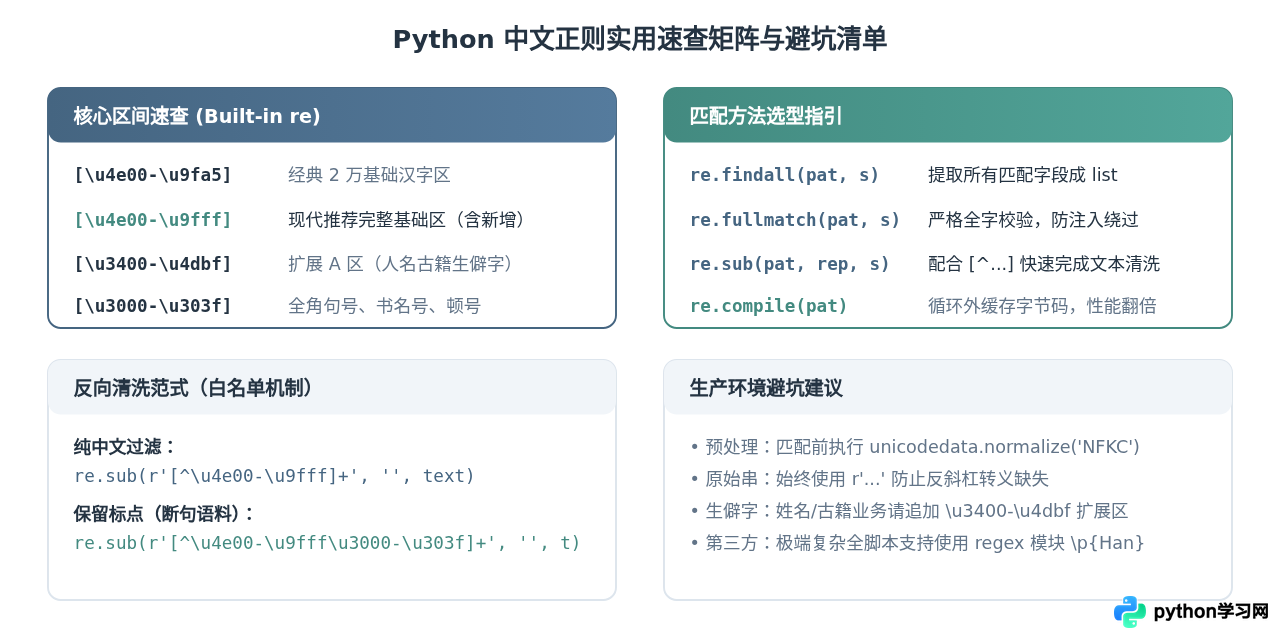
在 Unicode 标准中,汉字被归类在 CJK 统一表意文字(CJK Unified Ideographs) 及其扩展区块中。以下是进行中文匹配时最常涉及的几类编码区间:
| 分类名称 | 十六进制范围 | 涵盖字符数 | 使用场景与说明 |
|---|---|---|---|
| CJK 基本汉字(经典范围) | \u4e00 - \u9fa5 |
20,902 字 | Unicode 4.1 以前的标准范围,涵盖绝大多数日常常用字,历史代码中使用最普遍。 |
| CJK 基本汉字(当前完整区) | \u4e00 - \u9fff |
20,992 字 | 包含后续版本追加的基本汉字,覆盖更全面,推荐作为现代业务代码的标准基础区间。 |
| CJK 扩展 A 区 | \u3400 - \u4dbf |
6,582 字 | 主要包含古籍生僻字、特定人名地名汉字(如“䶮”、“㭎”等),户籍、文献系统建议包含。 |
| CJK 符号与标点 | \u3000 - \u303f |
64 个码位 | 中文全角空格、句号(。)、顿号(、)、书名号(《》)等专用中文符号。 |
| 半角及全角形式 | \uff00 - \uffef |
240 个码位 | 包含中文输入法常见的全角逗号(,)、全角冒号(:)、全角问号(?)与全角叹号(!)。 |
二、Python 标准库 re 模块基础写法与常用操作
Python 标准库提供了内置模块 re。在编写针对中文的正则表达式时,需要注意在字符串前添加原始字符串前缀 r(如 r'[\u4e00-\u9fa5]'),避免反斜杠在 Python 解释器层和正则解析层发生二次转义。
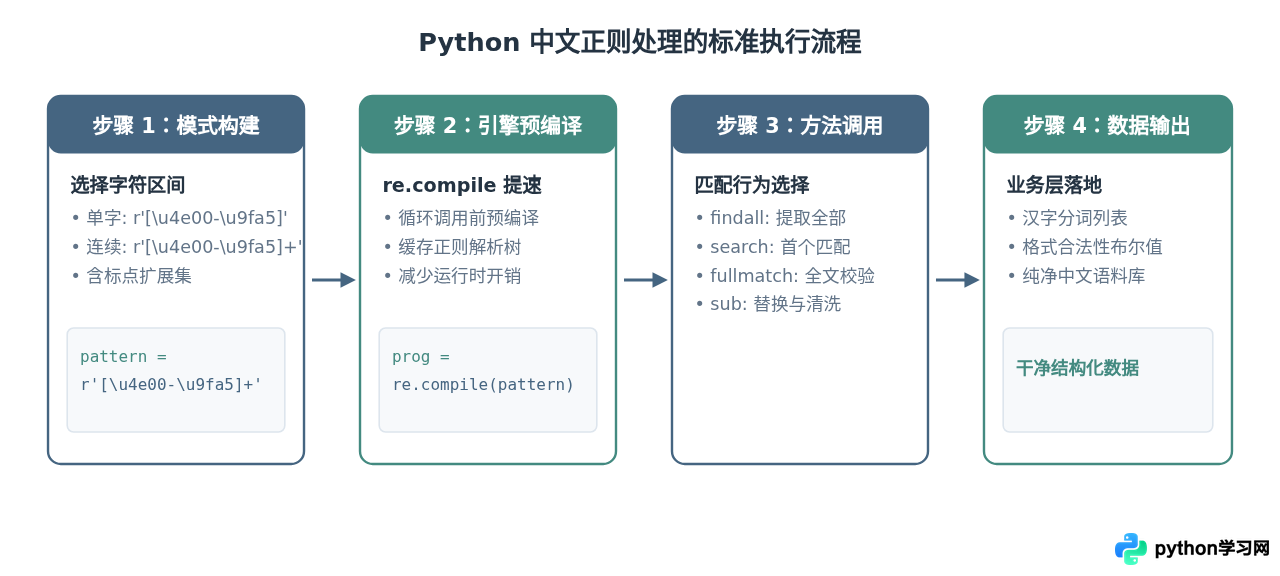
1. 提取所有中文词段:re.findall
当需要从包含中英混排、数字及特殊符号的杂乱字符串中将所有中文字段单独提取出来时,最直接的方式是使用 re.findall 并配合加号(+)贪婪量词:
import re

text = "2026年Q1季度财报显示:净利润同比增长18.5%,营收超出预期!"

# 匹配由一个或多个连续汉字组成的字符串片段
pattern = r'[\u4e00-\u9fa5]+'
chinese_words = re.findall(pattern, text)

print(chinese_words)
# 示例输出:['年', '季度财报显示', '净利润同比增长', '营收超出预期']
2. 检验文本是否全为中文:re.fullmatch
在表单验证或数据清洗场景中,通常需要确认用户输入(如“真实姓名”)是否完全由纯汉字构成。推荐使用 re.fullmatch 方法,它会从字符串起始严格校验到结尾,避免漏写锚点 ^ 与 $ 产生的逻辑疏漏:
import re

def is_all_chinese(text: str) -> bool:
    # 允许包含 2 到 10 个纯汉字
    pattern = r'[\u4e00-\u9fa5]{2,10}'
    return bool(re.fullmatch(pattern, text.strip()))

# 测试用例
print(is_all_chinese("张伟"))       # 示例输出: True
print(is_all_chinese("王小明A"))    # 示例输出: False (含英文字符)
print(is_all_chinese("李  雷"))    # 示例输出: False (含空格)
3. 过滤非中文字符(数据清洗):re.sub
在构建自然语言处理(NLP)语料或进行词频统计前,常需剔除所有数字、英文字母及符号。通过在字符集起始位置使用脱字符 ^ 表达取反逻辑,可以快速将非中文字符替换为空字符串:
import re

raw_comment = "这款手机太赞了!Battery lasts 2 days, 强烈推荐 (5/5星)~~"

# 将非汉字字符(即取反集合 [^\u4e00-\u9fa5])全部替换为空
clean_text = re.sub(r'[^\u4e00-\u9fa5]+', '', raw_comment)

print(clean_text)
# 示例输出:这款手机太赞了强烈推荐星
三、常见应用场景与模式决策树
实际业务场景中,“匹配中文”的需求往往不是单一的纯汉字匹配,而是涉及到中英文混合、中文与特定标点保留、或者生僻字提取等复杂情况。根据业务边界选择正确的正则表达式,能够避免过度清洗或漏匹配。
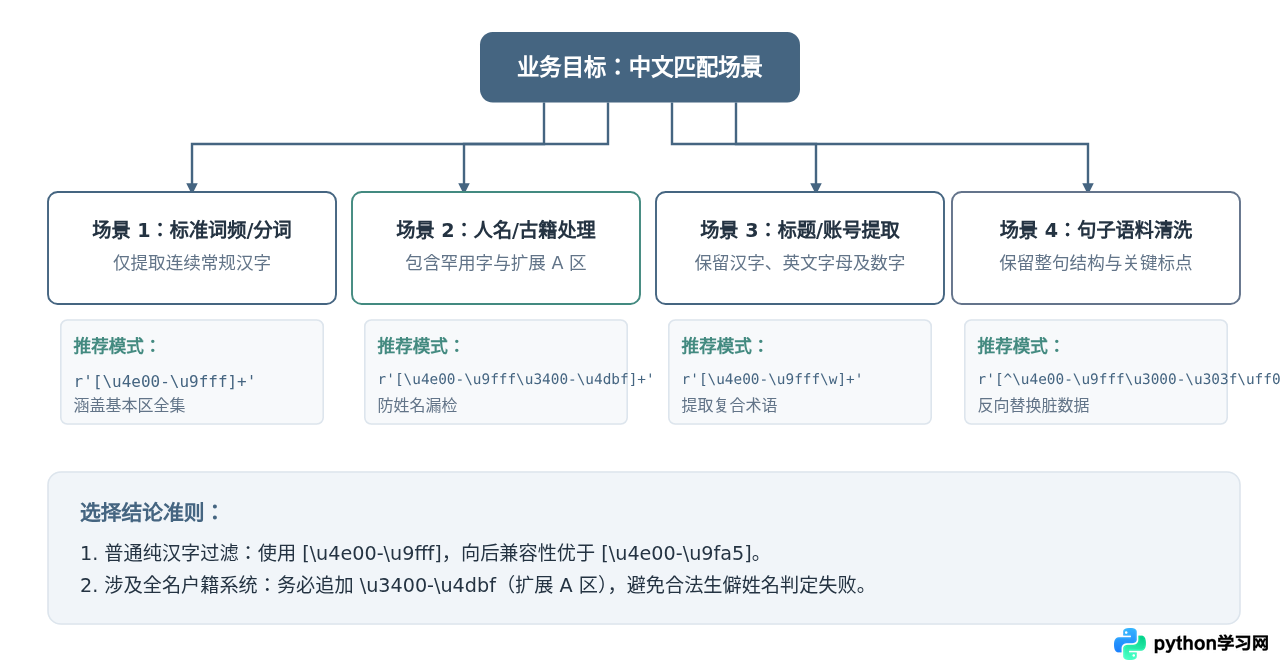
1. 保留中文标点符号的文本清洗
在许多 NLP 任务(如句子切分、情感分析)中,顿号、句号、逗号承载着句式节奏和转折关系。如果盲目过滤所有非 [\u4e00-\u9fa5] 字符,句子将被砸碎为失去语境的单字词。正确的做法是将中文常用标点区间加入白名单:
import re

text = "警告:温度过高!请立即检查(机房A-02)。"

# 保留汉字、常用中文标点(句号、感叹号、冒号、全角括号等)
# \u3002=。 \uff01=! \uff1a=: \uff08=\uff09=()
pattern = r'[^\u4e00-\u9fff\u3002\uff01\uff1a\uff08\uff09]+'
clean_sentence = re.sub(pattern, '', text)

print(clean_sentence)
# 示例输出:警告:温度过高!请立即检查(机房)。
2. 混合文本中精准拆分中英文段落
当需要从中英混杂的日志或技术文档中分别提取出中文与英文成分时,可以利用捕获组分别处理:
import re

content = "Python是一种广泛使用的High-level编程语言,语法清晰。"

# 提取所有连续的汉字词块与连续的英文单词
tokens = re.findall(r'[\u4e00-\u9fff]+|[a-zA-Z]+', content)

print(tokens)
# 示例输出:['Python', '是一种广泛使用的', 'High', 'level', '编程语言', '语法清晰']
四、进阶方案:使用第三方 regex 模块支持 \p{Han}
虽然内置的 re 模块完全能够通过显式指定 [\u4e00-\u9fff] 完成工作,但手动书写多段十六进制区间在可读性和维护性上较为繁琐,且 Unicode 标准在不断更新(新增 Extension B 至 G 等超大字符集)。
如果项目允许安装第三方依赖,regex 库是业界公认的更强大替代品。它原生支持 Unicode 字符属性(Unicode Property Scripts),只需书写 \p{Han} 或 \p{Script=Han} 即可自动适配当前 Python 环境支持的全部汉字区间。
# 安装方式:pip install regex
import regex

text = "包括常见汉字,以及生僻字如“𪚥”(四个龍)和“䶮”。"

# \p{Han} 能够原生匹配全部 Unicode 汉字(涵盖基本区、扩展A区以及增补平面的四字节字符)
matches = regex.findall(r'\p{Han}+', text)

print(matches)
# 示例输出:['包括常见汉字', '以及生僻字如', '𪚥', '四个龍', '和', '䶮']
若运行环境受限(如原生无外网服务器、轻量级脚本、标准微服务),内置 re 配合 [\u4e00-\u9fff] 是零依赖的最优选择;若涉及古籍数字化、大语料清洗或需要严格遵守 Unicode 属性规范,推荐使用 regex 模块。
五、核心注意事项与性能优化
在批量处理大规模中文文本(例如海量爬虫数据清洗、日志分析或百万级分词前置过滤)时,细节差异会对程序稳定性与吞吐效率造成明显影响:
-
在循环外部预编译正则表达式: 避免在
for循环中直接调用re.findall(...)。使用compiled_pat = re.compile(pattern)预编译后复用,能有效省去重复解析模式字符串的系统开销。 -
全半角混用的预先规范化: 中文输入法极易混入全角空格(
\u3000)、全角英文(如ABC)与全角数字(123)。在正则匹配前,使用标准库unicodedata.normalize('NFKC', text)先行转为标准半角,能大幅减少正则字符集编写的冗余度。 -
始终添加 Raw String 前缀: 养成书写
r'[\u4e00-\u9fff]'的习惯。省略r虽然在部分单斜杠转义中看似正常运行,但在涉及双重转义或反向引用时极易产生隐蔽 Bug。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









