

Python魔术方法为什么使用前后双下划线命名

深入解析Python魔术方法(dunder methods)采用前后双下划线命名的核心原因:命名空间隔离、协议钩子语义约定、与私有名称修饰的区别以及避免破坏语言未来演进的向下兼容性。
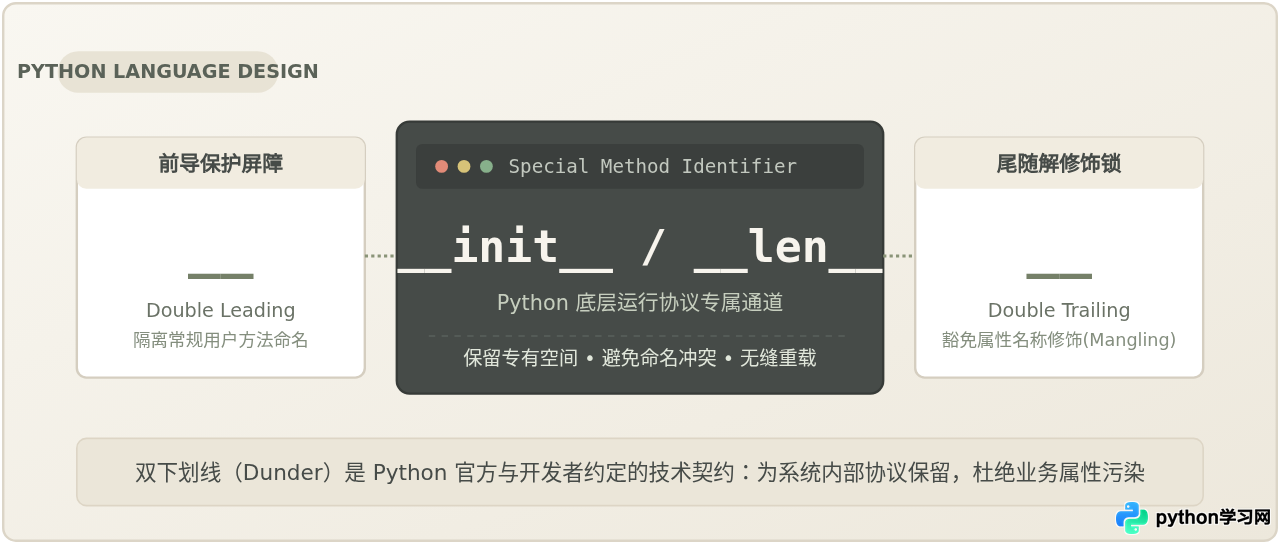
__init__、__len__、__str__),根本原因在于为语言解释器协议划分专属的保留命名空间。这种设计既避免了系统底层接口与开发者业务属性发生命名冲突,又豁免了双前导下划线的类名称修饰(Name Mangling),同时让 Python 核心团队在后续版本引入新协议时,无需新增语法关键字,也不会破坏全世界既有的用户代码。
一、命名空间的隔离:解决“协议钩子”与“业务命名”的天然冲突
在面向对象语言中,如何让开发者自定义的类能够与语言运行时的基础语法(例如运算符、类型转换、迭代循环、容器访问)自然融合,是一个核心设计问题。
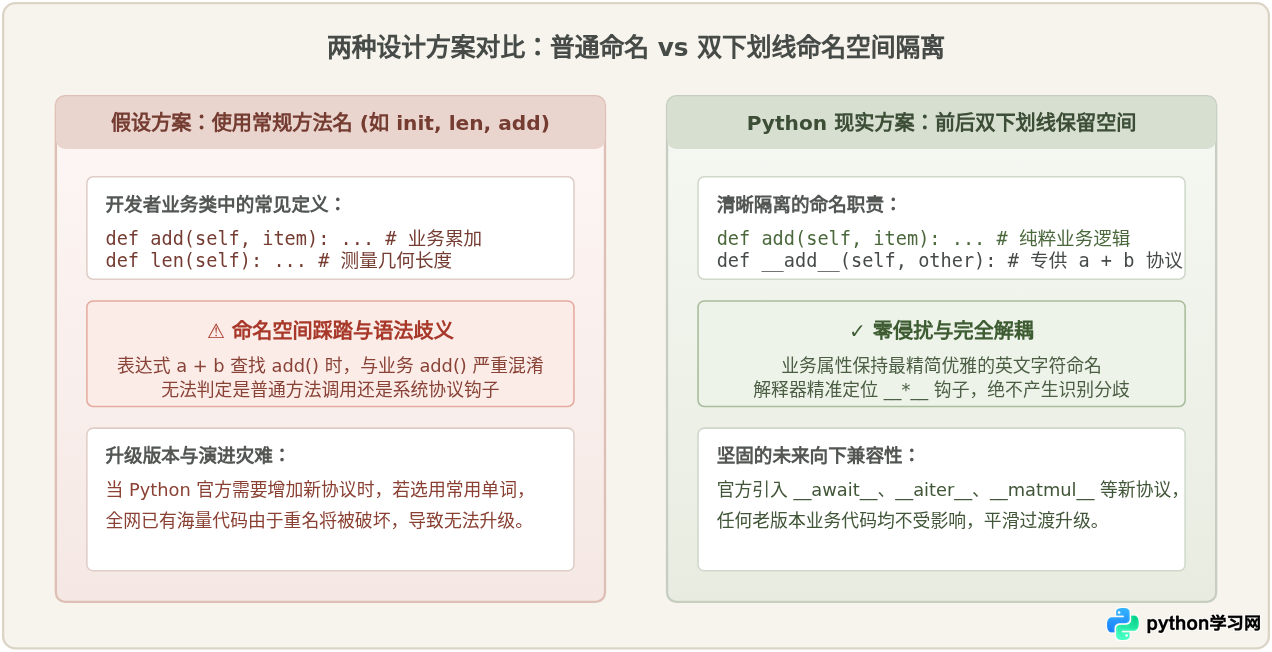
以获取对象长度为例,Python 提供了统一的内置函数 len(obj)。如果 Python 规定:只要用户在类里定义一个名为 length() 或 len() 的普通方法,解释器就去调用它,表面看起来很直观,但在实际工程中会引发极具破坏性的冲突。
1. 业务概念重名带来的灾难
在真实业务系统中,“长度”(length/size)、“添加”(add)、“初始化”(init)、“打开”(open)都是极其高频的普通词汇。例如:
- 在订单处理类
Order中,开发者可能需要定义一个用于累加商品的业务方法order.add(item); - 在木材加工系统中,开发者需要定义测量物理长度的属性
wood.length; - 如果内置的加法运算符
+依赖名为add的方法,那么只要开发者写下order.add(item),解释器就无法分辨这究竟是加法重载还是单纯的业务动作。
2. 保证语言未来版本的向后兼容性
更严重的隐患在于语言的演进。假设 Python 1.5 时代没有双下划线约定,所有特殊方法都使用普通单词。当 Python 3.5 需要引入协程异步等待协议时,如果官方决定使用 obj.await(),那么全球数以万计早已在业务代码中使用了 await 方法或变量的项目,在升级 Python 解释器时将瞬间全部崩溃。
正如 Python 官方文档和 PEP 8 所阐明:__*__ 属于 Python 语言核心的系统保留命名空间。因为日常业务代码绝不会以 __foo__ 作为常规函数名,Python 核心团队就可以在未来的版本中自由增添新的协议钩子(如 __await__、__aiter__、__anext__),而完全不用担心踩踏用户的业务代码。
二、语法糖与底层分发:Python 如何调度魔术方法
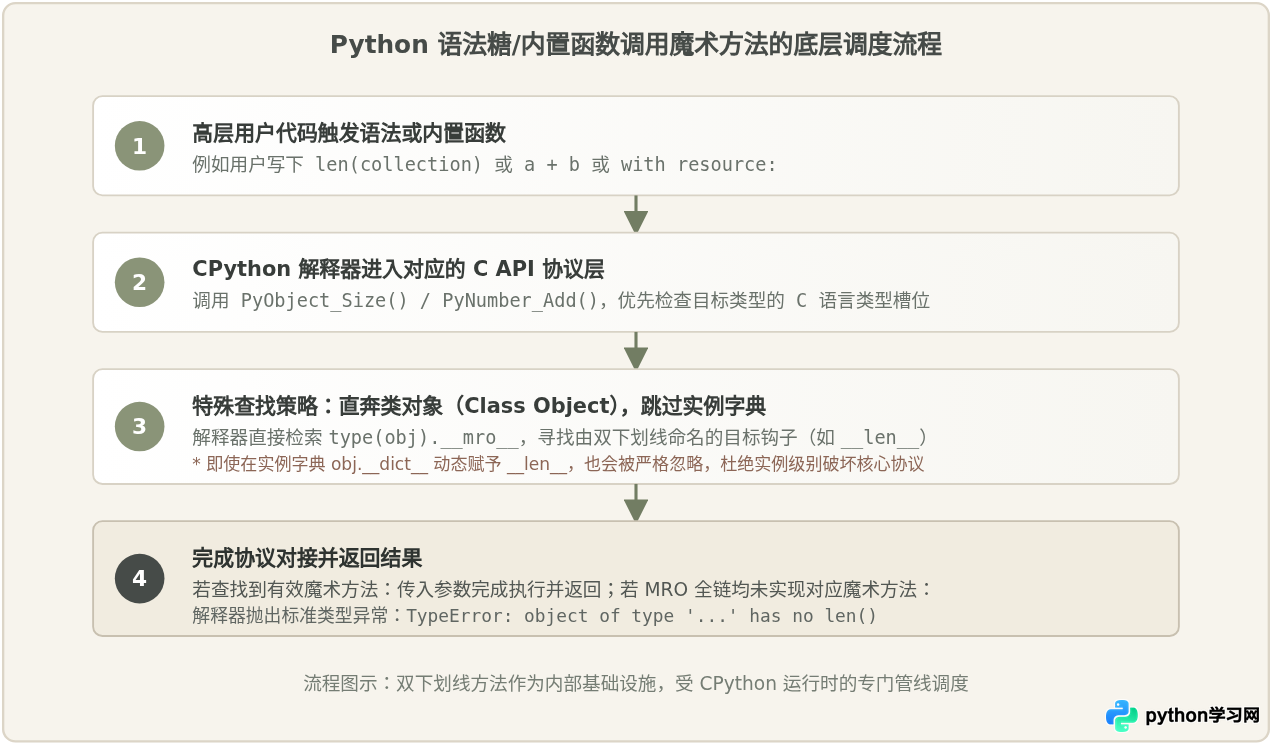
Python 魔术方法的另一个核心特点在于:它们通常由**高层语法糖或内置函数在底层隐式触发**,而非供用户日常显式调用。
1. 为什么设计为 len(x) 而非 x.len()?
在《Fluent Python》及核心开发者邮件列表中,Guido van Rossum 曾明确解释过这种设计风格:
- 对于内置的基础类型(如
str、list、dict),Python 解释器在 C 语言层面维护了高效的结构体。调用len(s)时,CPython 并不需要走复杂的常规属性字典查找,而是直接读取结构体中的ob_size字段,效率极高。 - 对于自定义类,
len(obj)会通过类型对象的 C 槽位(如tp_as_sequence->sq_length或tp_as_mapping->mp_length)转发至用户定义的__len__方法。 - “内置函数 + 特殊方法钩子”的架构,实现了“基础内置类型极致高效,自定义扩展类型高度灵活”的统一抽象。
2. 特殊方法查找绕过实例字典(Special Method Lookup)
为了保证解释器性能与安全,魔术方法的查找具有特殊规则:**它直接在对象的类(Class)及其继承链(MRO)上查找,而绕过实例自身的属性字典(__dict__)**。
例如以下代码展示的边界情况:
class Demo:
    pass

demo = Demo()
# 试图在实例上动态绑定 __len__
demo.__len__ = lambda: 42

try:
    # 调用 len(demo) 会直接报错,因为解释器只在 type(demo) 即 Demo 类上查找 __len__
    print(len(demo))
except TypeError as e:
    print("捕获异常:", e)
# 示例输出:捕获异常: 'Demo' object has no attribute '__len__'
这种机制确保了元类型体系与底层协议的不可篡改性,也进一步说明了 __name__ 并不是类里的普通成员,而是深深锚定在 Python 解释器执行循环中的协议钩子。
三、辨析与混淆:四种下划线命名模式的本质差异
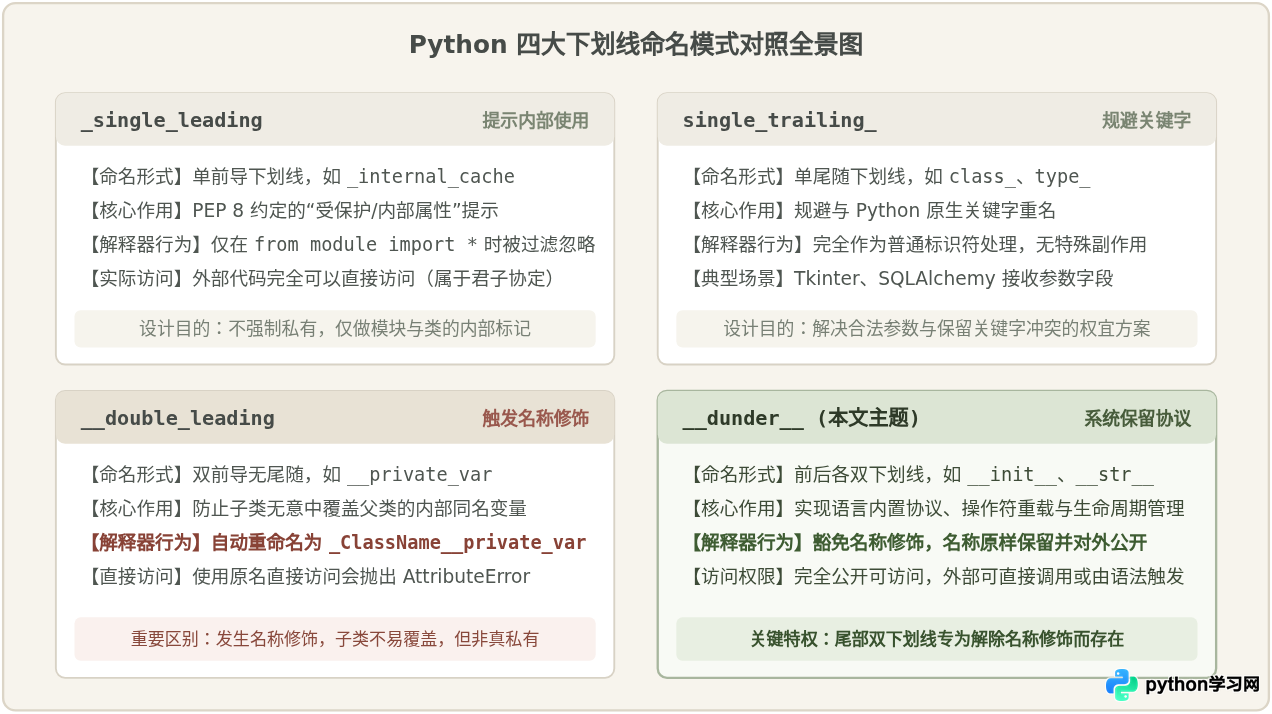
许多初学 Python 的开发者常将“单下划线”、“双下划线”与“前后双下划线”混为一谈,甚至误认为“前后双下划线是 Python 最高的私有权限”。这是一种完全错误的认知。
下表和结构图清晰展示了 Python 中四种典型下划线模式在语法含义、编译器行为及访问级别上的本质差异:
为什么必须有尾随的双下划线?——解除名称修饰(Name Mangling)
这是理解 dunder 命名的最精妙之处:如果只有前导两个下划线(例如 __init),Python 编译器会启动“名称修饰”机制。
在 Python 中,当类属性以至少两个下划线开头且最多一个下划线结尾时(如 __spam),解释器会在词法解析期将其文本重写为 _ClassName__spam。这样做的本意是避免多层继承时子类意外覆盖父类的变量。
但是,魔术方法是协议接口,它必须跨越整个继承体系自由多态覆写!子类必须能够覆盖父类的 __init__、__str__ 或 __len__。如果魔术方法只用前导双下划线,它们就会被修饰为 _Parent__init 和 _Child__init,导致继承多态彻底失效。
四、常见误区澄清与开发者实战准则
误区一:“魔术方法带有双下划线,代表它是私有的,不能从外部调用”
纠正:魔术方法完全是公开的。前后双下划线从来不是访问控制符(Python 本身就没有真正的私有关键字 private)。虽然日常编程中提倡使用高层语法(如用 str(obj) 代替 obj.__str__()),但从外部直接调用魔术方法在语法上是完全合法的。
class User:
    def __init__(self, name):
        self.name = name

    def __str__(self):
        return f"User({self.name})"

u = User("Alice")

# 推荐写法:通过内置函数触发协议
print(str(u))        # 示例输出: User(Alice)

# 语法完全合法:直接调用也是畅通无阻的
print(u.__str__())  # 示例输出: User(Alice)
误区二:“我可以给自己编写的工具方法起名为 __custom__ 吗?”
纠正:千万不要这样做。在代码中自定义类似 __my_process__、__parse_data__ 的方法不仅毫无意义,而且违反了 PEP 8 规范。
PEP 8 明确规定:“永远不要发明属于自己的 __*__ 名字;仅按照文档规范使用已有的魔术方法”。如果你自己发明了 __audit__ 方法,虽然当前解释器能正常运行,但如果在未来的某一个 Python 版本中,官方正好也引入了一个名为 __audit__ 的核心协议钩子,你的系统在升级后就会出现意料之外的严重 bug。
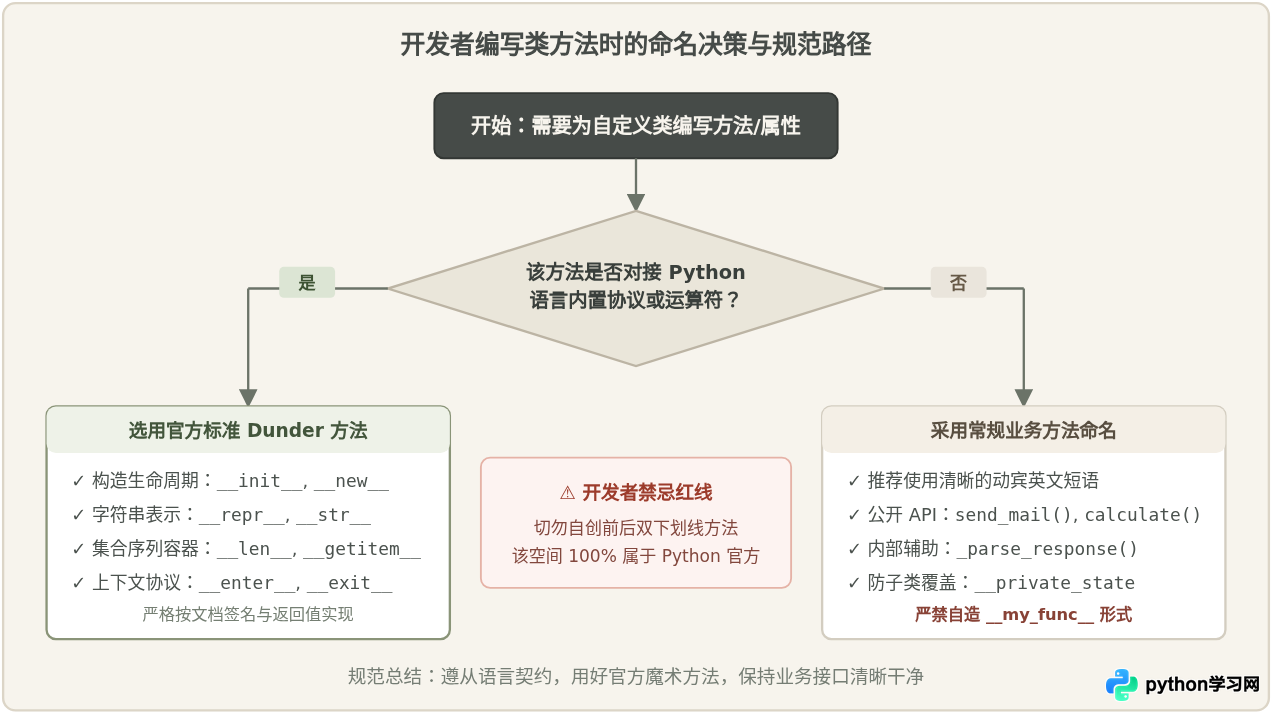
五、总结与设计启示
Python 魔术方法采用前后双下划线命名,绝非随意的审美偏好,而是一套经过深思熟虑且历经数十年检验的**语言架构契约**:
- 命名空间隔离:为语言内置协议建立“围栏”,彻底解决运算符重载、内置函数钩子与开发者日常业务词汇之间的命名重叠。
- 解修饰与多态支持:通过尾随的双下划线解除编译器对前导双下划线的名称修饰(Name Mangling),使得协议方法能够顺畅地在继承体系中多态重写。
- 保证未来演进的兼容性:Python 核心团队无需为了新增特性频繁修改语法关键字,引入新协议时不会破坏存量代码。
- 认知明确度:在阅读代码时,
__dunder__形式能够向所有开发者传递极其强烈的视觉信号——“这是一个底层的系统协议,由 Python 运行时接管并调度”。
理解了这层设计理念,开发者在日常编码时就能更加自如地通过实现既有的魔术方法让自定义对象拥有 Pythonic 的表现力,同时恪守命名界限,写出更加稳定、优雅的 Python 程序。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









