

Python函数返回值是什么:return语句与默认None机制解析

return 语句传递给调用方的数据或对象引用。如果没有显式书写 return 语句,或者仅写了 return 后面不带任何表达式,Python 解释器都会隐式地返回单例对象 None。返回值是函数对外输出结果、与上下文协同的核心纽带。本文将从函数调用栈与数据流转机制切入,详细解析 return 语句求值与控制流短路特性,深入对比显式返回值与隐式 None 的运行时差异,并结合元组解包、类型注解及原地操作避坑实践,帮助读者建立对 Python 返回值机制的完整理解。
一、函数返回值的本质与数据流转机制
要理解返回值是什么,首先需要理清函数在调用时的执行模型。当一个 Python 函数被调用时,解释器会在调用栈(Call Stack)上为该函数分配一个新的栈帧(Stack Frame)。函数的形参接收调用者传入的实参引用,并在函数体内部的局部命名空间中分配局部变量。
在这个过程中,函数内部所创建的变量属于局部作用域,外界环境无法直接访问。如果调用方需要使用函数计算的产物,就必须通过返回值机制进行移交。当代码执行到 return 语句时,解释器会计算该语句后方的表达式,并将计算结果对象的内存地址(在 CPython 层面即 PyObject* 指针)传递回主调函数的上下文中。随后,被调函数的栈帧被弹出销毁,其内部未被外部引用的局部变量将被垃圾回收机制清理。
1. 控制台输出与返回值的本质差异
初学者在编写函数时,经常容易混淆 print() 打印与 return 返回的概念。这两种操作在语义和计算机底层运作上具有根本性的区别:
- print() 属于 I/O 副作用:它的职责是将数据转换为字符串并发送到标准输出流(如控制台终端屏幕),供人类开发者阅读。该输出不具有程序流动性,无法被外部变量捕获用于后续计算。
- return 属于数据流动契约:它的职责是将运行结果对象安全交接到调用者手中,调用者可以将其赋值给变量,存储在容器中,或作为实参传递给下一个函数。
通过以下对照示例可以直观看到两者的行为差异:
# 示例一:仅执行 print 打印
def calculate_tax_print(amount):
    tax = amount * 0.1
    print(f"税费计算完成:{tax}")  # 仅在终端打印字符

# 示例二:使用 return 回传数据
def calculate_tax_return(amount):
    tax = amount * 0.1
    return tax  # 将浮点数对象引用交回调用者

# 测试调用
res1 = calculate_tax_print(100)
# 终端输出:税费计算完成:10.0
print(f"res1 接收到的内容:{res1},类型:{type(res1)}")
# 输出结果:res1 接收到的内容:None,类型:<class 'NoneType'>

res2 = calculate_tax_return(100)
print(f"res2 接收到的内容:{res2},后续计算结果:{res2 + 5}")
# 输出结果:res2 接收到的内容:10.0,后续计算结果:15.0
如果尝试对 res1 执行加法运算(如 res1 + 5),解释器会立即抛出 TypeError: unsupported operand type(s) for +: 'NoneType' and 'int' 异常。这充分说明:只有 return 才能真正实现函数间的数据传递。
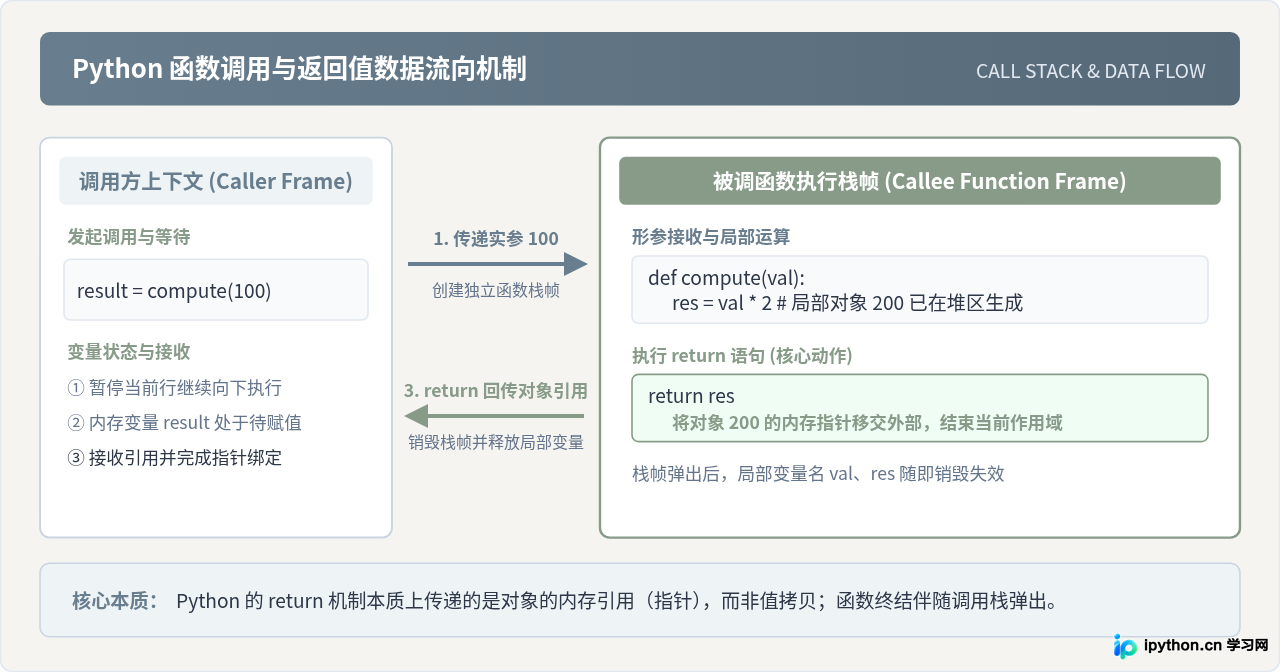
二、return 语句的工作原理与控制流短路
在 Python 语法体系中,return 语句承担着“数据产出”与“执行中断”双重职责。深入理解其执行生命周期,有助于写出结构紧凑且易于维护的高质量代码。
1. 表达式求值与立即终止
当解释器遇到 return <expression> 时,其执行流程分为严格的两个阶段:
- 求值阶段:先对
return右侧的表达式进行求值。若表达式涉及复杂的函数嵌套或算术运算,解释器会先将其归约为一个具体的对象。 - 短路阶段:一旦获得求值对象,当前函数的执行流程立即终止,控制权立刻返回到调用点。同级代码块中位于该
return之后的任何语句都不会被执行。
def demo_short_circuit():
    print("步骤 1:函数开始执行")
    return "已成功返回"
    print("步骤 2:这里的代码永远不会执行")  # 死代码(Unreachable Code)

val = demo_short_circuit()
# 终端仅输出:步骤 1:函数开始执行
2. 卫语句(Guard Clauses)设计模式
利用 return 立即中断的特性,工程上推崇采用“卫语句”重构复杂的多层嵌套逻辑。当入参不满足前置条件或命中边界情况时,立即通过 return 提前退出,从而使正常业务流程保持平铺直叙,极大降低代码的认知复杂度。
# 改进前:深层嵌套,阅读负担重
def process_user_nested(user):
    if user is not None:
        if user.is_active:
            if user.has_permission:
                return "操作成功"
            else:
                return "权限不足"
        else:
            return "账号已冻结"
    else:
        return "用户不存在"

# 改进后:卫语句提前 return,逻辑扁平清爽
def process_user_guard(user):
    if user is None:
        return "用户不存在"
    if not user.is_active:
        return "账号已冻结"
    if not user.has_permission:
        return "权限不足"

    # 核心业务逻辑直接展开
    return "操作成功"
3. 多返回值语法与元组打包解包机制
在很多实际业务中,一个函数需要同时产出多个统计指标,例如同时返回一个列表的最大值、最小值与平均值。Python 提供了非常优雅的多返回值写法:
def get_dataset_stats(numbers):
    min_val = min(numbers)
    max_val = max(numbers)
    avg_val = sum(numbers) / len(numbers)
    return min_val, max_val, avg_val  # 逗号分隔的多个值
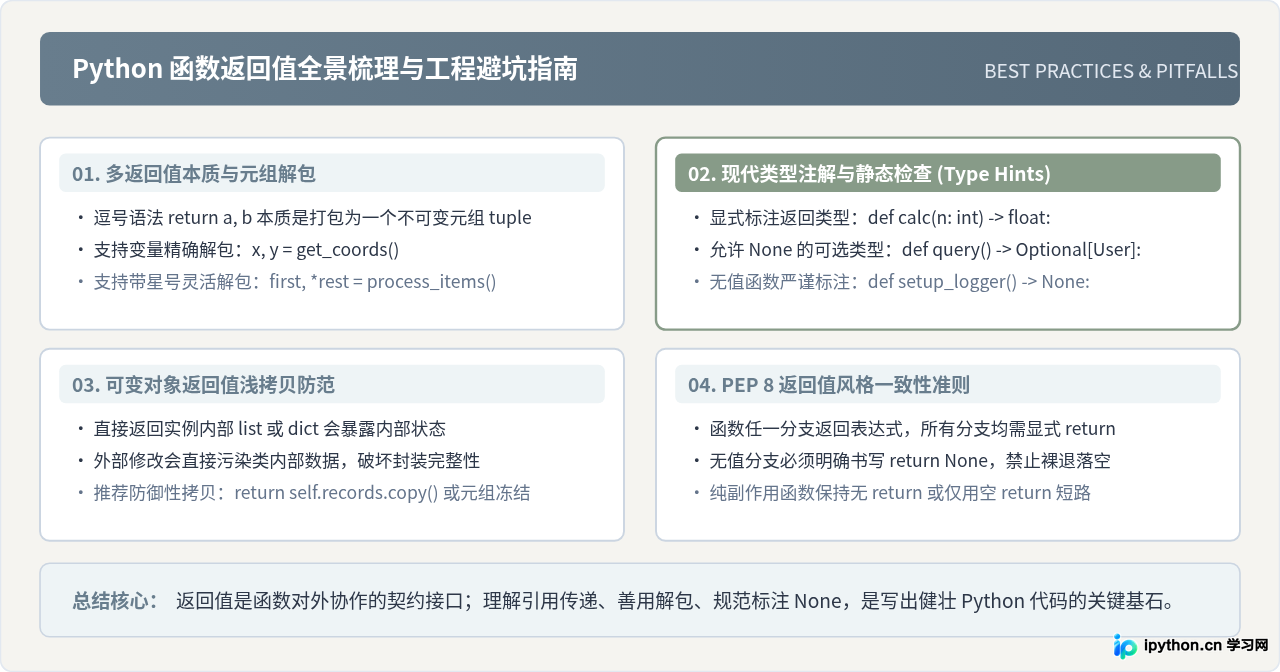
需要特别强调的是:Python 底层并没有真正的“多返回值”,其本质是返回一个元组(tuple)。当解释器解析到以逗号分隔的多个表达式时,会自动将其隐式打包为一个单一的不可变元组对象 (min_val, max_val, avg_val)。
在调用方接收结果时,Python 强大的序列解包(Unpacking)机制允许我们灵活接收:
# 方式 1:整体用单一变量接收(得到元组)
stats = get_dataset_stats([10, 20, 30])
print(type(stats), stats)  # <class 'tuple'> (10, 30, 20.0)

# 方式 2:位置精确解包
lowest, highest, average = get_dataset_stats([10, 20, 30])
print(lowest, highest, average)  # 10 30 20.0

# 方式 3:结合星号语法灵活捕获
def get_user_record():
    return "001", "张三", "技术部", "后端架构师", "北京"

uid, name, *details = get_user_record()
print(uid, name)     # 001 张三
print(details)       # ['技术部', '后端架构师', '北京']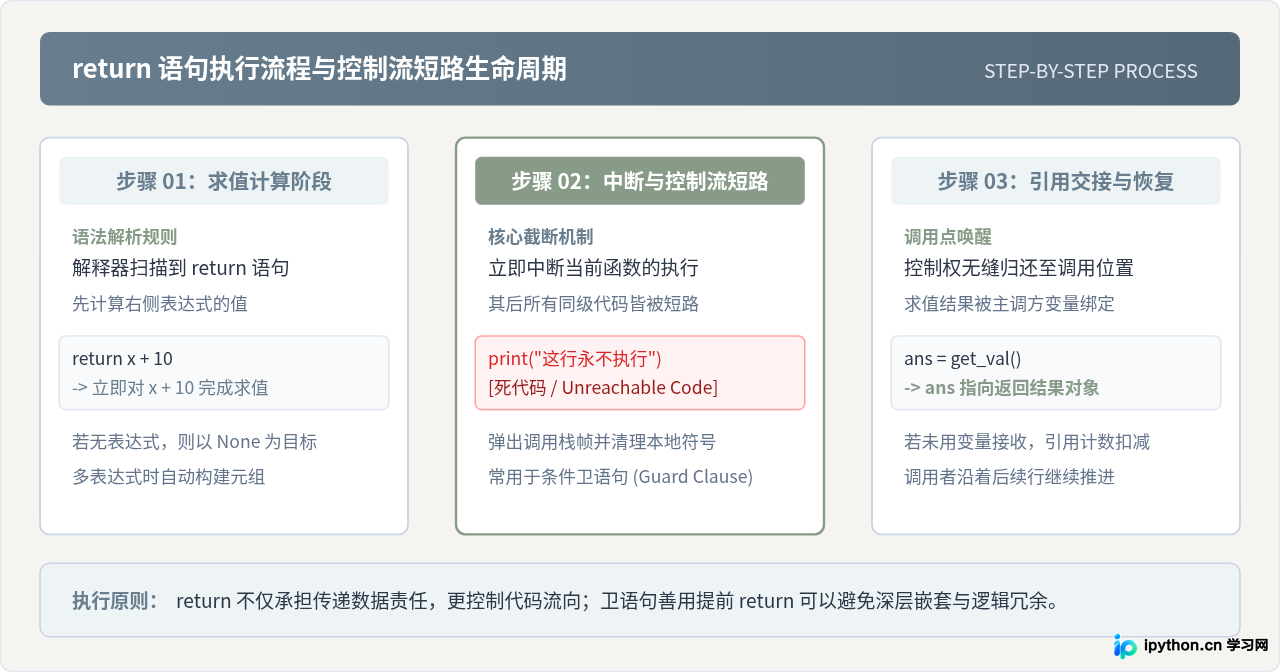
三、默认 None 机制的底层原理与对照分析
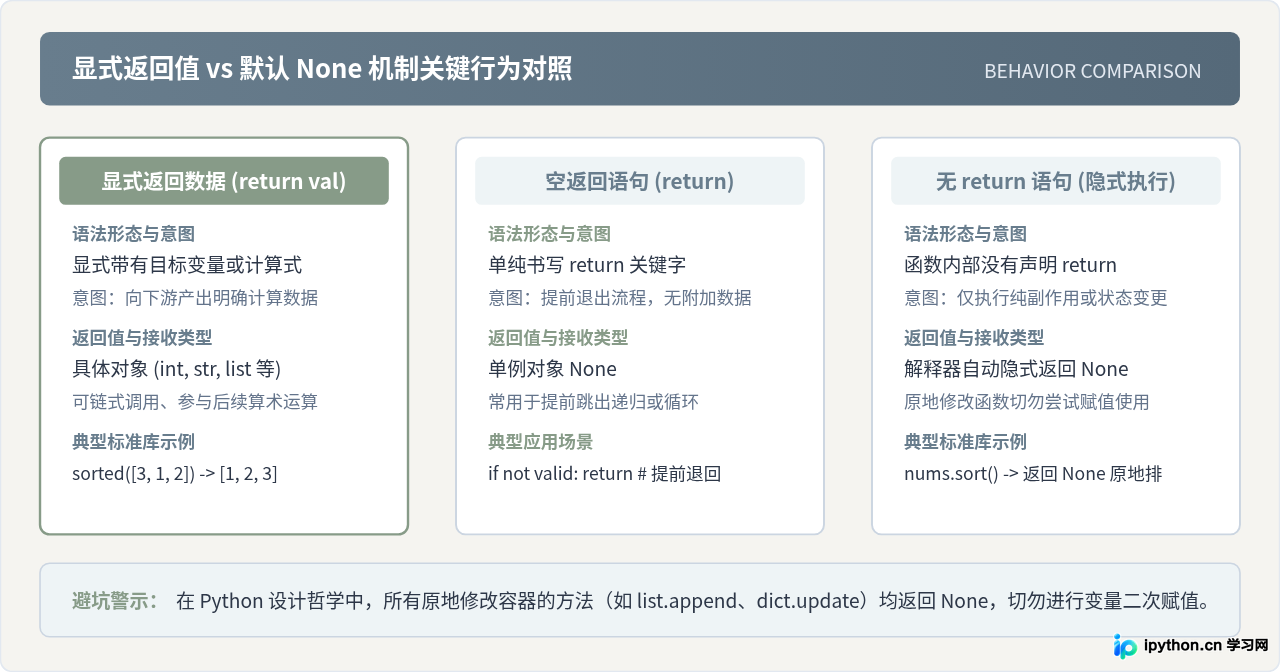
在静态类型语言(如 C/C++、Java)中,没有返回值的操作过程必须显式声明为 void 类型。而在 Python 的对象模型中,所有函数在任何情况下都有返回值,不存在纯粹的“无返回值函数”。当函数没有产出具体数据时,Python 会统一采用内建单例对象 None 作为兜底返回值。
1. 隐式产生 None 的两种场景
在 CPython 字节码编译层面,如果函数体末尾没有 return 语句,编译器会在生成的字节码末端自动注入两条指令:LOAD_CONST None 和 RETURN_VALUE。因此,以下两种写法在解释器看来是完全等价的:
# 场景 A:无 return 语句,自然执行到结尾
def implicit_none_a():
    x = 1 + 1

# 场景 B:显式写了 return,但后面没有任何表达式
def implicit_none_b():
    x = 1 + 1
    return

print(implicit_none_a())  # 输出:None
print(implicit_none_b())  # 输出:None
单例对象 None 是 NoneType 类的唯一实例。在 Python 进程的整个生命周期中,内存中只存在一份 None 对象,任何地方产生的 None 其内存标识 id() 都是完全一致的。因此,判断返回值是否为 None 时,必须始终使用 is None 或 is not None,而不是使用相等性比较符 ==。
2. 对照分析:显式 return None vs 空 return vs 隐式结束
既然这三者最终产生的都是 None,为什么在实际开发中还需要区分使用场景?根据 PEP 8 官方编码规范,这三种书写方式传递了截然不同的工程语义:
| 语法形式 | 书写示例 | 意图语义 | 适用场景与规范要求 |
|---|---|---|---|
| 显式 return None | return None |
明确传递“空结果”或“未命中” | 当函数内部某些分支返回具体有效数据时,其他失败分支必须显式写 return None,严禁隐式落空。 |
| 独立空 return | return |
纯粹中断流程,提前退出执行 | 用于仅产生副作用的函数内部作为卫语句提前返回,如参数校验不通过时退出,不向外传递数据意图。 |
| 无 return 语句 | 函数末尾自然结束 | 纯粹执行过程操作,关注副作用 | 函数的核心任务是写日志、修改全局状态或向终端输出,调用者本就不应关注返回值。 |
关键差异的影响在于代码可维护性与静态类型检查:如果一个函数用于查询用户信息,查找成功时返回 User 对象,若查找失败分支仅仅是代码执行到底部隐式结束,后续维护者很难分辨这究竟是设计者刻意为之,还是疏忽忘记了写 return。显式写出 return None 能够向读者和 IDE 明确传达设计意图。
# 规范做法:分支返回值风格保持绝对一致
def find_user_by_id(user_db, user_id):
    if user_id in user_db:
        return user_db[user_id]  # 显式返回具体对象
    return None                   # 失败分支必须显式返回 None,符合 PEP 8 准则

# 反规范做法:混淆隐式与显式
def bad_find_user(user_db, user_id):
    if user_id in user_db:
        return user_db[user_id]
    # 底部直接落空,代码意图模糊不清
3. 典型陷阱:原地修改(In-place)方法与 None 返回值误区
Python 标准库在设计其内置数据结构时遵循了一条核心设计哲学:凡是原地(In-place)修改对象内容的方法,其返回值一律固定为 None。这一设计旨在从 API 层面杜绝开发者混淆“原对象发生改变”与“生成了独立的新对象”。
然而,这正是许多初学者甚至中级开发者最常踩中的严重 Bug 来源:
# 常见错误:将 list.sort() 的返回值赋值给新变量
scores = [88, 92, 75, 60, 99]
sorted_scores = scores.sort()  # 错误!scores.sort() 原地排序并返回 None

print(sorted_scores)  # 输出:None
# 接下来的任何列表操作都会引发致命崩溃:
# sorted_scores.append(100) -> AttributeError: 'NoneType' object has no attribute 'append'避坑准则:如果需要获得排序后的新列表而保留原列表不变,必须使用内建函数 sorted(scores);如果使用 scores.sort(),则直接对原变量操作,切勿赋值。同理,list.append()、list.extend()、list.reverse()、dict.update() 均返回 None。
四、工程实践:类型注解、可变对象防范与避坑指南
在大型工程项目与团队协作中,严谨地规范函数返回值能够大幅减少生产环境中的空指针(NoneType)隐患。
1. 使用类型注解(Type Hints)明确返回值契约
从 Python 3.5 起引入的类型提示系统,允许开发者在函数签名中明确标注返回值的预期类型。在 Python 3.10+ 中,更推荐使用简练的竖线语法表示联合类型:
from typing import Optional

# 1. 明确返回具体基本类型
def calculate_discount(price: float, rate: float) -> float:
    return price * rate

# 2. 明确返回可能为空的对象(Optional)
# Python 3.10+ 推荐写法:User | None
def get_user_profile(user_id: int) -> Optional[dict]:
    if user_id <= 0:
        return None
    return {"id": user_id, "name": "管理员"}

# 3. 明确纯过程型函数的无返回值契约
def log_audit_trail(action: str) -> None:
    print(f"[AUDIT] {action}")
通过引入类型注解,搭配 mypy 等静态代码分析工具,可以在代码运行前就检测出未对 None 做防御性检查的潜在缺陷。例如当调用者直接对 get_user_profile(uid)["name"] 进行字典取值时,类型检查器会立刻警告 Item "None" of "Optional[dict]" has no attribute "__getitem__",强制开发者显式进行 if profile is not None: 判断。
2. 返回可变对象的浅拷贝与数据污染防范
另一个隐蔽的高级陷阱涉及面向对象编程中的可变对象封装性。当一个类的内部维护着一个列表或字典,而成员方法直接将其作为返回值回传时,外部调用者将持有该内部对象的直接引用:
class CourseManager:
    def __init__(self):
        self._students = ["小明", "小红"]

    # 风险写法:直接暴露内部私有对象引用
    def get_students_unsafe(self):
        return self._students

    # 安全写法:返回浅拷贝或不可变元组
    def get_students_safe(self):
        return self._students.copy()  # 或者 return tuple(self._students)

manager = CourseManager()
# 外部代码意外修改了内部列表
roster = manager.get_students_unsafe()
roster.clear()  # 导致 manager._students 也被清空,破坏了类封装!
在编写涉及内部核心状态的函数时,若需将容器作为返回值输出,应始终养成进行防御性拷贝(copy())或将其转换为不可变对象(如 tuple、types.MappingProxyType)的良好习惯。
五、核心机制全景总结
回顾全文,Python 的函数返回值机制既保持了动态语言的高度灵活性,又蕴含着严谨的对象模型哲学。为了在日常编码中写出健壮、优雅的函数,建议将以下三条法则作为团队开发准则:
- 全函数对象铁律:Python 中没有
void,所有函数必定返回且仅返回一个对象引用。未显式指定的返回、裸写return均严格等价于返回全局单例None。 - 原地修改非链式法则:标准库中所有对容器进行原地修改的方法(如
sort、append、update)皆返回None,切勿将其作为赋值链条使用;需要新副本时选用生成式函数(如sorted)。 - PEP 8 风格对称法则:只要函数中的某一个分支产出了有意义的计算值,其他未命中分支必须显式书写
return None,以便向协作开发者和静态类型分析器清晰传达设计意图。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









