

Python中怎么定义变量:基础赋值语法与命名规范
深入详解Python中如何定义变量,系统拆解基础赋值语法、多变量解包、内存引用与动态绑定机制,以及PEP 8工业级命名规范与实战避坑指南。
在 Python 中定义变量不需要预先声明数据类型,直接使用赋值运算符 = 即可将变量名与具体数据绑定,例如 x = 10。定义变量的实质是在当前作用域的命名空间中建立标识符,并让该标识符指向内存中创建的数据对象。掌握基础赋值语法、多变量处理机制、底层引用特性以及遵循 PEP 8 工业级命名规范,是编写清晰、稳健且符合 Pythonic 风格代码的基石。
一、基础赋值语法:如何创建并初始化变量
与 C、C++ 或 Java 等静态类型语言不同,Python 是一门动态强类型语言。在 Python 中创建变量时,既不需要指定 int、float 或 String 等类型关键字,也不存在单纯声明而不赋值的空语法。赋值语句执行的瞬间,变量即告完成定义。
1. 单一变量的基础赋值
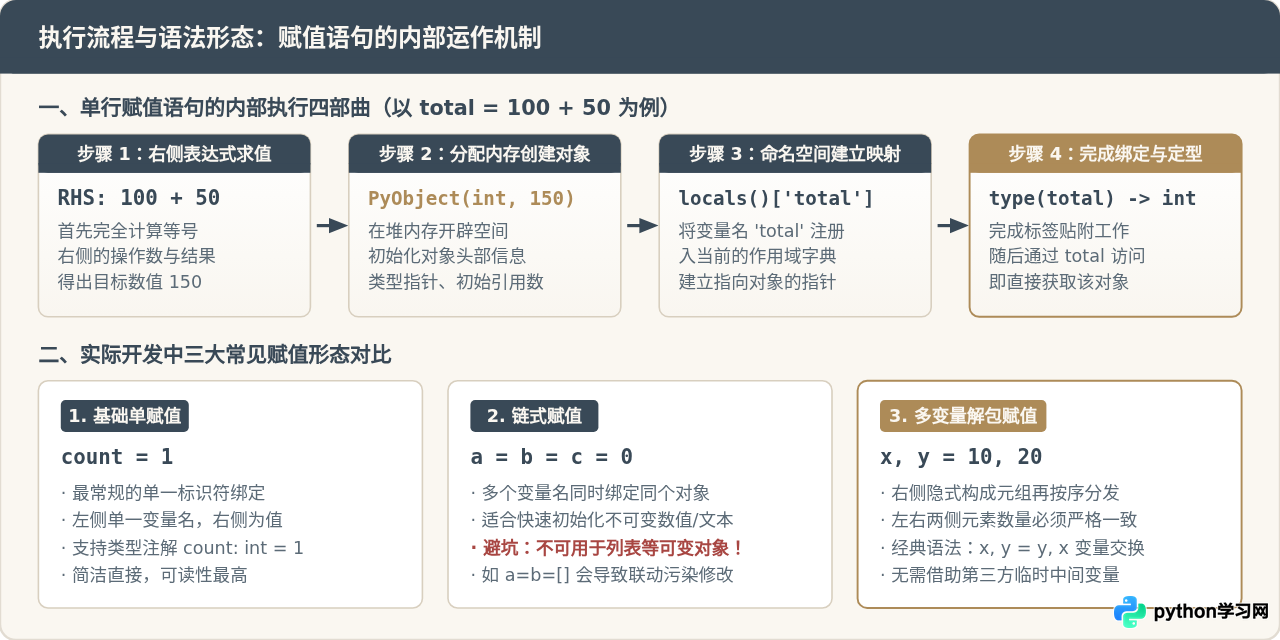
基础赋值的语法结构极其直观,公式为:变量名 = 表达式。等号(=)在此处代表“赋值”而非数学上的“相等”。
# 基础单一赋值示例
site_name = "Python Doc"      # 字符串类型 str
port = 8080                  # 整数类型 int
is_running = True             # 布尔类型 bool
cpu_load = 0.35               # 浮点数类型 float

# 检查运行输出
print(site_name, port, is_running, cpu_load)
运行上述代码,控制台将输出 Python Doc 8080 True 0.35。在每条语句中,Python 解释器首先计算等号右边的值,并在内存中创建对应的对象,随后让左侧的变量名指向该对象。
2. 多变量解包赋值(序列解包)
Python 允许在一行代码内同时对多个变量赋值,语法形如 a, b = 1, 2。该特性基于元组(Tuple)解包原理:等号右边的逗号会隐式构成一个元组,解释器随后按顺序将元组中的元素依次绑定到左侧对应的变量名上。
# 多个变量一行内解包赋值
width, height = 1920, 1080

# 经典应用:优雅的原地变量交换(无需临时第三方变量)
x = 10
y = 20
x, y = y, x

print("x =", x, "y =", y)
# 示例输出:x = 20 y = 10进行解包赋值时,等号左侧的变量数量必须与右侧集合的元素数量严格相等,否则会抛出 ValueError: too many values to unpack 或 not enough values to unpack。
3. 链式连续赋值
如果需要将多个变量同时初始化为相同的数值,可以使用链式赋值语法:a = b = c = 0。该语句会使 a、b、c 三个标识符全部指向内存中同一个整数对象 0。
# 链式赋值
base_score = bonus_score = current_score = 100
4. 类型注解(Type Hints,Python 3.6+)
为了提高工程代码的可读性以及方便 IDE 进行静态分析,Python 3.6 引入了 PEP 526 变量类型注解语法。它通过冒号指明预期类型,但并不会在运行时强制进行类型转换或校验:
# 显式带有类型注解的变量定义
user_id: int = 1001
account_name: str = "admin"
is_active: bool = True
二、核心机制:理解变量的“标签引用”模型
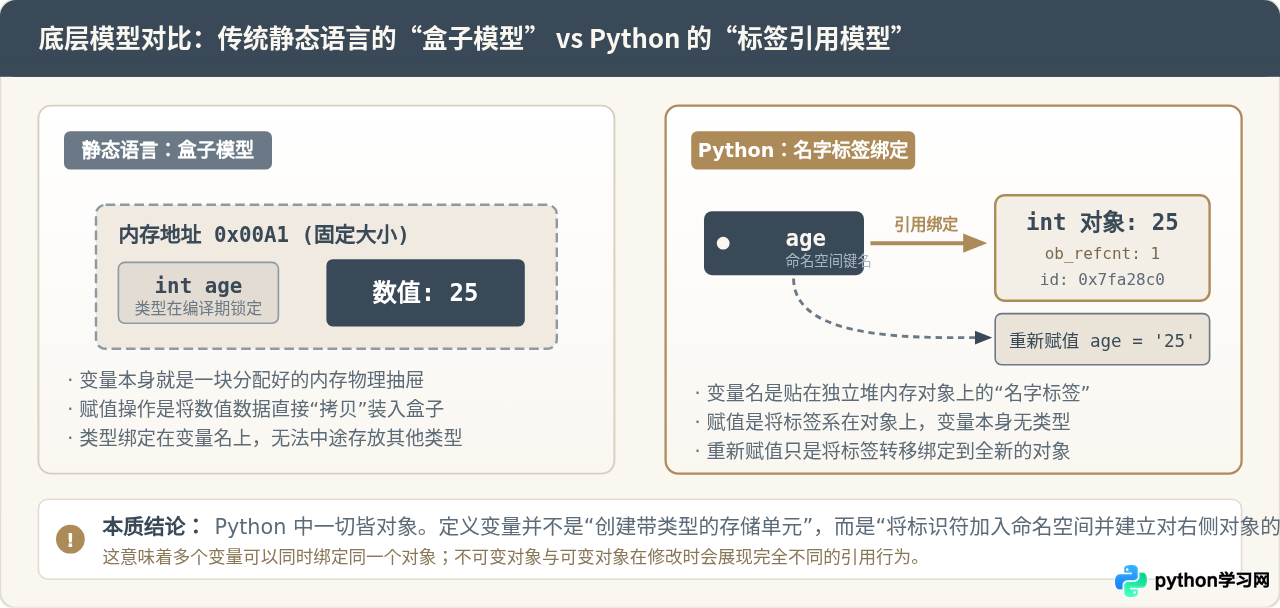
在很多传统编程语言中,变量被理解为一个“固定大小的内存盒子”,给变量赋值就相当于把数据放进盒子里。而在 Python 中,**变量只是贴在内存对象上的标签(Reference/Name Binding)**。
当执行 age = 25 时,Python 并没有创建一个名为 age 的内存盒子,而是在内存堆上创建了一个整型对象 25,并将名字 age 指向这个对象。随后若执行 age = 26,原有的 25 并不会被修改,而是生成了新的整型对象 26,age 标签被撕下来重新贴到 26 上。
验证引用的内置工具:id() 与 is 运算符
可以通过 Python 内置的 id() 函数查看对象在内存中的虚拟地址,或者通过 is 运算符判断两个变量是否绑定同一个物理对象:
a = [1, 2, 3]
b = a          # 引用拷贝:b 与 a 贴在同一个列表对象上
c = [1, 2, 3]  # 重新创建内容相同的独立列表对象

print("a is b:", a is b)   # 输出: True (同一对象)
print("a is c:", a is c)   # 输出: False (不同对象,虽然内容相等)
print("a == c:", a == c)   # 输出: True (数值/内容相等)
对于数值、字符串、元组等不可变对象(Immutable),修改变量必然生成新对象,互不影响;但对于列表(list)、字典(dict)等可变对象(Mutable),如果直接使用 b = a,修改 b 中的元素会导致 a 同时发生变化。如需独立副本,必须使用切片浅拷贝 a[:] 或 copy.deepcopy()。
三、变量命名的硬性语法规则(语法底线)
Python 解释器对标识符(Identifier)的拼写有一套绝对不可触碰的硬性要求。如果不遵守这些语法规则,代码在解析阶段就会直接中断并抛出 SyntaxError。
-
合法的字符集组成:
变量名只能由大小写英文字母(A-Z, a-z)、数字(0-9)以及下划线(_)构成。任何空格、标点符号、连字符(
-)、特殊字符(如@,$,%)均属于语法错误。 -
开头字符限制:
变量名的第一个字符绝对不能是数字。例如
item_1是合法的,但1_item会触发SyntaxError: invalid decimal literal。 -
大小写严格敏感:
Python 严格区分大小写字母。
student、Student、STUDENT在 Python 解释器内部被视作三个完全互不干扰的独立标识符。 - 严禁使用系统保留关键字: Python 语言保留了一批具有特殊控制逻辑的核心词汇(如条件分支、循环、类定义等),严禁将其作为普通变量名。
# 查看当前 Python 环境中的全部保留关键字列表
import keyword

print("关键字总数:", len(keyword.kwlist))
print(keyword.kwlist)
# 典型关键字包括:False, None, True, and, as, assert, async, await,
# break, class, continue, def, del, elif, else, except, finally, for,
# from, global, if, import, in, is, lambda, nonlocal, not, or, pass,
# raise, return, try, while, with, yield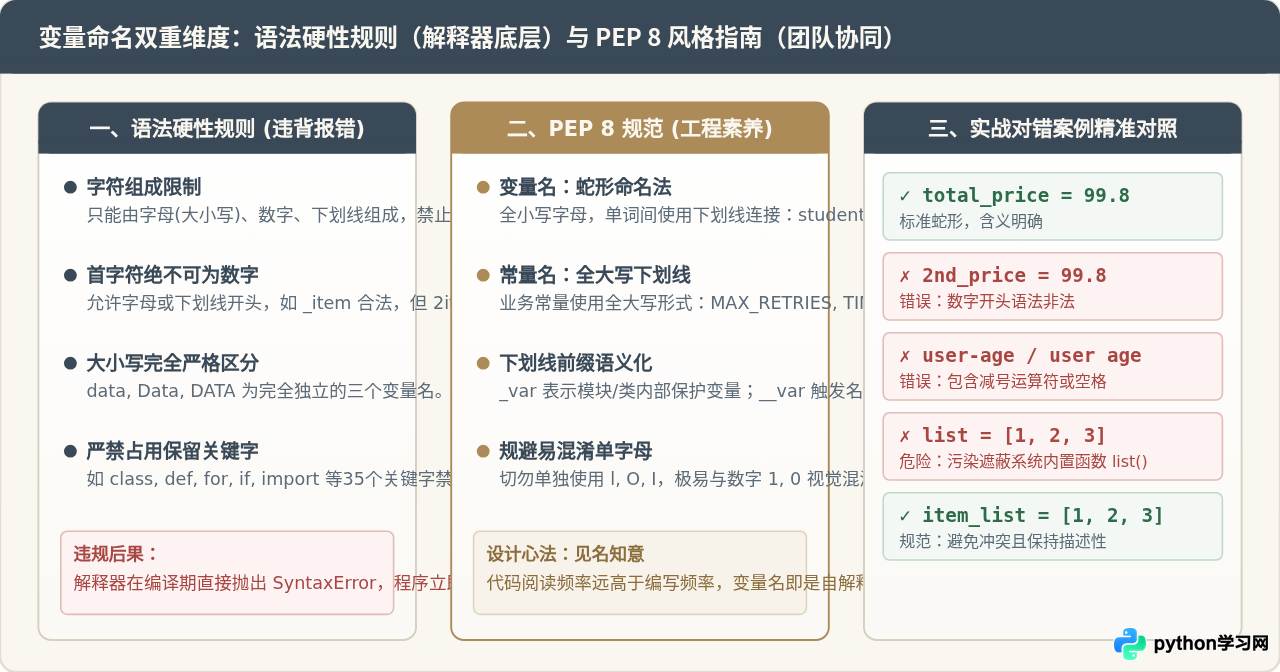
四、PEP 8 命名规范与工程最佳实践
一段代码通过了解释器的语法校验,仅仅意味着它可以运行,并不意味着它是一段易于维护的优质代码。Python 官方通过 PEP 8(Style Guide for Python Code) 为全球开发者统一了代码组织和命名标准。
| 标识符类别 | PEP 8 推荐命名风格 | 标准示例 | 设计初衷与解释 |
|---|---|---|---|
| 普通局部/模块变量 | 小写蛇形 (snake_case) | user_count, max_limit |
全部使用小写字母,单词之间用单个下划线隔开,视觉连贯度最高。 |
| 全局配置/业务常量 | 全大写蛇形 (UPPER_CASE) | DEFAULT_TIMEOUT, API_KEY |
Python 无真正常量的语言锁,全大写作为强烈约定,警示后续不要变更。 |
| 模块/类内部保护变量 | 单下划线前缀 (_leading) | _cache_store, _is_ready |
表示弱内部使用约定,通过 from module import * 时不会被导入。 |
| 类内私有属性 (防止覆盖) | 双下划线前缀 (__leading) | __password_hash |
触发名称改写机制(Name Mangling),避免子类命名意外冲突。 |
| Python 内部魔法属性 | 双下划线前后缀 (__dunder__) | __name__, __file__ |
系统保留专有命名,自定义变量绝对不应模仿此类命名形式。 |
实战工程命名准则
-
坚持“见名知意”,拒绝无意义缩写:
代码阅读的次数远多于编写的次数。使用
remaining_days优于rd;使用client_socket优于cs。唯一的例外是数学公式实现或常规循环计数器(如for i in range(10):)。 -
切忌单字母容易混淆的变量名:
永远不要将小写字母
l(容易与数字 1 混淆)、大写字母O(容易与数字 0 混淆)或大写字母I单独作为变量名。 -
严禁遮蔽系统内置函数(Built-in shadowing):
像
list、dict、str、int、len、type、id等虽非关键字,但属于全局内置函数或类型。如果将变量命名为list = [1, 2, 3],在该作用域内原本的list()函数将被覆盖失效,极易引发莫名其妙的TypeError。 -
布尔类型变量添加状态前缀:
推荐使用
is_、has_、can_、should_作为布尔变量前缀,例如is_authenticated、has_permission,能使条件判断语句极其贴合英文阅读习惯。
五、常见新手误区与避坑指南
误区 1:混淆赋值运算符 = 与关系比较运算符 ==
这是初学者最高频的失误之一。= 用于把右侧结果赋给左侧变量;== 用于对比两端内容是否相等并返回布尔值。虽然在 if 条件语句中 Python 会直接拦截大多数非法赋值并提示语法错误,但在复杂表达式中依然需要格外留神。
误区 2:未定义变量直接使用(NameError)
Python 属于解释型执行,任何变量在参与运算、输出或作为参数传递之前,必须在先前的代码路径中至少执行过一次赋值。否则会触发 NameError: name 'xxx' is not defined。
# 典型错误:未赋值先累加
try:
    total += 10  # 错误:total 尚未存在,无法执行读操作
except NameError as err:
    print("捕捉到异常:", err)
    # 正确做法:先初始化 total = 0,再累加
误区 3:可变对象的链式赋值陷阱
对于整型等不可变对象,a = b = 0 方便且安全。但千万不要对列表、字典等可变容器使用链式赋值:
# 危险陷阱:可变容器的链式赋值
list_a = list_b = []
list_a.append("item")

# 观察结果:list_b 也被意外篡改!
print("list_b:", list_b)  # 输出: ['item']

# 正确做法:分别独立实例化
list_a, list_b = [], []
六、核心总结与全景速查
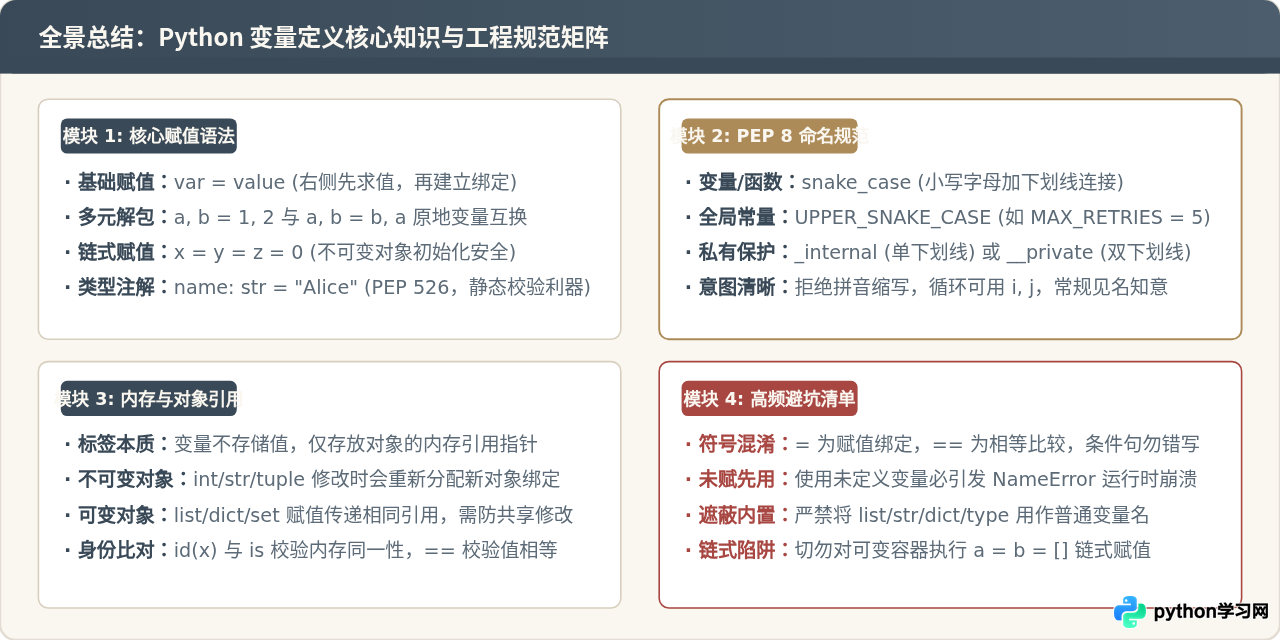
Python 中定义变量的核心在于理清“语法”、“引用”与“规范”三层体系:
- 语法层:利用
=随用随定,无需预先声明类型;结合多变量解包可写出极度凝练的数据绑定逻辑。 - 底层引用:时刻牢记“变量是标签”而非存储容器,深切理解不可变对象与可变对象在再赋值和修改时的差异。
- 工程规范:坚守合法性字符底线,全面拥抱 PEP 8 蛇形命名与见名知意原则,杜绝内置函数遮蔽。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









