

在线运行Python代码报错或超时怎么办?
针对在线运行Python代码时常见的语法错误、运行报错、交互输入卡死及超时(TLE)问题,提供从排查、代码优化到环境限制应对的系统解决方案。
假设你正打开一个网页端Python运行工具或刷题平台,把刚写好的脚本粘贴进去并点击“运行”,网页加载图标转动了数秒,屏幕上没有出现预期的计算结果,而是弹出一行红色的错误提示,或者直接显示“Time Limit Exceeded”(运行超时)。
在线运行环境与本地电脑上的IDE不同,它通常运行在服务商的沙箱容器中,受到严格的单次运行时间限制(通常为3至10秒)、内存配额上限以及终端交互机制的约束。遇到在线运行异常,解决的核心路径可以分为两步:第一步是判断问题属于“执行即崩溃的语法/逻辑报错”,还是“耗尽资源被系统强行终止的超时”;第二步则是根据在线沙箱的具体限制,针对性地修改代码或输入方式。
排查与解决代码报错(Runtime Error)
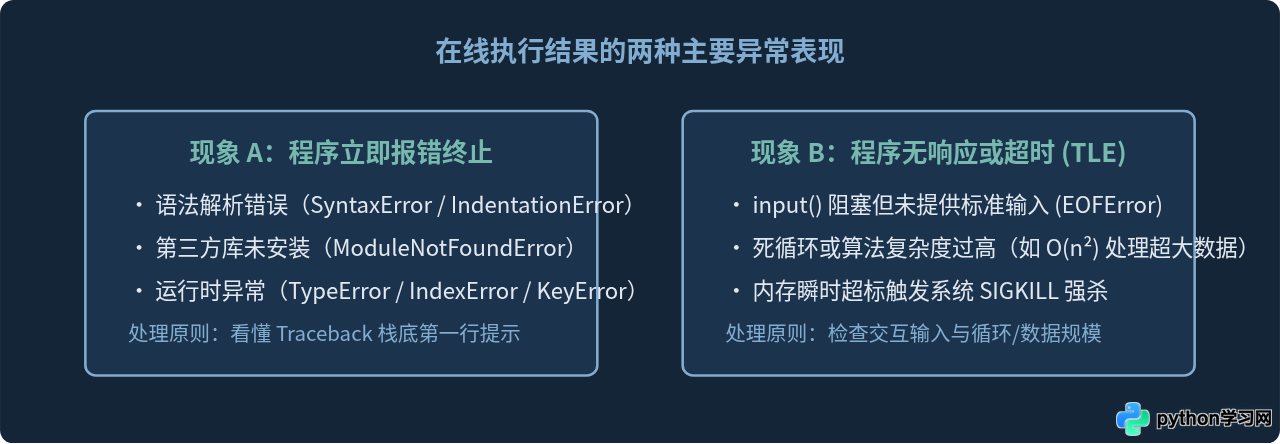
在线代码抛出异常时,控制台通常会输出一段被称为 Traceback 的报错调用栈。很多读者容易被一整屏的英文吓退,但排查的核心原则是:从输出信息的最底部往上看。
1. 常见报错定位
- SyntaxError 或 IndentationError:语法或缩进错误。在线编辑器有时在网页复制粘贴时会把空格和制表符(Tab)混在一起,或者漏掉代码块结尾的英文冒号
:。 - ModuleNotFoundError: No module named 'xxx':试图导入未预装的库。在线环境是服务器端的隔离沙箱,通常只自带 Python 标准库(如
math、sys、os)以及部分平台指定的常见库。如果需要使用第三方库(如requests、pandas),需确认平台是否提供了额外依赖安装入口(如 requirements 选项或!pip install),否则只能改用标准库替代实现。 - EOFError: EOF when reading a line:这是在线环境最具特色的报错之一。当你的代码包含
input()语句,而在线编辑器不支持实时网页弹窗输入,且“标准输入(Stdin)”文本框为空时,解释器读到数据流结尾就会立刻崩溃。
排查与解决运行超时(Timeout / TLE)
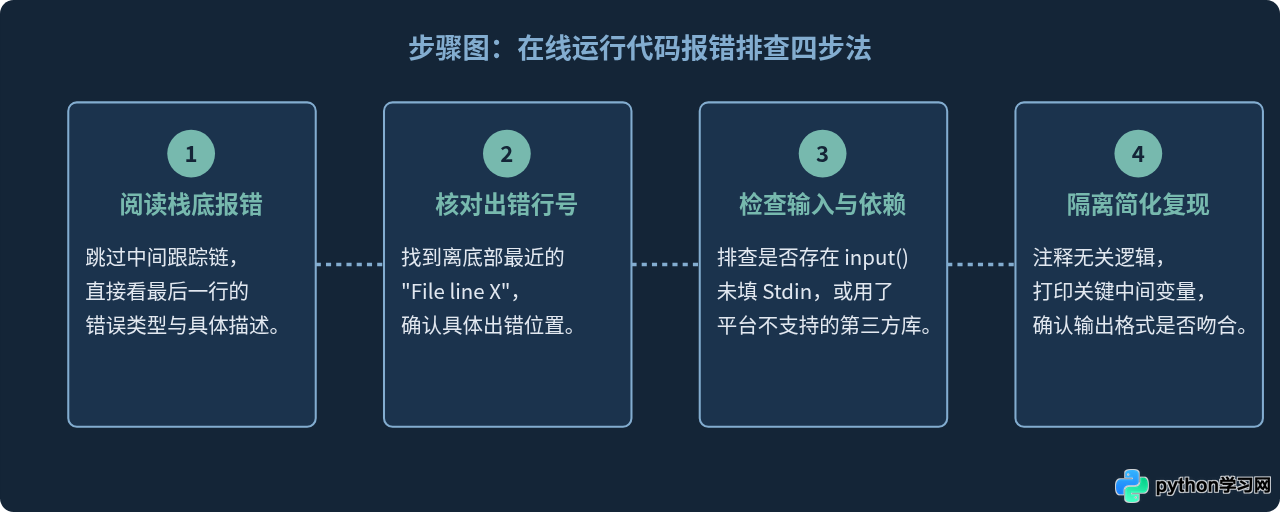
在线工具提示超时时,通常有两种本质不同的机理:一种是“代码卡在等待外部事件”,另一种是“计算复杂度太高,在规定时限内没跑完”。
1. 交互输入死锁:等待永远不会到来的输入
在本地终端中运行 name = input("请输入名字: "),程序会挂起并等待键盘敲击回车。但大多数在线代码运行平台(如非全功能云端终端)为了防止服务器资源被长连接占满,采用的是“批处理”模式:一次性把所有输入通过标准输入通道灌给程序,然后关掉通道。
如果网页界面中有一个名为 Standard Input / Stdin / 命令行输入 的输入框,你必须在点击运行前,提前把程序将要读取的所有内容按行写进去。如果留空,部分平台会直接报错 EOFError,而另一部分平台则会一直等待直到触发 5 秒超时机制。
data = [1, 2, 3]),避免依赖 input() 触发环境兼容问题。
2. 逻辑死循环
循环更新条件的疏漏是超时的首要原因。例如 while 循环中变量递增语句放错了缩进,或者退出条件永远无法满足:
# 错误示例:条件变量未更新导致的死循环
i = 0
total = 0
while i < 1000:
    total += i
    # 漏写了 i += 1,程序永远卡在 i=0,几秒后被服务器强行终止超时
3. 算法时间复杂度过高
在算法练习平台(如各大 Online Judge)上,服务器一般设定单次运行阈值为 1 秒到 2 秒。在 Python 中,通常一秒钟可执行的操作次数大约在 $10^7$(千万次)级别左右。如果题目的数据量 $N$ 达到 $10^5$,而你使用了两层嵌套循环($O(N^2)$),总运算次数就会达到 $10^{10}$ 次,这在任何在线沙箱中都会必然超时。
让代码变快的关键改动示例
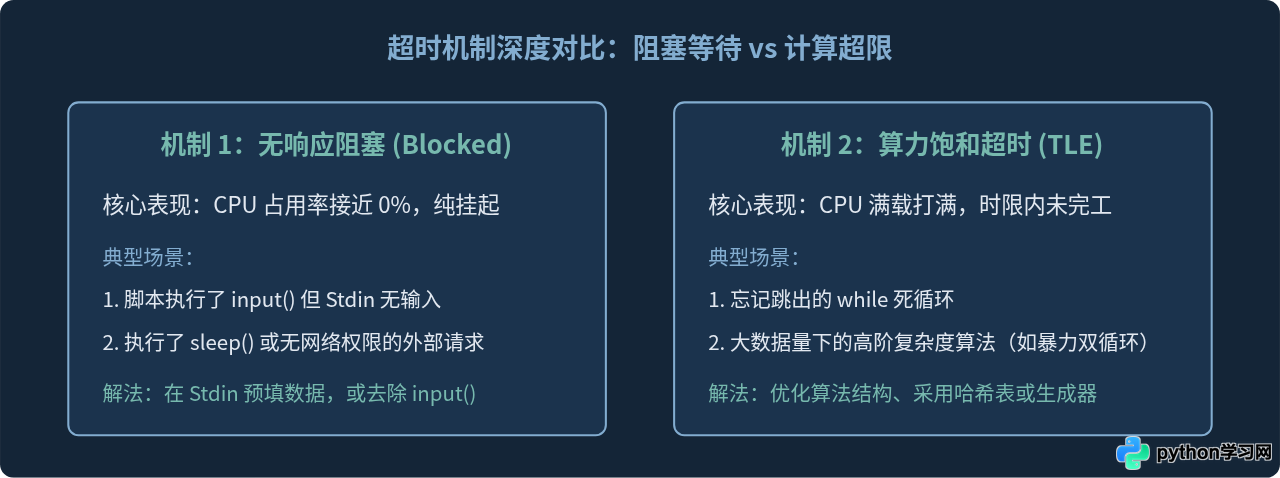
在线环境往往分配给单核 CPU 极小的算力份额。以下几个简单的写法优化,可以立竿见影地降低执行耗时,避免被系统强行终止:
1. 查找操作优先使用集合(Set)而不是列表(List)
在列表中检查元素是否存在(item in my_list)需要从头遍历整个列表,平均耗时为 $O(N)$;而将数据放入集合后进行检查(item in my_set),是通过哈希定位,平均耗时为 $O(1)$。
# 慢速写法:列表查找,元素多时极易在在线平台超时
def find_duplicates_slow(data, targets):
    found = []
    for item in targets:
        if item in data:  # 每次都是全列表扫描
            found.append(item)
    return found

# 快速写法:转换为集合查找,耗时降低数个数量级
def find_duplicates_fast(data, targets):
    data_set = set(data)  # 一次性构建哈希表
    return [item for item in targets if item in data_set]
2. 避免在超大循环中频繁调用 print()
在控制台输出字符涉及大量的系统 I/O 调用和网页端 WebSocket 传输。如果在包含 10 万次循环的体内部每次都执行 print(),即使计算本身仅耗时 0.05 秒,传输和打印也可能耗费 10 秒以上,进而触发输出截断或超时限制。优先在内存中汇总结果,最后一次性输出。
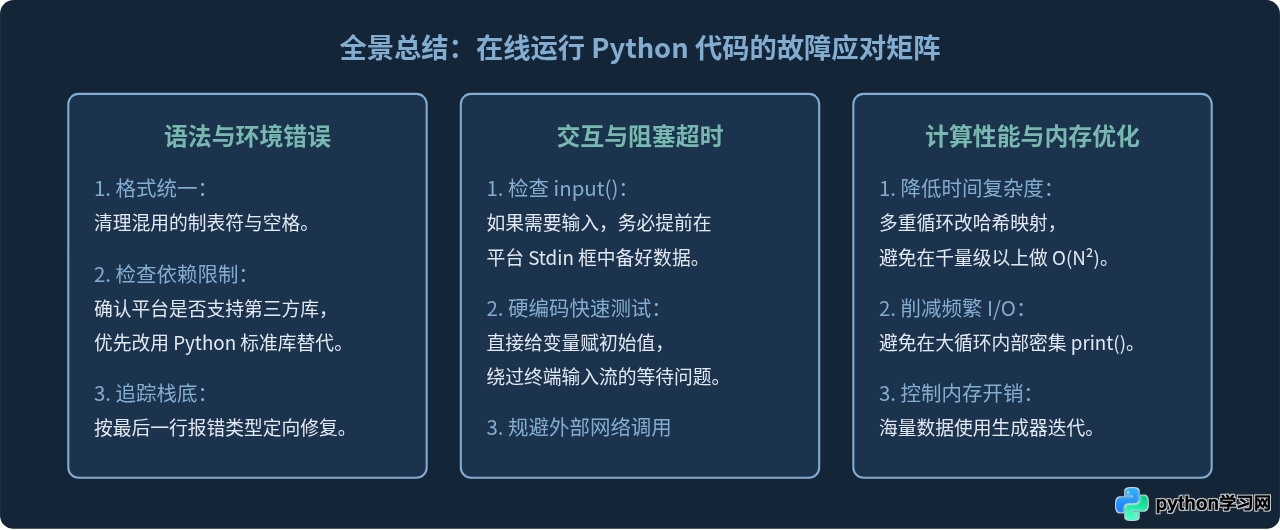
总结:如何确认问题已经彻底解决?
当修改完代码后,可以通过以下三个表现确认问题已经解决:
- 退出码正常:输出控制台末尾显示
Process finished with exit code 0,不再有红色告警字样。 - 输出符合预期:无论输入边界数据还是典型测试用例,控制台能在 1 秒内清晰吐出最终答案,而非停滞数秒后被动刷新。
- 边界测试不崩溃:用空列表、极小数值或大规模测试项验证代码,没有触发内存超限或未处理的索引越界。
如果经过所有优化后,代码依然因为任务过于繁重(例如大规模数据模型训练、爬取网页等)而被截断,这说明该任务已经超出了轻量级在线沙箱的承载边界,此时应当直接迁移到本地安装的 Python 环境或专用的云端开发服务器中运行。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









