

为什么我的代码在在线Python网站上运行超时?

Time Limit Exceeded 或 Timeout)的根源本质上只有两类:一是程序在执行逻辑上未能正常终止,陷入了死循环或阻塞等待;二是算法的计算量超出了平台分配的执行时限。了解平台的运行隔离机制、掌握典型触发场景并建立标准排查顺序,可以高效解决绝大多数超时报错。
一、在线平台的超时判定机制:与本地有何不同?
很多开发者在遇到超时时,第一个疑惑往往是:“这段代码在我的电脑终端里一眨眼就跑完了,为什么提交到网站上就超时?”要理解这一现象,首先需要认识在线网站的执行环境。
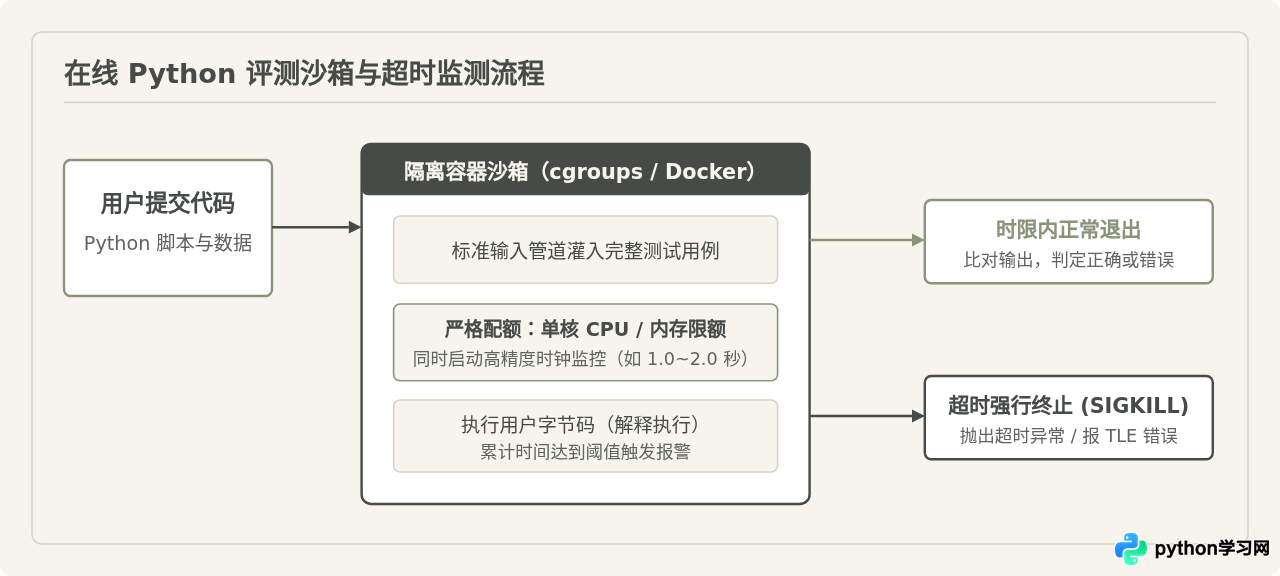
为了保障服务器安全与公平分配计算算力,在线 Python 平台通常将用户的代码放入隔离的轻量级容器(如 Docker 或基于 Linux cgroups 的沙箱)中运行。平台会对每个任务施加极其严格的资源配额:
- CPU 核心与算力限制:平台分配给单个运行实例的通常是单核甚至被限额(例如 0.5 到 1 个虚拟核)的算力,无法利用本地多核高主频的优势。
- 挂钟时间与 CPU 时间:网站判题系统设置了硬性阈值(通常在 1 秒到 5 秒之间)。一旦程序执行超过此阈值,守护进程会直接向程序发送强制终止信号(如 SIGKILL),并判定为运行超时。
- 非交互式输入环境:在线评测系统通过文件重定向或管道向程序灌入测试数据,而非人工在控制台实时打字交互。
二、导致超时的四大核心原因
1. 死循环或循环更新逻辑缺失(非计算量问题)
当代码出现死循环时,不论平台分配 1 秒还是 10 秒,程序都永远无法跑完,最终必然触发平台的强制超时中断。常见的死循环原因包括:
- 指针未移动:使用双指针或
while循环遍历数组或链表时,在部分分支(如if-else中)遗漏了i += 1或curr = curr.next。 - 终止边界设置错误:循环终止条件永远为真,例如因浮点数精度误差导致无法精确等于目标值。
- 区间搜索无进展:二分查找中在计算中点时出现向下取整死循环(例如左右边界相邻时
left = mid陷入原地打转)。
2. 交互式输入阻塞:input() 永久等待
初学者容易在在线提交的代码中保留 input("请输入数字:") 这类提示语句。在评测机环境下,评测程序是通过预设文件输入数据的。如果题目数据已经读取完毕,而代码仍调用了一次未加保护的 input(),程序将挂起等待用户终端键盘输入,直到超时被强制杀死。
3. 算法时间复杂度过高,无法承受大数据集
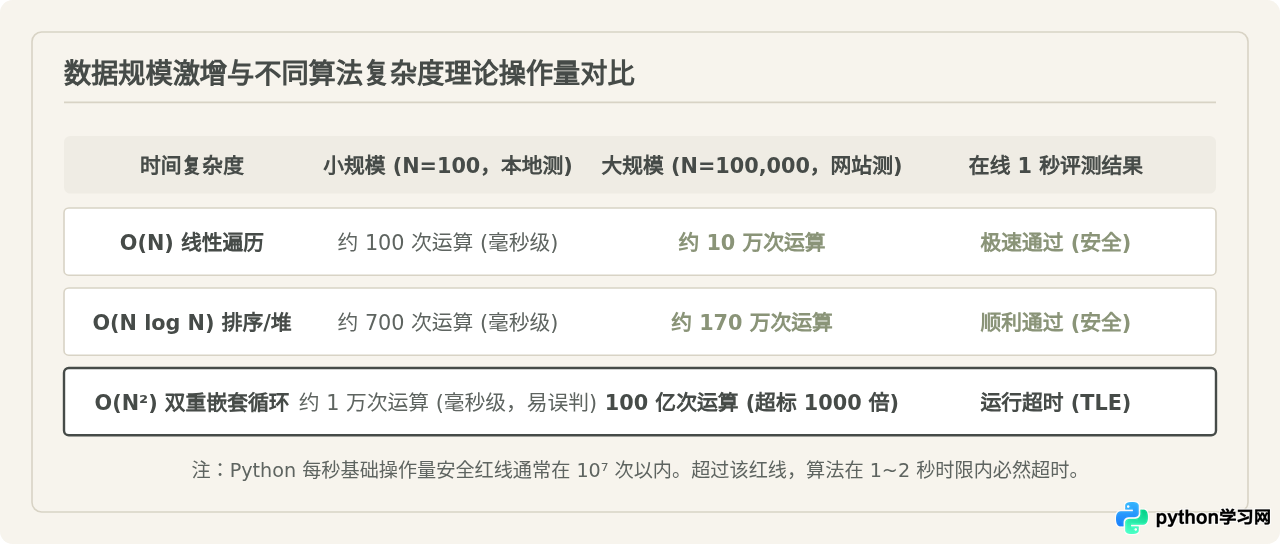
这是算法题与练习网站中最常见的超时原因。在本地测试时,开发者通常只手动输入 3~5 个数字进行验证;但在在线测试集中,评测系统会注入成千上万、甚至数以十万计的大规模数据。
在标准在线评测机配置下,Python 解释器在 1 秒内通常只能处理约 107 次以内的基础操作。若算法复杂度为 O(N2),当测试数据规模 N 达到 105 时,运算次数将飙升至 1010 次,理论耗时将达到数百秒,必然超时。
4. 低效的 Python 数据结构与隐藏高开销操作
部分代码从数学逻辑上看没有显式的多重循环,但在循环体内部调用了高开销的内置方法,导致隐式复杂度急剧上升:
- 在
list中频繁进行in查找或pop(0):列表的线性搜索与头部删除操作时间复杂度为 O(N)。如果在长为 N 的循环中重复这一操作,整体复杂度将隐式退化为 O(N2)。改用set(查找为 O(1))或collections.deque(两端弹出均为 O(1))即可解决。 - 字符串在循环中用
+频繁拼接:Python 中的字符串是不可变对象,每次str1 + str2都会在内存中重新分配空间并拷贝数据。大量字符串拼接应使用"".join(list)。 - 未带记忆化的深度递归:例如计算斐波那契数列或背包问题时直接采用朴素递归,导致指数级时间复杂度 O(2N),需添加记忆化缓存(如
@functools.lru_cache)或改写为动态规划。
三、容易混淆的常见说法辨析
辨析:这种说法忽略了测试用例维度的差异。开发者在本地运行代码时,往往使用的是样例数据(例如仅有 5 个元素的数组)。而在在线网站上,系统会运行完整的隐藏测试集,其中包含专门针对低效算法设计的“极端卡常数据”(例如 N = 105 且全部逆序)。只要算法复杂度不对,服务器即使毫无负载也无法在规定时间内完成百亿次计算。
辨析:列表推导式(List Comprehension)由底层 C 代码循环驱动,相较于纯 Python 的 for 循环能带来 20%~40% 的常数级速度提升。但是,如果算法本身的复杂度是 O(N2),常数级的微小提升完全无法跨越数量级层面的巨大差距。优化算法复杂度才是解决超时的根本路径。
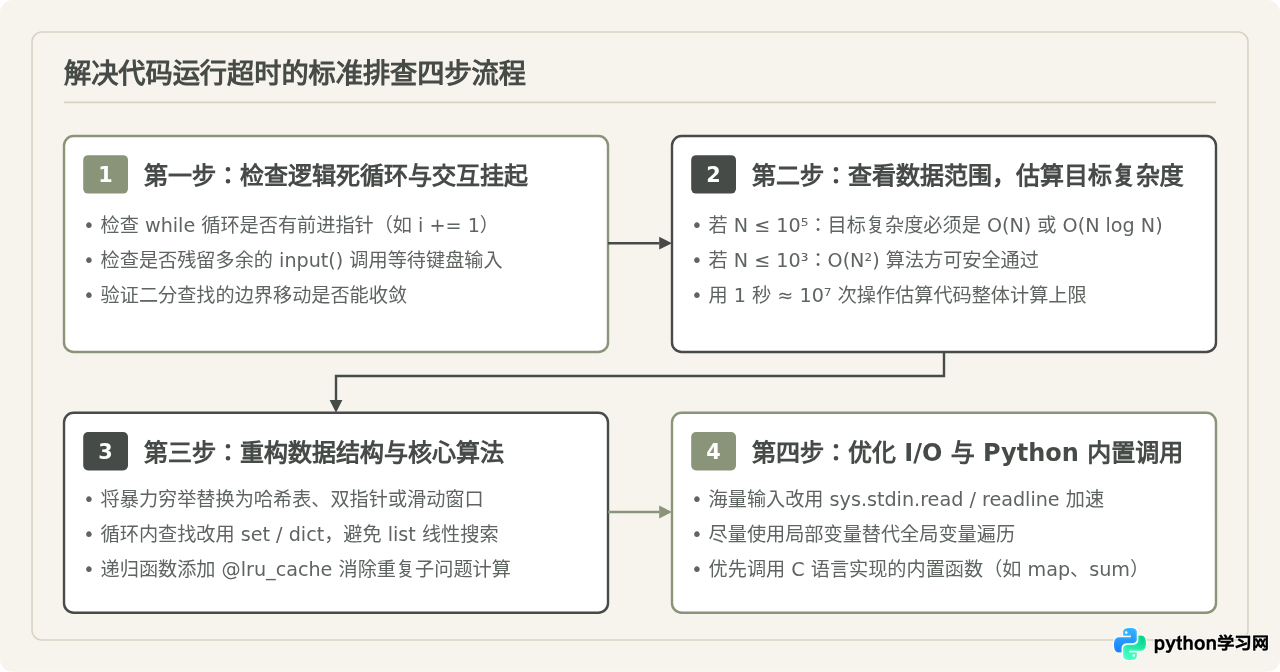
四、系统排查与解决超时的四步法
遇到超时错误时,不要盲目修改代码,应按照由易到难的顺序依次排查:
实战优化示例:从 O(N²) 到 O(N)
以下为一个典型场景:找出数组中相加等于目标值 target 的两个数。若使用嵌套循环,在 N = 105 时将超时;改用哈希表记录已遍历元素后,只需单次遍历:
# ❌ 易超时的朴素写法:O(N^2)
def two_sum_slow(nums, target):
    n = len(nums)
    for i in range(n):
        for j in range(i + 1, n):
            if nums[i] + nums[j] == target:
                return [i, j]
    return []

# ✅ 高效的哈希表写法:O(N)
def two_sum_fast(nums, target):
    seen = {}
    for i, num in enumerate(nums):
        complement = target - num
        if complement in seen:  # 字典查找平均仅耗费 O(1)
            return [seen[complement], i]
        seen[num] = i
    return []
输入输出加速技巧:应对海量数据
当题目测试数据行数达到数十万行时,Python 默认的 input() 每次需要解析换行符与输入缓冲,I/O 开销本身就可能耗费 1 秒以上。此时引入 sys.stdin.readline 能大幅降低耗时:
import sys

# 替换默认 input
input = sys.stdin.readline

def solve():
    # 读取一行数据并解析
    line = sys.stdin.readline()
    if not line:
        return
    # 处理数据逻辑...
五、超时应对策略与自查速查表
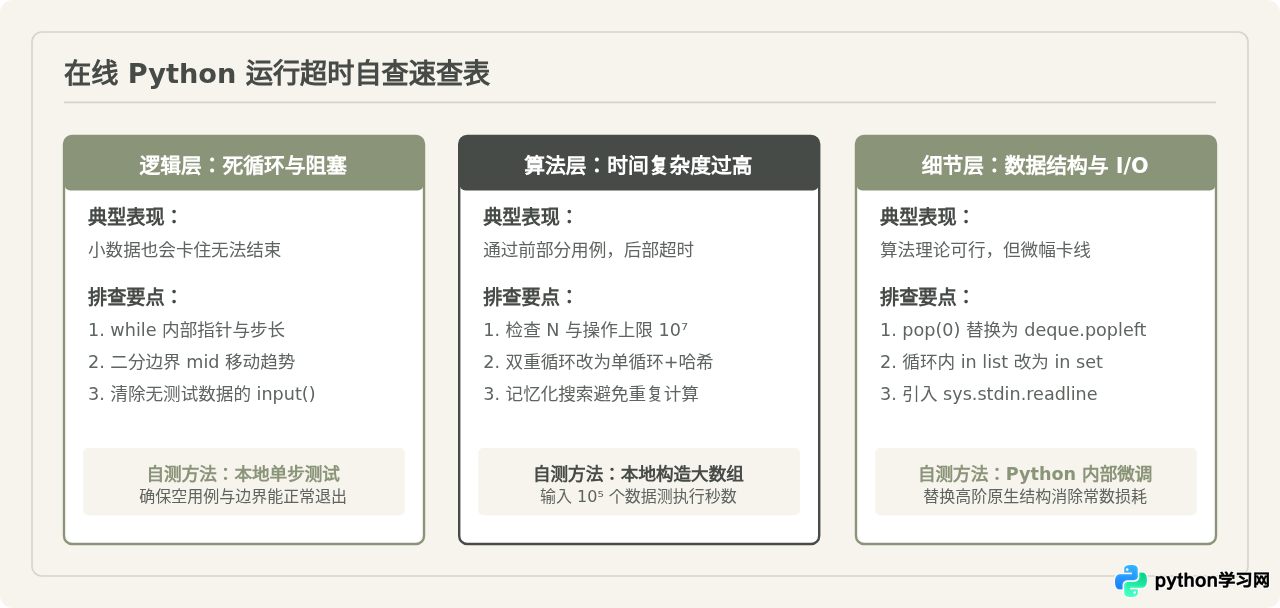
为了帮助在以后的代码编写中快速规避超时,下表总结了常见表现、核心诱因与对应修正建议:
综上所述,当你的 Python 代码在在线平台触发超时时,不必焦虑于服务器的状态。从确认逻辑终止、核算输入规模与时间复杂度,到选用合适的数据结构,只要按部就班地针对性调整,就能彻底消除超时报错,写出既清晰又高效的程序代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









