

在线运行Python代码超时或被杀进程的原因分析
深入分析在线平台运行Python代码时出现超时或进程被终止(Killed/137)的核心诱因,对比CPU密集超时与内存溢出的本质差异,并提供系统化的排查与代码优化方案。
一、在线沙箱的资源管控与异常表现
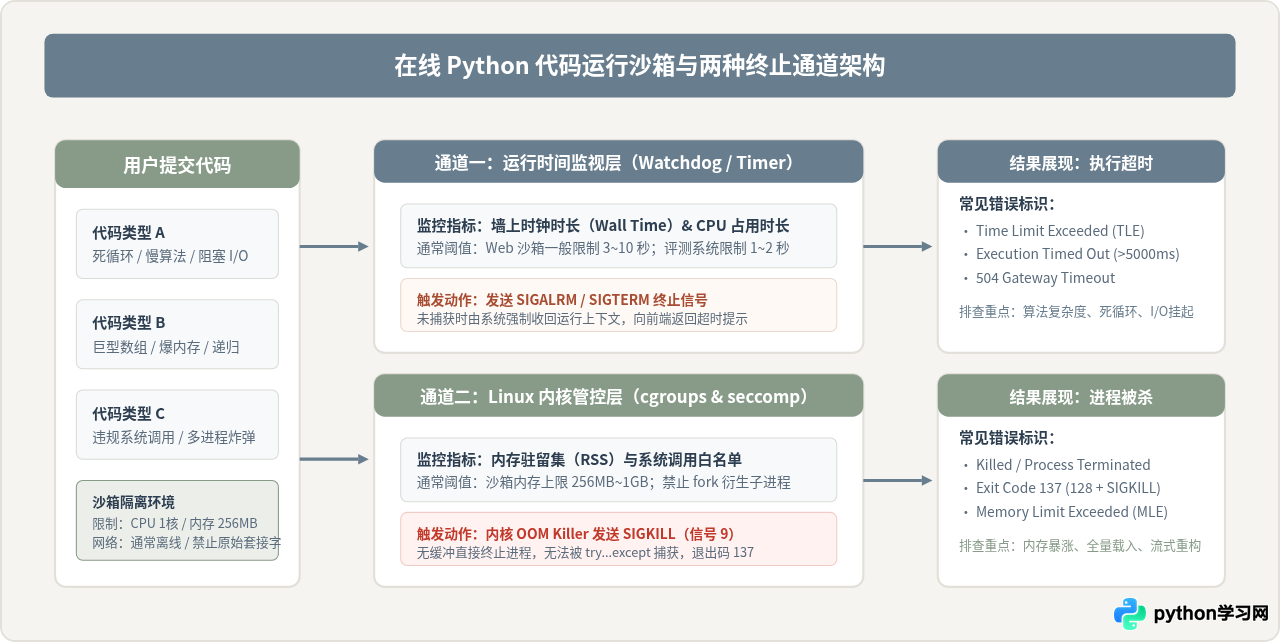
与本地开发环境不同,任何提供在线运行 Python 功能的平台都需要在多租户服务器上隔离用户代码。为了防止恶意脚本耗尽服务器资源或导致宿主机崩溃,平台普遍采用 Docker 容器、Linux cgroups(控制组)以及 seccomp(安全计算模式)构建微型沙箱。
在沙箱内,每一段提交的代码都会被施加严格的“硬性配额”。一旦程序越过某一项配额门槛,就会触发对应的终止机制。理解程序死亡的方式,是定位问题的第一步:
- 超时中断(Execution Timeout / Time Limit Exceeded):程序逻辑在规定的墙上时钟时间(Wall-clock Time)或 CPU 时间内未能完成全部执行,被沙箱管理进程通过发送
SIGALRM或SIGTERM信号强行停止。 - 进程被杀(Killed / Out of Memory / Exit Code 137):程序消耗的瞬时内存超过了沙箱 cgroups 的最大配额(
memory.max),或者尝试发起未经许可的系统调用。Linux 内核的 OOM Killer 会立即向该进程下发无法捕获、无法忽略的SIGKILL(信号 9),进程被操作系统瞬间抹除。
二、代码超时的三大核心诱因
超时通常意味着程序依然在合法运行,但运行所花费的实际时间超过了服务方愿意等待的上限。导致超时的常见诱因包括:
1. 逻辑未收敛或死循环
最常见的原因是 while 循环缺少退出条件或递增变量更新错误。此外,浮点数作为循环步长引起的精度问题也容易导致条件永远无法命中:
# 典型错误示例:浮点数累加导致条件判断永远不为 True
current = 0.0
target = 1.0
while current != target:
    current += 0.1  # 由于二进制浮点精度,current 经过累加为 0.9999999999999999 而非 1.0
    # 导致循环无限运行直至平台超时
2. 同步阻塞与不可达的外部 I/O
绝大多数在线沙箱出于网络安全考量,会切断外网访问权限,或者不分配可交互的标准输入流(stdin)。如果代码中包含以下操作,将会无限期挂起:
- 使用
input()尝试获取用户终端输入,但在线平台是以批处理方式运行,输入流始终处于 EOF 挂起状态。 - 使用
requests.get()发起网络请求,由于沙箱无公网出口且未设置timeout参数,底层 TCP 握手将持续阻塞直至平台超时。
3. 计算复杂度与数据规模失衡
本地测试时,使用 100 条小样本数据测试双重嵌套循环(O(n²))仅需几毫秒;但在线测评或真实运行平台会提供成千上万条输入。当数据量 n 达到 100,000 时,O(n²) 的循环操作次数高达 100 亿次,在单核 CPU 上耗时将达数分钟,必然超时。
三、进程被杀(Killed / 137)的底层机理
许多初学者看到终端显示 Killed 或返回状态码 137 时,往往误以为是程序“卡死了”,甚至尝试延长超时时间。事实上,进程被杀完全由内存或特权违背引起,与运行时间无关。
在 Linux 系统中,当进程因收到信号而终止时,其退出码计算公式为
128 + 信号编号。Linux 下的 SIGKILL 信号编号为 9,因此 128 + 9 = 137。这个状态码明确指示:进程并非正常退出,而是被内核直接击杀。
导致进程被杀的最主要因素包括:
- 瞬时加载过大对象:例如使用
file.read()一次性将数打百兆的文件读入字符串,或使用pd.read_csv()读取超出沙箱内存上限的大文件。Python 内部的对象封装开销通常是原始数据大小的 2~4 倍。 - 列表推导式或集合膨胀:尝试在内存中生成包含数千万元素的巨型列表,例如
[i for i in range(50000000)],该列表在 64 位 Python 解释器中仅指针数组就需要数百兆内存,瞬间击穿 cgroups 阈值。 - 深层递归耗尽调用栈:尽管 Python 有默认的递归深度限制(通常为 1000),但如果开发者盲目通过
sys.setrecursionlimit()调高上限,过度深度的函数调用栈帧将耗尽系统 C 栈内存,引发段错误(Segmentation fault)或被杀。 - 违规创建子进程或系统调用:通过
os.fork()或multiprocessing试图启动大量子进程,触发沙箱的进程数上限(pids.max)或 seccomp 规则拦截。
四、关键差异对比:超时 vs 被杀
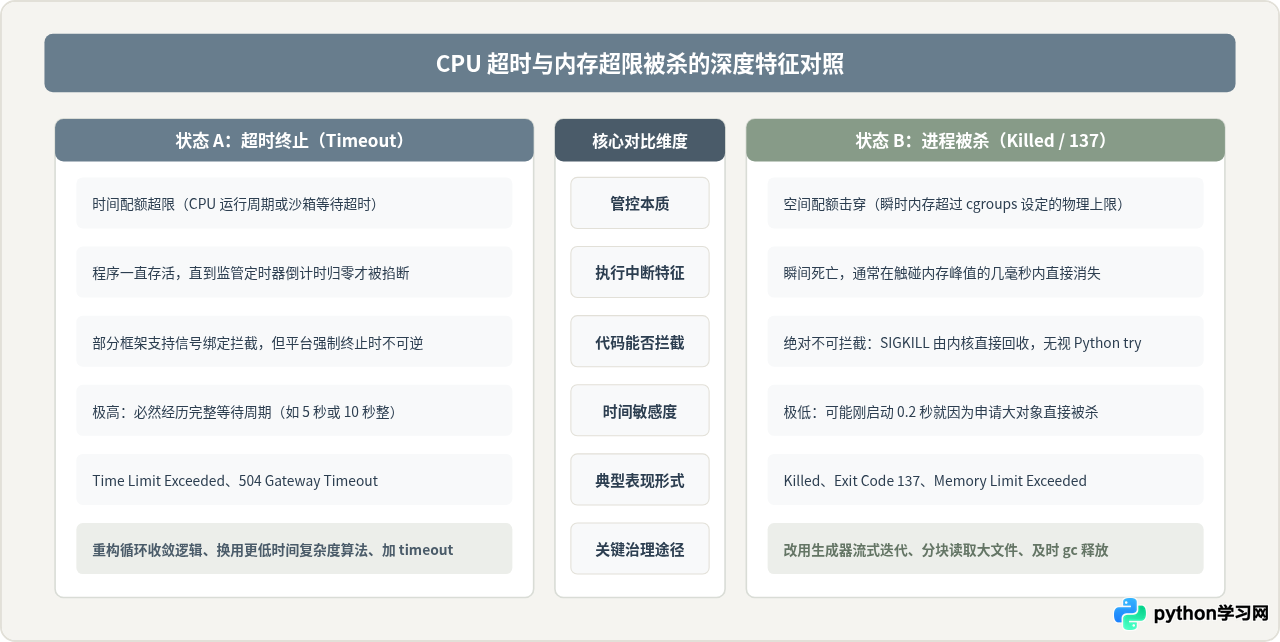
为了让读者在遇到报错时能够快速归类并采取针对性行动,下表对比了这两种失败状态在触发条件、诊断特征及修复路径上的关键差异:
| 对比维度 | 超时中断(Execution Timeout) | 进程被杀(Killed / Exit Code 137) |
|---|---|---|
| 触发主体 | 在线平台的外部监管进程 / 定时器(Watchdog) | 宿主机 Linux 内核的 OOM Killer / seccomp 子系统 |
| 限制指标 | 实际运行耗时(Wall Time)或 CPU 占用周期 | 进程驻留内存空间(RSS)或系统调用许可 |
| 信号机制 | 通常先发 SIGTERM,或直接由网关截断连接 |
直接下发不可捕获、不可忽略的 SIGKILL(Signal 9) |
| 异常捕获 | 内部若有定时告警机制可自行抛出,但平台截断后脚本无法继续 | try...except Exception 完全无法拦截,直接暴毙 |
| 常见典型代码 | while 死循环、未设超时的网络请求、O(n³) 低效算法 |
f.read() 读取巨型文件、数千万元素的普通 list、嵌套复制 |
| 解决核心思路 | 优化算法复杂度、消除死循环、给网络调用加 timeout | 改用生成器(Generator)、分批处理(Chunking)、流式迭代 |
五、排查与优化的四步标准化工作流
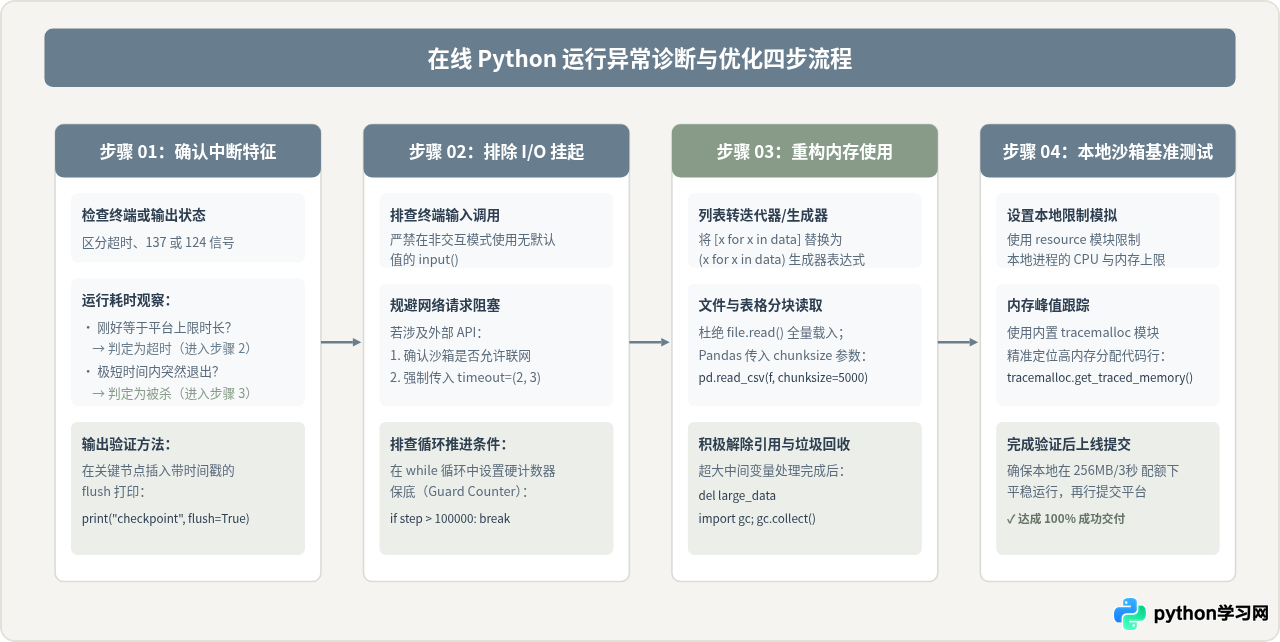
当在线运行 Python 遇到异常中断时,不要盲目猜测。遵循以下四个明确步骤,可以高效定位根本原因并完成修复:
代码优化实例:从“被杀/超时”到“毫秒级完成”
下面展示一个处理海量文本统计的真实对比案例。初学者常写出一次性读取全部文件并构造巨型字典的代码,导致在线沙箱瞬间因 OOM 被杀:
# ❌ 错误示范:极易触发内存溢出(Killed / 137)或超时
def process_logs_bad(filename):
    with open(filename, 'r', encoding='utf-8') as f:
        lines = f.readlines()  # 一次性将数千万行读入内存列表,瞬间撑爆内存

    result = []
    for line in lines:
        if "ERROR" in line:
            result.append(line.strip().split(","))  # 产生大量中间切片对象
return len(result)通过使用流式逐行迭代(Generator Streaming),让 Python 解释器在任何时刻内存中仅保留一行数据,内存占用恒定在几兆以内,且无需等待全部加载即可开始计算:
# ✔ 推荐写法:空间复杂度 O(1),平稳通过任何在线沙箱
def process_logs_optimized(filename):
    error_count = 0
    # 文件对象本身即为按需生成的迭代器,不会一次性装载全文
    with open(filename, 'r', encoding='utf-8') as f:
        for line in f:
            if "ERROR" in line:
                error_count += 1
    return error_count
六、本地资源仿真与防范实践
很多开发者困惑于“为什么代码在我自己的电脑上运行完全正常,一传到在线平台就超时或被杀”。根本原因在于现代 PC 普遍拥有 16GB 以上的物理内存和强劲的 CPU,即使用户代码存在严重的空间泄漏或 O(n²) 复杂度,庞大的本地内存也能默默吸收;而在线沙箱分配给单一会话的内存往往只有 128MB 到 512MB。
若要在本地完全复现并预判在线平台的沙箱限制,可以在开发与测试脚本头部加入 resource 模块(适用于 Linux 与 macOS 环境)对本进程实施自律配额限制:
import resource
import sys

def limit_virtual_memory(max_memory_mb=256, max_cpu_seconds=5):
    """
    在本地为当前 Python 进程施加与在线沙箱等价的硬件资源硬限制
    """
    # 限制最大虚拟内存(字节)
    max_memory_bytes = max_memory_mb * 1024 * 1024
    resource.setrlimit(resource.RLIMIT_AS, (max_memory_bytes, max_memory_bytes))

    # 限制最大 CPU 时间(秒)
    resource.setrlimit(resource.RLIMIT_CPU, (max_cpu_seconds, max_cpu_seconds))

if __name__ == "__main__":
    limit_virtual_memory(max_memory_mb=256, max_cpu_seconds=5)
    print("本地沙箱限制已激活:256MB 内存,5 秒 CPU 上限。")

    # 在该限制下运行核心业务逻辑,提前暴露潜在的超时或内存崩溃问题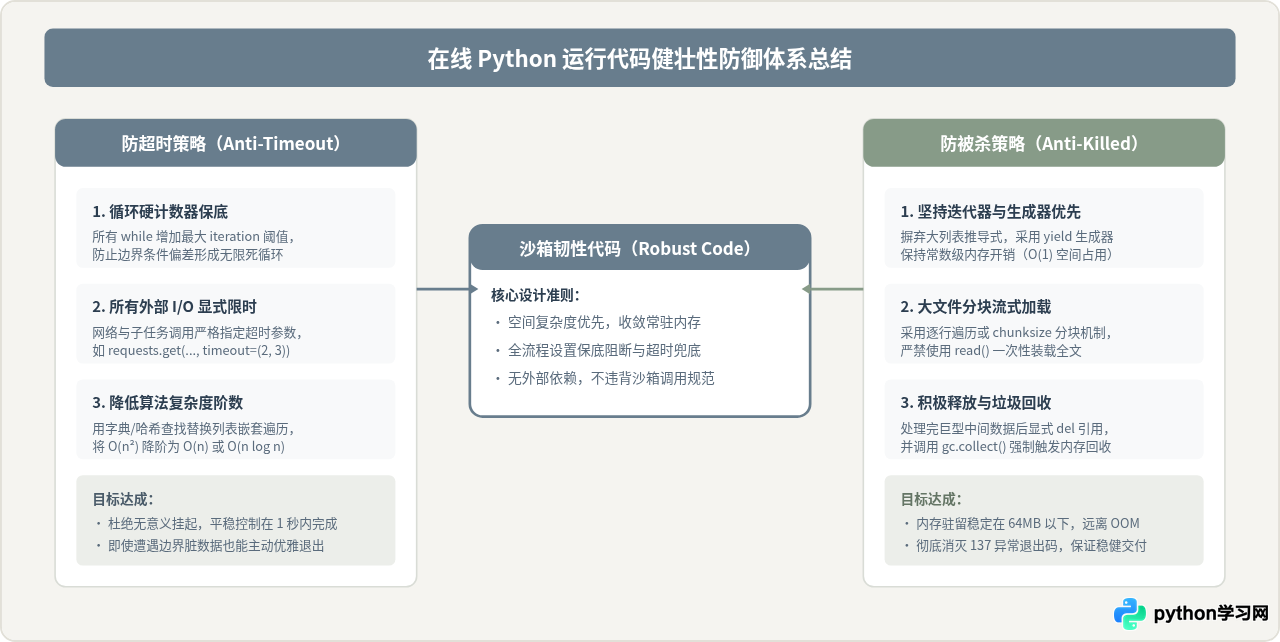
七、总结与常见疑问解答
在面对“超时”或“被杀”问题时,建立正确的心智模型至关重要:
- 看到 Time Limit Exceeded(超时),检查循环收敛性、I/O 阻塞点以及算法的大 O 阶数;不要试图申请更大内存,那无法解决计算耗时问题。
- 看到 Killed 或 Exit Code 137(被杀),直接检查内存消耗,将全量载入改为流式生成,将庞大的中间容器改为按需迭代;不要试图通过延长运行等待时间来解决,因为在触及内存天花板的那一刻,操作系统就已宣告了进程的死刑。
通过遵循上述排查路径与编码规范,开发者可以在严格受限的在线沙箱中写出既高效又极具韧性的 Python 程序。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









