

Python应用领域概览:Web开发、数据分析与自动化方向简介
全面梳理Python三大核心应用方向:Web后端开发、数据分析与自动化脚本。提供框架选型对比、典型工作流解析与具体代码示例,帮助初学者快速建立技术全景并明确切入路径。
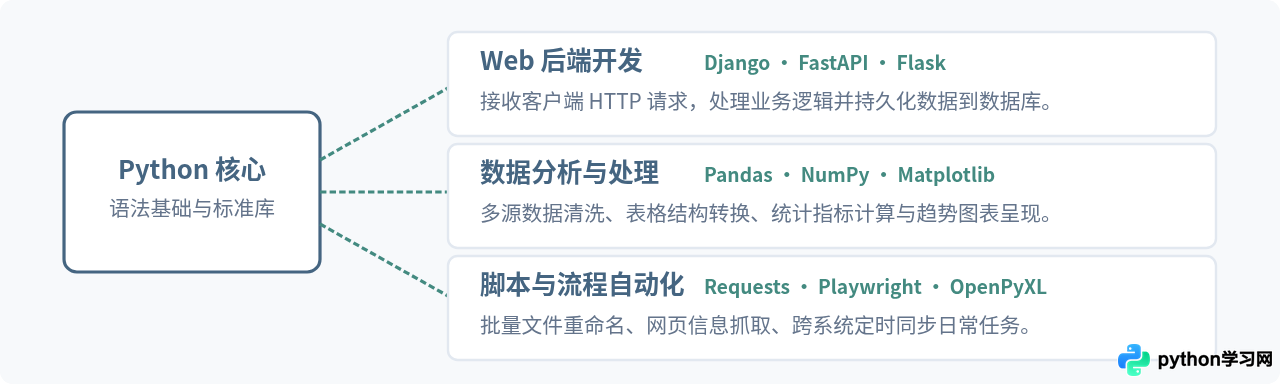
初学 Python 时,最容易让人困惑的不是语法本身,而是掌握了基础变量与循环后该往哪个方向写代码。在实际工程和日常工作中,Python 最成熟、社区生态最完善的三个应用落地分支是 Web 后端开发、数据分析与可视化 以及 办公与系统自动化。本文将针对这三个方向,拆解其解决的核心问题、常用技术栈、完整代码形态与实际落地场景。
方向一:Web 后端开发
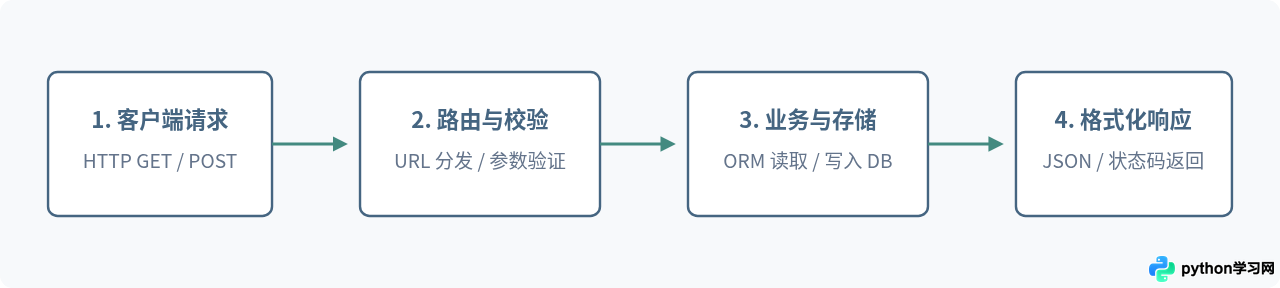
Web 服务的核心任务是处理网络交互:客户端(浏览器或移动端 App)发出网络请求,服务器接收后执行鉴权、增删查改数据库数据,最后组装成指定格式(通常是 JSON 或 HTML)返回给客户端。Python 在这个方向的优势在于开箱即用的网络库与成熟的框架体系,能够极快地把业务接口搭建起来。
主流框架选型对比
- FastAPI: 现代高并发 API 开发的首选框架。它原生支持 Python 类型提示(Type Hints)与异步处理(
async/await),并能在服务启动时自动生成符合 OpenAPI 标准的交互式在线接口文档。 - Django: 典型的“全包型”(Batteries-Included)重量级框架。内置完善的后台管理系统(Admin)、ORM 数据库映射层、身份认证与表单系统,适合需要快速成型的大型综合网站。
- Flask: 微内核极简框架。核心仅包含路由与上下文机制,没有捆绑任何数据库或表单库,开发者可以根据具体需求自由挑选插件拼装架构。
基础接口实现示例(基于 FastAPI)
下面是一段标准的现代 Python API 脚本,使用 FastAPI 框架创建一个包含参数检验和状态码返回的接口:
# 依赖环境:pip install fastapi uvicorn
from fastapi import FastAPI
from pydantic import BaseModel

app = FastAPI()

class Item(BaseModel):
    title: str
    price: float
    is_active: bool = True

@app.post("/items/")
async def create_item(item: Item):
    # 此处为处理业务逻辑的位置,例如写入 SQLite/MySQL
    return {"status": "success", "data": item.dict()}

# 执行命令:uvicorn main:app --reload方向二:数据分析与处理
数据分析方向旨在解决“将杂乱的原始数据整理成可供业务决策参考的信息”这一需求。无论是电商订单数据清洗、运营指标报表统计,还是财务坏账检测,Python 的工作模式基本围绕 获取数据 → 清洗重塑 → 指标汇总 → 输出图表 四个环节展开。
核心数据工具链
- Pandas: 核心依托
DataFrame(二维结构化数据表),能高效处理缺失值、类型转换、分组聚合(GroupBy)与多表关联拼接。 - NumPy: 为 Python 提供底层高性能多维数组运算支持,是大部分数据与科学计算库的基础。
- Matplotlib / Seaborn: 数据可视化库,可将数值分布绘制成折线图、柱状图、热力图或散点图。
典型数据分析操作步骤
- 读取与加载: 从 CSV、Excel、数据库拉取数据并建立数据表结构。
- 数据清洗: 删除冗余空行、修复异常格式字段(如把字符串格式的日期转为系统时间戳)。
- 计算衍生特征: 针对各分类组统计求和、均值、留存率或转化率。
- 结果导出: 导出结构化报表至 Excel 或绘制静态/交互式图表。
# 依赖环境:pip install pandas
import pandas as pd

# 1. 加载并构建原始数据表
raw_data = {
    "department": ["技术", "销售", "技术", "销售", "行政"],
    "salary": [12000, 8000, 15000, 9500, None]
}
df = pd.DataFrame(raw_data)

# 2. 清洗缺失数据:填充行政部门的空缺薪水为中位数
df["salary"] = df["salary"].fillna(df["salary"].median())

# 3. 按部门分组,计算平均薪资
result = df.groupby("department")["salary"].mean().reset_index()
print(result)

# 示例输出:
#   department   salary
# 0       行政  10750.0
# 1       技术  13500.0
# 2 销售 8750.0方向三:办公与系统自动化
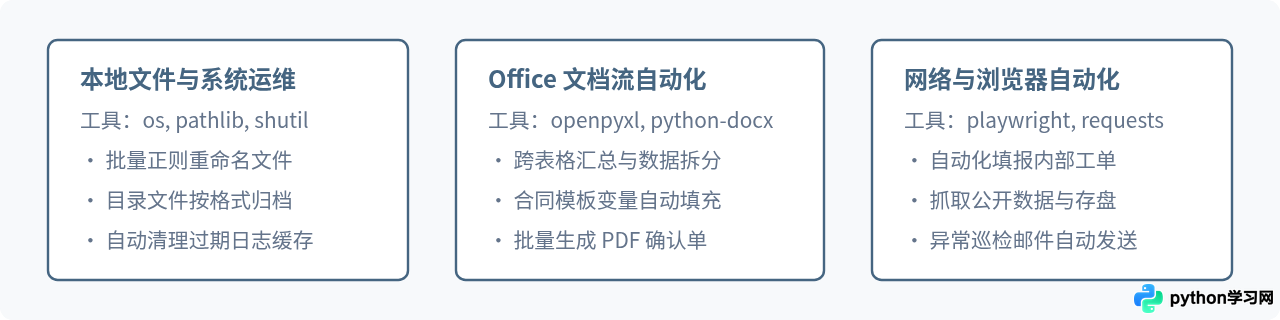
自动化方向的核心目标是消除重复劳动。凡是具有“固定规则、固定步骤、高频重复”特征的计算机操作,都可以编写脚本让计算机在后台静默运行。
办公文件处理演示:批量重命名文件
以下脚本利用 Python 标准库中的 pathlib 模块,批量扫描目标文件夹中的所有 .txt 文件,在文件名前加上修改日期前缀,避免手动修改几百个文件的重复操作:
import datetime
from pathlib import Path

target_dir = Path("./documents")

# 遍历目标目录下所有 .txt 文件并添加当天日期前缀
if target_dir.exists():
    today = datetime.date.today().strftime("%Y%m%d")
    for file_path in target_dir.glob("*.txt"):
        new_name = f"{today}_{file_path.name}"
        new_path = file_path.with_name(new_name)
        file_path.rename(new_path)
        print(f"已重命名: {file_path.name} -> {new_name}")
else:
    print("目标目录不存在,请检查路径。")
三个方向的差异与切入建议
为了避免在不同的学习路径中迷失,读者需要明确三个方向在工作方式和技能壁垒上的差异。下表汇总了三个方向的核心门槛与应用产出:
| 方向 | 典型交付产物 | 学习门槛关键点 | 适合人群 |
|---|---|---|---|
| Web 开发 | RESTful API、后台管理系统、SAAS 服务 | 需理解 HTTP 协议、数据库范式、异步与网络安全 | 目标成为专职后端工程师、全栈开发者 |
| 数据分析 | 统计报告、商业智能仪表盘、趋势图 | 需掌握统计指标、多维切片逻辑与表格重组思维 | 运营、财务、市场研究及数据岗位人员 |
| 办公自动化 | 定时任务脚本、批量文件处理工具、自动化填报流 | 门槛最低,聚焦在熟练调用针对具体文件的第三方库 | 需要解决手头繁琐重复电脑劳动的职场人士 |
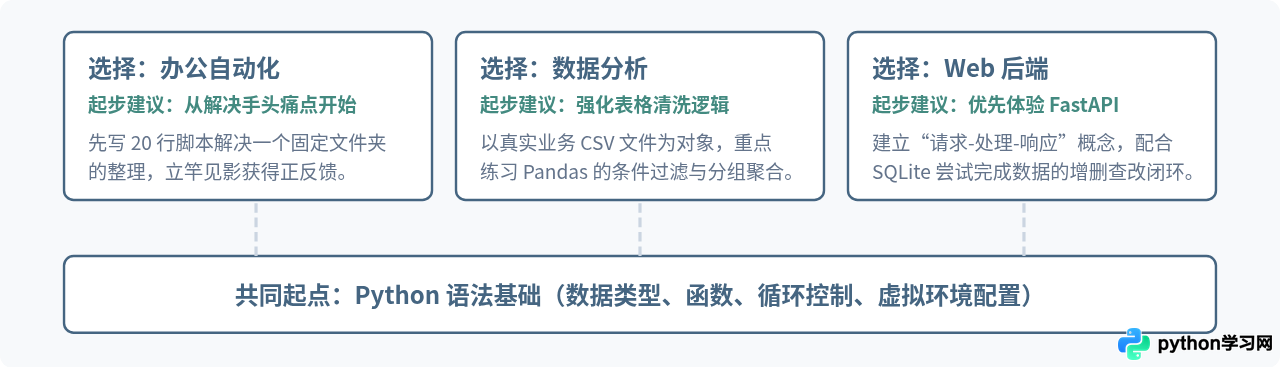
明确目标后,无需在一开始追求面面俱到。建议优先选择与自己当前工作或目标岗位关联度最高的分支,完成一个微小却完整的功能(如自动处理一张 Excel 表或跑通一个返回数据的接口),再逐步扩充技术栈。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









