

用Seaborn简化Python统计绘图:热力图与分布图代码示例
本文详细介绍如何使用Python的Seaborn库简化统计绘图,重点解析相关性热力图(heatmap)与数据分布图(histplot/kdeplot)的核心原理、常用参数与完整可执行代码示例。
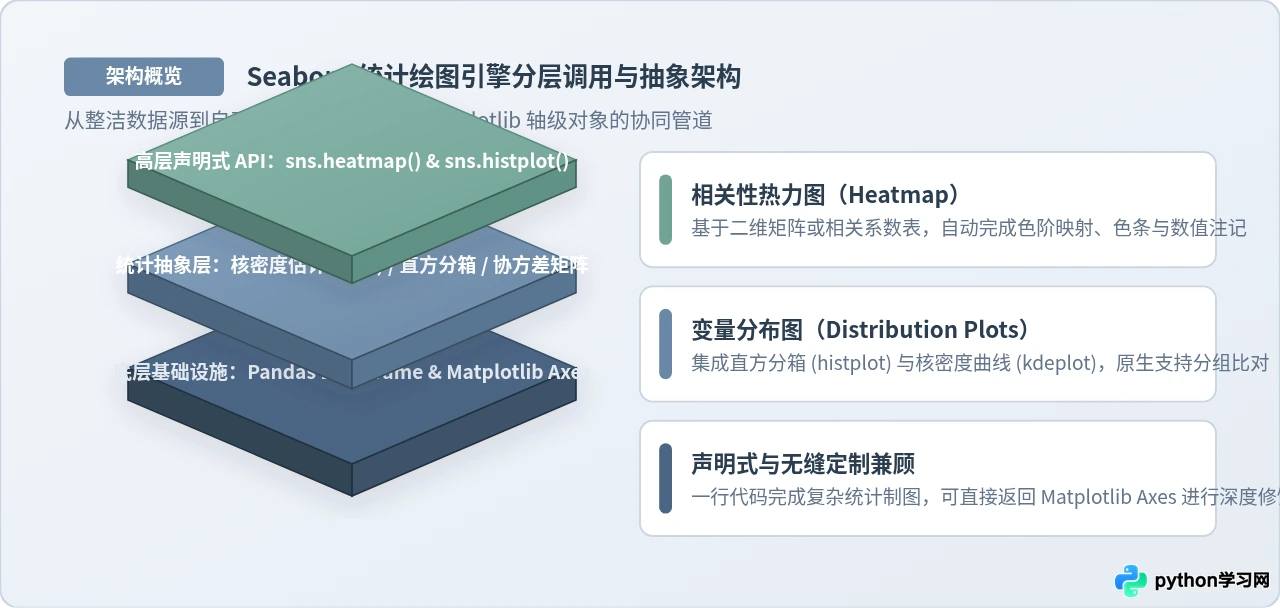
在 Python 数据科学与统计分析工作中,基础绘图库 Matplotlib 赋予了开发者底层像素级的精细控制权,但绘制统计图表往往需要手动处理频数分箱、核函数密度积分、色阶归一化以及图例拼装等繁琐代码。Seaborn 作为构建在 Matplotlib 之上的高级统计可视化工具,深度集成了 Pandas DataFrame 的整洁数据(Tidy Data)结构,将多维统计计算与美学映射压缩进直观的声明式接口中。本文直接切入数据探索中最关键的两类图表——反映多变量关联程度的相关性热力图(Heatmap)与反映单/双变量概率形态的分布图(Distribution Plots),通过完整代码示例、核心参数拆解与底层推导图解,帮助读者建立清晰可靠的统计制图实践规范。
一、准备工作与环境依赖约定
运行本文示例代码前,请确保 Python 环境中已安装 seaborn(建议版本 ≥ 0.12.0)、matplotlib、pandas 和 numpy。在主流终端或 Jupyter 笔记本中,可以通过以下命令确认依赖:
pip install seaborn matplotlib pandas numpy在编写绘图逻辑之前,通常需进行全局主题设置和中文字体支持配置。Matplotlib 默认缺少对中文字符的映射,容易导致坐标轴标签与图例出现空白方块(乱码);负号(-)在特定字体环境下也可能被错误解析。标准初始化脚本如下:
import seaborn as sns
import matplotlib.pyplot as plt
import pandas as pd
import numpy as np

# 设置统一的主题风格为浅色网格
sns.set_theme(style="whitegrid")

# 兼容中文字体与负号正常显示
plt.rcParams['font.sans-serif'] = ['PingFang SC', 'Microsoft YaHei', 'SimHei', 'sans-serif']
plt.rcParams['axes.unicode_minus'] = False二、绘制相关性热力图(Heatmap)与常用参数实战
热力图通过颜色深浅把二维数字矩阵直观化。在探索性数据分析(EDA)阶段,它最常用于展示多元连续特征之间的相关系数矩阵(Correlation Matrix),帮助识别特征间的共线性与强关联信号。
1. 完整代码示例:从模拟多维数据到半三角热力图
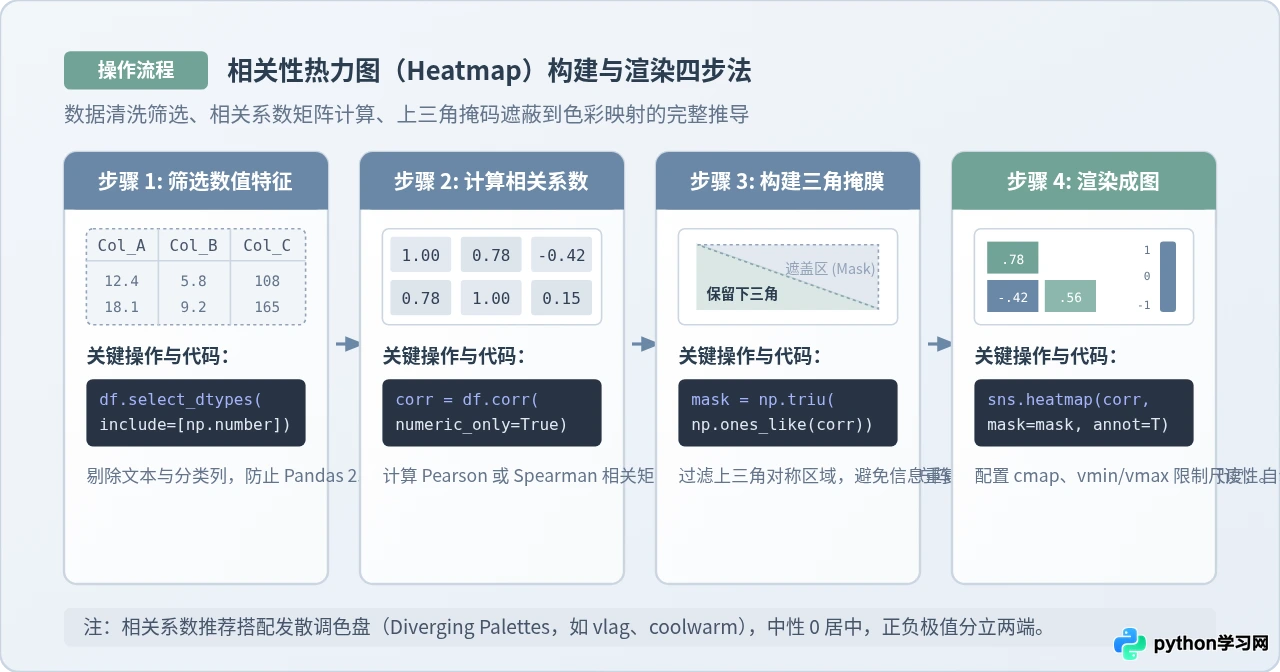
以下示例构建了包含 5 个数值变量与 1 个分类变量的示例数据集,展示如何清洗非数值列、计算皮尔逊相关系数、构建上三角掩码(Mask)消除视觉重复,并渲染高可读性的热力图:
# 1. 构造具有可复现特征的多变量示例数据
np.random.seed(42)
n_samples = 200

feature_a = np.random.normal(loc=50, scale=10, size=n_samples)
feature_b = feature_a * 0.75 + np.random.normal(loc=10, scale=4, size=n_samples)  # 与 A 强正相关
feature_c = -feature_a * 0.5 + np.random.normal(loc=30, scale=5, size=n_samples)  # 与 A 显著负相关
feature_d = np.random.exponential(scale=15, size=n_samples)                         # 偏态独立变量
feature_e = feature_b * 0.6 - feature_c * 0.4 + np.random.normal(size=n_samples)    # 综合变量

df_house = pd.DataFrame({
    '面积_A': feature_a,
    '总价_B': feature_b,
    '房龄_C': feature_c,
    '距离_D': feature_d,
    '评级_E': feature_e,
    '区域类别': np.random.choice(['东区', '西区', '南区'], size=n_samples)
})

# 2. 计算相关矩阵(明确指定 numeric_only=True 以兼顾 Pandas 2.0+ 兼容性)
corr_matrix = df_house.corr(numeric_only=True)

# 3. 构造上三角掩码矩阵,遮挡对角线上方的冗余对称数据
mask = np.triu(np.ones_like(corr_matrix, dtype=bool))

# 4. 创建画布并使用 Seaborn 绘制热力图
plt.figure(figsize=(8, 6), dpi=120)
sns.heatmap(
    corr_matrix,
    mask=mask,                  # 遮盖上三角
    annot=True,                 # 单元格内显示数值
    fmt=".2f",                  # 保留两位小数
    cmap="vlag",                # 发散色系(中间为中性色,正负分别延伸)
    vmin=-1.0,                  # 锁定色阶下界
    vmax=1.0,                   # 锁定色阶上界
    center=0.0,                 # 居中参考点
    square=True,                # 保持单元格为正方形
    linewidths=0.8,             # 单元格间隔网格线宽
    linecolor="white",           # 网格线颜色
    cbar_kws={"shrink": 0.8, "label": "皮尔逊相关系数"}
)

plt.title("房产指标特征相关性热力图(下三角清晰视图)", fontsize=14, pad=16)
plt.tight_layout()
# plt.show()2. 热力图关键参数解析与选型
sns.heatmap() 拥有数十个控制参数,在实际应用中需要着重关注以下几项配置:
annot与fmt:annot=True开启文字标注。务必显式指定格式化字符串(如fmt=".2f"或百分比fmt=".1%"),否则默认输出科学计数法,严重破坏排版可读性。cmap(调色盘)选择:相关系数在 -1 到 1 之间震荡,属于典型的双极对称数据,必须选用发散调色盘(Diverging Colormaps),如"vlag"、"coolwarm"、"BrBG"。切忌在此场景使用单向渐变色阶(如"Blues"),否则读者无法直观辨析 0 处的无相关状态。vmin、vmax与center:即便当前数据集计算出的最大相关系数仅为 0.72,也应显式固定vmin=-1.0与vmax=1.0。这能确保颜色深浅代表真实的统计绝对强度,避免读者因色阶被局部放大而产生错误归因。mask:相关矩阵沿主对角线对称,全部展示不仅冗余,还会引起视觉疲劳。利用np.triu()构造布尔矩阵传给mask,能将图表信息密度减半,保留高价值数据。
三、绘制变量分布图(Distribution Plots)与多维对比
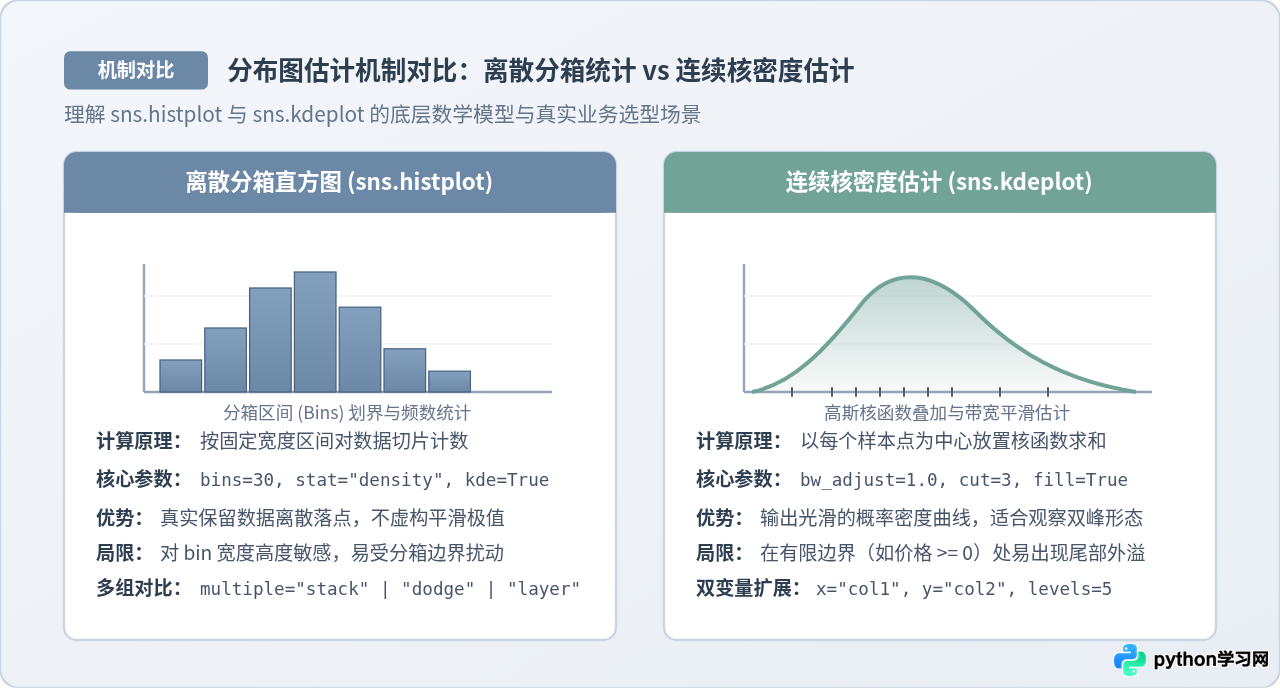
在探索连续变量的数据形态时,我们关注其集中趋势、离散程度、偏度(Skewness)、多峰状态以及异常尾部。Seaborn 历经版本重构后,推荐使用 sns.histplot(直方分箱与频数统计)和 sns.kdeplot(连续核密度曲线拟合)替代早期的单一入口 sns.distplot。
1. 完整代码示例:单变量直方与多类别分组分布对比
以下示例演示如何在同一画布的多个子图(Subplots)中,分别呈现单变量密度拟合、核密度带宽平滑调整,以及基于 hue 参数的多类别堆叠比对:
# 1. 构建双峰与偏态混合分布样本
np.random.seed(101)
sample_size = 600

# 模拟不同业务组别的客户活跃时长数据
group_a = np.random.normal(loc=25, scale=6, size=sample_size // 2)
group_b1 = np.random.normal(loc=18, scale=3, size=sample_size // 4)
group_b2 = np.random.normal(loc=42, scale=5, size=sample_size // 4)
group_b = np.concatenate([group_b1, group_b2])  # 典型的双峰分布

df_activity = pd.DataFrame({
    '活跃时长': np.concatenate([group_a, group_b]),
    '用户层级': ['普通会员'] * (sample_size // 2) + ['高阶会员'] * (sample_size // 2)
})

# 2. 创建 1 行 2 列的子图画布
fig, axes = plt.subplots(1, 2, figsize=(14, 5), dpi=120)

# 子图 1: 单变量直方图叠加 KDE 曲线,并按比例归一化为密度(Density)
sns.histplot(
    data=df_activity,
    x='活跃时长',
    bins=30,                   # 分箱数量
    kde=True,                  # 同步拟合平滑密度线
    stat="density",            # Y 轴显示概率密度而非原始频数
    color="#6B88A6",           # 主色雾蓝
    edgecolor="#FFFFFF",       # 柱状图边框高亮
    linewidth=0.8,
    ax=axes[0]
)
axes[0].set_title("全量用户活跃时长分布(直方分箱 + 核密度拟合)", fontsize=12, pad=10)
axes[0].set_xlabel("每日活跃时长(分钟)")
axes[0].set_ylabel("概率密度 (Density)")

# 子图 2: 多分组对比,使用 element="step" 消除柱状遮挡
sns.histplot(
    data=df_activity,
    x='活跃时长',
    hue='用户层级',
    element="step",            # 阶梯状边界轮廓,避免实心柱体互相掩盖
    stat="density",
    common_norm=False,         # 各组各自独立归一化,便于形态比对
    palette=["#6B88A6", "#71A397"],
    linewidth=1.8,
    ax=axes[1]
)
axes[1].set_title("不同会员层级活跃时长形态比对(阶梯直方模式)", fontsize=12, pad=10)
axes[1].set_xlabel('每日活跃时长(分钟)')
axes[1].set_ylabel('组内独立概率密度')

plt.tight_layout()
# plt.show()2. 分布图进阶参数与核密度控制技巧
stat统计度量转换:默认stat="count"展示绝对频数;当两组样本量相差悬殊时,绝对频数会导致小样本组完全被压平,此时应切换为stat="density"(曲线下面积积分为 1)或stat="probability"(各柱高度和为 1)。multiple与element的排布模式:multiple="layer":默认半透明层叠,容易相互掩盖;multiple="dodge":并排并列柱,适合离散取值或分组数量 ≤ 3 的情况;multiple="stack":垂直堆叠柱,适合观察总量及各组结构占比;element="step"或element="poly":以轮廓线或多边形展示,是对比多个连续分布形态的最佳实践。
bw_adjust平滑带宽调节:在sns.kdeplot中,bw_adjust控制核函数的平滑窗口。默认值为 1.0;若设置为0.5,曲线对局部波动更敏感,适合探测尖锐的多峰形态;若设置为2.0,曲线将更平缓,有利于过滤随机噪声。
四、Seaborn 接口体系与图层调度深度解析
许多初学者在将 Seaborn 嵌入已有报表布局时,常遇到图例错位、画布尺寸失控或 ax 报错的问题。根本原因在于混淆了 Seaborn 的两套 API 体系:轴级函数(Axes-level)与图形级函数(Figure-level)。
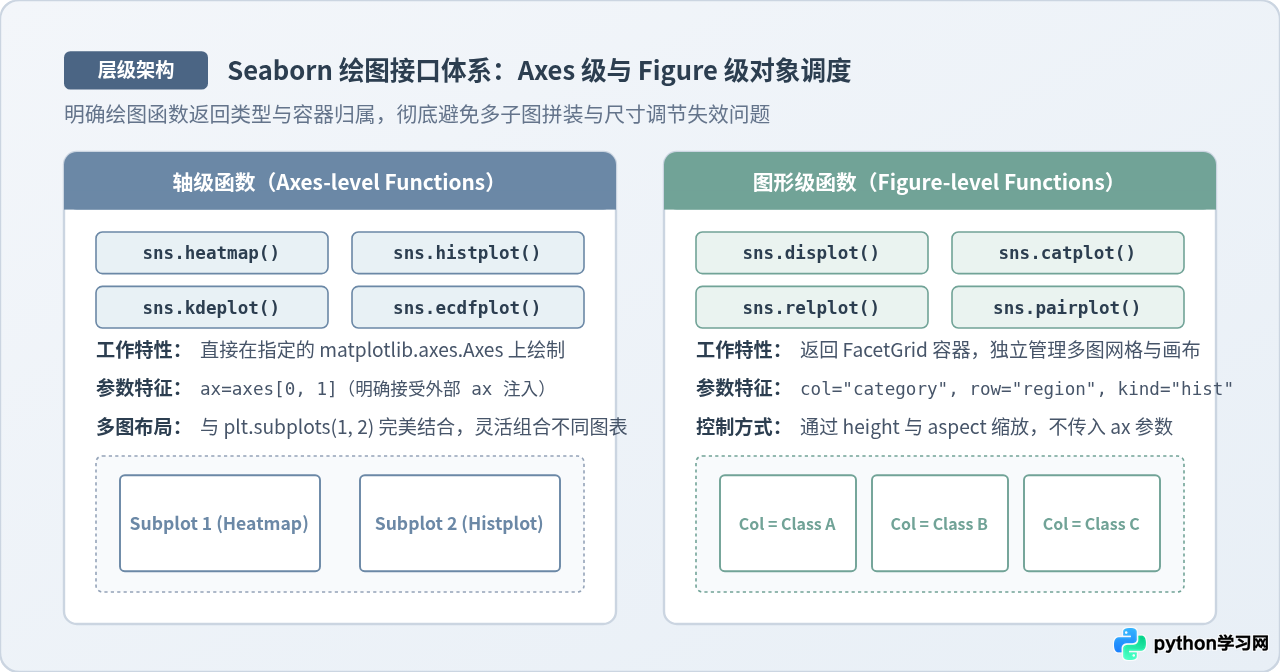
| 对比维度 | 轴级函数(Axes-level) | 图形级函数(Figure-level) |
|---|---|---|
| 代表函数 | sns.heatmap()、sns.histplot()、sns.kdeplot() |
sns.displot()、sns.catplot()、sns.pairplot() |
| 返回对象 | matplotlib.axes.Axes |
seaborn.axisgrid.FacetGrid |
| 多图组合能力 | 可任意传入 plt.subplots() 实例,高度自由 |
自带 col 与 row 参数切片,自动构建规则网格 |
| 尺寸调节方式 | 由 Matplotlib 的 plt.figure(figsize=(w, h)) 决定 |
由函数内部参数 height 与 aspect 统一推算 |
| 典型适用场景 | 构建定制化仪表板、拼合不同类型图表、精细化坐标轴修改 | 单类型图表的多维类别切片(如按城市分列展示分布) |
五、生产环境常见报错与避坑指南
1. Pandas 2.0+ 调用 corr() 报错 ValueError
报错表现:在较新版本的 Pandas 中,直接运行 df.corr() 会抛出 ValueError: could not convert string to float。
产生根源:旧版 Pandas 会自动在底层静默丢弃非数值字段,而 Pandas 2.0+ 将 numeric_only 参数的默认值调整为 False,检测到字符串列时即终止执行。
规范写法:必须显式传入 df.corr(numeric_only=True),或在计算前主动通过 df.select_dtypes(include=[np.number]) 提取纯数值子集。
2. KDE 密度估计在绝对边界处的“虚假外溢”
异常表现:当绘制诸如“年龄”、“商品单价”等严格大于等于 0 的物理量时,KDE 曲线在 0 左侧依然延伸出了平滑尾部,导致负值区间出现概率分布。
产生根源:核密度估计假设底层连续分布无边界约束,在边缘样本点处放置的高斯核必然向两侧对称扩散。
规范写法:在 sns.kdeplot 中设置 cut=0,告知算法截断核函数的外推边界,紧密贴合数据的实际物理极值。
3. 热力图标签被裁切或刻度倾斜重叠
异常表现:特征名称较长时,热力图下方的横向标签相互重叠,或边缘文字被截断在图像外部。
规范写法:在保存或展示图像前调用 plt.xticks(rotation=45, ha='right') 倾斜文字,并在最后执行 plt.tight_layout() 或在保存时指定 plt.savefig('output.png', bbox_inches='tight', dpi=300)。
六、统计图表选型与参数决策总结
在实际项目的数据挖掘流程中,面对纷繁复杂的数据维度,选择热力图还是分布图、配置何种统计参数,可通过以下决策路径进行快速对齐:
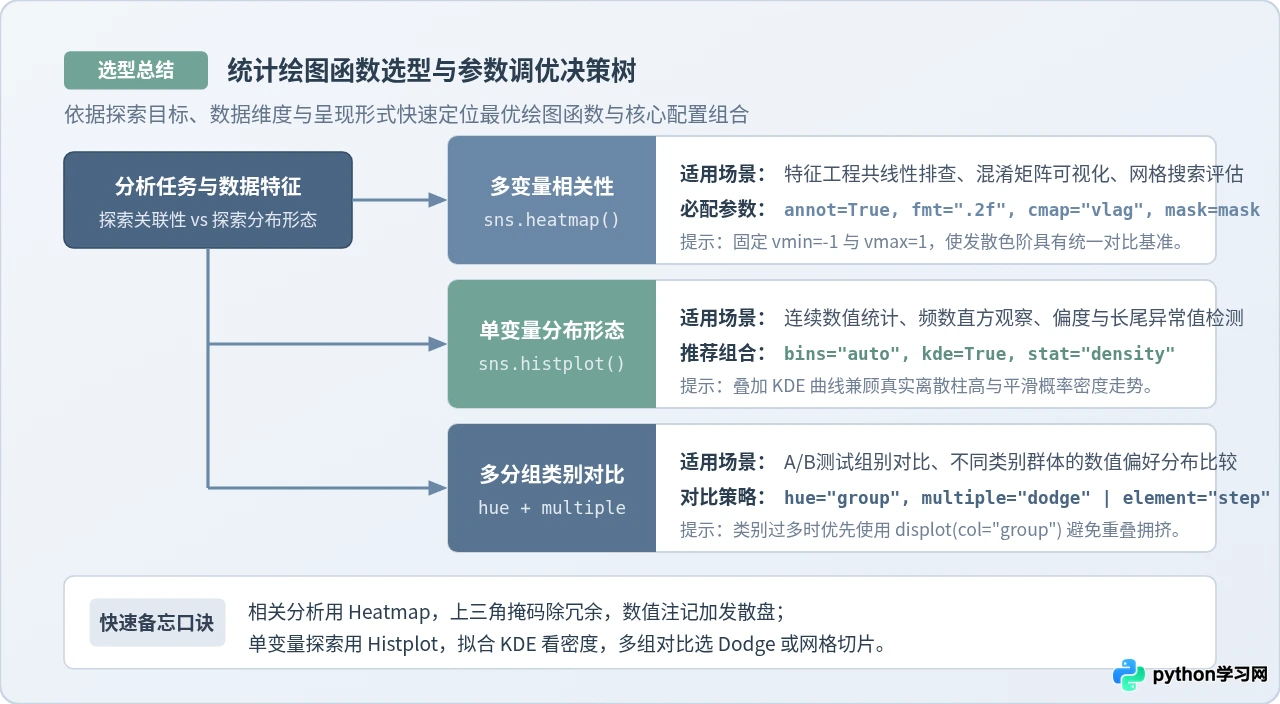
通过合理结合 sns.heatmap() 的矩阵压缩表达与 sns.histplot() / sns.kdeplot() 的概率形态透视,分析师能够用极简的代码行数覆盖绝大部分探索性统计分析需求。掌握 Axes 级对象的注入机制与颜色映射逻辑,更能让生成的统计图表兼具工程鲁棒性与出版级美观度。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









