

Python源文件是什么:.py文件的定义与基本结构
深入解析Python源文件的定义与物理本质,系统拆解.py文件的六大标准组成结构、__name__双模式执行机制,并提供完整的编写规范与避坑实操指南。
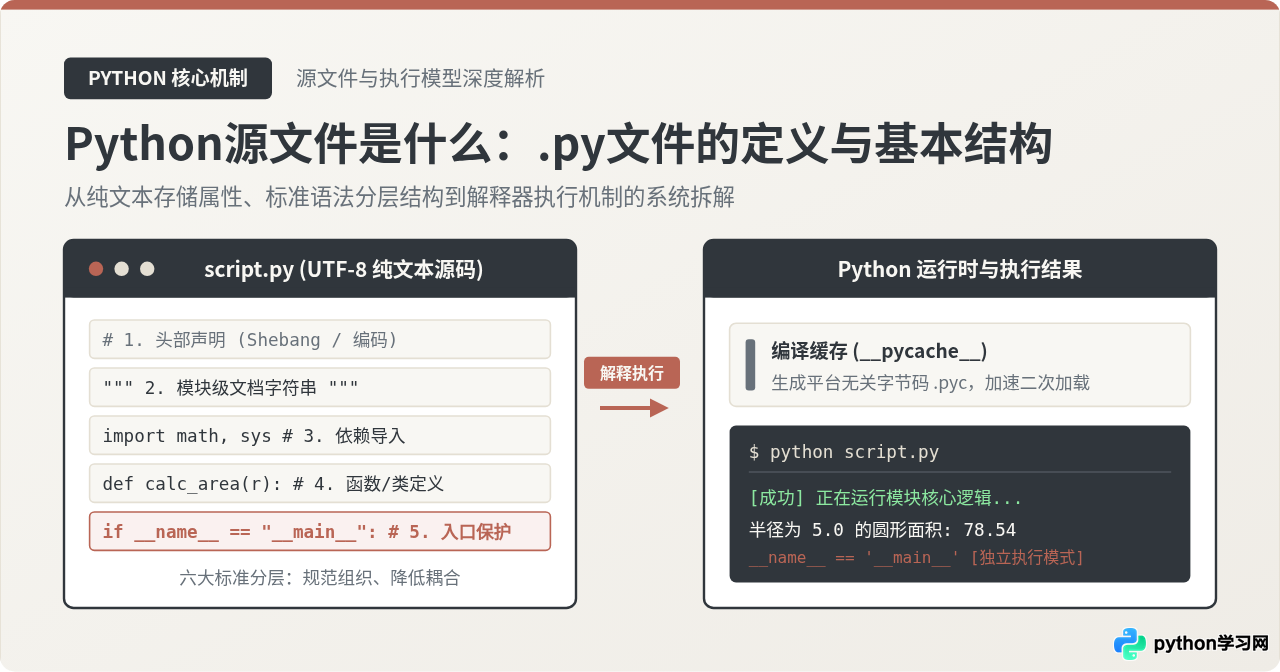
初学编程时,很多人会产生一个疑问:我们在代码编辑器里写下的一行行代码,到底是以什么形式保存在电脑里的?为什么保存的文件必须以 .py 结尾?打开它究竟会发生什么?
简单直接地回答:Python源文件在物理上就是一个遵循特定字符编码(现代Python默认且强制推荐为UTF-8)的纯文本文件,其在操作系统层面的标准扩展名为 .py。 它内部保存的是符合Python语法规则的纯英文字符、标点与换行。它不是无法直接读取的专有二进制程序,而是专门供Python解释器(Python Interpreter)按自上而下的顺序进行词法分析、编译为中间字节码并逐条解释执行的“脚本图纸”。
理解一个规范的 .py 文件如何构成,不仅能帮助我们写出结构清晰、符合工程规范(PEP 8)的代码,更能彻底理清诸如“为什么要写 if __name__ == '__main__':”、“模块导入时到底发生了什么”等底层核心机制。本文将从底层定义、标准分层结构、执行原理到避坑实操,完整拆解Python源文件的全貌。
一、.py文件的物理本质与运行原理
要真正理解Python源文件,首先需要分清“源文件的存储形态”与“源文件的执行过程”两者的界限。
1. 纯文本存储:没有秘密的普通文件
很多初学者会误以为 .py 是一种特殊的、被Python软件“加密”或“打包”过的二进制格式。事实恰恰相反:
- 任何纯文本编辑器均可打开与编辑: 无论是专业的 VS Code、PyCharm,还是系统自带的记事本(Notepad)、Vim、Nano,都可以毫无障碍地打开
.py文件。你看到的字符就是硬盘上真实存储的内容。 - 标准扩展名
.py的本质作用: 扩展名并不是给Python解释器看的,而是给操作系统和开发者工具识别的标记。操作系统通过.py识别该文件关联的打开程序;开发工具通过.py开启语法高亮、自动补全与错误检查。即使你将文件命名为script.txt,在终端运行python3 script.txt,只要里面的语法正确,解释器依然能够正常运行,但工程规范上严禁这样做。 - 命名限制与边界:
.py文件名应由小写字母、下划线和数字组成,且不能以数字开头,更严禁与Python内置模块同名(例如绝对不要命名为math.py、random.py、test.py或json.py,否则会导致标准库被自己覆盖,引发严重导入故障)。
2. 从纯文本到屏幕输出:解释器的三阶流水线
计算机CPU无法直接看懂 print("Hello") 这类英文字符,那 .py 文件是如何驱动机器运行的?当你在终端敲下 python demo.py 时,Python解释器在底层迅速完成了以下三个连续阶段:
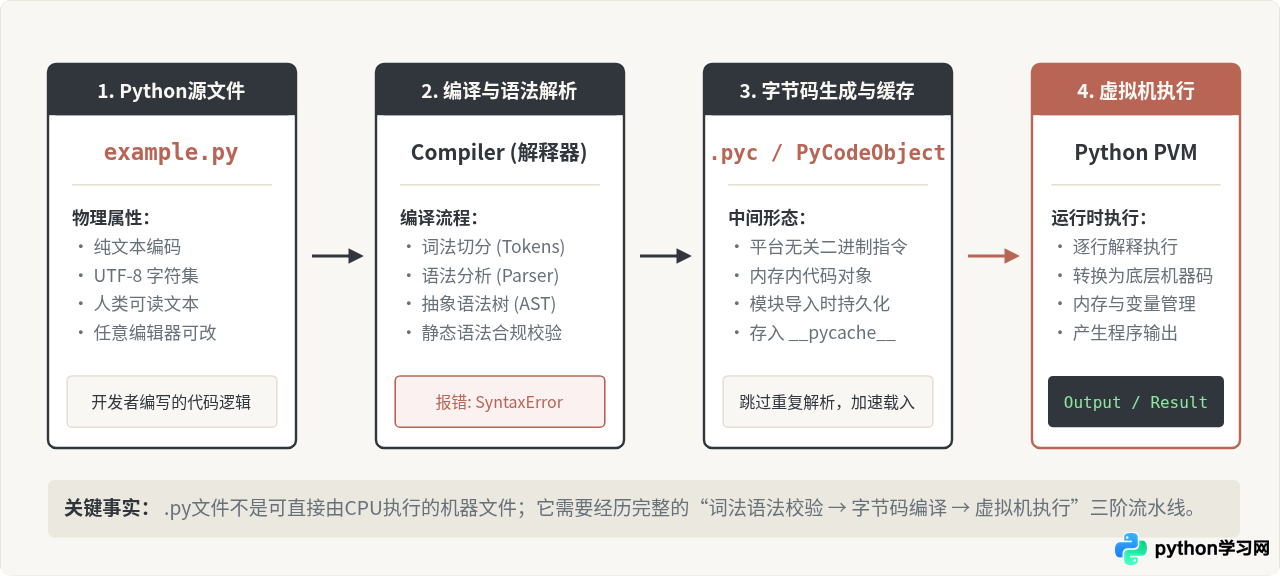
- 词法与语法分析(Lexing & Parsing): 解释器读取源码文本,将其拆解为一个个标记(Token),并构建成抽象语法树(AST)。如果代码中有少写括号、冒号或缩进混乱,解释器会在这个阶段立即报错并终止,抛出
SyntaxError。 - 编译生成字节码(Bytecode Compilation): 语法检查通过后,解释器将代码转换为一系列更加紧凑、平台无关的中间指令(即字节码,如
LOAD_CONST,CALL_FUNCTION)。如果该文件是作为模块被其他文件import引入的,解释器还会自动在同级目录下创建__pycache__文件夹,将编译好的字节码写入.pyc文件中,以便下次运行时直接读取,跳过编译开销。 - 虚拟机解释执行(Python Virtual Machine, PVM): PVM逐行循环读取字节码,将其翻译为当前操作系统与CPU硬件能理解的原生机器指令,最终完成打印输出、磁盘读写或数学运算。
二、Python源文件的标准结构组织规范
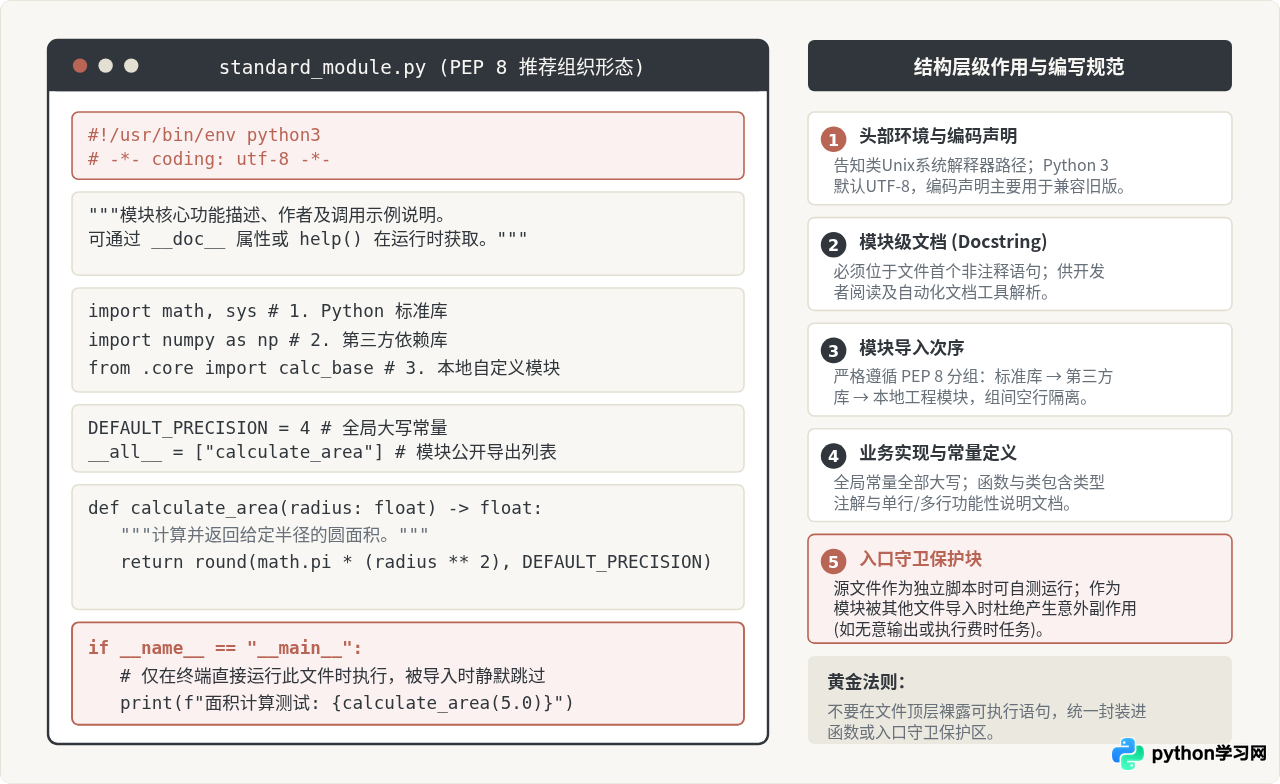
虽然Python语法允许你随心所欲地在任何位置写 print(),但在成熟的工程实践中,杂乱无章的源文件会带来灾难性的阅读困难与依赖混乱。官方的 PEP 8(Python代码风格指南) 为一个标准的 .py 文件推荐了层次分明的六大组成区块:
| 结构层次 | 典型代码格式 | 作用说明与编写注意事项 |
|---|---|---|
| 1. 头部环境与编码 | #!/usr/bin/env python3# -*- coding: utf-8 -*- |
Shebang告知Linux/macOS系统解释器路径;Python 3默认使用UTF-8编码,显式声明可增强在旧环境或特殊工具下的兼容性。 |
| 2. 模块文档字符串 | """模块功能简述与使用说明...""" |
位于文件最开头的多行三引号注释,解释本模块的职责与对外接口,会被绑定到内置属性 __doc__ 上。 |
| 3. 依赖导入区 | import mathfrom typing import List |
必须放在文件顶部,紧随模块注释之后。推荐按“标准库 → 第三方库 → 本地项目模块”的顺序分三组排列,组间空行。 |
| 4. 全局常量与变量 | DEFAULT_PRECISION = 4__all__ = ["calc_circle"] |
模块作用域的配置参数,名称全大写以区分普通变量。__all__ 用于显式约束 from module import * 导入的符号。 |
| 5. 核心逻辑实现区 | class Geometry: ...def calc_circle(...): ... |
代码的主体部分,包含业务类定义与纯函数实现,函数间保留两个空行(模块级)或一个空行(类内方法)。 |
| 6. 主程序入口保护区 | if __name__ == "__main__": main() |
环境守卫语句。确保包含在此代码块内的自测脚本或启动逻辑,仅在独立运行时触发,被其他文件导入时自动忽略。 |
三、核心语法块详解与标准代码范例
为了让上述结构在脑海中变得具象化,我们通过一个完整的、可直接运行的几何工具模块 circle_metrics.py 来进行逐行剖析:
#!/usr/bin/env python3
# -*- coding: utf-8 -*-

"""
圆形计算工具模块 (circle_metrics.py)

提供基于给定半径计算圆形周长、面积的标准化函数。
支持直接作为命令行工具运行,也支持被外部模块安全导入复用。
"""

# ==========================================
# 1. 依赖导入区 (Imports)
# ==========================================
import math
import sys
from typing import Dict, Union

# ==========================================
# 2. 全局常量与公开接口声明
# ==========================================
DEFAULT_PRECISION: int = 4
MAX_VALID_RADIUS: float = 100000.0

__all__ = ["calculate_circle_metrics", "DEFAULT_PRECISION"]

# ==========================================
# 3. 核心业务函数实现区
# ==========================================
def calculate_circle_metrics(radius: float, precision: int = DEFAULT_PRECISION) -> Dict[str, float]:
    """
    计算圆形的周长与面积。

    参数:
        radius (float): 圆的半径,必须为非负数且小于等于 MAX_VALID_RADIUS
        precision (int): 结果保留的小数位数,默认值为 DEFAULT_PRECISION

    返回:
        Dict[str, float]: 包含 'perimeter'(周长) 和 'area'(面积) 的字典
    """
    if radius < 0:
        raise ValueError(f"半径不能为负数,当前输入: {radius}")
    if radius > MAX_VALID_RADIUS:
        raise ValueError(f"半径超过安全计算阈值 {MAX_VALID_RADIUS}")

    perimeter = 2 * math.pi * radius
    area = math.pi * (radius ** 2)

    return {
        "radius": radius,
        "perimeter": round(perimeter, precision),
        "area": round(area, precision)
    }

# ==========================================
# 4. 主程序入口守卫 (Entry Guard)
# ==========================================
if __name__ == "__main__":
    # 仅在此文件作为独立主脚本运行时执行
    print("--- [circle_metrics] 独立脚本运行测试 ---")
    test_radius = 5.0
    result = calculate_circle_metrics(test_radius)
    print(f"半径: {result['radius']}")
    print(f"周长: {result['perimeter']}")
    print(f"面积: {result['area']}")
    print("------------------------------------------")
深度剖析:为什么必须理解 if __name__ == '__main__':?
很多新手初写Python时,最困惑的就是为什么要在文件结尾加上 if __name__ == '__main__':,直接写 print() 不行吗?
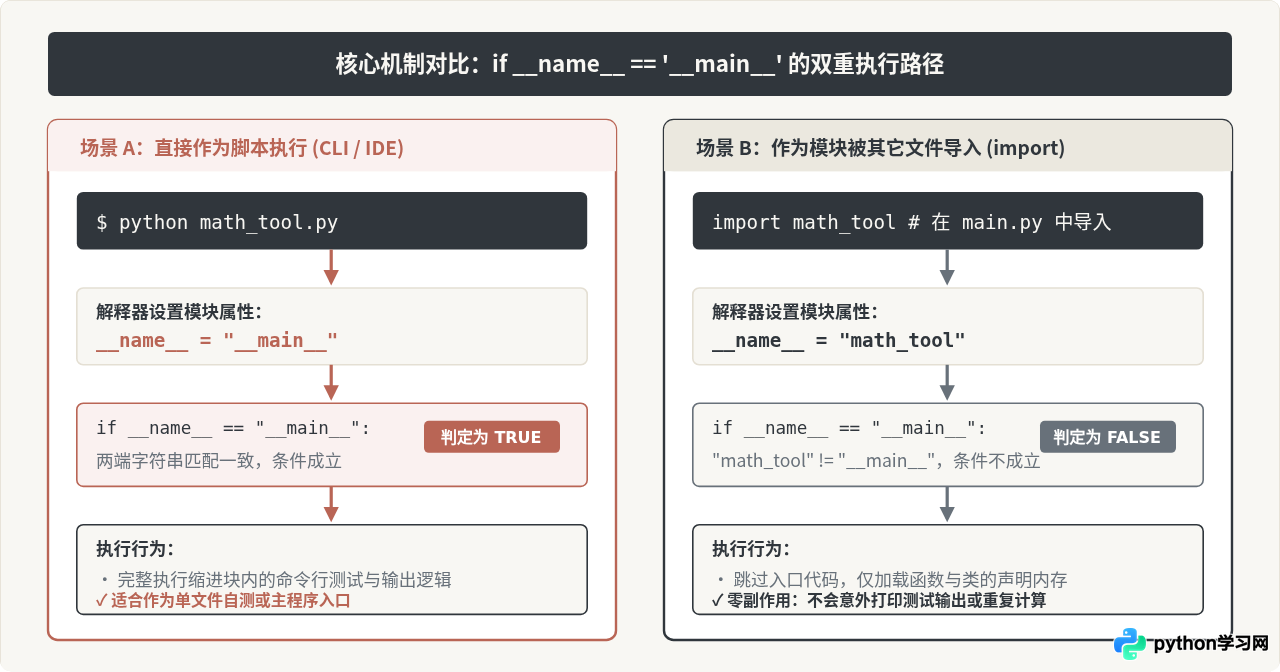
这个语句的精髓在于解决“单文件测试”与“模块化复用”的冲突。在Python中,每一个 .py 文件都有一个由解释器自动注入的内置隐藏变量 __name__。它的取值完全取决于这个文件是如何被加载的:
- 模式 1:文件被作为主程序直接执行。
例如你在终端输入python circle_metrics.py。此时,Python解释器会把该文件的__name__变量强制赋值为字符串"__main__"。因此if __name__ == "__main__":条件成立,后面的测试打印会被顺利执行。 - 模式 2:文件作为模块被其他文件
import导入。
例如你在另一个文件main.py中写了import circle_metrics。此时,Python解释器加载该文件时,会把该文件的__name__变量赋值为该模块的实际名字(即"circle_metrics")。因此"circle_metrics" == "__main__"判定为 False,条件不成立!入口保护块内的代码被瞬间跳过。
如果你把测试代码直接写在文件最外层(不加 if __name__ == '__main__':),那么每当别人在其他代码里 import circle_metrics 想要使用你的函数时,你的测试打印就会在别人的控制台上无缘无故地输出出来;更严重的是,如果你的测试代码里包含了网络请求或删除文件的操作,导入动作就会立即触发这些破坏性副作用!
四、源文件创建、保存与终端运行全流程
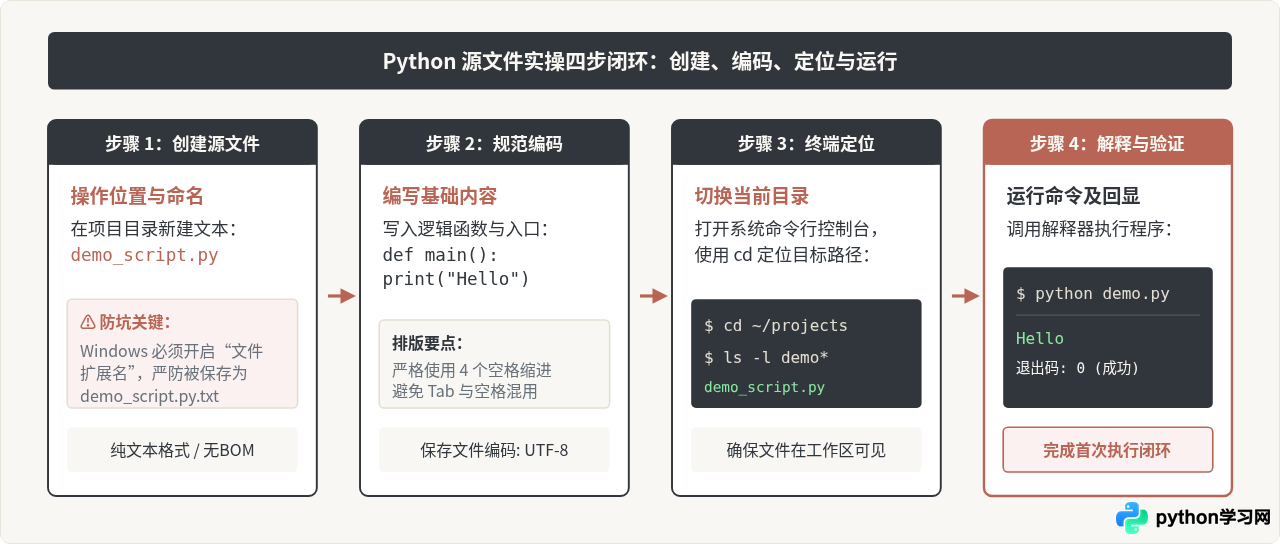
掌握了结构之后,如何从零开始操作并验证一个 .py 文件?以下是经过工程检验的标准4步实操流程:
第 1 步:创建与保存源文件
在你的项目文件夹中新建一个文本文件,将其重命名为 app.py。在 Windows 系统中,请务必先在文件资源管理器中勾选“查看 → 文件扩展名”,确保文件名是真实的 app.py,而不是被隐藏了后缀的 app.py.txt。
第 2 步:书写基础业务逻辑并保存为 UTF-8 编码
用编辑器打开 app.py,录入如下基础验证代码,并确认编辑器右下角显示的字符编码为 UTF-8(不要选择 UTF-8 with BOM 或 ANSI 编码):
# app.py
def greet(name: str) -> str:
    return f"你好,{name}!欢迎使用 Python 源文件。"

if __name__ == "__main__":
    message = greet("开发者")
    print(message)
第 3 步:打开终端并定位到源文件所在目录
运行 Python 脚本前,必须让终端的“当前工作目录”(Current Working Directory)指向该文件所在的文件夹。在 macOS/Linux 终端或 Windows PowerShell 中执行 cd 命令:
$ ls -la app.py
-rw-r--r-- 1 user staff 224 Nov 1 04:30 app.py
第 4 步:调用 Python 解释器执行并验证输出
在当前目录下直接输入 python app.py(在部分 Linux/macOS 环境下为 python3 app.py),观察控制台返回的标准输出:
你好,开发者!欢迎使用 Python 源文件。
$ echo $?
0
终端成功输出了欢迎语,且命令退出状态码为 0(在 Unix 哲学中代表程序无错误、正常退出),证明整个源文件的创建与执行顺利闭环。
五、编写 .py 文件时的常见问题与避坑指南
在日常开发中,很多看似诡异的报错,追根溯源都是源文件层面的低级不规范导致的。以下列出四类最容易踩坑的问题及排查方式:
1. 致命同名屏蔽(Shadowing Standard Library)
典型表现: 刚写完一个简单的绘图脚本 random.py,一运行 import random 立即抛出 AttributeError: partially initialized module 'random' has no attribute 'randint'。
底层原因: Python解释器在执行 import 寻找模块时,优先检索当前脚本所在目录。当你的文件叫 random.py 时,它把自己当成了标准库导入,导致真正的标准库 random 被彻底屏蔽遮盖。
解决依据: 坚决杜绝用标准库模块(如 string.py, test.py, turtle.py, email.py)作为自己的文件名。
2. Tab 与空格混用引发的 IndentationError
典型表现: 视觉上看几行代码完全是对齐的,但解释器运行直接报错:IndentationError: unindent does not match any outer indentation level。
底层原因: Python 3 严格禁止在同一个源文件内混用制表符(Tab)和空格(Spaces)。由于不同编辑器对 Tab 宽度的渲染差异(有的展示为2空格,有的为4或8空格),肉眼对齐但实际底层ASCII编码完全不同。
解决依据: 在代码编辑器设置中开启“将制表符转换为空格(Tab to Spaces)”,并设置缩进宽度为标准的 4 个空格。
3. 顶级裸露逻辑引发的“循环导入”死锁
典型表现: 两个模块互相关联 import a; import b 时,抛出 ImportError: cannot import name ... from partially initialized module。
底层原因: 如果在 a.py 和 b.py 的文件顶层都直接裸露了实例化对象或执行函数,导入过程中双方都需要对方先初始化完成,导致相互阻塞。
解决依据: 遵循“定义先行,执行在后”的原则。顶层只保留类、函数和静态常量的定义,具体的动态执行动作放入函数内部或入口保护区。
六、总结与源文件编写规范全景矩阵
回顾全文,Python源文件并不神秘,但它是一套极其严谨的工程语法规范的物理载体。无论是单行脚本还是包含数万行的大型工程模块,优秀的代码都建立在坚实清晰的文件结构基础之上。
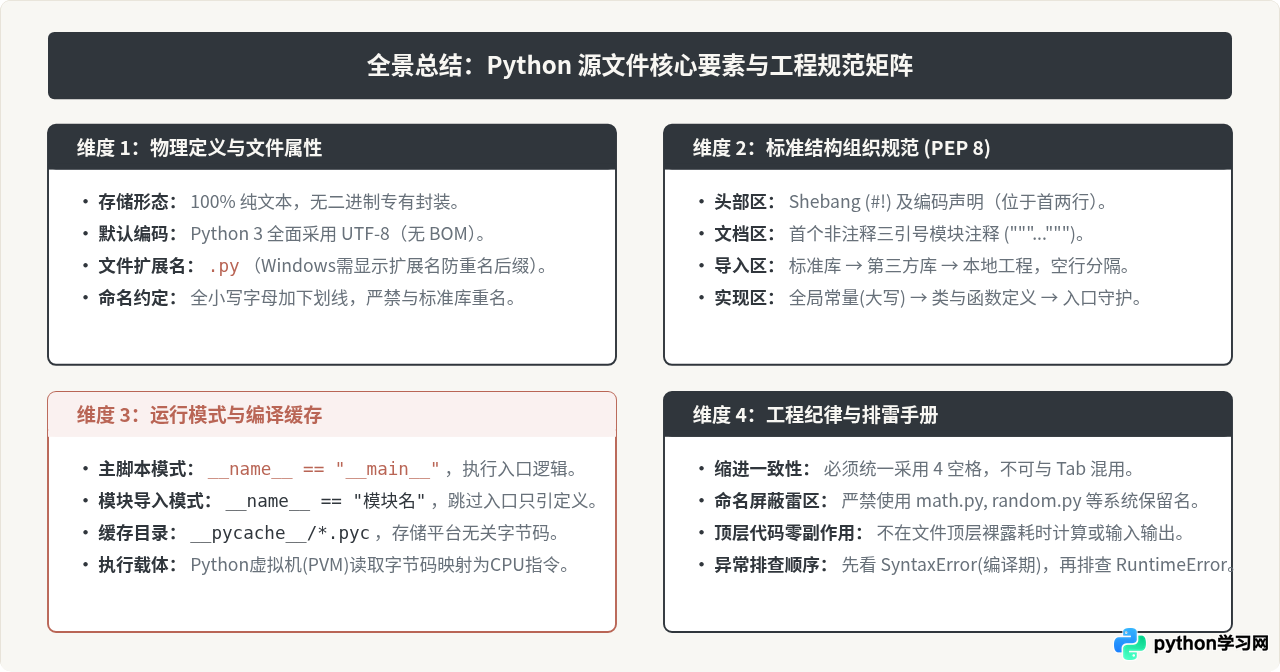
在今后的开发中,只要牢记以下四项基本纪律,你的 .py 文件就能始终保持健壮、优雅与高复用性:
- 物理规范: 坚持 UTF-8 编码、规范小写下划线命名、避免同名遮蔽。
- 逻辑分区: 严格遵循 PEP 8 顺序(声明 → 文档 → 依赖 → 常量 → 函数 → 入口)。
- 入口自律: 善用
if __name__ == '__main__':,杜绝顶层副作用,让每个模块既能独立测试,又能安全被工程导入。 - 排错思维: 遇到问题先区分是编译阶段的语法缩进错误,还是运行阶段的属性或导入异常,快速定位根因。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









