

Python星号表达式(*)在序列解包中的高级用法详解
深入解析Python中星号表达式(*)在序列解包中的高级用法与运行机制。涵盖PEP 3132扩展解包原理、首尾锚定模式、嵌套结构解析、流式数据管道处理及常见陷阱与性能优化。
一、星号解包的核心机制与底层运作模型
在 Python 2 中,序列解包要求赋值目标变量的数量与右侧序列的长度完全一致。如果右侧序列有五个元素,左侧就必须声明五个独立变量,一旦长度动态变化,代码就会抛出 ValueError。传统的变通方案是借助索引切片(如 head = seq[0], tail = seq[1:]),但这要求序列必须支持随机索引,并且代码冗长易错。
PEP 3132 引入的扩展可迭代解包(Extended Iterable Unpacking)将星号表达式从单纯的函数实参/形参打包解包,推广到了赋值语句(Assignment Target)中。在解包上下文中,星号表达式扮演着“贪婪聚合容器”的角色。
# 对集合(无法切片的对象)进行星号解包
tags = {"python", "backend", "concurrency", "performance"}
primary, *secondary = tags

print("primary 变量值:", primary)
print("primary 数据类型:", type(primary))
print("secondary 变量值:", secondary)
print("secondary 数据类型:", type(secondary))
从上述输出可以发现星号解包的核心行为:无论右侧序列原本是元组、集合、字符串还是生成器,被星号表达式捕获的变量在赋值完成后始终是原生列表(list)。这种类型收敛保证了解构产物具备可追加、可变长及标准序列的所有通用方法。
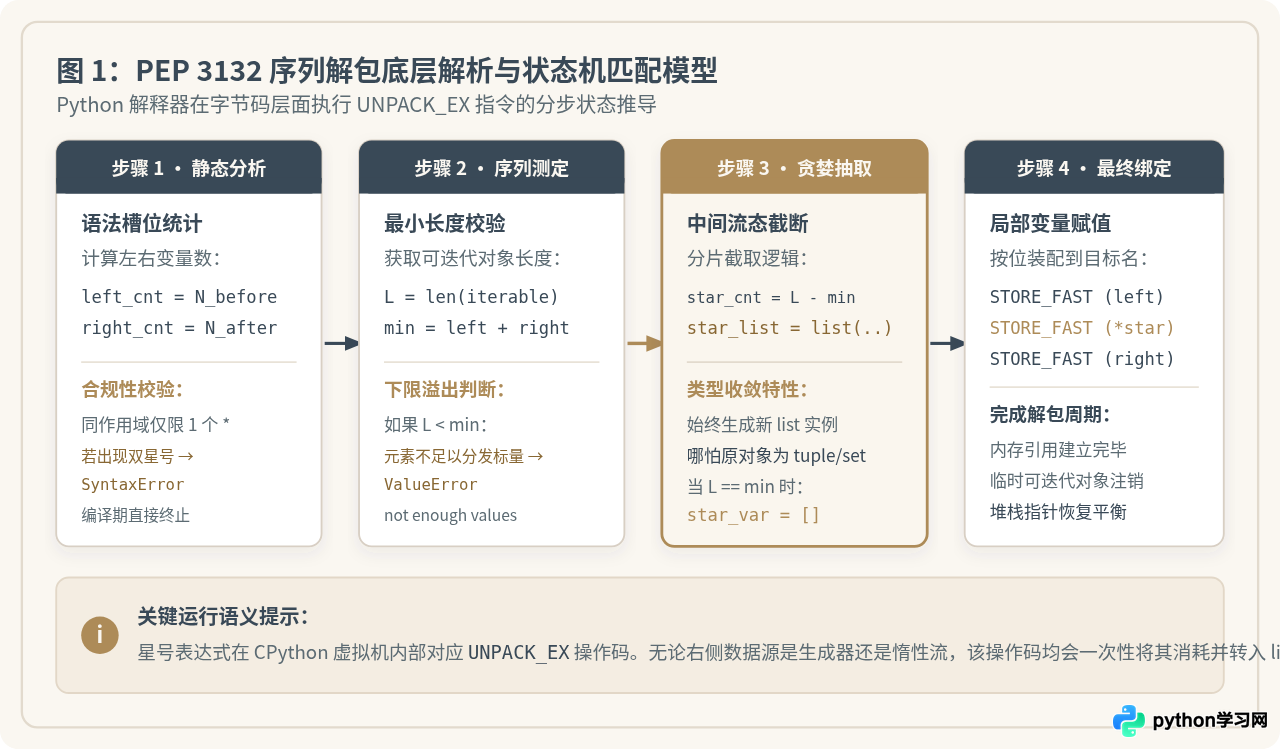
UNPACK_EX 操作码校验序列长度下限(步骤 2);随后从序列中切分中间流并构造为 list 实例(步骤 3);最终将变量引用绑定至局部变量栈(步骤 4)。
当右侧可迭代对象的长度恰好等于非星号变量的总和时,星号表达式不会报错,而是安全地被赋为空列表 []。这一设计避免了额外的 if len(...) 条件分支,赋予了代码极高的弹性。
# 序列长度刚好等于非星号标量数(2 个)
header, *payload, status = ["TITLE", 200]

print("header:", header)
print("payload:", payload)
print("status:", status)二、典型解包拓扑与结构化提取范式
在实际工程开发中,根据星号在目标解构列表中的不同位置,可以将其划分为四种经典拓扑结构。每种结构对应特定场景下的数据提取需求。
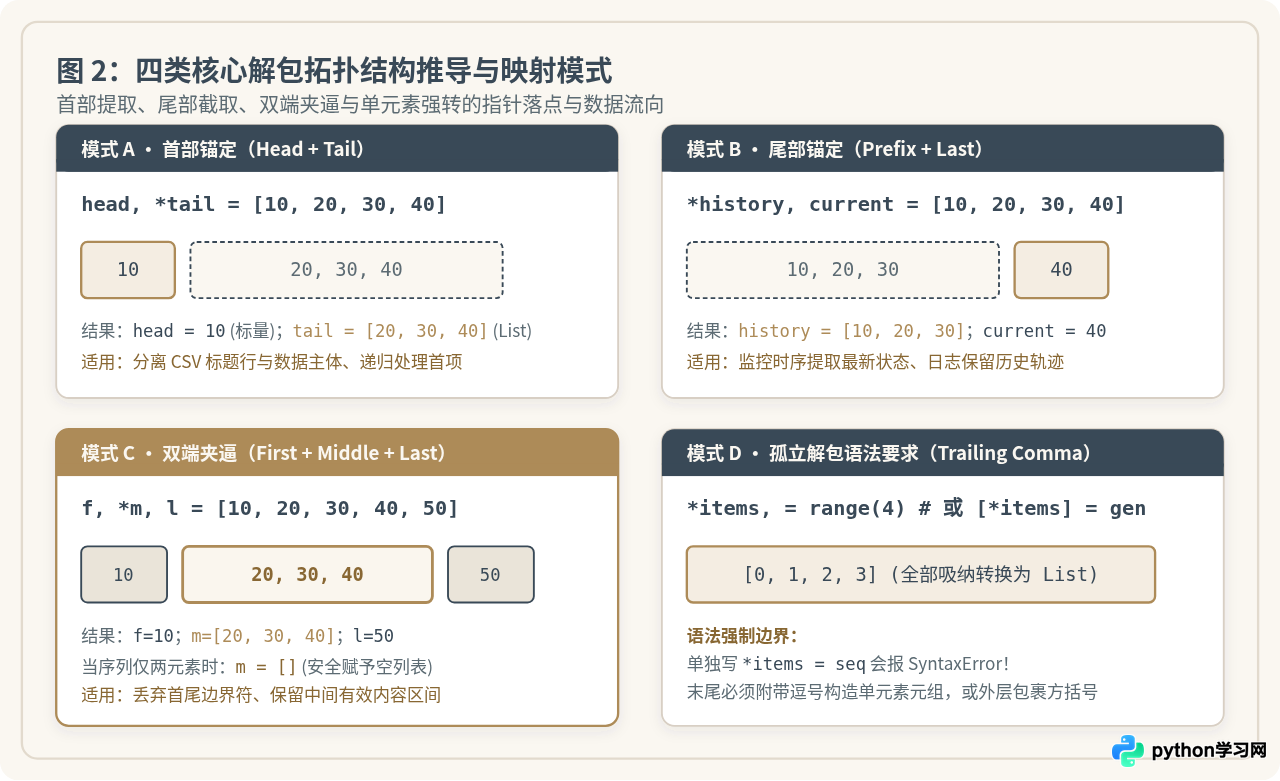
1. 首部锚定(Head + Tail 范式)
星号位于右侧末位(如 head, *tail = sequence)。这种模式适用于提取序列的起始项,将其余项作为后续处理队列。例如在解析命令行命令、处理递归树或分离协议指令时极为常用。
command_tokens = ["CONNECT", "192.168.1.100", "8080", "SSL=TRUE"]
command, *args = command_tokens

print("解析动作指令:", command)
print("附加配置参数:", args)2. 尾部锚定(Prefix + Last 范式)
星号位于起始位置(如 *prefix, last = sequence)。当需要监控系统中的最新状态、保留滑动历史窗口或读取追加日志中的末尾签名时,尾部锚定无需计算负索引 [-1] 即可完成解构。
metrics_stream = [42.1, 43.5, 41.8, 44.2, 45.0]
*historical_data, current_metric = metrics_stream

print("历史均值基线:", sum(historical_data) / len(historical_data))
print("最新告警判定值:", current_metric)3. 双端夹逼(First + Middle + Last 范式)
星号位于中间(如 first, *middle, last = sequence)。这在数据清洗中极其高效,例如消除字符串或文件流中的起始标志行与终止标志行,仅保留中间的主体有效负载。
raw_packet = ["<START>", "0x1A", "0x2F", "0x3C", "0x4E", "<END>"]
start_flag, *body_payload, end_flag = raw_packet

print("校验起始标记:", start_flag)
print("提取有效数据段:", body_payload)
print("校验结束标记:", end_flag)4. 孤立解包语法要求(Trailing Comma 规则)
有时候开发者希望将一个任意可迭代对象(如生成器、filter 结果或 map 映射)全部吸纳并转化为列表。如果直接写 *items = generator,Python 编译器会抛出 SyntaxError: starred assignment target must be in a list or tuple。
根据 PEP 3132 规范,星号赋值目标必须显式属于元组或列表结构。因此必须使用末尾逗号 *items, = generator,或者在外层加上中括号 [*items] = generator。
# 错误写法:*items = range(5) -> SyntaxError
# 正确写法 1:添加尾随逗号构造解包元组
*items_a, = range(5)

# 正确写法 2:外层显式包裹列表
[*items_b] = (x ** 2 for x in range(5))

print("写法 1 结果:", items_a)
print("写法 2 结果:", items_b)三、进阶实战:嵌套解包与流式数据处理
序列解包的强大之处在于它的递归可组合性。在处理复杂、多层嵌套或者批量流式数据时,星号表达式能够与小括号/方括号结合,以声明式的方式精准剥离层级嵌套。
1. 多层嵌套解包中的独立星号作用域
虽然在同一解包层级中不能出现两个星号,但在不同的嵌套层级(括号内与括号外)中,各层级拥有独立的作用域,彼此互不干扰。
# 模拟复杂的网络连接与路由日志
record = (
    "REQ_9041",
    ("IPv4", "192.168.1.10", "10.0.0.1", "172.16.0.254"),
    200,
    "OK"
)

# 外部层级与内部子元组各使用一个 *
req_id, (proto, *hops), *status_info = record

print("请求 ID:", req_id)
print("传输协议:", proto)
print("中继节点路由跳点:", hops)
print("响应状态元数据:", status_info)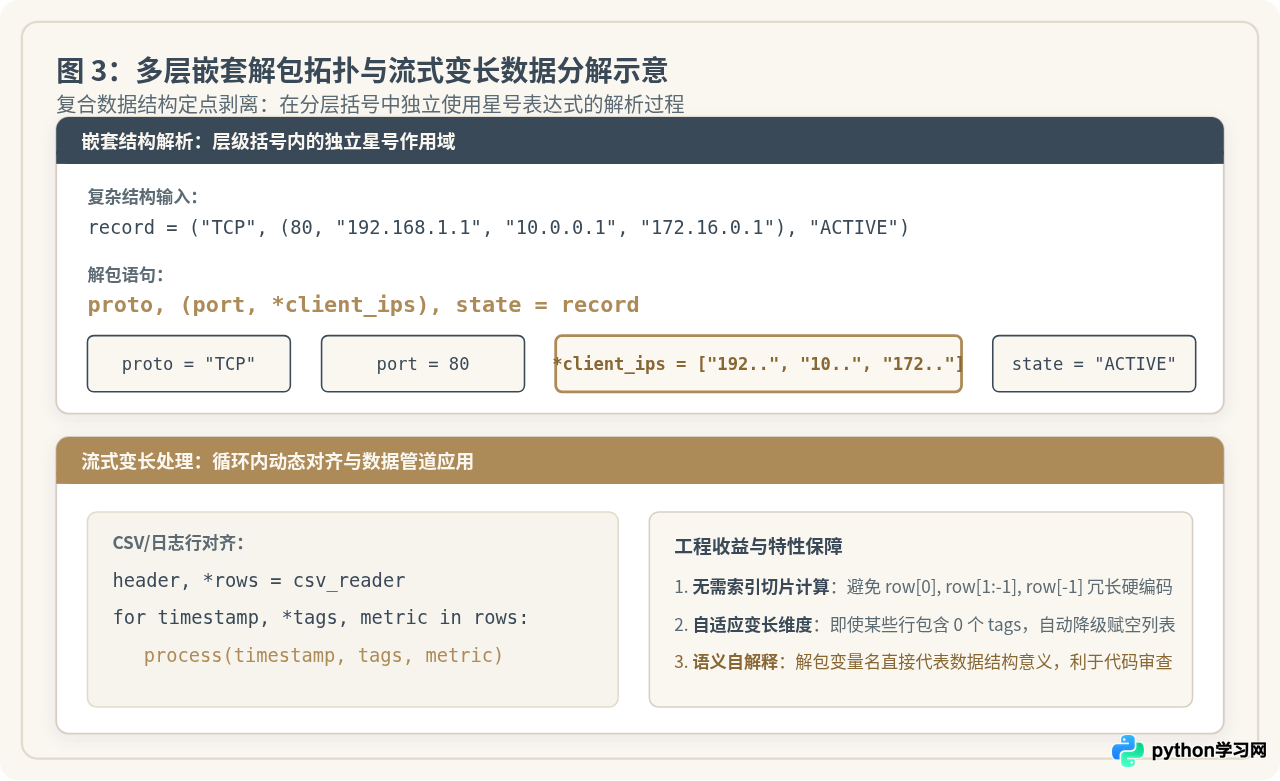
2. 循环体内的动态变长解包
在迭代复杂数据集合时,直接在 for 循环头部使用星号解包,能够一次性完成字段拆解,无需在循环体内编写难以维护的 row[0] 或切片逻辑。
# 模拟不同学生拥有不同数量的选修课成绩
gradebook = [
    ("Alice", 95, 88, 92, "A"),
    ("Bob", 78, "C"),
    ("Charlie", 85, 90, 88, 91, 87, "A-")
]

for name, *scores, final_grade in gradebook:
    avg = sum(scores) / len(scores) if scores else 0.0
print(f"学生: {name:<8} 选修课门数: {len(scores)} 均分: {avg:5.1f} 等级: {final_grade}")3. CSV 与数据集表头分离
在处理表格文件或外部数据库游标时,首行通常为列名(Header),后续行为具体数据。借助 head, *body 模式,可以瞬间完成元数据与记录主体的清晰分离。
raw_csv_rows = [
    ["user_id", "user_name", "role", "region"],
    ["1001", "dev_ops", "admin", "us-east"],
    ["1002", "tester_a", "qa", "eu-west"],
    ["1003", "guest_01", "viewer", "ap-south"]
]

# 一行代码优雅分离表头与实体行
header, *data_rows = raw_csv_rows

# 构建列名映射字典
dict_records = [dict(zip(header, row)) for row in data_rows]
print("第一条结构化字典数据:", dict_records[0])四、语法约束、性能边界与异常排查指南
星号解包虽然灵活优雅,但在编译期规则、内存开销与运行机制上有着明确的限制。忽视这些边界条件容易引发致命的语法错误或严重的生产内存故障。
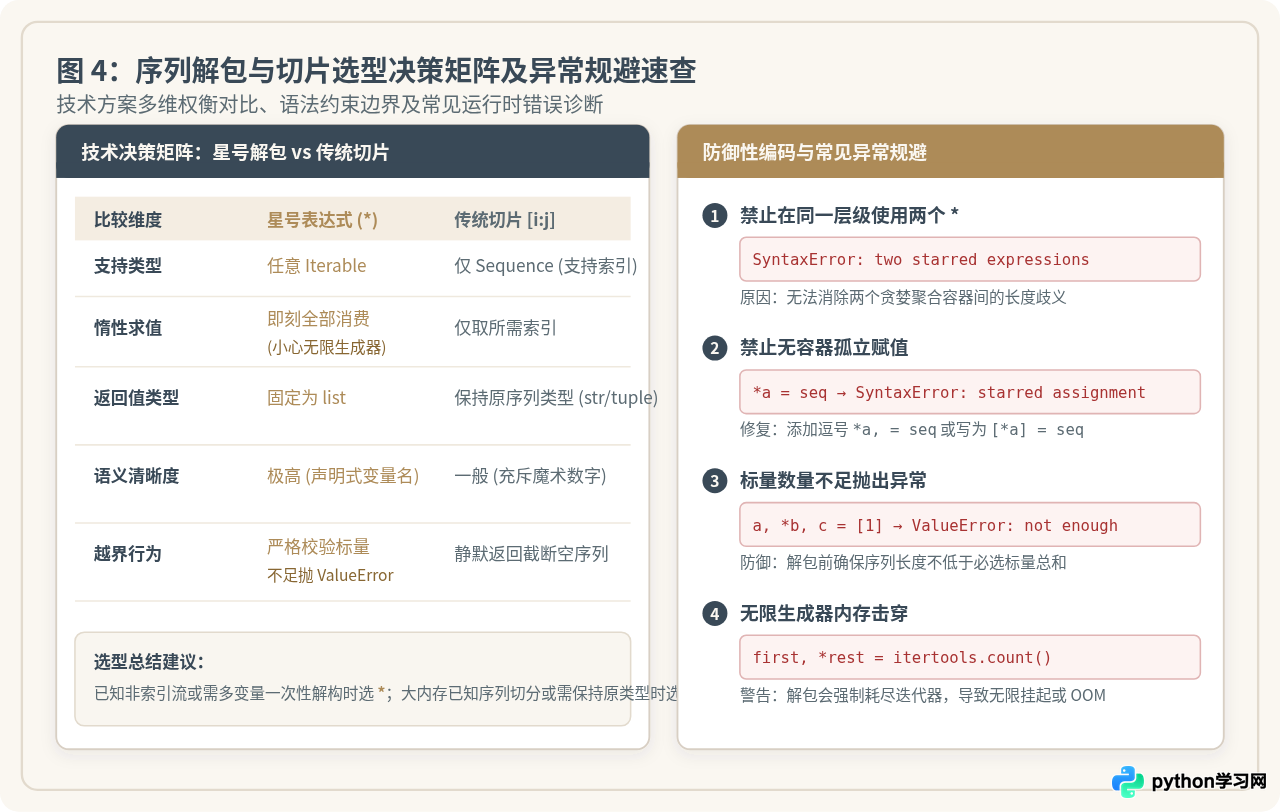
1. 同一层级禁止多个星号表达式(SyntaxError)
Python 编译器要求在同一个解包赋值层级中,至多只能存在一个星号表达式。如果允许出现两个变长容器,解释器在数学上将面临无法确定的不适定问题(即两容器各自应分配多少项),因此在语法解析阶段便会拦截并抛出错误。
# 触发 SyntaxError: two starred expressions in assignment
# *prefix, *suffix = [1, 2, 3, 4]  <-- 非法代码,无法编译通过
2. 标量数量不足引发 ValueError
星号表达式可以容纳 0 个元素,但序列长度必须至少满足所有非星号标量变量的硬性需求。当序列总长度小于非星号变量个数时,解释器将立即抛出 ValueError: not enough values to unpack。
try:
    # 期望 2 个非星号标量 (first 和 last),但输入仅有 1 个元素
    first, *middle, last = ["single_element"]
except ValueError as e:
    print("捕获预期异常:", repr(e))
在对不可信或外部动态输入执行形如 a, *b, c = data 的解包前,必须确保 len(data) >= 2;若 data 为单向迭代器,应使用安全包裹函数先取出前缀元素,避免程序崩溃。
3. 内存与无限生成器陷阱
星号解包具有即刻且贪婪的求值语义。这意味着它不是按需惰性读取的生成器,而是会通过循环穷尽所有后续元素并填充进一个全新的 list。
- 无限生成器死循环:对
itertools.count()执行first, *rest = count()会导致程序彻底卡死,直至内存耗尽崩溃(OOM)。 - 超大文件内存膨胀:如果尝试对一个包含数千万行记录的文件生成器执行
header, *lines = file_obj,整个文件的所有行都会被一次性读取并加载进内存列表中,完全丧失了流式读取的内存优势。
对于需要惰性消费或部分读取的流式数据,应当配合 itertools.islice 代替星号解包:
import itertools

# 模拟大容量或无限数据流
def infinite_event_stream():
    n = 1
    while True:
        yield f"event_{n}"
        n += 1

stream = infinite_event_stream()

# 推荐做法:安全提取首项与后续 3 项,避免全量贪婪消费
first_event = next(stream)
next_batch = list(itertools.islice(stream, 3))

print("流首位事件:", first_event)
print("有限批量缓冲:", next_batch)4. 技术选型:星号解包 vs 传统切片(Slicing)
为帮助开发者在实际架构中做出精准选择,下表梳理了两种提取手段的关键技术差异:
| 对比指标 | 星号表达式序列解包 (*) | 传统索引与切片 [i:j] |
|---|---|---|
| 类型兼容性 | 支持任意可迭代对象(集合、生成器、映射键等) | 仅支持具备索引协议的序列(Sequence,如 list/tuple/str) |
| 求值时机与消耗 | 立即且完全消费,对生成器单向不可逆 | 仅通过索引指针获取,不破坏原始数据源 |
| 结果数据类型 | 固定转换为 list |
与源类型保持一致(字符串切片仍为字符串) |
| 语义表达能力 | 声明式多变量对齐,自解释性强,无魔术数字 | 充斥 [0], [1:-1], [-1] 等偏移量硬编码 |
| 越界容错行为 | 对标量位严格检查,不足时抛出 ValueError |
切片操作自动容错截断,不会抛出越界异常 |
五、总结与核心用法速查
Python 的星号表达式(PEP 3132)为序列解构提供了声明式、自适应变长的现代语法支持。在日常编码与系统构建中,掌握其应用准则可以归纳为以下四点:
- 首尾提取首选解包:凡需同时提取首项、尾项或两端元素并聚合剩余内容时,优先使用
first, *middle, last = seq,提升代码可读性与健壮性。 - 牢记结果类型恒为列表:星号变量永远是一个独立的
list实例,若后续操作依赖元组的不变性或字符串的高性能拼接,需显式执行tuple()或"".join()转换。 - 警惕无限流的贪婪消费:遇到未知长度的生成器、管道流或大型文件时,切勿直接使用星号解包,必须借助
itertools.islice设定最大消费阈值。 - 单变量解包不可遗漏逗号:单独提取可迭代对象至单一列表时,必须采用
*items, = iterable或[*items] = iterable语法。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









