

Python怎么使用threading模块开启多线程
详细讲解Python threading模块的使用方法,包括Thread类创建线程、线程同步、守护线程等核心操作,配合完整代码示例帮助理解多线程编程。
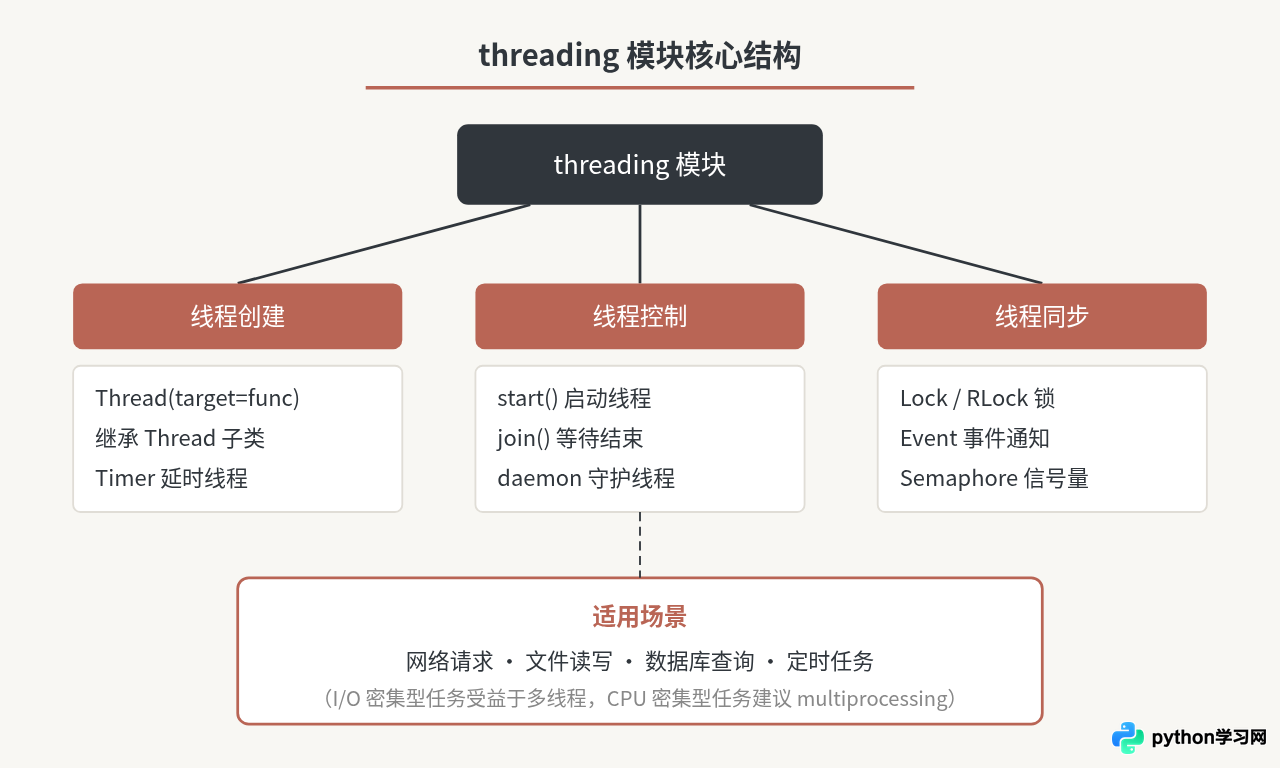
Python标准库中的threading模块提供了创建和管理线程的完整接口。使用它开启多线程的核心步骤是:用threading.Thread创建线程对象,指定目标函数或继承Thread类,然后调用start()启动线程。本文从基础用法到常见实践逐步展开,帮助你在实际项目中正确使用多线程。
threading模块的核心概念
Python的threading模块建立在底层_thread模块之上,封装了线程创建、同步、通信等操作。理解以下几个概念是使用多线程的前提:
- 主线程:Python程序启动时自动运行的线程,所有手动创建的线程都由主线程或其子线程发起。
- Thread对象:每个线程对应一个
threading.Thread实例,通过它控制线程的启动、等待和状态查询。 - GIL(全局解释器锁):CPython中同一时刻只有一个线程执行Python字节码。这意味着多线程对CPU密集型任务没有加速效果,但对I/O密集型任务(网络请求、文件读写、数据库查询)仍然有效,因为线程在等待I/O时会释放GIL。
明确这一点后再决定是否使用多线程:如果你的任务瓶颈在I/O等待,threading是合适的选择;如果瓶颈在计算,应该考虑multiprocessing或concurrent.futures.ProcessPoolExecutor。
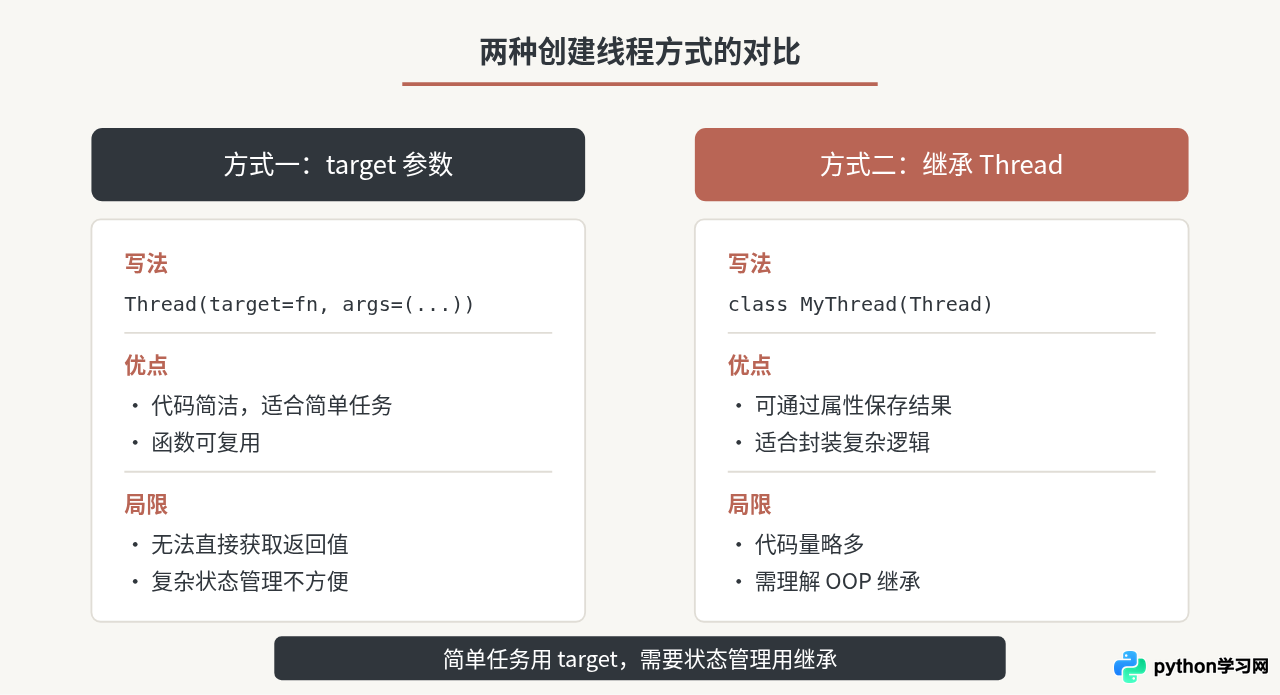
方式一:用target参数指定目标函数
最常用的方式是将要执行的函数通过target参数传给Thread,用args或kwargs传递参数:
import threading
import time

def download(filename, seconds):
    print(f"开始下载 {filename}")
    time.sleep(seconds)  # 模拟I/O等待
    print(f"{filename} 下载完成")

# 创建两个线程
t1 = threading.Thread(target=download, args=("data.csv", 2))
t2 = threading.Thread(target=download, args=("image.png", 3))

t1.start()  # 启动线程,不会阻塞主线程
t2.start()

t1.join()   # 等待t1执行完毕
t2.join()   # 等待t2执行完毕

print("全部下载完成")
运行后的输出示例:
开始下载 data.csv
开始下载 image.png
data.csv 下载完成
image.png 下载完成
全部下载完成
两个下载任务并行执行,总耗时约3秒而不是5秒。需要注意的几点:
target传的是函数对象本身,不要加括号。写成target=download("data.csv", 2)会在创建Thread时就执行函数,达不到多线程的效果。args是一个元组。只有一个参数时写成args=("data.csv",),别忘了逗号。start()调用后线程在后台运行,主线程继续往下执行。如果不调用join(),主线程不会等待子线程结束。
方式二:继承Thread类
当线程逻辑比较复杂,或者需要在线程对象上维护状态时,可以继承Thread类并重写run()方法:
import threading
import time

class Crawler(threading.Thread):
    def __init__(self, url):
        super().__init__()
        self.url = url
        self.result = None

    def run(self):
        print(f"正在抓取 {self.url}")
        time.sleep(1)  # 模拟网络请求
        self.result = f"{self.url} 的内容"
        print(f"{self.url} 抓取完成")

urls = ["https://example.com/1", "https://example.com/2", "https://example.com/3"]
threads = [Crawler(url) for url in urls]

for t in threads:
    t.start()

for t in threads:
    t.join()

for t in threads:
print(f"结果: {t.result}")这种方式的好处是可以通过实例属性self.result保存线程的执行结果,而target方式的函数返回值无法直接获取(需要借助队列等方式)。注意要重写的是run()方法,启动线程时调用的仍然是start()——直接调用run()只会在当前线程同步执行,不会创建新线程。
线程同步:使用Lock避免数据竞争
多个线程同时读写同一个变量时会出现竞态条件。看这个例子:
import threading

counter = 0

def add():
    global counter
    for _ in range(1000000):
        counter += 1

t1 = threading.Thread(target=add)
t2 = threading.Thread(target=add)
t1.start()
t2.start()
t1.join()
t2.join()

print(f"counter = {counter}")  # 结果几乎不会是2000000
counter += 1不是原子操作——它包含读取、加一、写回三步,两个线程可能同时读到相同的值再各自写回,导致更新丢失。解决方法是使用threading.Lock:
import threading

counter = 0
lock = threading.Lock()

def add():
    global counter
    for _ in range(1000000):
        lock.acquire()
        try:
            counter += 1
        finally:
            lock.release()

# 更推荐使用 with 语句自动管理锁
def add_v2():
    global counter
    for _ in range(1000000):
        with lock:
            counter += 1

t1 = threading.Thread(target=add_v2)
t2 = threading.Thread(target=add_v2)
t1.start()
t2.start()
t1.join()
t2.join()

print(f"counter = {counter}") # 结果一定是2000000使用with lock是推荐写法,它能确保无论代码块内是否发生异常,锁都会被释放,不会造成死锁。
threading.RLock(可重入锁),允许同一线程多次获取同一把锁。
守护线程与join的使用
将线程设置为守护线程(daemon thread)后,当所有非守护线程结束时,守护线程会被自动终止,不会阻止程序退出。这在后台日志、心跳检测等场景下很有用:
import threading
import time

def heartbeat():
    while True:
        print("♥ 心跳检测中...")
        time.sleep(2)

t = threading.Thread(target=heartbeat, daemon=True)
t.start()

# 主线程继续执行其他工作
time.sleep(5)
print("主线程结束,守护线程自动退出")设置守护线程有两种方式:在构造时传daemon=True,或者在start()之前设置t.daemon = True。
join(timeout)可以设置超时时间。比如t.join(timeout=5)最多等待5秒,超时后主线程继续执行。可以配合t.is_alive()检查线程是否仍在运行:
t.join(timeout=5)
if t.is_alive():
    print("线程仍在运行,超时退出")
else:
    print("线程已正常结束")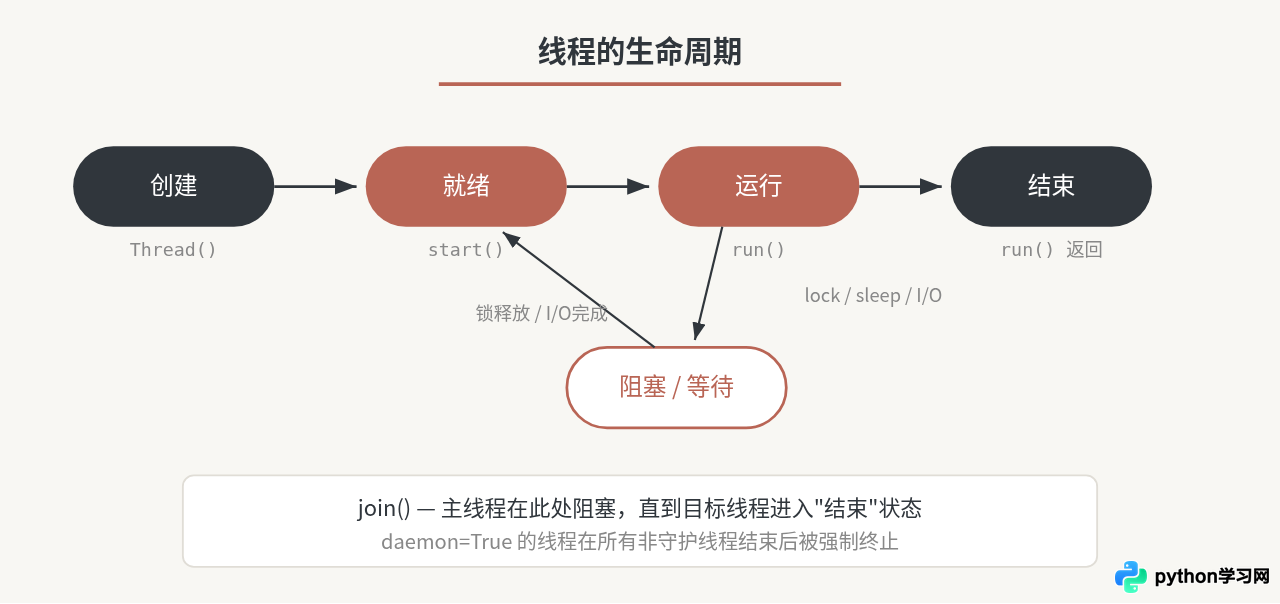
批量管理线程的实用写法
实际项目中通常要创建多个线程并统一管理。以下是一个批量抓取的完整示例,展示了线程列表、共享数据收集和超时控制:
import threading
import time
import random

results = []
lock = threading.Lock()

def fetch(url):
    delay = random.uniform(0.5, 2.0)
    time.sleep(delay)  # 模拟不同响应时间
    with lock:
        results.append({"url": url, "time": round(delay, 2)})

urls = [f"https://api.example.com/page/{i}" for i in range(10)]

threads = []
for url in urls:
    t = threading.Thread(target=fetch, args=(url,))
    threads.append(t)
    t.start()

for t in threads:
    t.join(timeout=3)

print(f"成功获取 {len(results)} 个结果")
for r in results:
print(f" {r['url']} - {r['time']}s")这里用lock保护results列表是因为list.append()虽然在CPython中碰巧是线程安全的(由于GIL),但依赖这种实现细节不是好习惯。显式加锁让代码的正确性不依赖于特定Python实现。
线程间通信:queue.Queue
线程间传递数据最安全的方式是使用标准库的queue.Queue,它本身就是线程安全的,不需要额外加锁:
import threading
import queue
import time

def producer(q, items):
    for item in items:
        time.sleep(0.3)
        q.put(item)
        print(f"生产: {item}")
    q.put(None)  # 发送结束信号

def consumer(q):
    while True:
        item = q.get()  # 阻塞等待
        if item is None:
            break
        print(f"消费: {item}")
        q.task_done()

q = queue.Queue(maxsize=5)  # 最多缓存5个

t1 = threading.Thread(target=producer, args=(q, ["A", "B", "C", "D"]))
t2 = threading.Thread(target=consumer, args=(q,))

t1.start()
t2.start()
t1.join()
t2.join()Queue的maxsize参数可以限制缓冲区大小。当队列满时,put()会阻塞生产者直到消费者取走数据,形成自然的流量控制。
常见错误与注意事项
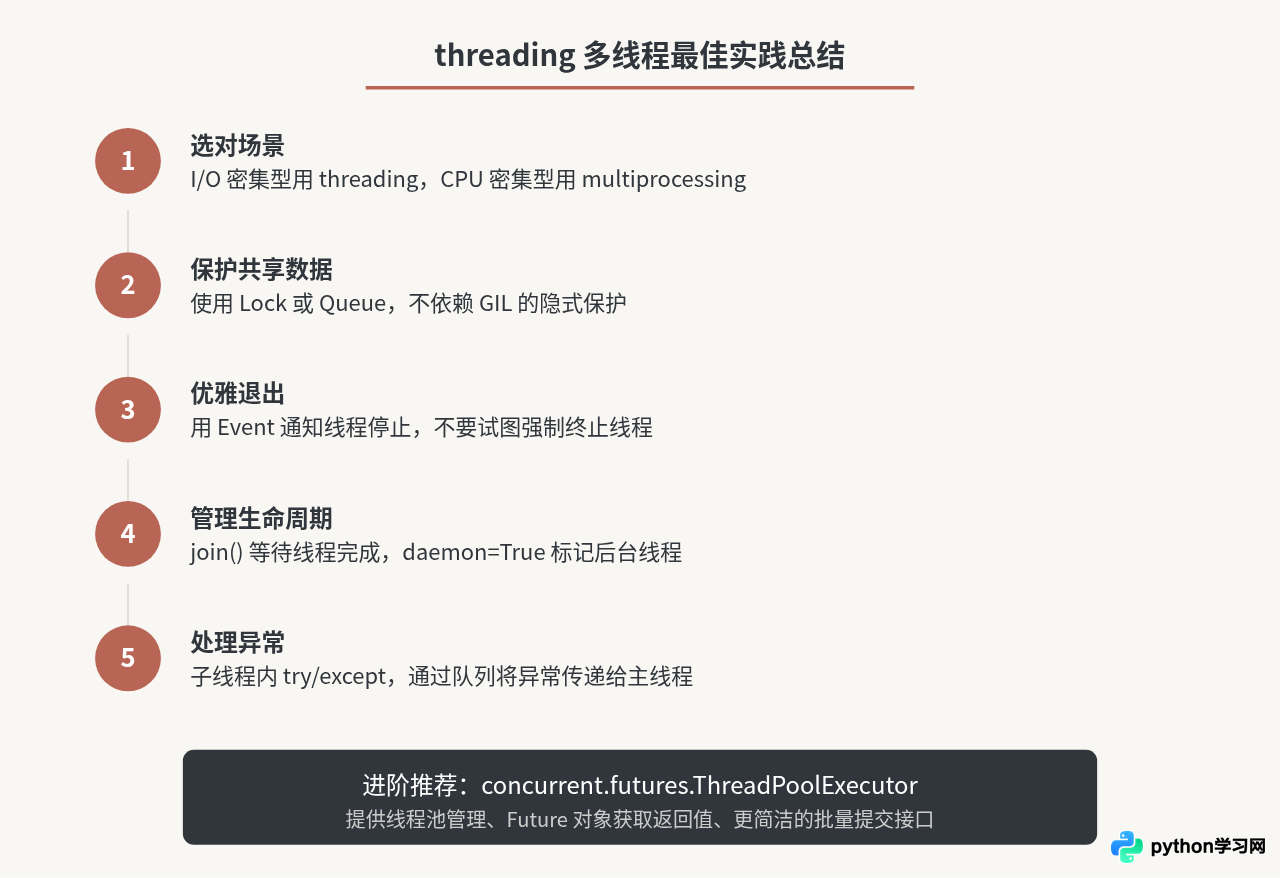
1. 线程不能被强制终止
Python没有提供安全终止线程的方法。threading模块不提供kill()或stop()方法。正确做法是使用标志变量或threading.Event让线程自行退出:
import threading
import time

stop_event = threading.Event()

def worker():
    while not stop_event.is_set():
        print("工作中...")
        stop_event.wait(timeout=1)  # 既能等待又能响应停止
    print("线程收到停止信号,退出")

t = threading.Thread(target=worker)
t.start()

time.sleep(3)
stop_event.set()  # 通知线程停止
t.join()
2. start()只能调用一次
同一个Thread对象调用两次start()会抛出RuntimeError。如果需要重复执行相同任务,每次都要创建新的Thread对象。
3. 线程中的异常不会传播到主线程
子线程里抛出的异常只会在该线程内打印traceback,不会让主线程崩溃或感知到错误。如果需要捕获子线程异常,可以在目标函数内用try/except捕获后通过队列或共享变量传递给主线程。
4. 不要在线程中使用全局变量做通信而不加锁
前面已经演示了竞态条件的例子。哪怕看起来是"只读"的操作,如果另一个线程在修改数据结构,也可能读到不一致的中间状态。
进阶:使用ThreadPoolExecutor简化管理
Python 3.2起,concurrent.futures模块提供了更高层的ThreadPoolExecutor,内部基于threading实现,但封装了线程池管理、任务提交和结果获取:
from concurrent.futures import ThreadPoolExecutor, as_completed
import time

def fetch(url):
    time.sleep(1)
    return f"{url} 的响应数据"

urls = [f"https://api.example.com/{i}" for i in range(5)]

with ThreadPoolExecutor(max_workers=3) as executor:
    future_map = {executor.submit(fetch, url): url for url in urls}
    for future in as_completed(future_map):
        url = future_map[future]
        try:
            result = future.result()
            print(f"{url}: {result}")
        except Exception as e:
print(f"{url} 出错: {e}")对于大多数实际项目,ThreadPoolExecutor是比直接使用threading.Thread更推荐的选择:它自动管理线程数量、复用线程、通过Future对象直接获取返回值和异常。直接使用threading模块更适合需要精细控制线程行为的场景,例如守护线程、自定义线程子类或复杂的同步逻辑。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









