

Python和Java的核心区别:语法、性能与应用场景深度对比
深入对比Python与Java在类型系统、语法表达、执行引擎、并发模型及工业生产场景下的本质差异,提供严谨的技术选型依据与架构落地指南。
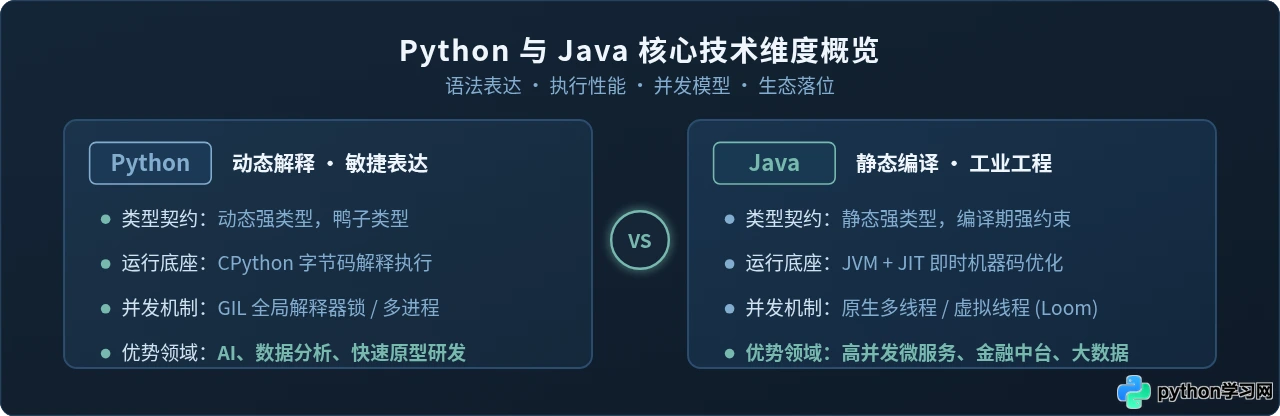
一、语法与类型系统:动态敏捷与静态契约的本质分野
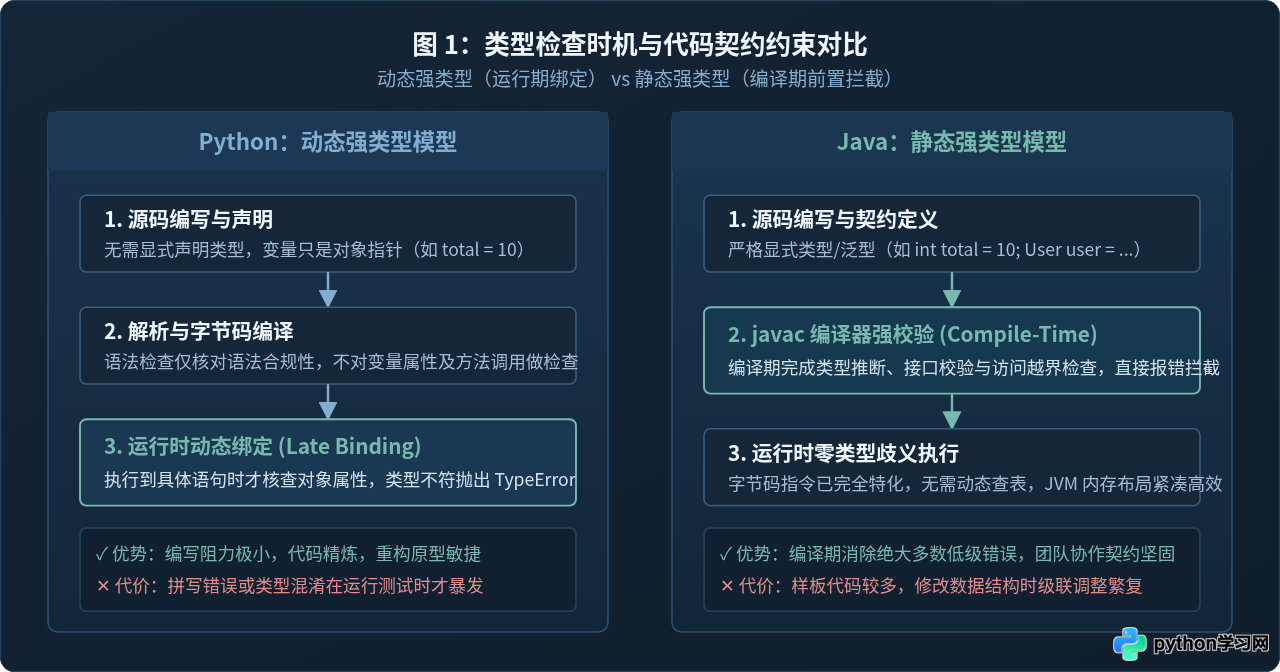
Python 与 Java 最直观的差异在于类型的确定时机与代码书写习惯。Python 采用动态强类型,而 Java 则是典型的静态强类型语言。
所谓“动态”,意味着变量本身没有固定的类型限制,变量名仅仅是对内存中对象的引用。在 Python 中声明 x = 100,之后随时可以执行 x = "text"。所谓“强类型”,意味着类型之间不会隐式随意转换,1 + "2" 在两种语言中都会报错,不会像弱类型语言那样静默转换。
Java 的“静态”要求每个变量、参数和返回值在编译期必须具备精确的类型定义。编译器在生成字节码之前,会严格核对每一次方法调用是否存在、参数类型是否匹配、访问权限是否越界。
代码表达密度对比:提取 JSON 中符合条件的用户名称
为了具体观察语法哲学差异,我们来看一个实际开发中极为常见的操作:解析一组用户数据列表,过滤出年龄大于 18 岁且状态为激活(active)的用户姓名列表。
Python 实现:
# Python 3.10+
users = [
    {"id": 1, "name": "Alice", "age": 24, "active": True},
    {"id": 2, "name": "Bob", "age": 17, "active": True},
    {"id": 3, "name": "Charlie", "age": 30, "active": False}
]

# 单行列表推导式完成过滤与投影
matched_names = [u["name"] for u in users if u["age"] > 18 and u["active"]]
# 示例输出: ['Alice']
Java 实现:
// Java 17+
import java.util.List;
import java.util.stream.Collectors;

public class UserFilter {
    // 定义具备强类型契约的数据记录类
    public record User(int id, String name, int age, boolean active) {}

    public static List<String> filterActiveAdults(List<User> users) {
        return users.stream()
                .filter(u -> u.age() > 18 && u.active())
                .map(User::name)
                .collect(Collectors.toList());
    }
}
从代码量来看,Python 的实现直接利落,省去了类定义和类型声明;而在 Java 中,即便使用了 Java 16+ 简化的 record 和 Stream API,依然需要清晰定义数据模型与操作管线。
AttributeError 或拼写错误。
二、运行机制与性能:CPython 解释循环与 JVM JIT 优化
在性能讨论中,往往存在“Python 很慢,Java 很快”的泛化认知。要准确理解这一差距的边界,必须深入两种语言的底层执行机制。
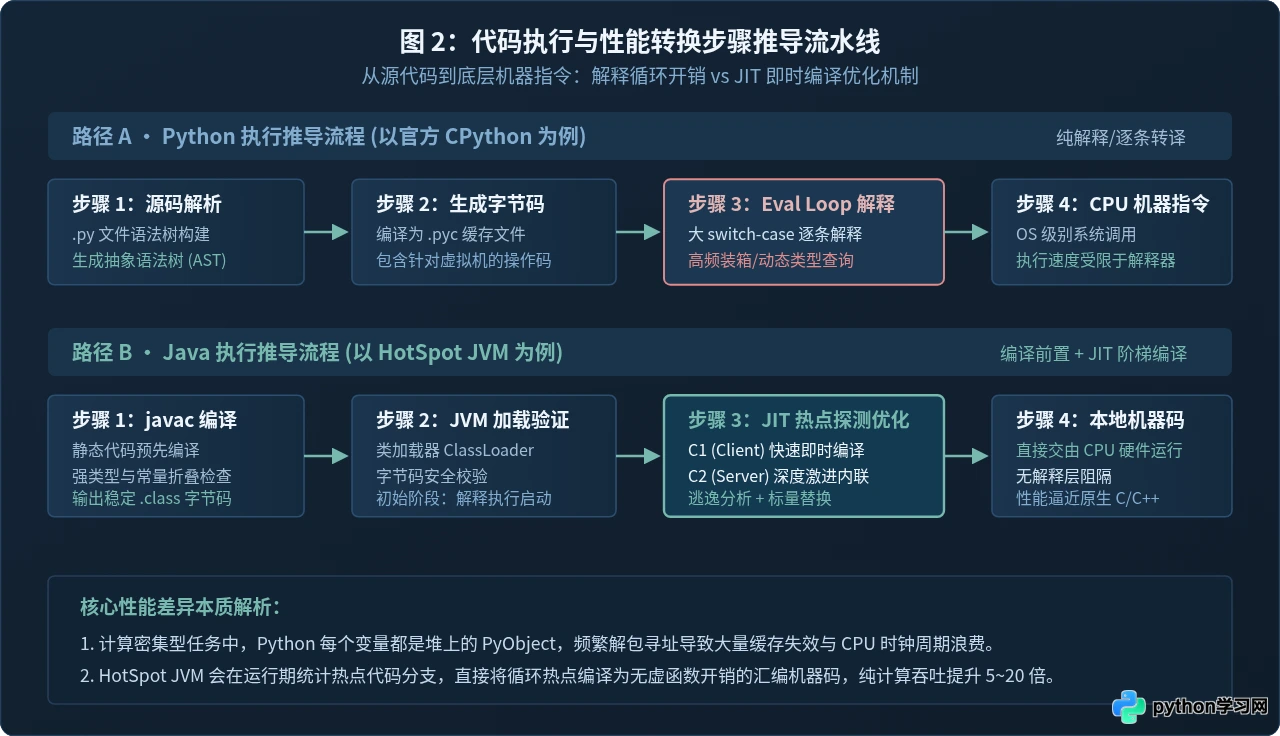
官方标准 Python(CPython)是一个纯解释型虚拟机架构。虽然 .py 源码在执行时也会被编译成 .pyc 字节码,但 CPython 的虚拟机本质上是一个庞大的 for-switch 循环(即 _PyEval_EvalFrameDefault 函数),逐条读取字节码操作码(opcode),并在运行时做动态分发。
而在 Java 平台(以主流 HotSpot JVM 为例),虽然 javac 生成的也是中间表示 .class 字节码,但 JVM 拥有成熟的分层 JIT(Just-In-Time,即时编译)编译器。
性能差距的核心推导步骤:
- 热点探测与本地汇编生成:JVM 在运行初期使用解释器执行字节码,同时内置性能计数器。当某个方法或循环体的调用频次超过设定阈值(Hot Spot),Tier 1 (C1) 与 Tier 2 (C2) 编译器会介入,将字节码直接编译为针对宿主机 CPU 架构深度优化的裸机汇编指令。
- 激进方法内联(Inlining):Java JIT 能够将高频调用的小函数体直接展开到调用点,彻底消除函数调用的调用栈压栈与跳转开销。
- 逃逸分析与标量替换:JIT 能够分析对象的生命周期。若对象未逃出当前方法范围,JVM 会避免在堆上分配该对象,直接将其拆解为基本数据类型放在 CPU 寄存器或栈帧上,大幅减轻垃圾回收压力。
- 对象寻址与内存装箱:在 Python 中,整数甚至布尔值都是完全封装的
PyObject,带有引用计数和类型指针(在 64 位机器下一个简单整数占用 28 字节)。连续计算时产生大量间接指针寻址,破坏 CPU 缓存行(L1/L2 Cache);而 Java 的原始类型(int,long,double)直接在连续内存中紧凑排列,支持高效的 SIMD 向量化计算。
因此,在纯粹的单核 CPU 密集型循环、复杂逻辑推导或自定义数据结构遍历中,Java 的吞吐量通常高出 Python 5 到 20 倍。然而在调用底层 C/C++ 封装库(如 NumPy 矩阵运算、TensorFlow 算子、OpenCV 图像处理)时,由于实际计算早已脱离 CPython 解释器,Python 的性能可以逼近底层 C 库的速度。
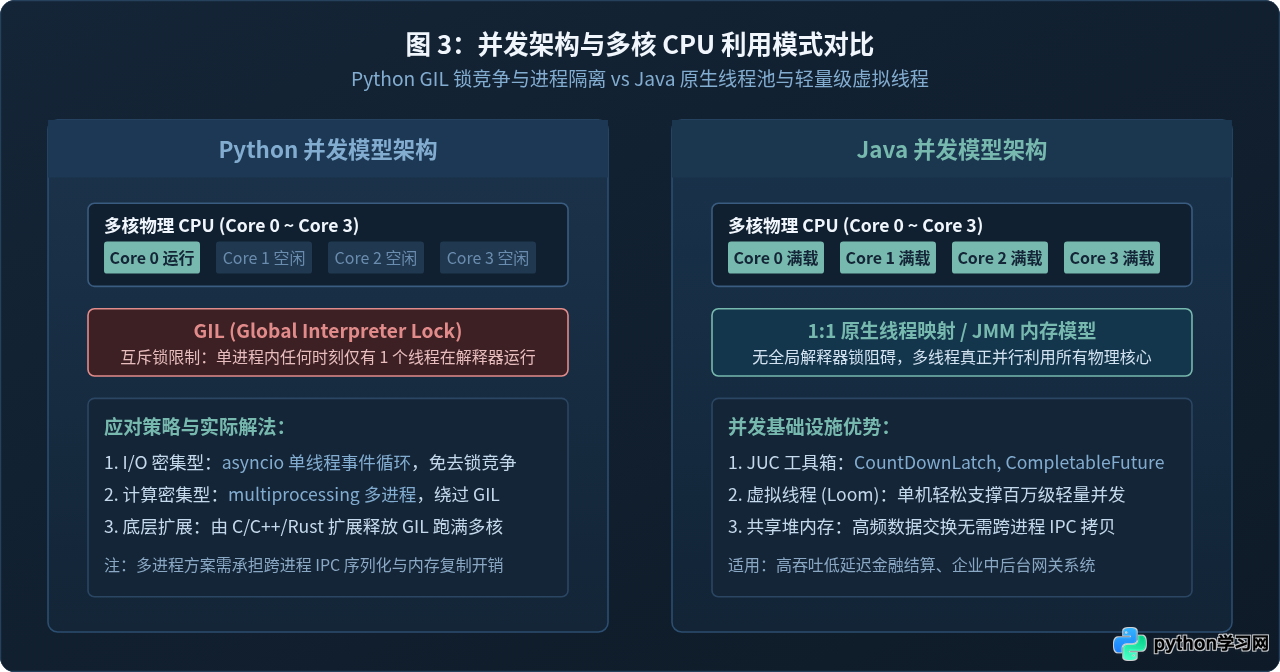
三、并发模型与多核利用:GIL 与多线程调度
现代服务器普遍具备 32 核乃至上百核 CPU 算力。如何充分利用多核硬件,是系统架构的关键指标。
1. Python 的并发边界:全局解释器锁(GIL)
在 CPython 中,由于内存管理采用引用计数算法,为了防止多线程并发修改引用计数导致内存损坏或竞争死锁,CPython 引入了 GIL(Global Interpreter Lock,全局解释器锁)。
- CPU 密集型任务:即使创建了 8 个 Python 线程运行在 8 核机器上,GIL 也会强行让它们在单个核心上串行轮流抢锁,无法实现物理并行,多线程甚至会因线程切换与抢锁带来额外的性能惩罚。
- I/O 密集型与异步解决方案:当线程遇到文件读写、网络 Socket 请求等系统调用时,CPython 会主动释放 GIL。现代 Python 广泛使用
asyncio单线程事件循环处理高并发网络连接;若需利用多核做计算,则必须采用multiprocessing启动独立子进程,但进程间通信(IPC)需要经历跨进程序列化与内存复制。
2. Java 的并发优势:原生 OS 线程与虚拟线程
Java 从语言设计之初就直接拥抱原生多线程。JVM 中的 java.lang.Thread 与操作系统内核级线程通常保持 1:1 的直接映射关系,没有全局解释器锁的束缚。
- 多核真正并行:Java 多线程可以直接被操作系统内核调度到不同的物理核心上同时并发运算,共享同一个 JVM 进程堆内存,数据传递高效,无需跨进程序列化。
- 工程级并发库(J.U.C):从
ConcurrentHashMap、ReentrantLock到线程池ThreadPoolExecutor,Java 提供了极其完善的无锁并发工具和同步屏障。 - JDK 21 虚拟线程(Project Loom):Java 最新版本推出了虚拟线程(Virtual Threads),将轻量级协程机制引入标准库。单机 JVM 可以廉价创建上百万个虚拟线程处理阻塞 I/O,无需重写响应式代码,极大简化了高并发编程模型。
四、工业应用场景与生态护城河
语法和性能上的差异,最终决定了两种语言在工业界沉淀出的生态壁垒。
| 领域场景 | 首选语言 | 核心驱动要素与生态代表 |
|---|---|---|
| 人工智能与数据科学 | Python | PyTorch、TensorFlow、Scikit-learn、Pandas。Python 成为 AI 算法工程的事实标准胶水层,科研成果向工业转化的第一语言。 |
| 大型企业中后台与微服务 | Java | Spring Boot、Spring Cloud、Dubbo、gRPC。强契约、丰富的中间件驱动、完备的 APM 监控链路与庞大的资深工程团队梯队。 |
| 大数据处理与计算引擎 | Java / Scala | Apache Hadoop、Flink、Spark、Kafka、Elasticsearch。底层原生由 JVM 驱动,追求纳秒级内存管理与极高的持续流式吞吐。 |
| 自动化运维、爬虫与辅助脚本 | Python | Ansible、Selenium、Scrapy、Requests。无需编译,开箱即用,几十行代码即可打通跨系统 API 或自动化处理工作流。 |
五、技术选型决策路径与落地指南
在实际项目启动时,应当抛开“谁优谁劣”的主观喜好,依据客观的项目约束进行系统化决策。
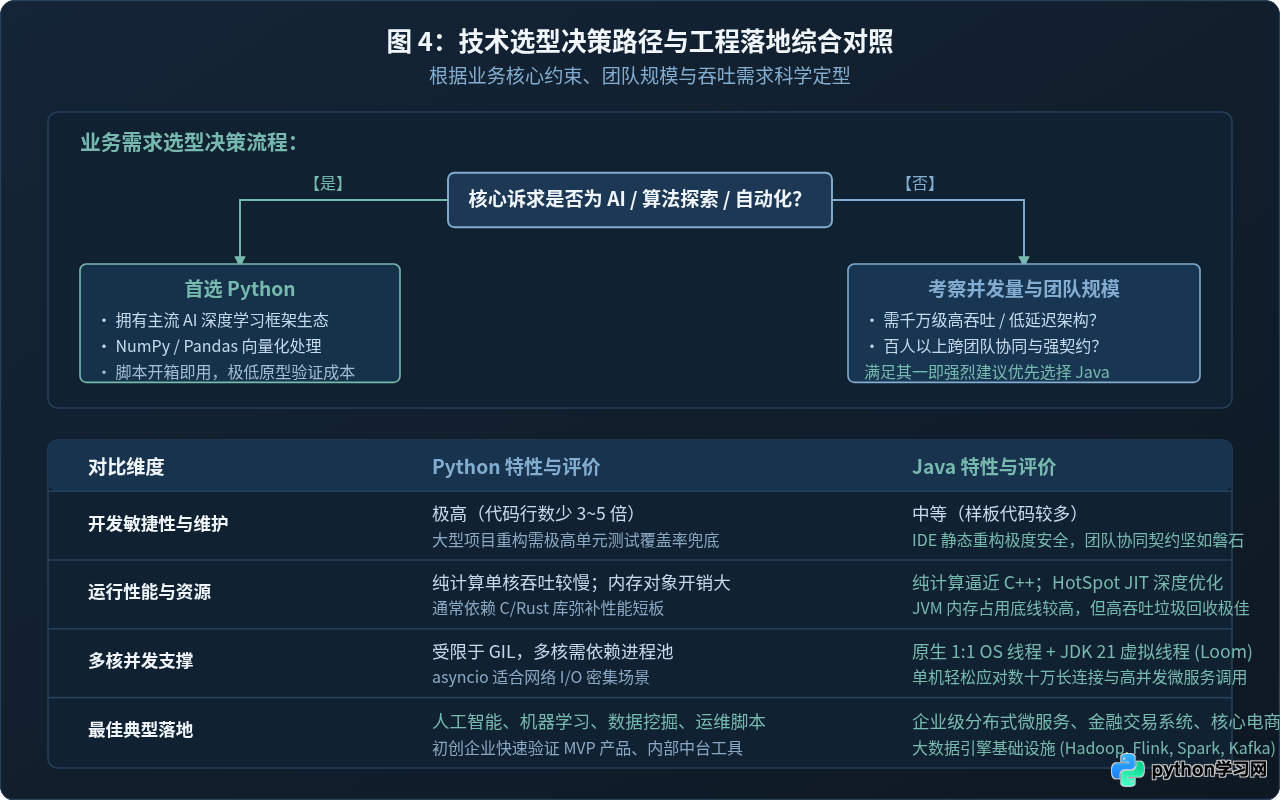
选型判断规则清单:
- 选择 Python 的场景:
- 系统核心价值在于模型训练、特征工程、数学计算或自然语言处理。
- 初创业务或探索性项目,核心诉求是 1~2 周内上线验证用户需求(MVP)。
- 日常自动化测试、系统监控、资产巡检及 DevOps 管道编排。
- 选择 Java 的场景:
- 银行核心账务、证券撮合、电商大促等对系统高可用、高并发、确定性低延迟有硬性要求的系统。
- 涉及跨部门、跨地区数十人以上规模的协同开发,依赖编译期强类型进行契约约束。
- 深度融入或改造现有的大数据平台(如定制 Flink 算子、Kafka 流处理)。
- 现代工业界的混合架构趋势: 在成熟的互联网与工业互联网架构中,两者往往是协同共存的关系。前端接入与核心交易中台由 Java/Spring 构建高可靠网关与领域服务;而用户意图识别、智能推荐、风险预估等算法算子,则通过 gRPC/REST 接口交由 Python 微服务集群(基于 FastAPI 或 Triton Inference Server)独立承接,充分发挥各自维度的最大工程效能。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









