

Python可变与不可变数据类型有什么区别?内存机制与操作差异解析

深入解析Python可变与不可变数据类型的核心区别,从底层的内存指针、对象标签绑定机制到+=运算差异、默认参数陷阱与复合容器行为,全面掌握Python数据操作原理。
一、数据类型核心分类与快速判定方法
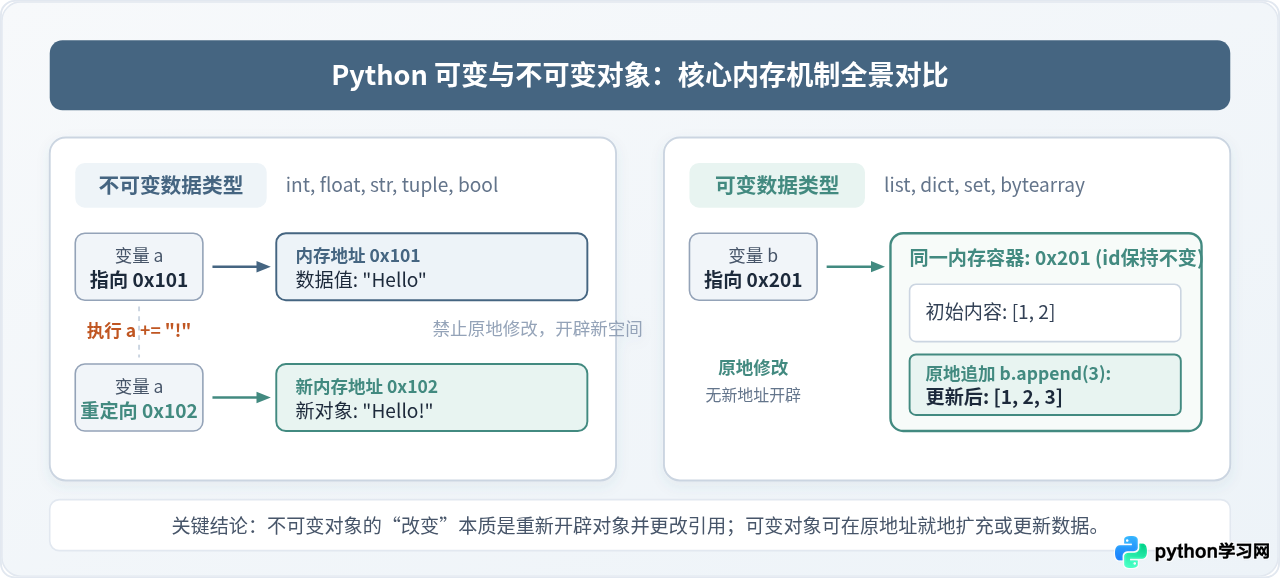
Python 内置的数据类型非常丰富,但在内存管理维度上,它们被清晰地划分为两大阵营:
| 分类类别 | 典型内置数据类型 | 原地修改能力 | 哈希特性(Hashable) |
|---|---|---|---|
| 不可变数据类型 (Immutable) | int, float, complex, bool, str, tuple, frozenset, bytes |
严格禁止;修改将创建全新对象 | 原生支持哈希(元组要求成员亦不可变) |
| 可变数据类型 (Mutable) | list, dict, set, bytearray |
支持就地(in-place)扩展、裁剪与赋值 | 不可哈希,无法直接用作字典的键或集合元素 |
在实际编写或调试代码时,验证一个操作是否改变了对象本身,最直接的手段是使用内置函数 id() 以及身份比较运算符 is。在 CPython 实现中,id(obj) 返回的是该对象在底层 C 堆结构中的内存虚拟地址;a is b 则等价于 id(a) == id(b)。
# 示例代码:验证不可变类型与可变类型的内存地址变动
# 1. 验证不可变对象 (以整型和字符串为例)
num = 100
initial_id = id(num)
num += 1
print(f"整数加1前地址: {initial_id}, 加1后地址: {id(num)}")

# 2. 验证可变对象 (以列表为例)
items = [1, 2, 3]
list_initial_id = id(items)
items.append(4)
print(f"列表追加前地址: {list_initial_id}, 追加后地址: {id(items)}")列表追加前地址: 4359928128, 追加后地址: 4359928128
从输出结果可以直观看到:整数执行 num += 1 后,内存地址发生了偏移,原本的 100 并没有被改为 101,而是新分配了 101 的内存并将变量 num 指向它;相反,列表调用 .append(4) 后,对象的 id 毫厘未变,所有更新均在当前容器内部原地完成。
二、底层内存机制深度剖析:变量名、对象头与指针数组
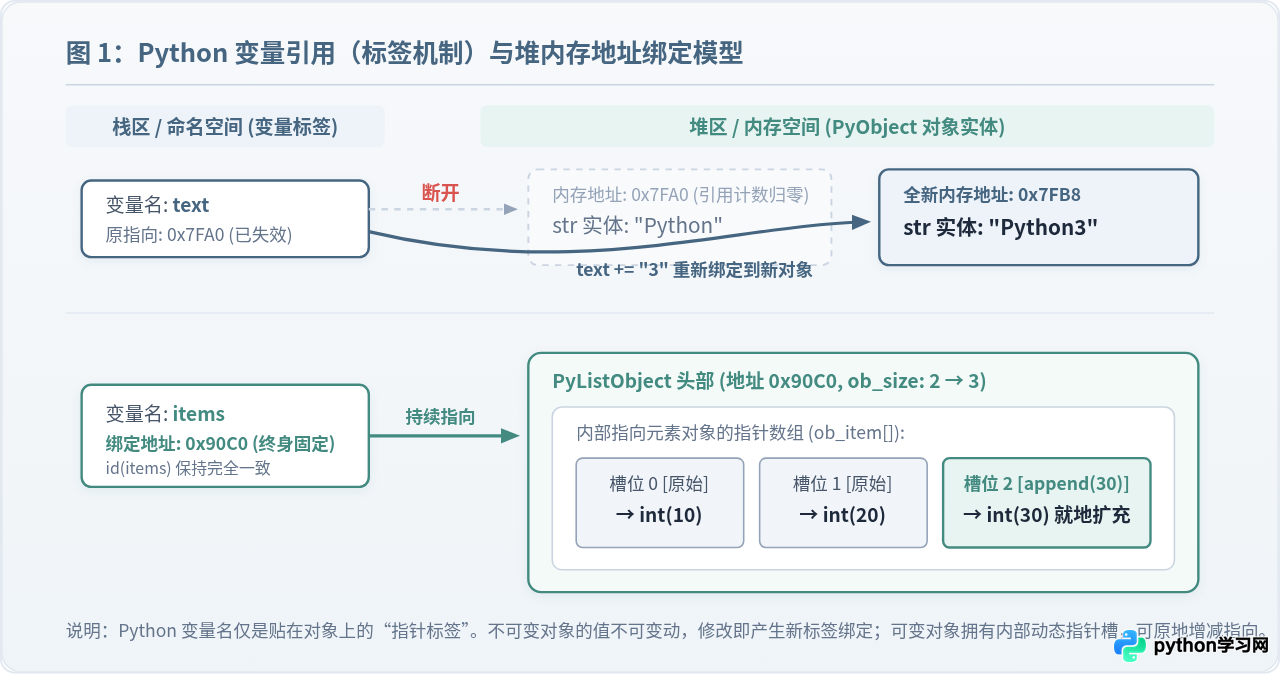
许多有其他语言(如 C/C++)背景的开发者初学 Python 时容易产生误解,认为变量是一个预先开辟好固定大小、用来存放数据的“盒子”。但在 Python 的底层实现中,“变量只是一张贴在对象上的便利贴(Name Binding / 引用标签)”。所有的数值、字符串、列表等实体,都是由堆区分配的独立 PyObject 结构体承载的。
1. 不可变类型的内存模型:只读数据段与重新绑定
不可变对象(如 PyLongObject、PyUnicodeObject)被初始化分配时,其内存块中包含了引用计数(ob_refcnt)、类型指针(ob_type)以及具体的数据内容。一旦完成填充,Python 解释器在 C 语言层面将其标记为只读。当对字符串执行拼接、切片替换等操作时:
- 解释器会在堆区申请一块新的内存空间;
- 将拼接后的计算结果写入新内存空间;
- 将栈区或当前命名空间中的变量标签撕下,重新指向新对象的内存地址;
- 原对象的引用计数减 1。如果引用计数归零,将由垃圾回收器(GC)适时回收。
2. 可变类型的内存模型:连续缓冲区与指针解耦
相比之下,可变对象(如列表 PyListObject)的内部构造要复杂得多。一个列表对象自身包含一个指向存储项指针数组的二级指针 ob_item 以及容量计数 allocated。当创建 items = [10, 20] 时,items 指向的列表头部对象本身只记录元数据,其内部的 ob_item 则指向一个保存了 &10 和 &20 内存地址的连续数组。
当执行 items.append(30) 时,Python 只需要检查预分配容量是否充足;若充足,仅在 ob_item 数组尾部填入新元素 30 的指针,并更新 ob_size 字段。列表对象自身在堆中的首地址(即 id(items))从未变动。这使得可变类型在进行批量元素追加或就地排序时,省去了重新分配外层对象容器的巨大开销。
三、关键操作差异解析:自增运算、方法返回值与传参模型
1. 自增运算符 += 的行为分流
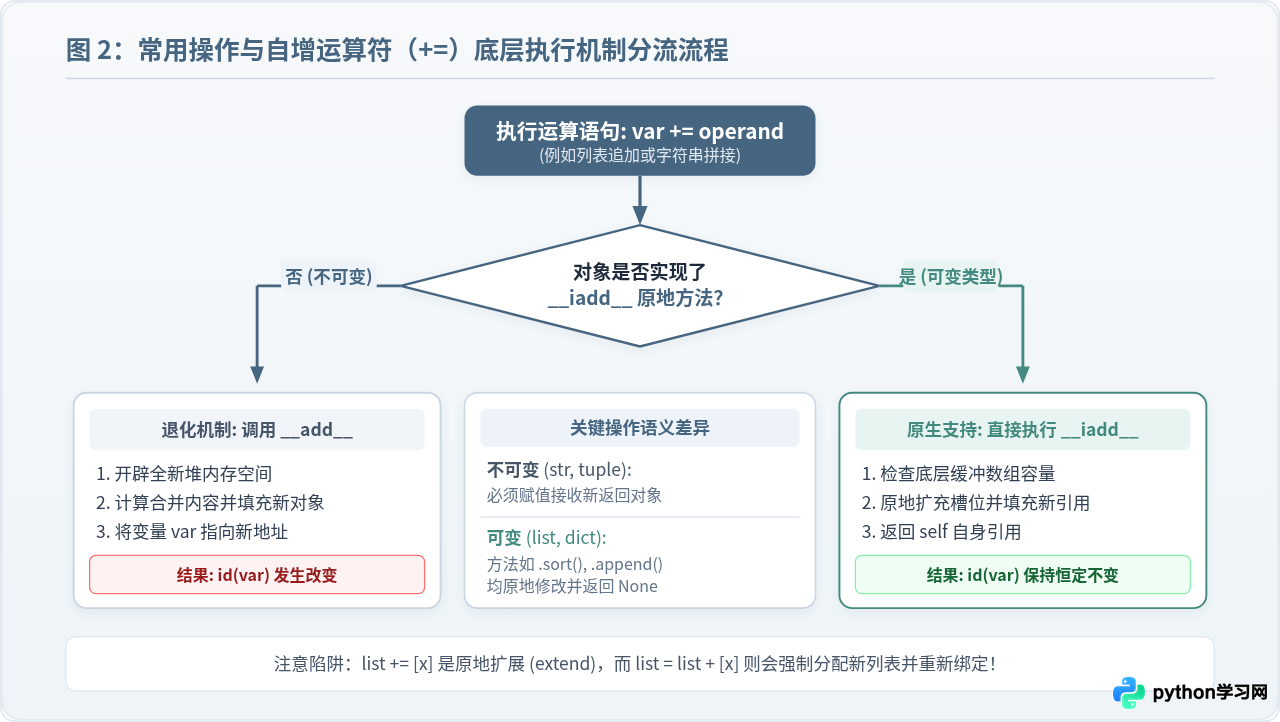
在日常开发中,最具隐蔽性的差异体现在自增运算符 +=(增量赋值)上。+= 并不简单等同于 a = a + b,Python 会优先检测对象是否实现了原地增量魔术方法 __iadd__。
# 示例代码:探究 += 与 + 在列表上的本质差异
# 情况 A:使用 += (原地操作)
list_a = [1, 2]
ref_a = list_a
list_a += [3]
print("list_a += [3] 后:")
print(f"list_a: {list_a}, ref_a: {ref_a}, 两者是否同一对象: {list_a is ref_a}")

# 情况 B:使用 + 并重新赋值 (开辟新对象)
list_b = [1, 2]
ref_b = list_b
list_b = list_b + [3]
print("\nlist_b = list_b + [3] 后:")
print(f"list_b: {list_b}, ref_b: {ref_b}, 两者是否同一对象: {list_b is ref_b}")list_a: [1, 2, 3], ref_a: [1, 2, 3], 两者是否同一对象: True
list_b = list_b + [3] 后:
list_b: [1, 2, 3], ref_b: [1, 2], 两者是否同一对象: False
解析:list_a += [3] 调用了列表的 __iadd__ 方法,其底层等价于 list_a.extend([3]),所有指向该列表的外部引用(如 ref_a)都会同步感知到变化;而 list_b + [3] 则严格遵循加法运算,构造了包含三个元素的新列表,随后通过赋值将 list_b 重新绑定,ref_b 依然留在原旧列表中。
2. 方法调用模式:就地修改返回 None vs 返回新对象
Python 官方 API 设计中严格遵循了一条“无副作用与原地修改分离”的哲学原则:绝大多数对可变对象执行的原地修改方法,都显式返回 None。
list.sort():直接对内部指针进行快速排序,返回None;若写成my_list = my_list.sort(),会导致my_list变为None。sorted(iterable):通用内置函数,绝不修改原对象,而是提取数据后返回一个全新的有序列表。str.upper()、str.replace():字符串作为不可变对象,无法原地修改,因此其方法必然返回生成的新字符串对象。
3. 函数传参的真实本质:传对象引用(Call by Object Reference)
许多教科书争论 Python 究竟是“值传递”还是“引用传递”。准确地说,Python 是对象引用传递(Call by Object Reference / Call by Sharing)。函数调用时,形参获得的是实参所指向对象的内存地址拷贝:
- 如果传递的是可变对象,在函数内部使用其原地方法(如
.append()、.update()、键赋值),外部实参对象会立即被同步改变; - 如果传递的是不可变对象,任何运算都会在函数内部触发重新绑定,无法且不可能对外部实参产生副作用。
四、开发中的两大经典深坑与底层成因
陷阱一:使用可变对象作为函数默认参数
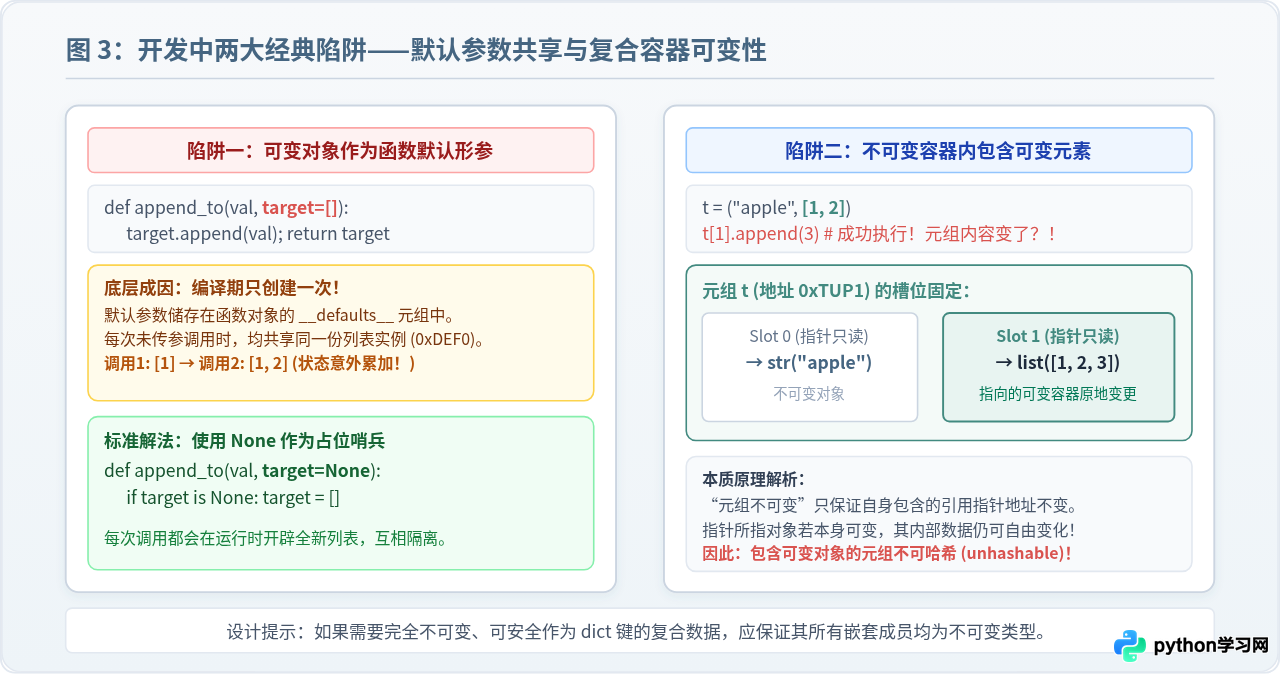
这是 Python 初学者乃至中级工程师最常踩到的性能与逻辑陷阱。请观察以下代码的行为:
# 陷阱演示:默认参数累积污染
def collect_data(item, cache=[]):
    cache.append(item)
    return cache

print(collect_data("A"))  # 期望: ["A"]
print(collect_data("B")) # 意外: 实际输出 ["A", "B"]['A', 'B']
Python 中的
def 是一条可执行语句。在模块加载或函数被定义时(编译期),Python 就会对默认参数表达式进行求值,并将生成的空列表 [] 存入函数对象的 __defaults__ 属性中。这意味着无论后续调用该函数多少次,只要调用者没有显式传入 cache 实参,所有调用都在共享 __defaults__ 中的同一个列表实例!
工程标准规范解法:使用不可变的不可替代哨兵 None 作为默认值,在函数体运行时判断并动态初始化:
def collect_data_safe(item, cache=None):
    if cache is None:
        cache = []  # 每次调用均在运行时创建全新独立列表
    cache.append(item)
    return cache
陷阱二:不可变容器内包含可变元素(元组的局限性)
“元组是不可变的”,这句话严谨的含义是:元组对象内部各个槽位(Slots)所保存的指针地址不可变,元组长度不可变。但如果槽位所指向的目标对象本身是一个可变对象(如列表),那么通过该指针寻找到的数据内容是允许被改变的!
# 示例代码:包含列表的元组
t = ("alpha", [10, 20])
print(f"操作前元组内容: {t}, 列表地址: {id(t[1])}")

# 原地修改列表元素
t[1].append(30)
print(f"操作后元组内容: {t}, 列表地址: {id(t[1])}")

# 尝试直接给槽位赋新值则会抛出异常
try:
    t[1] = [10, 20, 30]
except TypeError as e:
print(f"直接赋值报错: {e}")操作后元组内容: ('alpha', [10, 20, 30]), 列表地址: 4360214848
直接赋值报错: 'tuple' object does not support item assignment
深入理解这一原理还能解释另一个核心问题:为什么字典的键(Key)和集合(Set)的元素必须是不可变对象?
字典和集合的高性能检索依赖于哈希表(Hash Table)。当一个对象被放入哈希表时,其存储桶索引是通过 hash(key) 计算得出的。如果作为键的对象内部数据可变,一旦其内容发生改变,其哈希值也将改变,导致哈希表在旧槽位再也无法命中该键,破坏哈希表的数据一致性。因此,Python 规定只有实现了稳定的 __hash__() 且内容不可变的对象才具备哈希性(Hashable)。包含列表的元组在计算 hash(t) 时会直接抛出 TypeError: unhashable type: 'list'。
五、工程实战选型与性能最佳实践总结
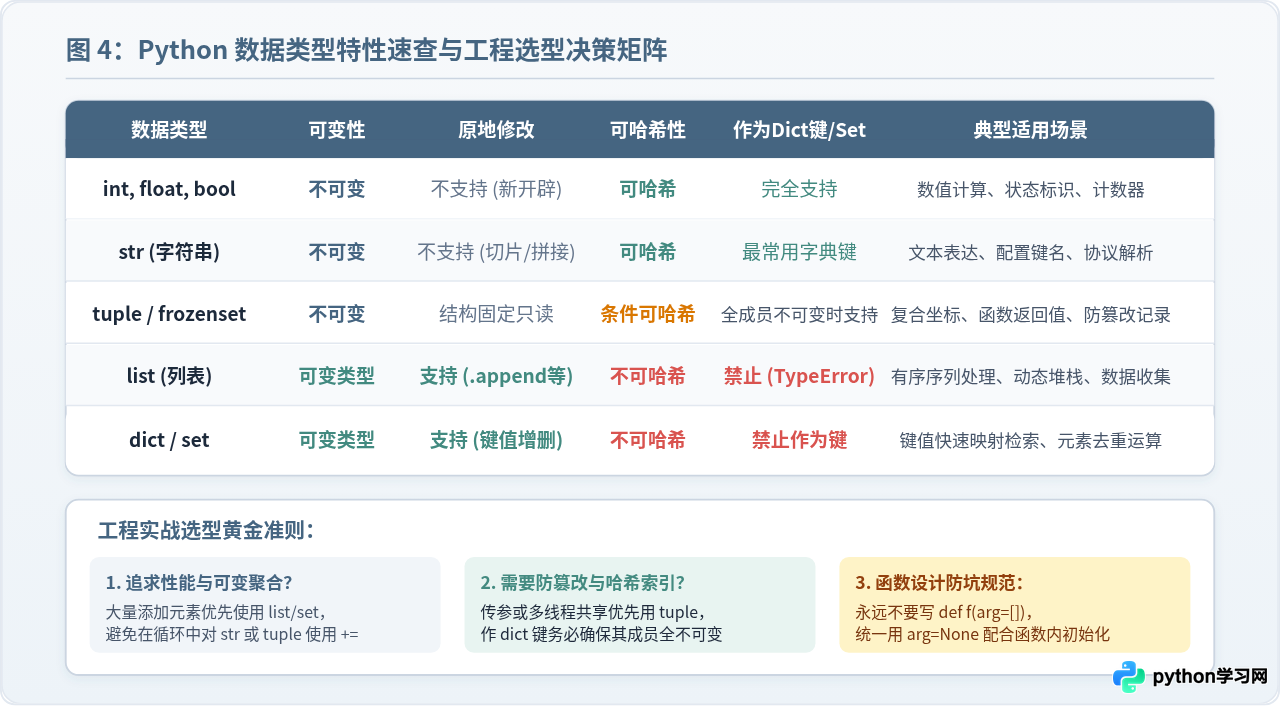
在实际工程开发中,合理选用可变与不可变类型,不仅能够避免难以排查的引用共享 Bug,还能对系统性能产生决定性影响。以下是三大关键实践建议:
+=在循环中拼接长字符串或不可变元组是一种经典的反模式。每次
+= 都会触发 \(O(N)\) 级别的内存重新分配与字节拷贝,导致整体耗时退化为 \(O(N^2)\)。应当先使用可变容器 list 收集数据(其 .append() 具备摊销 \(O(1)\) 时间复杂度),最后通过 "".join(list) 一次性在堆中高效分配目标字符串。
当一个类的内部状态由可变列表或字典维护时,如果直接通过 Getter 方法将该内部对象返回给调用方,调用方的就地修改会无意中破坏类的内部封装(即“表示暴露”)。在需要对外只读暴露数据时,应优先将其转换为不可变元组
tuple(self._internal_list) 或返回深浅拷贝。
在涉及多线程或并发处理共享配置时,不可变对象天然具备线程安全(Thread-Safe)的优良特性。由于其内存内容不可变动,多个线程并发读取无需加锁同步,极大地降低了死锁风险与并发控制开销。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









