

Python文件操作代码示例:读写TXT、CSV与JSON数据
深入讲解Python中TXT纯文本、CSV表格与JSON结构化数据的读写操作,包含with上下文管理、编码规范、核心库函数及完整可运行代码示例。
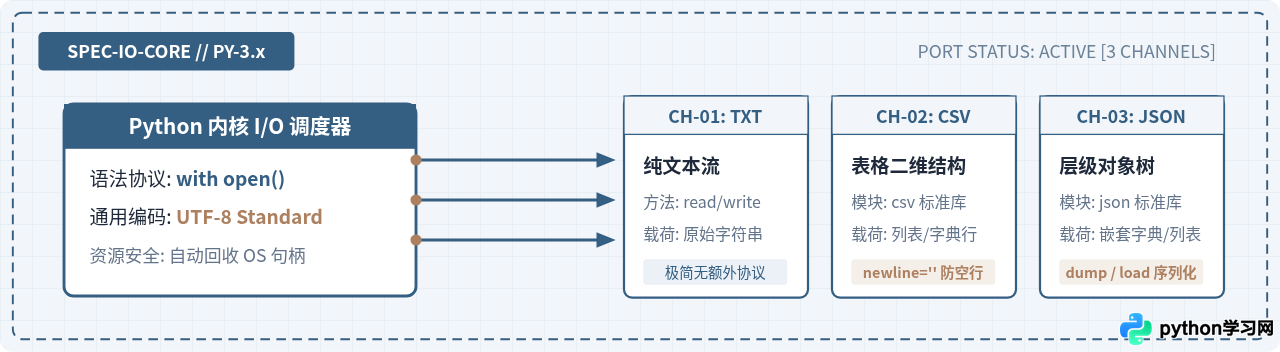
一、Python 文件操作核心协议:open 函数与上下文管理
在 Python 中,所有针对磁盘文件的 I/O 行为均以内置的 open() 函数为入口。操作系统分配给每个打开文件的句柄数量是有限的。如果使用传统的 f = open(...) 并在操作结束后显式调用 f.close(),一旦读写过程中抛出异常,程序就会跳过关闭步骤,造成文件描述符泄漏甚至文件损坏。
推荐的工业标准做法是使用 with 语句。它是 Python 上下文管理器(Context Manager)协议的直接实现:进入 with 代码块时自动触发 __enter__() 获取文件对象;离开代码块时,无论程序是正常执行结束还是遭遇未捕获的运行时异常,都会自动调用 __exit__() 刷新缓冲区并关闭底层操作系统文件句柄。
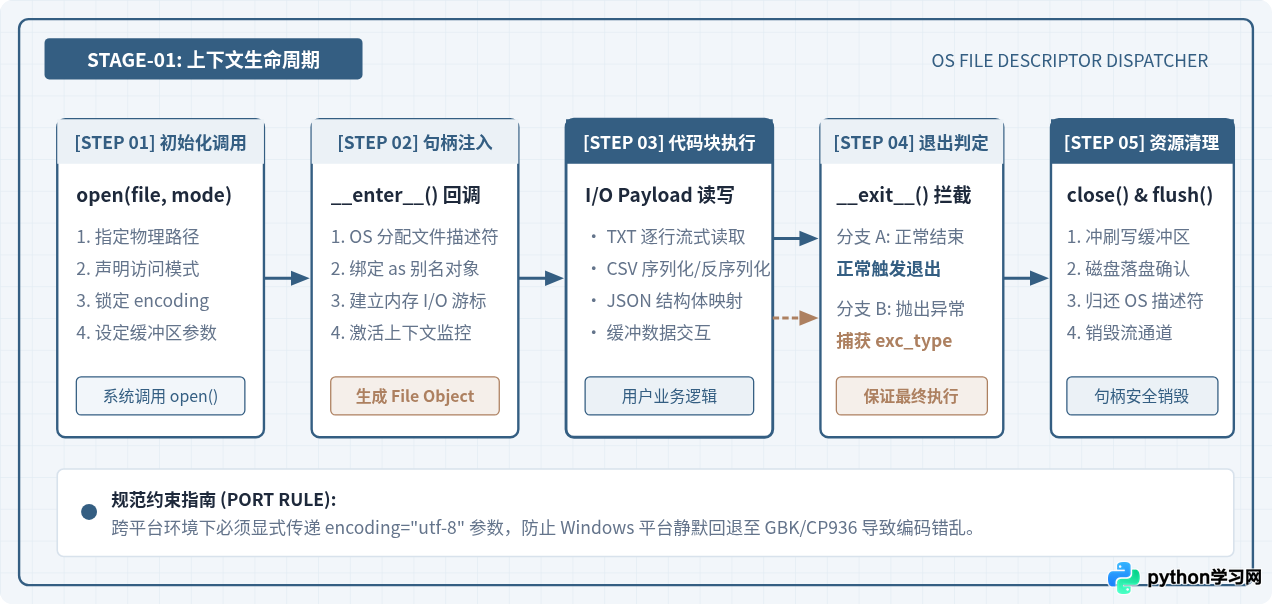
open() 函数的默认编码不同。在 Linux 和 macOS 上通常是 utf-8,而在简体中文 Windows 操作系统上默认编码是 cp936(GBK)。如果不指定编码,含有中文字符的文件在跨系统分发时极易触发 UnicodeDecodeError。因此,除非有特殊历史文件需求,必须始终显式指定 encoding="utf-8"。
二、纯文本文件(TXT)读写操作
TXT 文件属于无格式或轻格式的纯字符序列。Python 内置的文件对象直接提供了按字符、按行或全量读取的方法。
1. 写入 TXT 文件
写入文件时主要有以下模式选择:
"w"(覆盖写入):如果文件不存在则新建;如果文件已存在,则在打开时将其内容清空。"a"(追加写入):如果文件不存在则新建;如果文件已存在,光标移至文件末尾追加新内容。
# demo_txt_write.py
# 演示文本写入与追加
content_lines = [
    "第一行:Python 文件操作基础\n",
    "第二行:支持纯文本与日志数据记录\n",
    "第三行:逐行写入与换行符控制\n"
]

# 1. 覆盖写入
with open("sample.txt", mode="w", encoding="utf-8") as f:
    f.write("=== 文件标题头 ===\n")
    # writelines 接收可迭代对象,注意元素末尾需自带换行符 \n
    f.writelines(content_lines)

# 2. 追加写入
with open("sample.txt", mode="a", encoding="utf-8") as f:
    f.write("追加行:任务执行完成时间记录\n")
2. 读取 TXT 文件
读取纯文本文件常见的方法有三种,针对不同规模的文件应选择合适的方式:
f.read():一次性将文件全部内容读入内存字符串。适用于几兆以内的轻量小文件。f.readlines():一次性将所有行读取为一个字符串列表。同样会占用与文件大小成正比的内存。- 迭代文件对象(推荐):直接使用
for line in f遍历。Python 会在底层启用缓存流式迭代,不会将整个大文件瞬间载入内存,适用于 GB 级大型日志文件的处理。
# demo_txt_read.py
# 方式一:小文件全量读取
with open("sample.txt", mode="r", encoding="utf-8") as f:
    full_text = f.read()
    print("--- 全量读取结果 ---")
    print(full_text)

# 方式二:流式逐行读取(内存友好)
print("--- 逐行流式读取结果 ---")
with open("sample.txt", mode="r", encoding="utf-8") as f:
    for line_num, line in enumerate(f, start=1):
        # strip() 移除行尾的 \n 与多余空白
        print(f"[{line_num}] {line.strip()}")
=== 文件标题头 ===
第一行:Python 文件操作基础
第二行:支持纯文本与日志数据记录
第三行:逐行写入与换行符控制
追加行:任务执行完成时间记录
--- 逐行流式读取结果 ---
[1] === 文件标题头 ===
[2] 第一行:Python 文件操作基础
[3] 第二行:支持纯文本与日志数据记录
[4] 第三行:逐行写入与换行符控制
[5] 追加行:任务执行完成时间记录
三、表格数据文件(CSV)读写操作
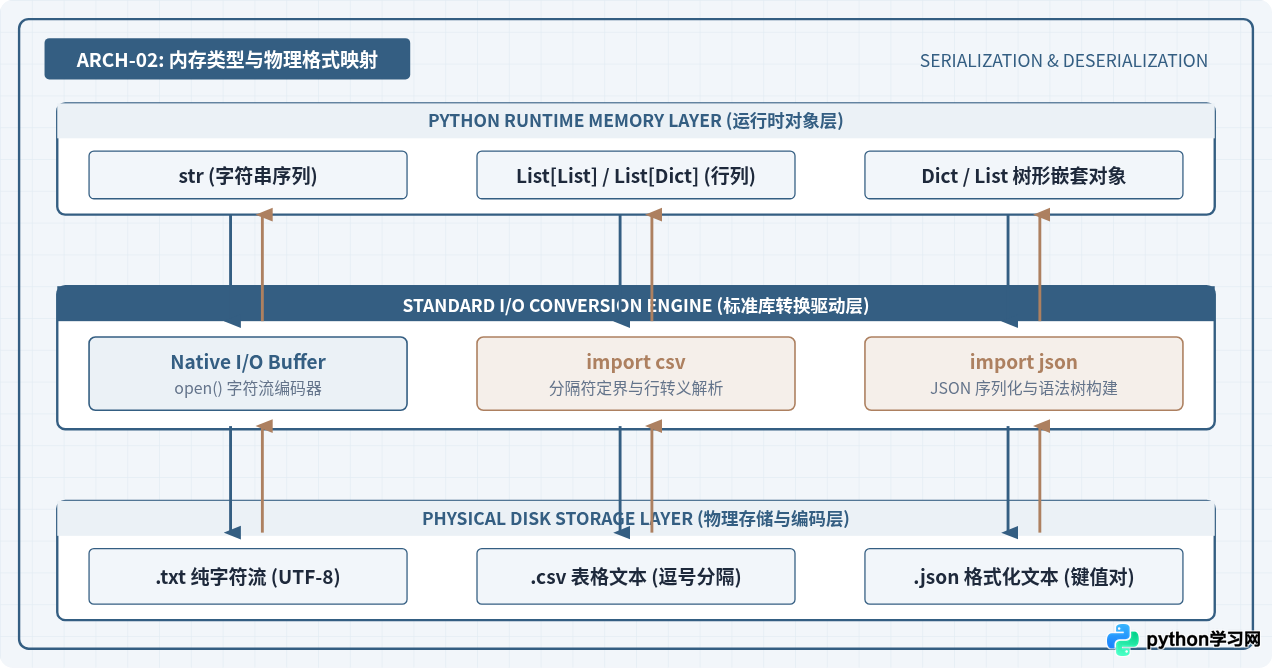
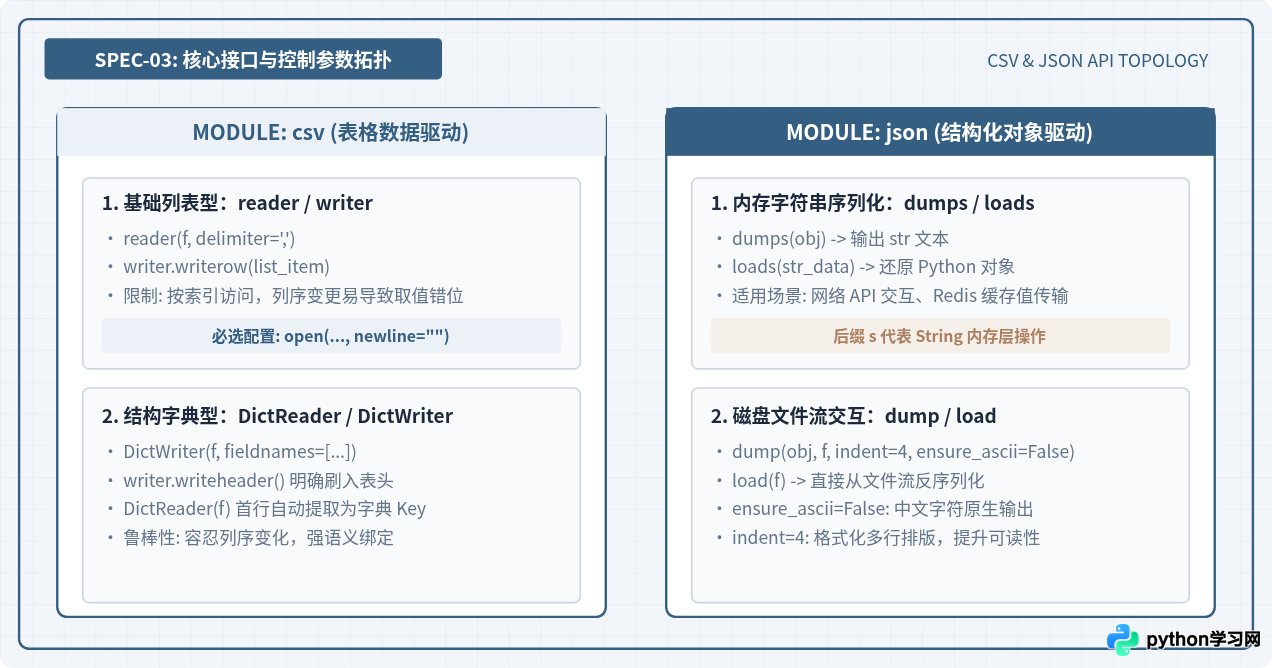
CSV(Comma-Separated Values)本质上也是文本文件,但它约定每一行代表一条记录,字段之间用逗号(或其它指定定界符)隔开。如果直接使用 split(",") 手动切分,遇到包含英文逗号、换行符或双引号的内容时极易解析出错。因此,应始终使用 Python 内置的 csv 模块。
1. 关键参数:newline="" 的作用
在以写模式打开 CSV 文件时,必须在 open() 中传入 newline="" 参数。如果省略此参数,在 Windows 平台上,csv.writer 在写入由其内部生成的 \r\n 换行时,Python 内置的文本模式转换器会再次把 \n 翻译为 \r\n,最终导致生成的文件每行之间都夹带一个恼人的多余空行。
2. 基于列表的读写:csv.reader 与 csv.writer
# demo_csv_list.py
import csv

# 待写入的表格数据(首行为表头)
table_data = [
    ["工号", "姓名", "部门", "考核分"],
    ["1001", "张伟", "技术研发", 95.5],
    ["1002", "李娜", "产品运营", 91.0],
    ["1003", "王强", "数据分析", 88.5]
]

# 写入 CSV:注意 newline=""
with open("staff.csv", mode="w", encoding="utf-8", newline="") as f:
    writer = csv.writer(f)
    # 写入单行表头
    writer.writerow(table_data[0])
    # 批量写入其余数据行
    writer.writerows(table_data[1:])

# 读取 CSV
with open("staff.csv", mode="r", encoding="utf-8") as f:
    reader = csv.reader(f)
    for row in reader:
        print(f"行数据: {row} | 字段数: {len(row)}")
行数据: ['1001', '张伟', '技术研发', '95.5'] | 字段数: 4
行数据: ['1002', '李娜', '产品运营', '91.0'] | 字段数: 4
行数据: ['1003', '王强', '数据分析', '88.5'] | 字段数: 4
3. 基于字典的读写:csv.DictReader 与 csv.DictWriter
当表格列数较多或列顺序可能变化时,使用下标访问字段容易引发越界或错位。此时使用 DictWriter 和 DictReader 将每行数据映射为字典是更健壮的选择。
# demo_csv_dict.py
import csv

dict_records = [
    {"product_id": "P01", "name": "机械键盘", "price": 299, "stock": 45},
    {"product_id": "P02", "name": "无线鼠标", "price": 129, "stock": 80},
    {"product_id": "P03", "name": "4K显示器", "price": 1899, "stock": 15}
]

headers = ["product_id", "name", "price", "stock"]

# 字典写入
with open("products.csv", mode="w", encoding="utf-8", newline="") as f:
    writer = csv.DictWriter(f, fieldnames=headers)
    # 自动写入字段名作为表头
    writer.writeheader()
    writer.writerows(dict_records)

# 字典读取
with open("products.csv", mode="r", encoding="utf-8") as f:
    reader = csv.DictReader(f)
    print("--- 字典流读取 ---")
    for row in reader:
        # 字段自动变为字典的 Key,值均为字符串类型
        print(f"商品: {row['name']} | 单价: {row['price']} | 库存: {row['stock']}")
商品: 机械键盘 | 单价: 299 | 库存: 45
商品: 无线鼠标 | 单价: 129 | 库存: 80
商品: 4K显示器 | 单价: 1899 | 库存: 15
四、结构化数据文件(JSON)读写操作
JSON(JavaScript Object Notation)是一种轻量级的数据交换格式,因其直观的嵌套树形结构,广泛用于软件配置文件、Web API 数据交互及复杂业务状态持久化。Python 内置的 json 模块完成了 Python 原生字典/列表与 JSON 字符串之间的双向转换。
1. 厘清两对核心函数
初学者容易混淆 json 模块中的四种操作,其命名规则非常清晰:
json.dump()和json.load():针对文件流(File-like object)进行操作,接收文件句柄作为参数。json.dumps()和json.loads():末尾的 s 代表 String,针对内存中的字符串进行操作。
2. 中文与格式化参数:ensure_ascii 与 indent
默认情况下,json.dump() 和 json.dumps() 会将所有非 ASCII 字符(包括中文、日文、Emoji 等)自动转义为 \uXXXX 形式的 Unicode 转义序列。虽然解析时能还原,但直接查看 JSON 文件时无法辨识。
传入 ensure_ascii=False 能够让中文字符以原貌保存。另外,传入 indent=4(或 indent=2)会令输出自动带有缩进与换行,非常适合配置文件;若用于紧凑的网络通信,则可以省略 indent 参数以节省体积。
# demo_json_io.py
import json

app_config = {
    "server": {
        "host": "127.0.0.1",
        "port": 8080,
        "debug": True
    },
    "metadata": {
        "title": "生产任务调度中心",
        "version": "1.2.0",
        "tags": ["核心模块", "自动化", "I/O 调度"]
    },
    "workers": [
        {"id": 1, "name": "爬虫采集节点", "concurrency": 8},
        {"id": 2, "name": "数据清洗节点", "concurrency": 16}
    ]
}

# 1. 将复杂结构体写入 JSON 文件
with open("config.json", mode="w", encoding="utf-8") as f:
    json.dump(app_config, f, indent=4, ensure_ascii=False)

# 2. 从 JSON 文件流直接加载为 Python 字典/列表
with open("config.json", mode="r", encoding="utf-8") as f:
    loaded_data = json.load(f)

# 访问嵌套属性与类型验证
print(f"应用名称: {loaded_data['metadata']['title']}")
print(f"端口号: {loaded_data['server']['port']} (类型: {type(loaded_data['server']['port']).__name__})")
print(f"首个节点名称: {loaded_data['workers'][0]['name']}")
端口号: 8080 (类型: int)
首个节点名称: 爬虫采集节点
五、格式对比与异常防御指南
在工程实践中,针对不同的业务数据形态,应选择合适的数据文件格式:
| 文件类型 | 核心应用场景 | 优势 | 劣势与注意事项 |
|---|---|---|---|
| TXT | 单行日志记录、原始抓取文本、提示词模版 | 开销极低、无语法解析负担,支持超大文件流式追加与逐行遍历 | 缺乏结构化元数据,复杂类型需手写解析规则 |
| CSV | 数据分析样本、Excel 导出、数据库表格转储 | 格式轻量,兼容各类 BI 分析工具及 Pandas 框架 | 写文件需配置 newline="",无法天然表达层级嵌套数据 |
| JSON | 程序配置文件、Restful API 传输、复合嵌套对象 | 强层级嵌套、字段类型明确,与 Python 字典/列表无缝映射 | 全量反序列化时大文件较占内存,写中文需配 ensure_ascii=False |
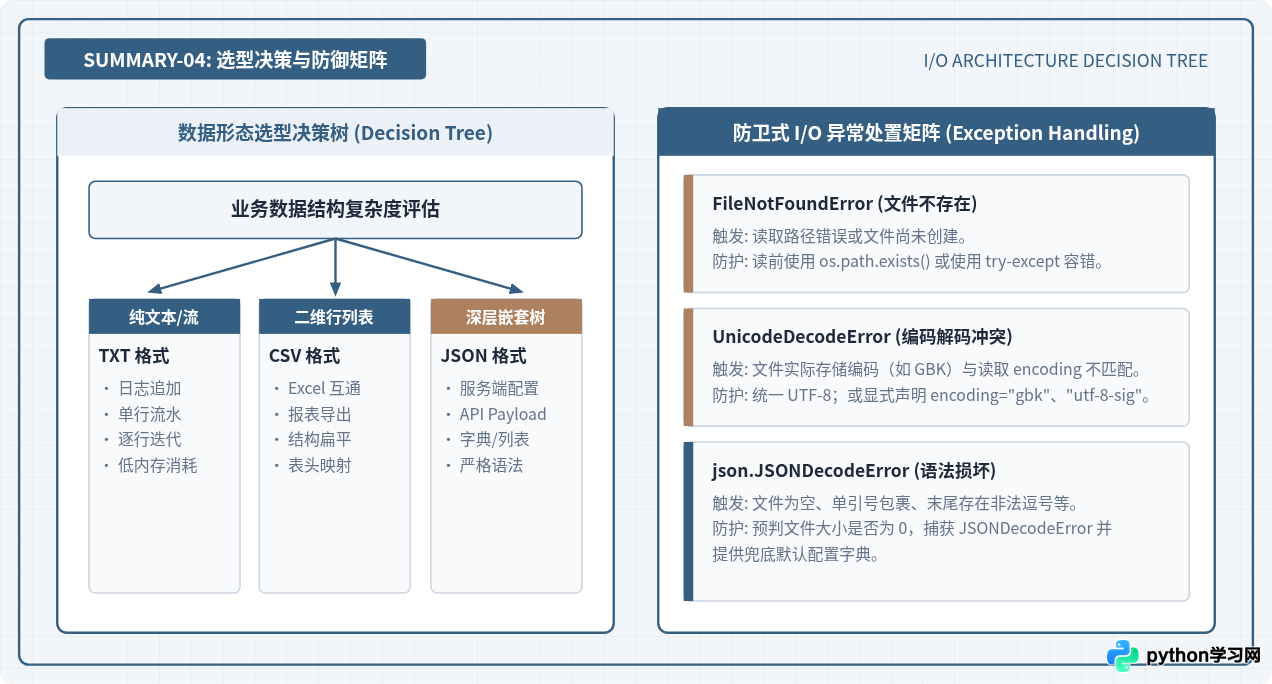
防御式编程完整代码示例
# demo_defensive_io.py
import json
import os

def safe_load_json_config(config_path: str, default_data: dict) -> dict:
    """
    安全读取 JSON 配置:自动处理路径不存在、空文件及语法损坏异常
    """
    if not os.path.exists(config_path):
        print(f"[提示] 配置文件 {config_path} 不存在,自动初始化并写入默认配置。")
        # 写入默认配置并返回
        with open(config_path, mode="w", encoding="utf-8") as f:
            json.dump(default_data, f, indent=4, ensure_ascii=False)
        return default_data

    try:
        with open(config_path, mode="r", encoding="utf-8") as f:
            # 防止空文件触发 JSONDecodeError
            content = f.read().strip()
            if not content:
                print(f"[警告] 配置文件 {config_path} 为空文件,返回默认数据。")
                return default_data
            return json.loads(content)
    except (UnicodeDecodeError, json.JSONDecodeError) as err:
        print(f"[错误] 解析配置文件失败: {err},已降级回退至默认配置。")
        return default_data

# 测试安全加载
default_setting = {"timeout": 30, "retry": 3}
loaded_config = safe_load_json_config("app_config.json", default_setting)
print(f"最终生效配置: {loaded_config}")
总结而言,掌握 Python 文件操作的关键在于形成良好的编码习惯:始终通过 with open(...) 声明生命周期;针对中文文件显式声明 encoding="utf-8";编写 CSV 保持 newline="";序列化 JSON 时灵活运用 ensure_ascii=False 与 indent。遵循这些工程实践,能够保证文件 I/O 脚本在跨平台运行时的稳定与可靠。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









