

Python大文件复制怎么显示进度条
详细讲解在Python中复制大文件时显示实时进度条的核心原理与实现方法,包含纯标准库分块流实现、tqdm工业级进度条封装、元数据保留以及缓冲区性能调优指南。
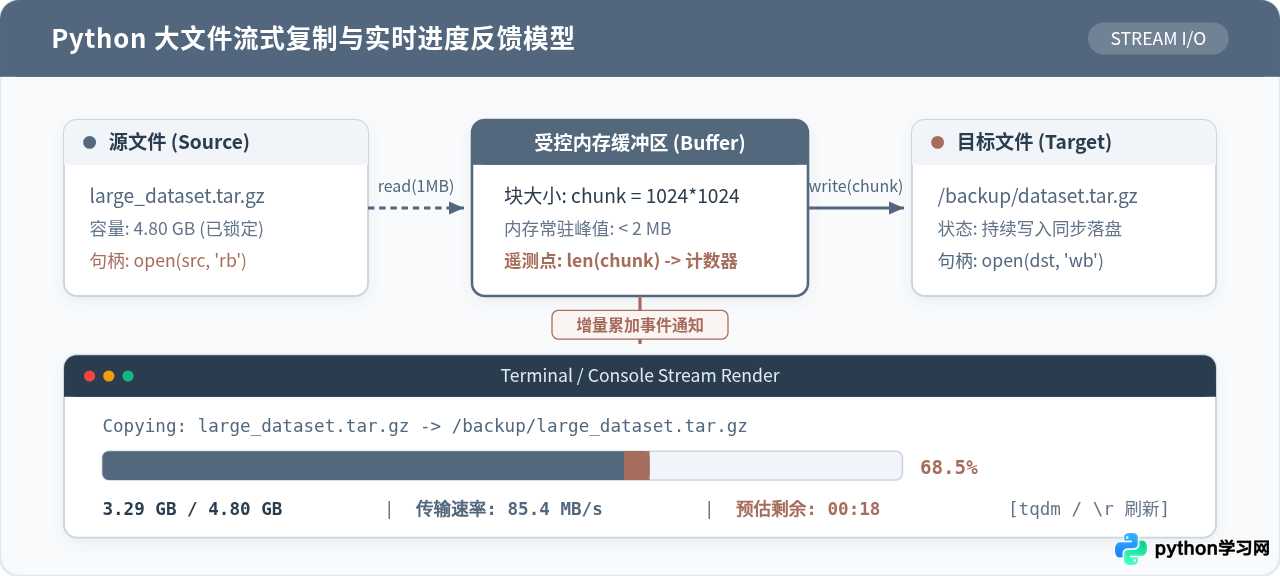
在 Python 中,直接调用标准库的 shutil.copy 或 shutil.copyfile 复制多吉字节(GB)的大文件时,程序会处于长时间静默阻塞状态,终端没有光标移动或任何实时回显,极易被误判为程序挂死。标准库本身为了接口极简,在底层写死了读写搬运循环,并未提供进度回调钩子。解决该问题的核心在于:将单次黑盒调用拆解为“按指定缓冲区(如 1MB ~ 4MB)分块读取与写入”的文件流,在每次数据块落盘时累加已复制字节量,并驱动标准输出回车符 或 tqdm 模块刷新终端界面。
一、为什么原生 shutil 没有进度反馈?底层流机制解析
翻看 Python 标准库 shutil 的源码可以发现,无论是 shutil.copy 还是 shutil.copy2,它们在底层复制文件内容时,最终都委托给了 shutil.copyfileobj(fsrc, fdst, length=...) 函数。这个函数的内部实现是一个纯粹的死循环:不断从源文件句柄读取数据块,写入目标文件句柄,直到读取内容为空字节串 b'' 时退出。
由于 shutil.copyfileobj 的设计初衷是提供最高效、紧凑的字节级数据管道,它在循环体内没有留出任何回调函数参数。如果我们复制一个 10GB 的数据库备份或虚拟机镜像,整个线程就会停留在操作系统底层的 I/O 阻塞调用中,开发者和使用者在终端前只能面对空白的等待光标。
处理大文件复制时,绝不能因为需要知道进度就执行 f.read() 一次性读取全部内容。一次性读取会将整个文件加载到 Python 进程的内存堆空间中,不仅会导致系统内存突增,甚至会直接触发操作系统的 OOM Killer 强制终结进程。正规的做法是确定一个受控的缓冲区尺寸(Buffer Size),让内存常驻开销始终被锁定在数兆字节以内,并通过流式驱动将传输事件反馈给终端控制台。
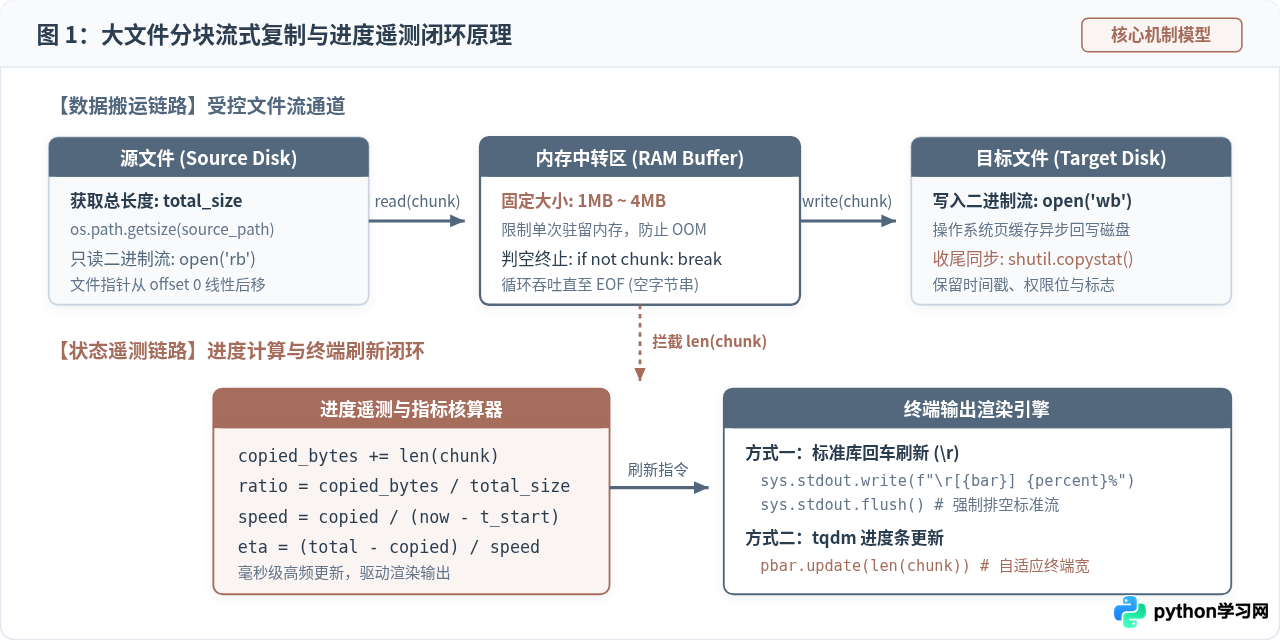
如上图所示,一个完整的带进度复制链路包含两条相互协同的通道:一条是受控的数据搬运链路,仅负责在内存安全限制下将数据块从源磁盘泵入目标磁盘;另一条是状态遥测链路,在每次缓冲区交接完成时捕获当前数据块长度,将其注入核算引擎,计算出百分比、速率与剩余时间,最后驱动控制台进行单行重绘。
二、方案一:纯标准库实现(零外部依赖)
在生产运维自动化、基础容器镜像或严格限制网络拉取第三方包的内网环境中,保持零依赖是一项重要指标。利用 Python 内置的 os、sys 和 time 模块,即可实现流畅的单行控制台进度条。
很多初学者尝试用 print() 打印进度时,终端会快速刷出成千上万行日志,瞬间淹没整个屏幕。控制台单行刷新的核心在于回车转义符 (Carriage Return)。在 ASCII 协议中, 会将终端光标直接重置回当前行的最左端起点,配合后续新的文本输出,即可完整覆盖掉上一秒的旧数值。由于标准输出流 sys.stdout 默认具备缓冲机制,使用 覆盖文本后必须紧跟 sys.stdout.flush() 强制清空缓冲区,否则进度字符可能被滞留在内存中无法即时渲染。
标准库分块复制完整代码实现
import os
import sys
import time

def copy_file_standard(src_path: str, dst_path: str, buffer_size: int = 1024 * 1024) -> None:
    """
    使用纯标准库复制大文件,并在终端实时刷新显示进度条。

    :param src_path: 源文件路径
    :param dst_path: 目标文件路径
    :param buffer_size: 每次读取的缓冲区大小,默认 1MB
    """
    if not os.path.isfile(src_path):
        raise FileNotFoundError(f"源文件不存在: {src_path}")

    total_size = os.path.getsize(src_path)

    # 防御 0 字节特殊空文件,避免后续发生 ZeroDivisionError
    if total_size == 0:
        with open(dst_path, 'wb'):
            pass
        print(f"复制完成: {os.path.basename(src_path)} (空文件, 0 字节)")
        return

    copied_bytes = 0
    bar_width = 30  # 进度条实体字符长度
    start_time = time.time()

    print(f"开始复制: {os.path.basename(src_path)} -> {dst_path}")

    with open(src_path, 'rb') as f_src, open(dst_path, 'wb') as f_dst:
        while True:
            chunk = f_src.read(buffer_size)
            if not chunk:
                break
            f_dst.write(chunk)
            copied_bytes += len(chunk)

            # 计算进度与运行指标
            elapsed = time.time() - start_time
            ratio = copied_bytes / total_size
            speed = copied_bytes / elapsed if elapsed > 0 else 0  # 字节/秒
            eta = (total_size - copied_bytes) / speed if speed > 0 else 0

            # 组装图形进度条
            filled_len = int(bar_width * ratio)
            bar = '█' * filled_len + '-' * (bar_width - filled_len)

            # 格式化输出字符串
            percent = ratio * 100
            copied_mb = copied_bytes / (1024 * 1024)
            total_mb = total_size / (1024 * 1024)
            speed_mb = speed / (1024 * 1024)

            sys.stdout.write(
                f"\r[{bar}] {percent:5.1f}% | "
                f"{copied_mb:7.2f}/{total_mb:7.2f} MB | "
                f"{speed_mb:6.1f} MB/s | ETA: {eta:4.0f}s"
            )
            sys.stdout.flush()

    # 循环结束后换行,防止后续打印信息覆盖进度条最终状态
    print()
    print(f"传输完成,总耗时: {time.time() - start_time:.2f} 秒")
执行该函数时,终端会始终固定在单行进行高频动态渲染,示例输出效果如下:
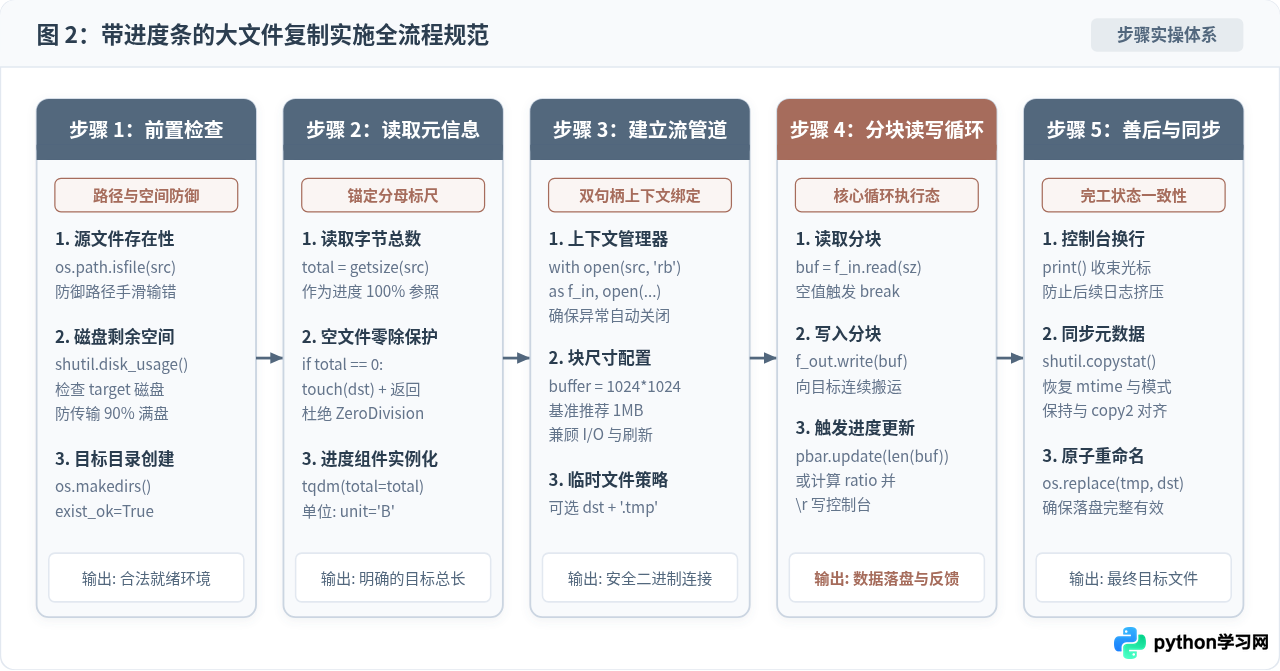
从上图可以看到,一个健壮的实施方案绝不仅仅是写一个 while 循环,它需要经历“前置环境检查、基准元数据锚定、安全双流绑定、带流式遥测的搬运循环以及善后收敛”这五个阶段。尤其是在循环退出后,显式调用 print() 释放控制台换行是必不可少的收尾动作。
三、方案二:结合 tqdm 打造工业级交互体验
虽然纯标准库方案足够轻量,但在复杂交互终端、自动化 CLI 工具或大型数据处理流水线中,自建进度计算往往面临若干边缘痛点:例如终端窗口被用户拉伸或缩小时字符容易发生换行错位;传输速率如果采用全周期简单平均,在网络抖动时无法反映当前的瞬时波动态势;不同量级(从数十兆到数吉字节)的字节单位换算需要编写大量额外的格式化代码。
Python 生态中事实上的标准进度条库是 tqdm。通过合理配置其单位换算参数,tqdm 能自动以 1024 进制将字节数精确折算为 KiB、MiB 或 GiB,并且内置了基于指数移动平均(EMA)的平滑算法,可以提供非常稳定的速率估算与剩余时间预测。
pip install tqdm。
方式 A:命令式显式更新
最直接的做法是在手动分块循环中直接驱动 tqdm 实例:
import os
from tqdm import tqdm

def copy_file_tqdm_simple(src_path: str, dst_path: str, chunk_size: int = 1024 * 1024) -> None:
    total_size = os.path.getsize(src_path)

    with open(src_path, 'rb') as f_src, \
         open(dst_path, 'wb') as f_dst, \
         tqdm(total=total_size, unit='B', unit_scale=True, unit_divisor=1024,
              desc=os.path.basename(src_path), miniters=1) as pbar:
        while True:
            chunk = f_src.read(chunk_size)
            if not chunk:
                break
            f_dst.write(chunk)
            pbar.update(len(chunk))
方式 B:流对象包装器模式与元数据完整保留
上述简单方式虽然实现了进度展示,但隐藏着一个在工程中容易被忽视的隐患:普通的 open('wb') 写入的文件是一个全新的文件,源文件的最后修改时间(mtime)、最后访问时间(atime)以及文件权限标志位(mode / flags)全部丢失了。而标准库 shutil.copy2 之所以被称为“更完善的复制”,正是因为它在数据传输完成后会执行 shutil.copystat(src, dst) 来同步这些元数据。
为了兼顾 tqdm 的优雅渲染与 shutil 的元数据完整性,更优雅的架构是采用装饰器/包装器模式(Wrapper Pattern):将源文件句柄包装为一个自定义类,在其 read() 方法被调用时自动触发进度递增,然后将这个包装对象直接传入 shutil.copyfileobj。传输完毕后,再显式调用 shutil.copystat()。
import os
import shutil
from tqdm import tqdm

class ProgressFileReader:
    """
    包装文件只读句柄,在读取操作发生时自动通知进度条组件
    """
    def __init__(self, file_obj, progress_bar):
        self._file = file_obj
        self._pbar = progress_bar

    def read(self, size=-1):
        data = self._file.read(size)
        if data:
            self._pbar.update(len(data))
        return data

    def __getattr__(self, attr):
        # 将其余所有未显式定义的方法直接代理到底层真实句柄
        return getattr(self._file, attr)

def copy_file_robust(src: str, dst: str, buffer_size: int = 2 * 1024 * 1024) -> None:
    """
    工业级大文件复制函数:带平滑进度条且完整保留源文件元数据。

    :param src: 源文件路径
    :param dst: 目标文件或目标目录路径
    :param buffer_size: 传输缓冲区字节数,推荐 2MB - 4MB
    """
    if not os.path.exists(src):
        raise FileNotFoundError(f"源文件不存在: {src}")

    # 如果目标是已存在的目录,则自动拼接文件名
    target_path = os.path.join(dst, os.path.basename(src)) if os.path.isdir(dst) else dst

    # 获取文件总大小作为进度条基准
    total_bytes = os.path.getsize(src)

    with open(src, 'rb') as f_src:
        with tqdm(total=total_bytes,
                  unit='B',
                  unit_scale=True,
                  unit_divisor=1024,
                  ncols=90,
                  desc=f"Copying {os.path.basename(src)}") as pbar:
            wrapped_src = ProgressFileReader(f_src, pbar)
            with open(target_path, 'wb') as f_dst:
                # 借助标准库底层分块复制驱动流包装器
                shutil.copyfileobj(wrapped_src, f_dst, length=buffer_size)

    # 关键步骤:同步文件修改时间、访问时间与权限标记,完全对齐 shutil.copy2
    shutil.copystat(src, target_path)
    print(f"复制完成,已同步元数据至: {target_path}")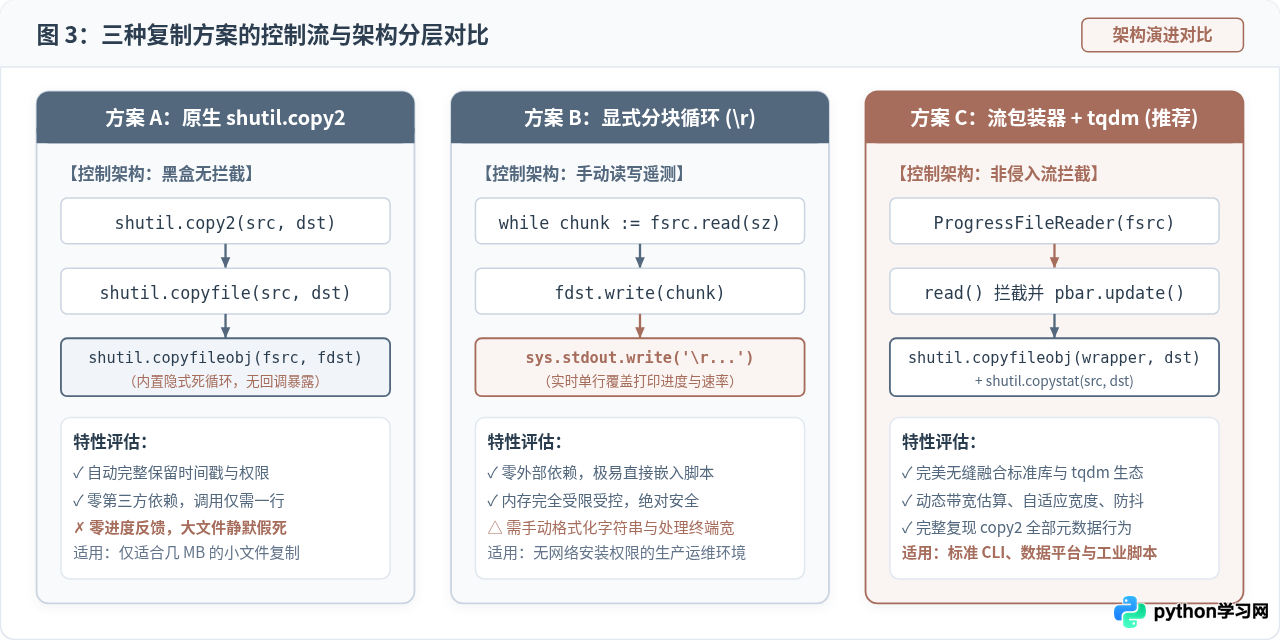
通过上图的架构演进对比可以清晰看出:从原生 shutil.copy2 的完全黑盒,到方案 B 的手工破坏式重构,再到方案 C 的流拦截设计。方案 C 在没有侵入破坏 shutil 底层读写优化的前提下,仅通过几十行代码便优雅地接入了实时遥测能力,同时继承了 copystat 的完整元数据维护机制。
四、性能调优与大文件复制的避坑细节
在实际生产环境中,复制数 GB 到数百 GB 的超大文件时,仅仅实现进度条展示是不够的。如果缓冲区选择不当,或者忽视了存储介质与文件系统特性,可能导致整体复制吞吐量大幅下滑,甚至引发数据一致性灾难。
1. 缓冲区大小(Buffer Size)的取舍平衡
有些开发者在编写分块循环时随意填入一个较小的数值,例如 4096(4KB)或 8192(8KB)。在现代操作系统中,每次执行 read() 或 write() 都伴随着一次从用户态(User Space)到内核态(Kernel Space)的系统调用(Syscall)。复制一个 10GB 的文件:
- 若使用 4KB 缓冲区:总计需要执行约 262 万次 系统调用,CPU 会花费大量时间在中断上下文切换上,且进度条若每块都触发计算,会导致控制台 I/O 成为严重的性能瓶颈,传输耗时成倍增加。
- 若使用 512MB 的超大缓冲区:虽然系统调用次数锐减,但单次读取在磁盘较慢时耗时较长,进度条会长时间停滞不动,然后突然暴跳一个大百分比,完全失去了实时反馈的意义。
- 推荐经验值:在本地 SATA/NVMe SSD 固态硬盘上,推荐设置 2MB ~ 4MB(即
2 * 1024 * 1024);在普通机械硬盘(HDD)或 USB 存储设备上,推荐 512KB ~ 1MB,既能保证磁盘连续顺序读取吞吐量,又能确保进度条每秒平滑刷新多次。
2. 复制中断导致的脏文件防御:临时文件与原子重命名
大文件传输耗时较长,如果在复制进行了 80% 时系统意外断电、网络挂载卷断开,或者用户按下了 Ctrl + C,目标路径下会留存一个体积不完整、内容损坏的残缺文件。如果后续自动化系统仅依靠“文件是否存在”来判断任务完成,就会读入破损的数据引发不可预料的严重故障。
工业级脚本的标准实践是:将数据首先写入 target_path + ".tmp" 临时文件中;在双句柄关闭且 copystat 校验完毕后,调用 os.replace(temp_path, target_path) 进行原子重命名(Atomic Rename)。在同一文件系统内,原子重命名只是修改元数据索引,耗时通常在微秒级别,从而彻底杜绝了半成品文件被上层业务误读的风险。
3. 磁盘剩余空间与特殊文件防御
在复制超大文件前,必须养成预先检查目标磁盘可用容量的习惯。通过 shutil.disk_usage(os.path.dirname(os.path.abspath(target_path))) 可以获取目标分区的可用字节数。如果源文件大小超过可用容量,应在打开文件之前直接抛出异常阻断,避免文件写满磁盘导致整个系统服务瘫痪。
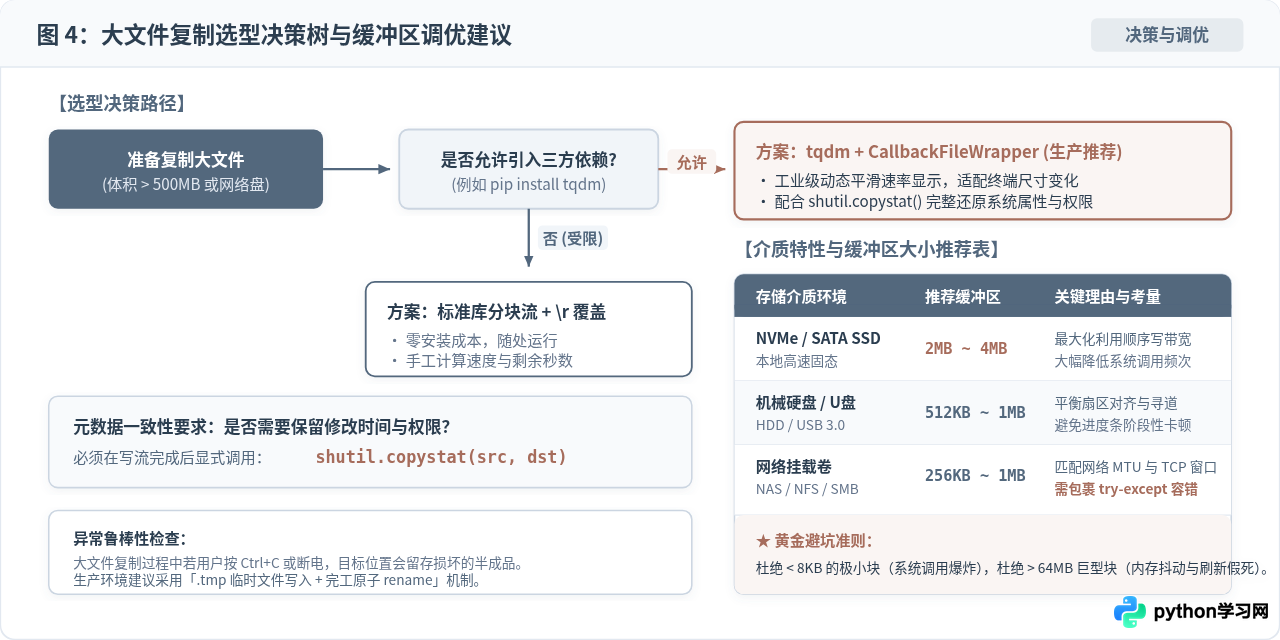
针对不同的运行环境与硬件约束,可以对照图 4 快速选型。对于常规脚本开发与数据处理任务,优先选用基于 tqdm 与流包装器的方案;而对于分发到极简运维容器或无外网环境中的轻量脚本,则直接采用标准库的 \r 单行刷新模式。
五、核心结论与快速参考
总结来说,Python 大文件复制时显示进度条的核心逻辑只有两点:把黑盒的整块传输拆分成受控的分块数据流,并在每次分块数据转移完毕后触发进度渲染。标准库没有提供该功能并非能力不足,而是为了保持底层接口的纯粹与正交性。
在具体选型上:
- 追求零依赖与绝对轻量,使用
sys.stdout.write('\r...')配合sys.stdout.flush(),重点关注回车符覆盖机制与收尾换行。 - 追求终端美观、动态平滑速率与单位智能转换,使用
tqdm包装文件流,兼顾shutil.copystat()保留元数据属性。 - 不论采用哪种形式,缓冲区大小建议稳定在 1MB 到 4MB 之间,避免极小块带来的系统调用暴增,也避免极大块造成的交互卡顿。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









