

Python列表基础教程:创建、索引与增删改查详解
全面详解Python列表的核心机制与实操方法,涵盖列表的底层结构、三种创建方式、正负索引与切片规则,以及append、extend、insert、remove、pop、del等增删改查操作的执行逻辑、时间复杂度与边界避坑指南。
一、列表的定义与多种创建方式
在 Python 底层实现(CPython)中,列表由 PyListObject 结构体定义,其内部维护着一段连续分配的引用地址数组。与静态数组不同,Python 列表是可变对象(Mutable),不仅支持就地修改,还能根据元素增减自动调整底层分配的内存容量。此外,列表中存放的是对象的内存指针,因此同一列表内可以混合容纳整数、字符串、浮点数甚至嵌套列表等任意类型。
1. 使用方括号字面量 []
方括号字面量是创建列表最直接、最常用的方式。无论声明空列表还是预填初始元素,Python 解释器在语法解析层面均对 [] 做了专门优化,其执行效率略高于调用内置构造器。
# 创建空列表与多类型元素列表
empty_list = []
numbers = [1, 2, 3, 4, 5]
mixed_list = [1024, "Python", 3.14, True, [1, 2]]
2. 使用 list() 工厂函数进行类型转换
内置函数 list([iterable]) 能够接收任意可迭代对象(如字符串、元组、集合、字典键或 range 生成器),并将其拆解重组为新列表。
# 将字符串与 range 区间转换为列表
char_list = list("Hello")
range_list = list(range(1, 6))

print(char_list)
print(range_list)3. 使用列表推导式(List Comprehension)
当需要基于某种算式或过滤条件快速生成列表时,推导式提供了紧凑高效的语法。推导式在 CPython 内部以优化过的循环指令运行,不仅语义明确,执行速度通常也优于普通的 for 循环配合 append()。
# 生成 0 到 9 中所有偶数的平方
even_squares = [x ** 2 for x in range(10) if x % 2 == 0]
print(even_squares)[[0] * 3] * 3。此方式仅复制了子列表的外部指针,导致修改其中一个子列表的元素时,所有行都会同步变动。正确的做法是使用列表推导式生成独立子列表:[[0] * 3 for _ in range(3)]。
二、元素访问:正向索引、负向索引与切片规则
列表是严格保证序列次序的有序集合。为了访问或提取局部元素,Python 提供了基于下标的索引访问与基于区间的切片语法。
1. 正向索引与负向索引
正向索引以下标 0 为起点,指向列表的第一个元素,最后一个有效元素下标为 len(list) - 1。与此同时,Python 原生支持负向索引,以下标 -1 表示最后一个元素,-2 表示倒数第二个元素,依此类推。负向索引本质上是解释器内部自动执行了 index + len(list) 的换算。
fruits = ["apple", "banana", "cherry", "date"]

print(fruits[0])   # 正向访问首个元素:apple
print(fruits[-1])  # 负向访问尾部元素:date
如果传入的索引绝对值超过了列表边界,Python 会抛出 IndexError: list index out of range 异常,这要求程序在按索引访问未经验证的位置时必须确保安全或捕获异常。
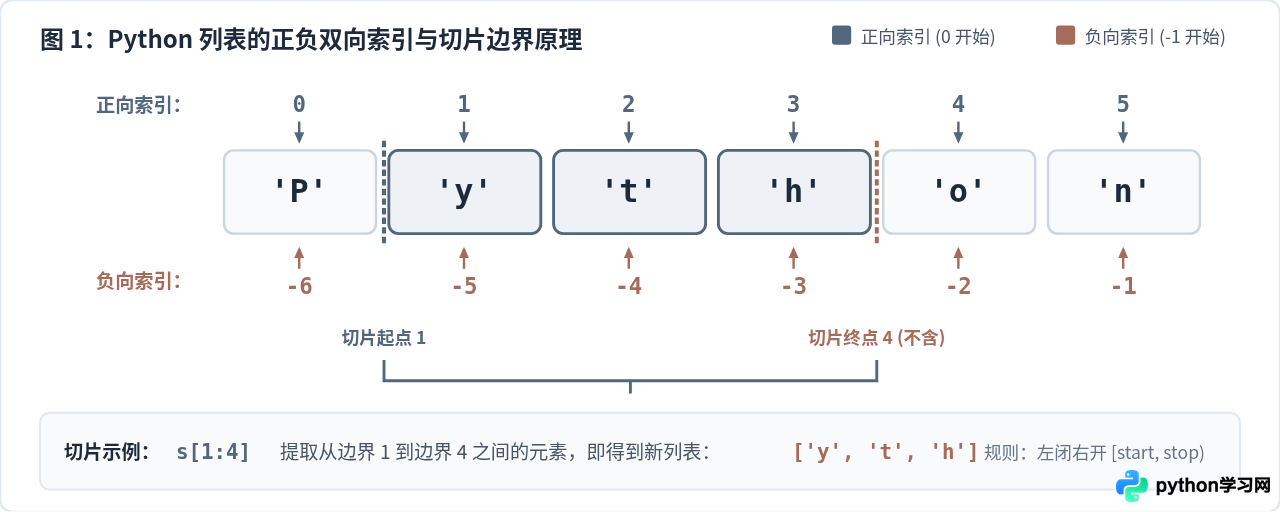
2. 步长切片:list[start:stop:step]
切片操作从列表中提取子序列并返回一个全新的列表。切片遵循“左闭右开”规则(数学区间表示为 [start, stop)),即结果包含 start 边界所在的元素,但不包含 stop 边界所在的元素。
- 默认省略:若省略
start,默认从序列头部开始;若省略stop,默认截取至序列末尾;若省略step,默认步长为1。 - 负步长与反转:当
step为负数时,切片将从右向左逆向提取。经典写法lst[::-1]能够以原生 C 循环效率生成当前列表的逆序副本。 - 切片越界容错:与单一索引不同,切片的上下界超出列表范围时不会抛出
IndexError,而是自动截断到列表的有效边界。
letters = ['a', 'b', 'c', 'd', 'e', 'f']

print(letters[1:4])    # 提取索引 1 到 3 的元素:['b', 'c', 'd']
print(letters[:3])     # 从头截取到索引 2:['a', 'b', 'c']
print(letters[::2])    # 隔项步长提取:['a', 'c', 'e']
print(letters[::-1])   # 快速倒序:['f', 'e', 'd', 'c', 'b', 'a']
print(letters[2:100])  # 超出右边界,自动截断:['c', 'd', 'e', 'f']
三、列表元素的新增:append、extend 与 insert 详解
向列表中追加或插入新元素有三种典型方法。它们的底层实现不同,对内存分配和元素位移的影响也存在显著区别。
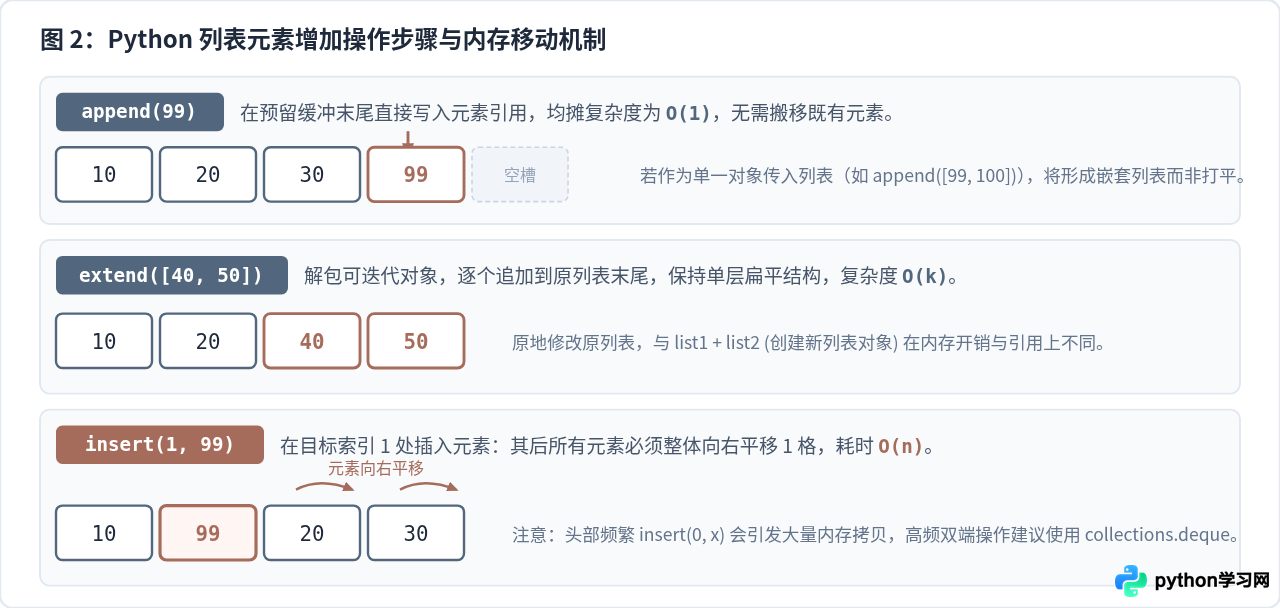
1. append(item):末尾追加单个元素
append() 将传入的单个对象直接附加到列表当前末尾。由于 Python 会为列表预留连续存储容量(Over-allocation 机制),大多数追加操作只需在末尾槽位写入指针即可完成,其平摊时间复杂度为 O(1)。
tasks = ["write", "test"]
tasks.append("deploy")
print(tasks)  # 结果:['write', 'test', 'deploy']

# 注意:若传入的是序列对象,append 会整体作为嵌套子项加入
tasks.append(["monitor", "report"])
print(tasks)  # 结果:['write', 'test', 'deploy', ['monitor', 'report']]
2. extend(iterable):解包合并多个元素
extend() 接收一个可迭代对象,并将其包含的元素逐个解包追加到目标列表末尾,始终保持列表的单层结构。在性能上,extend() 在 C 语言层完成循环批量扩容,比手动写 Python for 循环调用 append() 快得多。
base_nums = [1, 2]
base_nums.extend([3, 4])
print(base_nums)  # 原地修改为:[1, 2, 3, 4]

# 对比:使用 + 操作符会分配内存并返回全新列表对象
new_nums = base_nums + [5, 6]
3. insert(index, item):指定位置插入元素
insert(index, item) 将对象插入到指定下标位置。由于列表底层依赖物理连续地址,插入位置及其右侧的所有后续元素指针必须在内存中整体向右平移一个槽位。因此,insert() 的时间复杂度为 O(n)。
scores = [90, 80, 70]
scores.insert(1, 85)  # 在索引 1 处插入 85,80 和 70 依次右移
print(scores) # 结果:[90, 85, 80, 70]insert(0, val) 会强制搬动整个列表的每一个元素。若程序需要高频在头部入队或出队,应当改用标准库 collections.deque(双端队列),其首尾操作均为 O(1)。
四、列表元素的删除:del、pop、remove 与 clear 选用决策
针对不同的业务意图,Python 提供了按值清除、按索引弹出、按范围销毁以及全量重置四类删除操作。
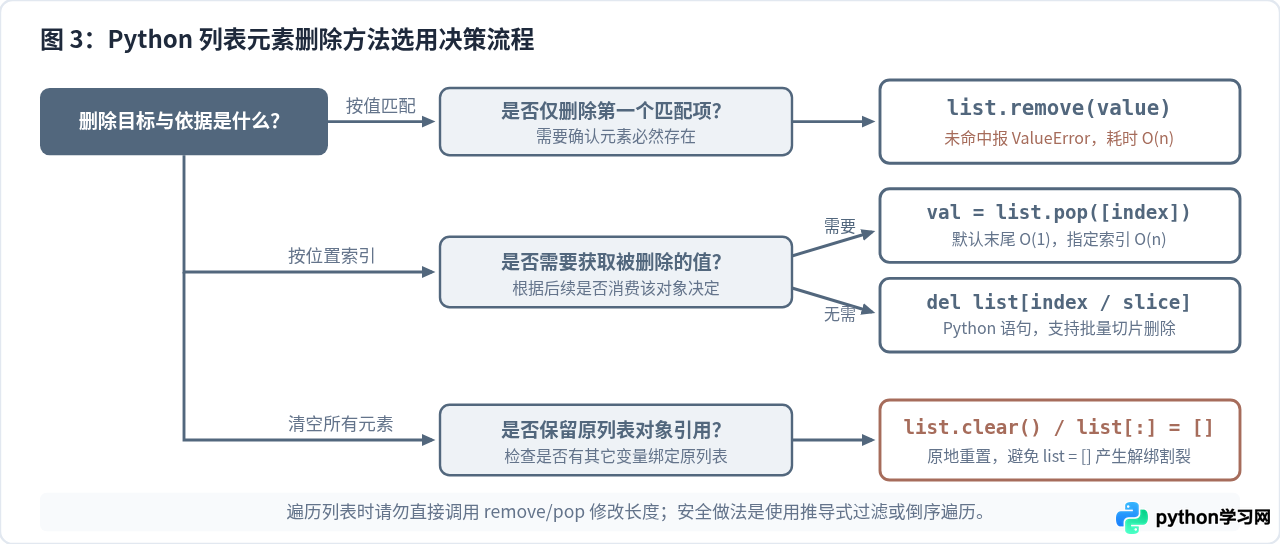
1. remove(value):按值删除首个匹配项
remove() 从左到右扫描列表,删除找到的第一个与目标值相等的元素,后续元素随之左移。需要注意:
- 如果列表中存在多个相同的值,
remove()只清除最左侧的那一个; - 若目标值在列表中不存在,直接调用会引发
ValueError: list.remove(x): x not in list。生产代码中通常需要先通过if val in lst守卫或者包裹try...except结构。
colors = ["red", "green", "blue", "green"]
colors.remove("green")
print(colors)  # 仅删除了首个 green,输出:['red', 'blue', 'green']
2. pop([index]):按索引移除并返回元素
pop() 既完成了元素的移出,又将该元素作为函数结果返回给调用方,非常适合用来实现栈或队列结构。
- 不传参数时,默认弹出最后一个元素
pop(-1),无需搬移前置元素,时间复杂度为最优的O(1); - 传入有效非负或负数索引(如
pop(0)),则弹出指定位置元素,右侧元素统一左移,时间复杂度为O(n); - 对空列表执行
pop()会抛出IndexError: pop from empty list。
stack = ["page1", "page2", "page3"]
current = stack.pop()  # 弹出末尾
print("弹出的页面:", current)
print("剩余栈状态:", stack)3. del 语句:按位置或切片批量销毁
del 是 Python 核心关键字,不属于列表的方法调用,因此不会产生任何返回值。它的优势在于支持直接结合切片语法进行批量区间删除。
items = [0, 1, 2, 3, 4, 5, 6, 7]

del items[0]      # 删除单个索引项
del items[2:5]    # 批量删除连续切片区间(索引 2, 3, 4)
print(items)      # 结果:[1, 2, 6, 7]
4. clear():原地清空列表
clear() 将列表长度重置为 0,并释放所持有的所有内部对象指针。与直接将变量赋值为空列表(items = [])相比,clear() 会保留当前列表对象在内存中的地址,所有共享该列表引用的其他变量都会感知到清空变化。
shared_list = [1, 2, 3]
alias_list = shared_list

shared_list.clear()
print("原变量:", shared_list)
print("共享变量:", alias_list) # 同样被原地清空五、列表元素的修改与查询检索
1. 单元素赋值与切片批量替换
修改单个元素只需对目标索引直接赋值,耗时为恒定的 O(1)。此外,Python 支持强大的切片赋值机制:你可以将列表的一个区间整体替换为另一个可迭代对象,且新内容的长度无需与被替换区间保持相等,列表会自动执行收缩或扩展。
data = [10, 20, 30, 40, 50]

# 单元素修改
data[0] = 99

# 切片替换:将索引 1 到 3 的两个元素替换为三个新元素
data[1:3] = [200, 250, 280]
print(data)  # 结果:[99, 200, 250, 280, 40, 50]
2. 成员存在性判断:in 与 not in
判断元素是否存在于列表中最地道的写法是使用 in 关键字。列表由于无哈希索引支持,必须从头至尾线性遍历所有元素,最坏时间复杂度为 O(n)。如果业务场景需要高频次、大体量地判断“某项是否存在”,应优先使用集合(set)或字典键(dict),后者的查找复杂度仅为 O(1)。
3. 检索索引与出现频次:index() 与 count()
index(x, [start, [stop]]):返回元素x在指定区间内首次出现的正向索引。若未找到,抛出ValueError。count(x):全量统计元素x在列表中出现的总次数。若未找到则返回0,不会报错。
grades = ["A", "B", "A", "C", "A"]

print(grades.count("A"))       # 输出:3
print(grades.index("B"))       # 输出:1
print(grades.index("A", 1))    # 从索引 1 开始向后查找,输出:2
六、常用操作特性总结与速查
为了方便在工程开发中根据业务规模选择恰当的列表操作,下表与图示全面汇总了各常用方法的语法、返回值、是否就地修改及时间复杂度特性。
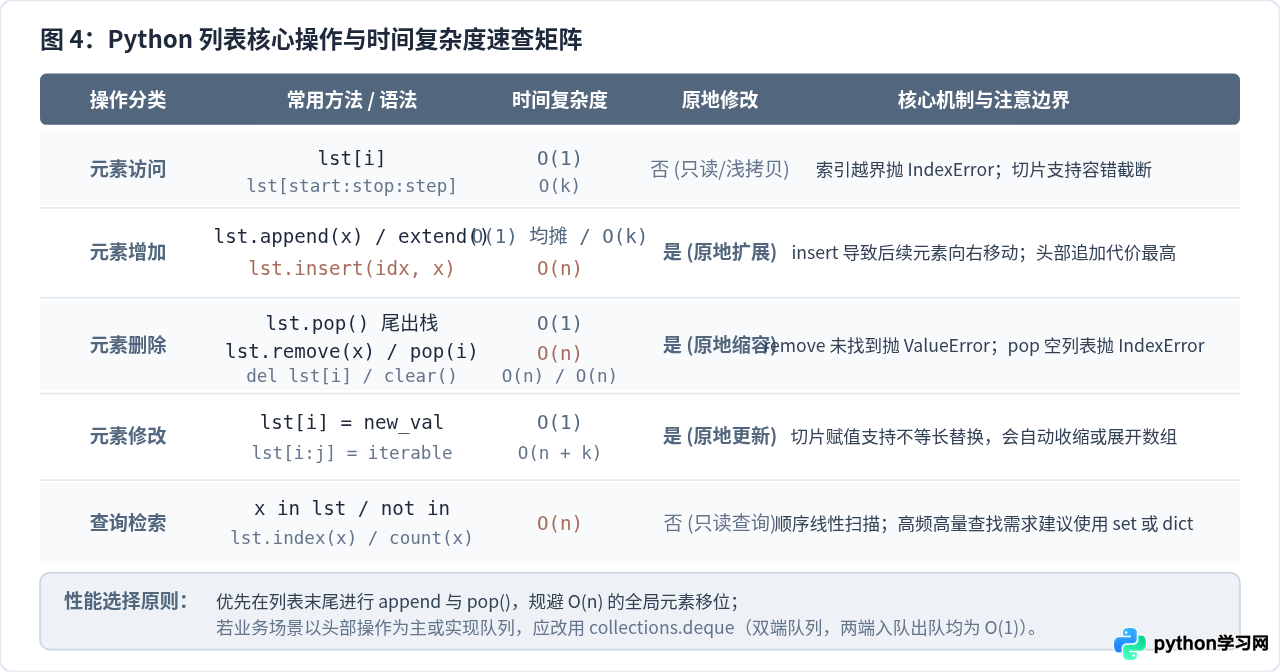
| 操作大类 | 语法 / 方法 | 时间复杂度 | 就地修改原对象 | 异常风险 / 注意事项 |
|---|---|---|---|---|
| 访问与切片 | lst[i] / lst[start:stop] |
O(1) / O(k) | 否(切片生成新列表) | 单索引超出范围抛 IndexError;切片自动截断 |
| 末尾追加 | lst.append(x) |
O(1) 均摊 | 是 | 若传入列表会整体作为嵌套项,不打平 |
| 批量扩展 | lst.extend(iterable) |
O(k) | 是 | 参数必须是可迭代对象,原地展开追加 |
| 任意插入 | lst.insert(index, x) |
O(n) | 是 | 触发后续所有元素向右物理位移;头部插入最慢 |
| 按值删除 | lst.remove(value) |
O(n) | 是 | 仅删除首个匹配项;未找到目标值抛 ValueError |
| 弹出提取 | lst.pop([index]) |
末尾 O(1) / 指定 O(n) | 是 | 返回被弹出元素;空列表或越界抛 IndexError |
| 切片删除 | del lst[i:j] |
O(n) | 是 | 语句执行无返回值,能高效批量擦除连续区间 |
| 全局清空 | lst.clear() |
O(n) | 是 | 保留原始对象内存引用,与 lst = [] 语义不同 |
| 检索统计 | lst.index(x) / lst.count(x) |
O(n) | 否 | index() 未找到抛异常;高频检索优先考虑 set |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









