

怎么配置Kafka ACK机制与幂等性以防止消息丢失和重复
详细讲解如何通过配置Kafka的acks确认机制、min.insync.replicas副本同步策略以及Producer幂等性参数enable.idempotence,解决生产端消息丢失与重试重复问题,并提供完整Java配置代码与命令行验证步骤。
在 Kafka 生产环境中防止消息丢失并消除网络重试带来的重复写入,核心做法是将 Producer 端的 acks 设为 all(或 -1)、开启 enable.idempotence=true,同时在 Broker 或 Topic 级别将副本因子 replication.factor 设为至少 3、最小同步副本数 min.insync.replicas 设为 2。单独修改客户端的 ACK 级别或只开启重试,往往会在节点宕机与网络抖动时按下葫芦浮起瓢:只管重试会导致消息重复,不配最小同步副本会让 acks=all 退化成单副本确认。下面按照配置生效的逻辑,从底层确认边界、参数组合方法到命令行验证逐一展开。
为什么改了 acks=all 还是可能丢消息
排查线上 Kafka 丢消息事故时,经常会看到一个让人困惑的现象:生产端明明已经把 acks 配置成了 all,但在某台 Broker 宿主机断电重启后,依然有几十条刚刚显示发送成功的消息在消费端彻底找不到了。翻看 Topic 的元数据才会发现,这个分区的 ISR(In-Sync Replicas,同步副本集合)在故障前一刻已经收缩到了只剩 Leader 自己。
acks 参数决定了 Producer 发送一条批次消息后,需要等待 Broker 返回什么程度的确认才算成功。当 acks=0 时,Producer 把数据塞进网络缓冲区就算完成,Broker 哪怕正在重启也感知不到;当 acks=1 时,只要分区 Leader 副本把消息写进本地磁盘 PageCache 就会立即回传确认,一旦 Leader 在 Follower 拉取这批数据前崩溃,新选出的 Leader 并不包含这条数据,消息就会静默丢失。
将 acks 设为 all(等价于 -1)确实要求 Leader 等待当前 ISR 列表中的所有副本都同步完成后再响应客户端。但这里藏着一个前提:如果所有 Follower 都因为网络延迟或磁盘繁忙被踢出了 ISR,ISR 列表里就只剩下 Leader 一个节点。此时 acks=all 在实际执行时就退化成了 acks=1,Leader 写入本地后照样直接返回成功,单点宕机丢数据的风险原封不动地回来了。
要堵住这个漏洞,必须在服务端配合设置 min.insync.replicas(通常设为 2)。这个参数规定了 ISR 集合至少要有多少个存活副本,Leader 才允许接收 acks=all 的写入请求。一旦 ISR 缩减到小于 2,Broker 会直接向 Producer 抛出 NotEnoughReplicasException 异常拒绝写入,宁可短暂阻断生产并触发客户端告警,也不向客户端返回虚假的“持久化成功”。
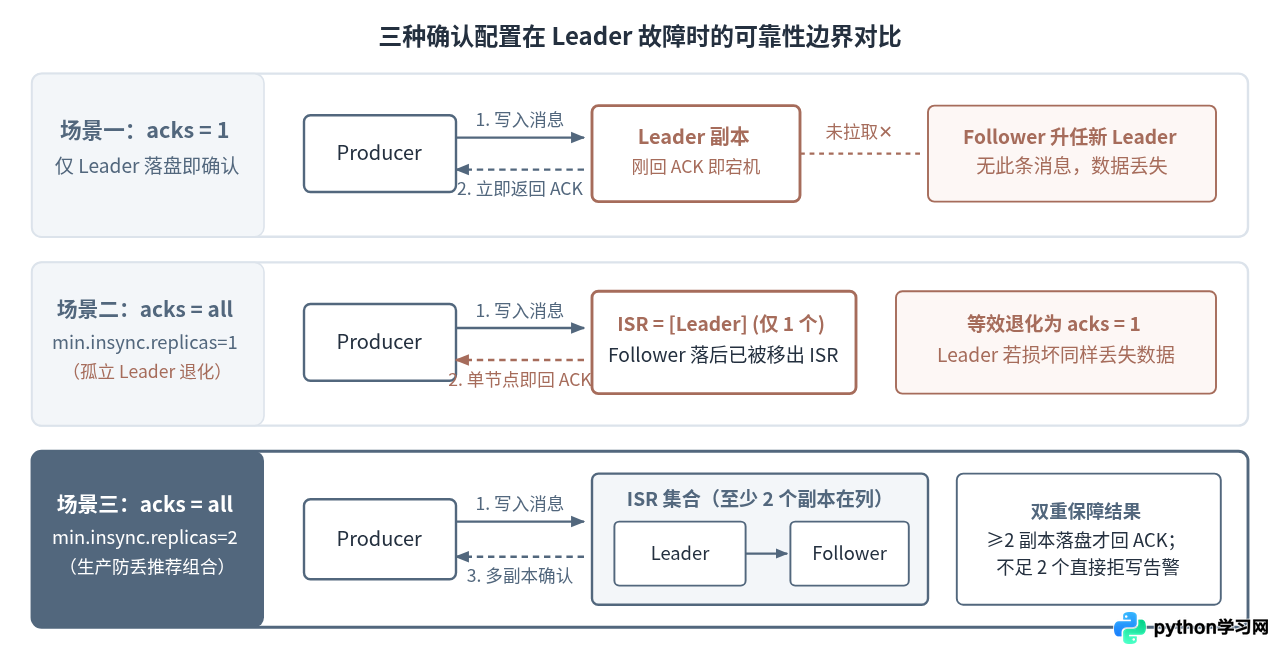
min.insync.replicas 组合下的消息持久化确认边界重试救回了丢失的消息,却引出了重复写入
配好 acks=all 和 min.insync.replicas=2 后,服务端不会再轻易弄丢已确认的数据。但在真实的机房网络里,瞬时丢包、Leader 切换或 Full GC 停顿随时会发生。如果 Producer 发送请求后不开启重试(retries=0),遇到一次毫秒级的网络抖动就会直接把异常抛给业务代码,这同样意味着消息在生产端丢失。
因此,防丢失必然要求开启自动重试。然而只要把 retries 设为大于 0 的值,另一个棘手的问题马上就会出现:假设 Leader 与 Follower 已经把消息成功写进了磁盘,但在 Leader 把 ACK 响应包发回给 Producer 的半路上,网络连接恰好闪断了。Producer 等待超过 request.timeout.ms 后认为发送失败,于是自动将同一批消息重新发送了一次。对 Broker 来说,如果你没有开启幂等性,它会把这次重试当成一条全新的消息追加到日志末尾,分配一个新的 Offset。消费端随后就会读到两条内容一模一样的消息。
为了在“开启重试”与“不产生重复数据”之间不再二选一,Kafka 自 0.11.0.0 版本起引入了生产端幂等性(Idempotence),只需设置 enable.idempotence=true 即可启用。它的底层机制并不复杂,核心是在每个消息批次(RecordBatch)的头部增加两个标识字段:
- PID(Producer ID):每个新的 Producer 实例在初始化时,都会向 Broker 申请一个全局唯一的、对业务透明的 64 位整数编号。
- Sequence Number(序列号):Producer 针对自己发往每一个目标分区的消息批次,在内存中维护一个从
0开始严格单调递增的整数序号,即按(PID, Topic-Partition)粒度独立计数。
Broker 端同样在内存中为每个分区维护了各个 PID 最近成功写入的序列号状态。当 Broker 收到一批消息时,会拿批次头部的序列号 $S_{\text{new}}$ 与本地已记录的最大序列号 $S_{\text{last}}$ 做比对:
- 如果 $S_{\text{new}} = S_{\text{last}} + 1$,说明是正常按序到达的新消息,Broker 正常写入日志并更新序号。
- 如果 $S_{\text{new}} \le S_{\text{last}}$,说明这批数据在之前已经成功落盘,只是当时的 ACK 丢失触发了客户端重发。Broker 不会再次落盘,而是直接向 Producer 补发一次成功确认,从而在存储层静默消除了重复数据。
- 如果 $S_{\text{new}} > S_{\text{last}} + 1$,说明中间有更早批次的消息尚未到达,Broker 会返回
OutOfOrderSequenceException。
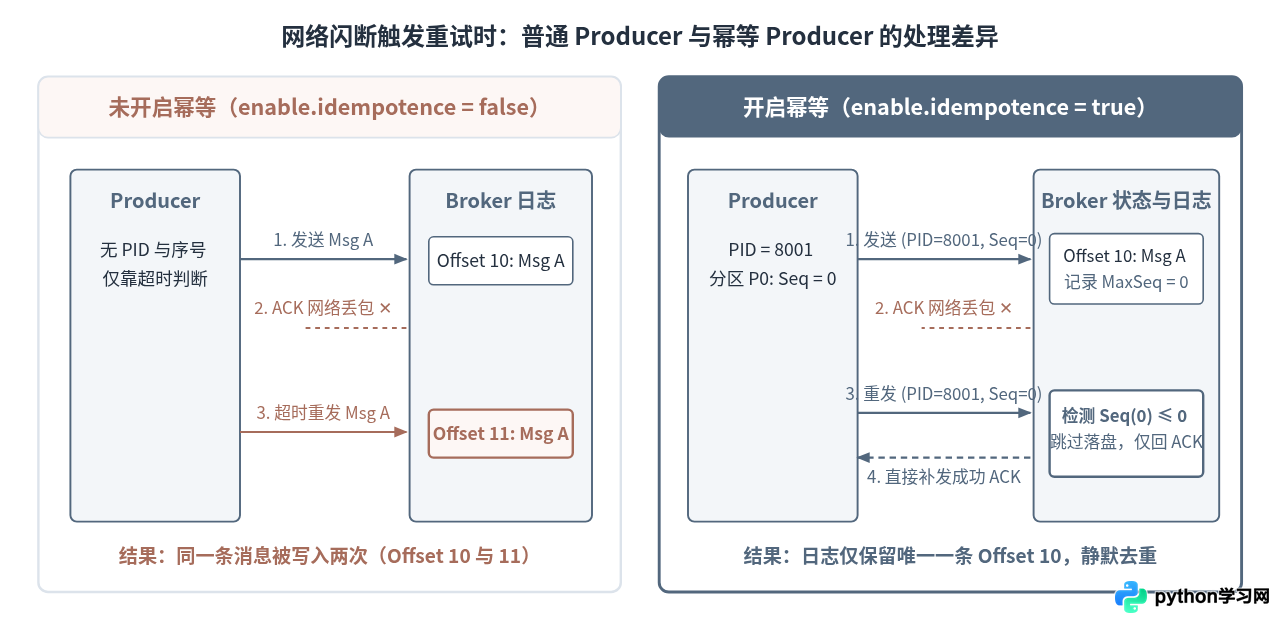
(PID, Partition, Sequence Number) 识别并丢弃重复重试批次为什么 max.in.flight.requests.per.connection 可以设为 5
不少早期的排查文章会强调,为了防止重试导致消息乱序,必须把 max.in.flight.requests.per.connection(单个连接上未收到响应的最大并发请求数)硬性压低为 1。但在开启了幂等性之后,这个限制已经放宽到了 5。
原因在于,当 enable.idempotence=true 且 max.in.flight.requests.per.connection 小于或等于 5 时,Broker 端会在内存中为每个生产者的每个分区缓存最近 5 个批次的元数据,并在客户端对失败批次进行重发时严格校验连续的 Sequence Number。如果第 1 批发送失败、紧随其后的第 2 批先到了 Broker,Broker 会发现第 2 批的序号跳跃,直接拒收第 2 批并触发客户端按序重发第 1 批和第 2 批。因此,将并发连接请求数保持在默认的 5,既能保留多批次流水线发送的高吞吐量,又不会破坏单分区内的消息顺序与幂等校验。
完整配置步骤:从 Topic 准备到 Producer 落地
要把上述机制真正落实到工程中,需要按顺序完成服务端 Topic 策略配置与客户端 Producer 参数配置。以下操作基于三节点及以上的 Kafka 集群环境(Kafka 2.x / 3.x / 4.x 均适用;需要注意从 Kafka 3.0.0 开始,acks=all 与 enable.idempotence=true 已成为官方客户端的默认值,但为了防止旧版客户端依赖或自定义配置覆盖,建议在代码中显式声明)。
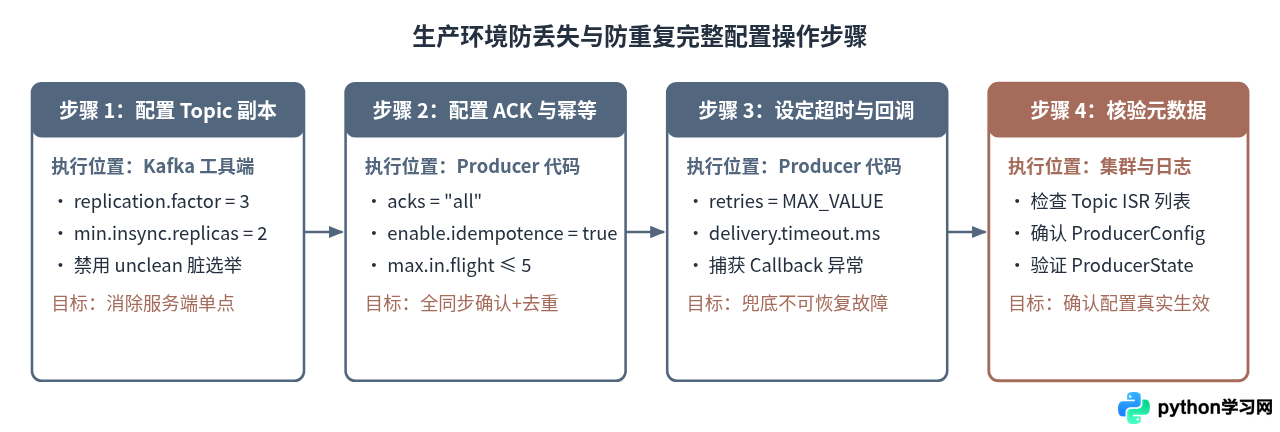
第一步:在服务端创建或修改 Topic 的副本与同步策略
登录安装有 Kafka 命令行工具的节点(假设 Broker 地址为 192.168.10.11:9092),创建名为 order-payment-events 的 Topic,将副本数设为 3,并将 min.insync.replicas 设为 2、禁用非同步副本参与 Leader 选举(unclean.leader.election.enable=false):
bin/kafka-topics.sh --bootstrap-server 192.168.10.11:9092 \
  --create \
  --topic order-payment-events \
  --partitions 3 \
  --replication-factor 3 \
  --config min.insync.replicas=2 \
  --config unclean.leader.election.enable=false
如果目标 Topic 已经在运行中,不需要重建 Topic,直接使用 kafka-configs.sh 动态更新配置即可,修改会立即在集群生效:
bin/kafka-configs.sh --bootstrap-server 192.168.10.11:9092 \
  --entity-type topics \
  --entity-name order-payment-events \
  --alter \
--add-config min.insync.replicas=2,unclean.leader.election.enable=false如果副本数为
3,同时把 min.insync.replicas 也设成 3,那么只要集群中有任意一台 Broker 做日常滚动重启或维护,该 Topic 的可用同步副本就会变为 2,导致所有 acks=all 的写入请求全部报错停摆。生产环境通用准则是:replication.factor = 3 搭配 min.insync.replicas = 2,既保证数据至少写入两台物理机,又允许集群容忍单节点下线维护。
第二步:编写开启 ACK 与幂等性的 Java Producer
在客户端工程(以下示例使用标准的 org.apache.kafka:kafka-clients 依赖)中,必须保证幂等性的四个关联参数互不冲突。如果在开启 enable.idempotence=true 的同时,在配置中心里误将 acks 写成了 1,或者把 retries 写成了 0,Producer 在启动阶段就会直接抛出 ConfigException 并拒绝初始化。
创建 ReliableOrderProducer.java,完整配置与异步回调异常处理如下:
package com.example.kafka;

import org.apache.kafka.clients.producer.Callback;
import org.apache.kafka.clients.producer.KafkaProducer;
import org.apache.kafka.clients.producer.ProducerConfig;
import org.apache.kafka.clients.producer.ProducerRecord;
import org.apache.kafka.clients.producer.RecordMetadata;
import org.apache.kafka.common.serialization.StringSerializer;

import java.util.Properties;
import java.util.concurrent.Future;

public class ReliableOrderProducer {

    public static void main(String[] args) {
        Properties props = new Properties();
        props.put(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG, "192.168.10.11:9092,192.168.10.12:9092,192.168.10.13:9092");
        props.put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG, StringSerializer.class.getName());
        props.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG, StringSerializer.class.getName());

        // 1. 要求 ISR 集合内所有副本全部同步成功后才返回确认
        props.put(ProducerConfig.ACKS_CONFIG, "all");

        // 2. 开启生产端幂等性(分配 PID 并启用单分区递增 Sequence Number)
        props.put(ProducerConfig.ENABLE_IDEMPOTENCE_CONFIG, "true");

        // 3. 单连接最大未确认请求数,开启幂等时须 <= 5,保持 5 可兼顾吞吐量与严格保序
        props.put(ProducerConfig.MAX_IN_FLIGHT_REQUESTS_PER_CONNECTION, 5);

        // 4. 重试次数设为整型最大值,实际重试上限由 delivery.timeout.ms 控制
        props.put(ProducerConfig.RETRIES_CONFIG, Integer.MAX_VALUE);

        // 5. 单次网络请求超时时间(30秒)与总交付超时时间(120秒)
        props.put(ProducerConfig.REQUEST_TIMEOUT_MS_CONFIG, 30000);
        props.put(ProducerConfig.DELIVERY_TIMEOUT_MS_CONFIG, 120000);

        try (KafkaProducer<String, String> producer = new KafkaProducer<>(props)) {
            String topic = "order-payment-events";
            String orderKey = "ORD-20261104-0089";
            String payload = "{\"orderId\":\"ORD-20261104-0089\",\"amount\":199.00,\"status\":\"PAID\"}";

            // 务必指定业务主键作为 Record Key,确保同一订单始终路由到固定分区
            ProducerRecord<String, String> record = new ProducerRecord<>(topic, orderKey, payload);

            Future<RecordMetadata> future = producer.send(record, new Callback() {
                @Override
                public void onCompletion(RecordMetadata metadata, Exception exception) {
                    if (exception == null) {
                        System.out.printf("发送成功: topic=%s, partition=%d, offset=%d%n",
                                metadata.topic(), metadata.partition(), metadata.offset());
                    } else {
                        // 当超过 delivery.timeout.ms(120秒)仍未恢复,或出现不可重试异常时触发
                        System.err.printf("消息最终投递失败,需落盘本地补偿表: key=%s, 原因=%s%n",
                                orderKey, exception.getMessage());
                    }
                }
            });

            // 示例中等待异步结果完成再关闭 Producer
            future.get();
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}
在上面的代码里,有两处细节直接关系到实际运行效果:
第一是超时控制方式。把 retries 设为 Integer.MAX_VALUE 并不意味着线程会永远卡死,真正决定重试总时长上限的是 delivery.timeout.ms(默认 120000 毫秒,即 2 分钟)。一条消息从写入本地缓冲区(send 调用返回)开始计时,只要在 120 秒内因为网络抖动或 Leader 重选失败,客户端都会自动带着相同的 PID 和 Sequence Number 重试;一旦超过 120 秒集群仍未恢复,Callback 就会收到 TimeoutException,此时应由业务代码将该消息写入本地数据库或死信补偿表。
第二是必须为 ProducerRecord 传入具有业务唯一性的 Key(如订单号 orderKey)。因为 Kafka 的幂等性序列号是按分区独立维护的,如果发送时不传 Key,采用黏性分区器(Sticky Partitioner)虽然在单次重试内目标分区不变,但如果业务上因为上游超时重新调用了一次发送方法,不带 Key 的消息可能会被路由到另一个分区,即便后续引入消费端校验也会增加乱序排查难度。
第三步:在 Spring Boot 项目中的等效配置
如果项目使用 spring-kafka,可以在 application.yml 中配置相同的参数组合,无需手写底层 Properties:
spring:
  kafka:
    bootstrap-servers: 192.168.10.11:9092,192.168.10.12:9092,192.168.10.13:9092
    producer:
      key-serializer: org.apache.kafka.common.serialization.StringSerializer
      value-serializer: org.apache.kafka.common.serialization.StringSerializer
      acks: all
      retries: 2147483647
      properties:
        enable.idempotence: true
        max.in.flight.requests.per.connection: 5
        request.timeout.ms: 30000
        delivery.timeout.ms: 120000
如何验证配置已经真实生效
写完配置后不能只看程序没有报错,可以通过以下两个步骤分别确认服务端 Topic 规则和生产端幂等状态是否到位。
1. 检查 Topic 的副本分布与动态参数
使用 kafka-topics.sh --describe 查看 order-payment-events 的详情:
bin/kafka-topics.sh --bootstrap-server 192.168.10.11:9092 \
  --describe \
--topic order-payment-eventsTopic: order-payment-events TopicId: k9xL2mPqR8vT1nZyW4bJcA PartitionCount: 3 ReplicationFactor: 3 Configs: min.insync.replicas=2,unclean.leader.election.enable=false
Topic: order-payment-events Partition: 0 Leader: 1 Replicas: 1,2,3 Isr: 1,2,3
Topic: order-payment-events Partition: 1 Leader: 2 Replicas: 2,3,1 Isr: 2,3,1
Topic: order-payment-events Partition: 2 Leader: 3 Replicas: 3,1,2 Isr: 3,1,2重点核对第一行末尾的 Configs 是否包含 min.insync.replicas=2,unclean.leader.election.enable=false,以及下方每个分区的 Isr 列表节点数量是否不少于 2 个。
2. 检查客户端日志与 Broker 端的幂等快照
运行 ReliableOrderProducer 时,Kafka 客户端会在启动日志的 ProducerConfig values 块中打印最终生效的参数。确认日志中同时出现 acks = -1(all 在内部会被规范化为 -1)和 enable.idempotence = true。
当消息发送成功后,还可以使用 Kafka 自带的 kafka-dump-log.sh 查看对应分区底层日志段的批次头信息(假设 Broker 数据目录为 /var/lib/kafka/data):
bin/kafka-dump-log.sh \
  --files /var/lib/kafka/data/order-payment-events-0/00000000000000000000.log \
--print-data-log | head -n 5Dumping /var/lib/kafka/data/order-payment-events-0/00000000000000000000.log
Log starting offset: 0
baseOffset: 0 lastOffset: 0 count: 1 baseSequence: 0 lastSequence: 0 producerId: 8001 producerEpoch: 0 partitionLeaderEpoch: 0 isTransactional: false isControl: false
| offset: 0 CreateTime: 1793780697102 keySize: 17 valueSize: 56 sequence: 0 headerKeys: [] key: ORD-20261104-0089 payload: {"orderId":"ORD-20261104-0089","amount":199.00,"status":"PAID"}只要在输出的 baseOffset 行看到 producerId 是一个正整数(如示例中的 8001,未开启幂等时该值为 -1),且 baseSequence 从 0 开始递增,就证明幂等机制已经在底层日志中正常工作。
容易踩坑的边界问题与排查方法
即使严格按照上述步骤完成了配置,在实际运行中仍有两个与标题直接相关的边界问题需要提前心里有数。
1. 为什么开了 enable.idempotence=true 还是出现了重复消息?
幂等性有两条明确的生效边界:单会话(Single Session)和单分区(Single Partition)。
- 应用重启会导致 PID 变化(跨会话失效):默认幂等 Producer 的
PID是在每次实例启动时向 Broker 临时申请的。如果业务服务正在发送一批消息,Broker 已经落盘,但业务容器恰好在这时因为 OOM 或发版重启,新启动的 Producer 实例会拿到一个全新的PID。此时业务层如果通过定时任务把刚才未收到响应的订单重新发一遍,由于PID已经不同,Broker 会将其视为新消息写入。 - 业务代码层面的主动重发(非客户端内部重试):
Sequence Number绑定在单次producer.send()生成的批次上。如果业务代码捕获异常后,自己又调用了一次producer.send(new ProducerRecord(...)),这在客户端看来是一条全新的消息,会被分配为下一个递增序号(例如Seq=1),Broker 自然不会拦截。
如果需要跨越应用重启保持幂等,或者需要把“消费上游消息—处理—发送下游消息”绑成一个原子操作,单纯靠 enable.idempotence=true 是不够的,需要在此基础上进一步为 Producer 配置固定的 transactional.id(开启 Kafka 事务),同时在消费端结合数据库的唯一索引(如以 orderId 作为唯一键)或 Redis 状态机做业务幂等兜底。
2. 偶发 OutOfOrderSequenceException 或 UnknownProducerIdException 怎么处理?
当生产流量极低(例如某个分区连续几天没有任何数据写入),且之前的日志段因为达到保留时间(retention.ms)被 Broker 清理删除后,Broker 内存中缓存的该 PID 元数据也会随之过期淘汰。如果此时该长连接 Producer 突然再次发送序号大于 0 的批次,Broker 可能会报错。在较新的 Kafka 客户端版本中,遇到此类状态丢失时会自动重置序列号或递增 epoch 恢复;如果在旧版客户端中捕获到该异常,安全的修复方式是在回调中记录日志并重建 KafkaProducer 实例。
| 配置参数 | 所属端 | 推荐配置值 | 解决的核心问题与作用边界 |
|---|---|---|---|
acks |
Producer | all(或 -1) |
要求 ISR 列表内全部副本写入成功后才确认,防止 Leader 单点崩溃丢数据。 |
min.insync.replicas |
Broker / Topic | 2(配合 3 副本) |
防止 ISR 收缩到仅剩 Leader 1 个节点时 acks=all 退化为单副本确认。 |
unclean.leader.election.enable |
Broker / Topic | false |
禁止落后于原 Leader 的非 ISR 副本被选为新 Leader,防止脏选举截断已确认数据。 |
enable.idempotence |
Producer | true |
为单分区批次附加 PID 与递增 Seq,使 Broker 自动丢弃网络重试导致的重复批次。 |
max.in.flight.requests.per.connection |
Producer | <= 5(推荐 5) |
在保留多批次并发流水线吞吐量的同时,由服务端缓存最近 5 批次序号以严格保序。 |
delivery.timeout.ms |
Producer | 120000(按业务调优) |
配合 retries=MAX_VALUE 设定包含所有重试在内的总交付时间上限,超时触发补偿。 |
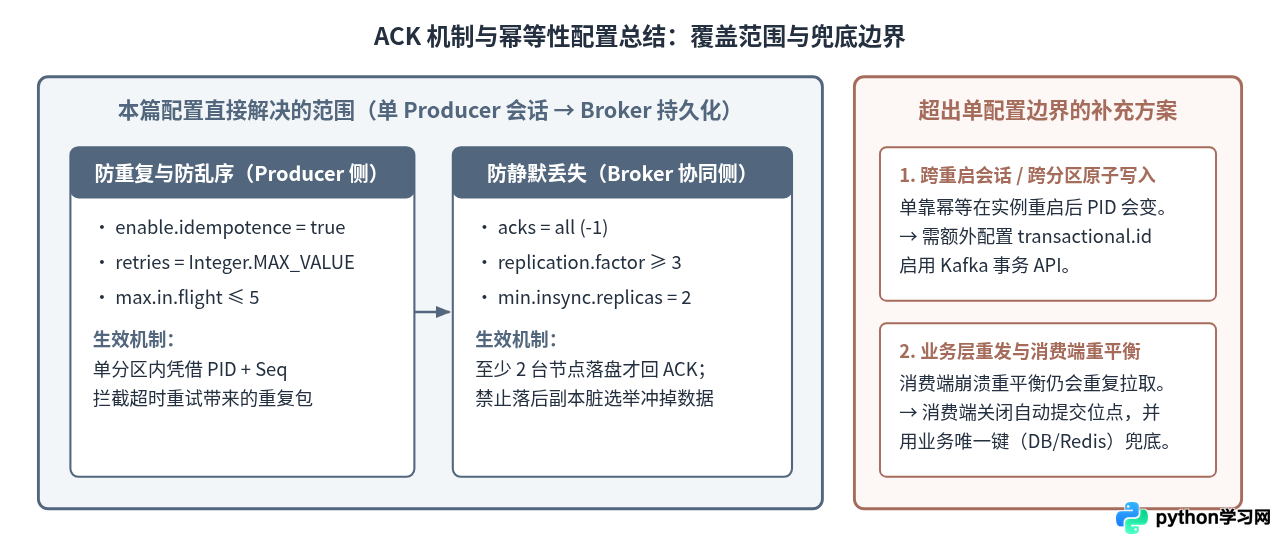
总结起来,配置 Kafka 防止生产端消息丢失与重复,不能只盯着客户端的某一个开关。先在 Topic 上用 replication.factor=3 与 min.insync.replicas=2 锁住服务端的多副本底线,再在 Producer 端启用 acks=all 与 enable.idempotence=true 配合超时回调,就能用很小的性能代价彻底解决网络抖动与单机故障引发的丢数和重发问题。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









