

Python zipfile解压中文乱码修复与完整解压实现

发布时间:2026-10-15| 7人浏览过
本文解决Python标准库zipfile解压含中文文件名压缩包时出现的乱码问题。通过自定义编码修正函数,结合shutil与os模块,实现复杂zip文件的完整解压,确保目录结构和文件内容完好无损。
Python zipfile中文文件名乱码问题
直接来看问题。在使用 Python 的标准库 zipfile 解压 zip 格式压缩包时,如果压缩文件内的目录或文件名包含中文等常见 unicode 字符,经常会遇到解压异常。例如以下情况:
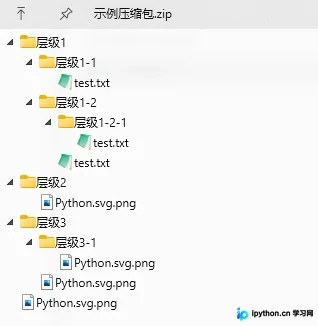
当直接调用 zipfile 的 extract() 或 extractall() 方法进行解压时,生成的解压结果文件名会出现乱码。通过调用 namelist() 方法查看压缩包内容,可以清晰地观察到这一现象:
乱码现象分析
from zipfile import ZipFile

# 读入压缩包文件
file = ZipFile('示例压缩包.zip')

# 查看压缩包内目录、文件名称
file.namelist()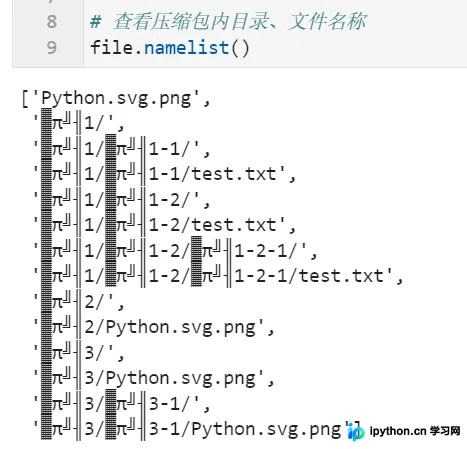
这是由于 zipfile 库对压缩包内容的编码兼容性较差导致的。我们可以通过以下函数对文件名进行编码修正:
编码修正函数实现
def recode(raw: str) -> str:
    '''
    编码修正
    '''

    try:
        return raw.encode('cp437').decode('gbk')

    except:
        return raw.encode('utf-8').decode('utf-8')

for file_or_path in file.namelist():

    print(file_or_path, ' -------> ' , recode(file_or_path))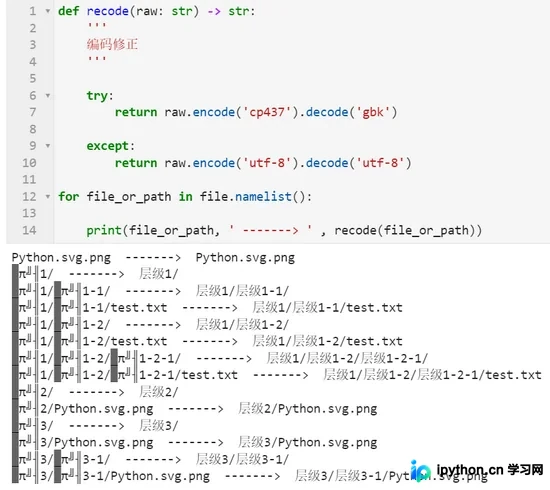
解决了文件名乱码问题后,结合 shutil 和 os 标准库的相关功能,即可实现将任意指定的 zip 压缩包完整解压到目标目录。具体代码如下:
完整解压代码实现
def zip_extract_all(src_zip_file: ZipFile, target_path: str) -> None:

    # 遍历压缩包内所有内容
    for file_or_path in file.namelist():

        # 若当前节点是文件夹
        if file_or_path.endswith('/'):
            try:
                # 基于当前文件夹节点创建多层文件夹
                os.makedirs(os.path.join(target_path, recode(file_or_path)))
            except FileExistsError:
                # 若已存在则跳过创建过程
                pass

        # 否则视作文件进行写出
        else:
            # 利用shutil.copyfileobj,从压缩包io流中提取目标文件内容写出到目标路径
            with open(os.path.join(target_path, recode(file_or_path)), 'wb') as z:
                # 这里基于Zipfile.open()提取文件内容时需要使用原始的乱码文件名
                shutil.copyfileobj(src_zip_file.open(file_or_path), z)

# 向已存在的指定文件夹完整解压当前读入的zip文件
zip_extract_all(file, '解压测试')
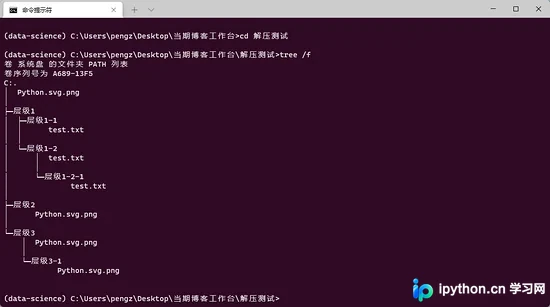
运行结果如下,效果完美:
至此,关于Python处理复杂zip文件解压的文章介绍完毕。如需了解更多Python zip文件解压相关内容,可搜索本站往期文章或继续阅读后续文章。感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









