

Python变量名中单下划线与双下划线的区别
深入解析Python中单下划线与双下划线的核心区别,全面涵盖前导单下划线、末尾单下划线、双前导下划线名称修饰机制、前后双下划线魔术方法与独立单下划线的具体语法行为与最佳实践。
public、private),而是一套融合了开发者编程约定与解释器特定行为的命名机制。单下划线主要作为一种语义提示,用于表达内部私有属性、避免关键字命名冲突或充当临时占位符;而双前导下划线则会触发 Python 解释器的“名称修饰(Name Mangling)”机制,从字节码层面重写变量名,防止子类在继承过程中产生属性冲突。
一、Python 下划线命名的五种常见形式
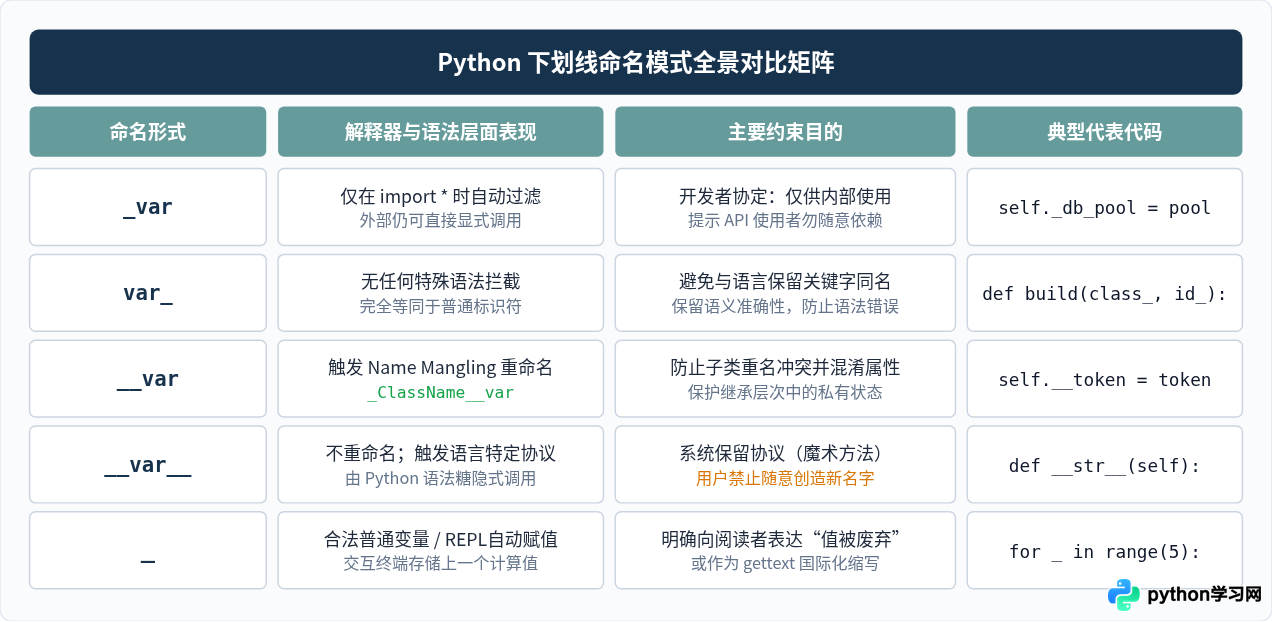
很多初学者容易将所有包含下划线的变量混为一谈。实际上,根据下划线出现的位置(前缀、后缀、独立)以及数量(单、双),Python 解释器与标准库对其赋予了截然不同的解释方式。我们首先将它们归纳为五种核心形态:
| 命名模式 | 代表示例 | 主要作用机制 | 核心应用场景 |
|---|---|---|---|
| 单前导下划线 | _internal_val |
约定弱私有;在 from module import * 时被自动过滤 |
模块内部函数、类内部不推荐外部直接调用的属性 |
| 单末尾下划线 | class_, id_ |
纯语义约定,不改变解释器行为 | 避免变量名与 Python 保留关键字发生冲突 |
| 双前导下划线 | __private_data |
解释器触发名称修饰(Name Mangling) | 基类中需要防止被子类意外覆写覆盖的关键属性 |
| 前后双下划线 | __init__, __len__ |
Python 语言保留的魔术方法/特殊属性协议 | 实现类的运算符重载、上下文管理或反射协议 |
| 单独立下划线 | _ |
语法上为合法标识符;交互环境中表示上一条表达式结果 | 解包时忽略无用值、多语言国际化函数标识 _() |
二、单下划线:约定、防冲突与占位
单下划线在 Python 中扮演了三种角色,它们各自服务于不同的工程场景:
1. 前导单下划线 _var:弱内部约定与导入隔离
根据 Python PEP 8 规范,以单个下划线开头的变量或函数(如 _internal_func()、self._cache)表示该成员是内部私有实现,不属于公共 API 的一部分。外部调用者应该意识到:这个变量可能在后续版本中随时被修改或移除。
需要强调的是,在面向对象的类中,前导单下划线不会阻止外部访问。实例对象依然可以通过 obj._cache 直接读取和修改属性。唯一由解释器强制生效的逻辑出现在模块通配符导入(Wildcard Import)时:
# my_module.py
public_value = "公开内容"
_private_value = "内部内容"

def public_action():
    return "已执行"

def _internal_helper():
    return "辅助计算"
在另一个文件中导入测试:
# 场景 A:使用通配符导入
from my_module import *

print(public_value)      # 正常输出:公开内容
# print(_private_value)  # 报错:NameError: name '_private_value' is not defined

# 场景 B:使用精确名称导入或模块名导入
import my_module
from my_module import _private_value

print(my_module._private_value)  # 正常输出:内部内容
print(_private_value)            # 正常输出:内部内容
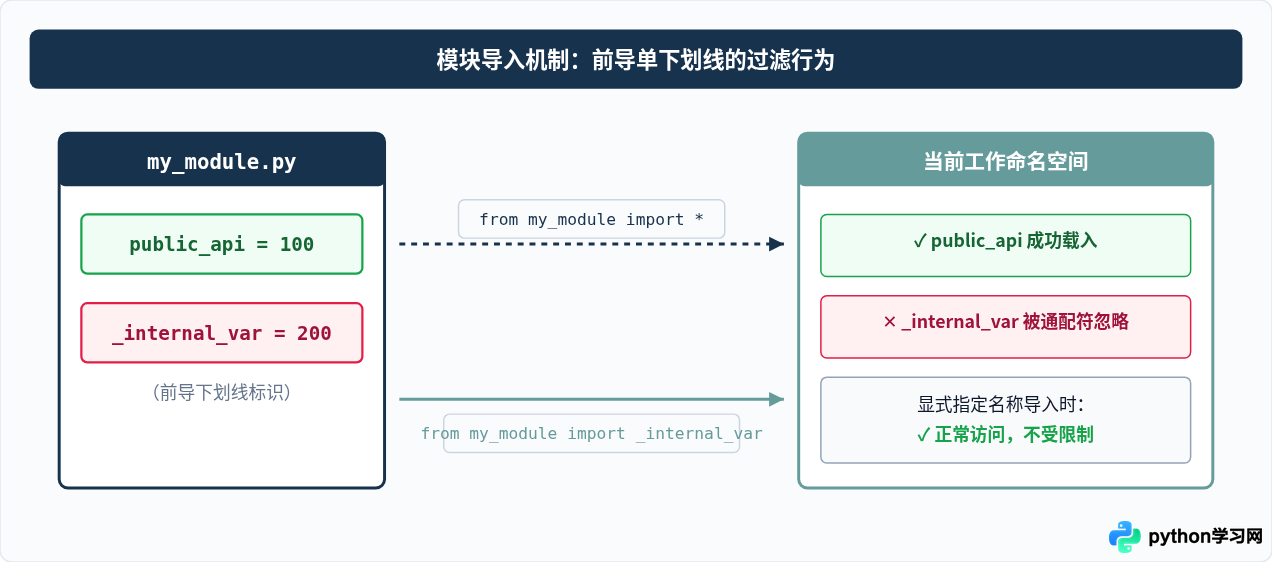
__all__ = ['_private_value'],则通配符导入将完全遵循 __all__ 列表的内容,即使变量带单前导下划线也会被强制导出。
2. 末尾单下划线 var_:解决关键字同名冲突
当你的业务逻辑中恰好需要使用 Python 保留关键字(例如 class、def、in、from、type)作为变量名、参数名或字段名时,直接使用会导致语法错误 SyntaxError。此时,PEP 8 推荐在词尾追加一个单下划线:
# 示例:Web 框架中接收 HTML 属性或数据库列名
def create_element(tag_name, class_=None, id_=None):
    params = {"tag": tag_name}
    if class_:
        params["class"] = class_
    if id_:
        params["id"] = id_
    return params

# 避免为了躲避关键字而采用糟糕的拼写,如 klass 或 my_class
element = create_element("div", class_="container", id_="main-header")
3. 单个独立下划线 _:临时弃用与交互式上一结果
单独立下划线 _ 在 Python 中有两个核心用途:
- 忽略不关心的值(解包与循环):向代码维护者传达“该值在当前上下文中无需使用”。例如循环计数
for _ in range(10),或者元组解包name, _, age = ("Alice", "Engineer", 30)。 - 交互式 REPL 的上一运算结果:在 Python 终端解释器中,
_会自动保存上一条表达式的返回值,方便连续链式计算。
三、双下划线:名称修饰与特殊协议
与单下划线大多基于约定不同,双下划线涉及 Python 运行时的硬性重构行为和语言内置协议。
1. 双前导下划线 __var:名称修饰(Name Mangling)
很多开发者误将 __var 视作“私有变量保护”。实际上,当 Python 解析包含至少两个前导下划线且至多一个末尾下划线的属性(如 __spam)时,解释器会在编译阶段自动将其重写为:_类名__属性名(例如 _SampleClass__spam)。
名称修饰的设计初衷是:在面向对象的继承体系中,防止父类的属性被子类同名属性无意中覆盖,保障父类内部方法的稳定性。
class BaseService:
    def __init__(self):
        self.__service_id = "BASE-1001"   # 修饰为 _BaseService__service_id
        self._readable_name = "Base"

    def get_service_id(self):
        return self.__service_id

class ExtendedService(BaseService):
    def __init__(self):
        super().__init__()
        self.__service_id = "EXT-2002"    # 修饰为 _ExtendedService__service_id

service = ExtendedService()

# 验证两个同名属性的真实共存情况
print("Base 方法返回:", service.get_service_id())  # 输出 BASE-1001(父类方法访问的是父类修饰名)
print("实例命名空间:", service.__dict__)
# 输出示例:
# {'_BaseService__service_id': 'BASE-1001', '_readable_name': 'Base', '_ExtendedService__service_id': 'EXT-2002'}
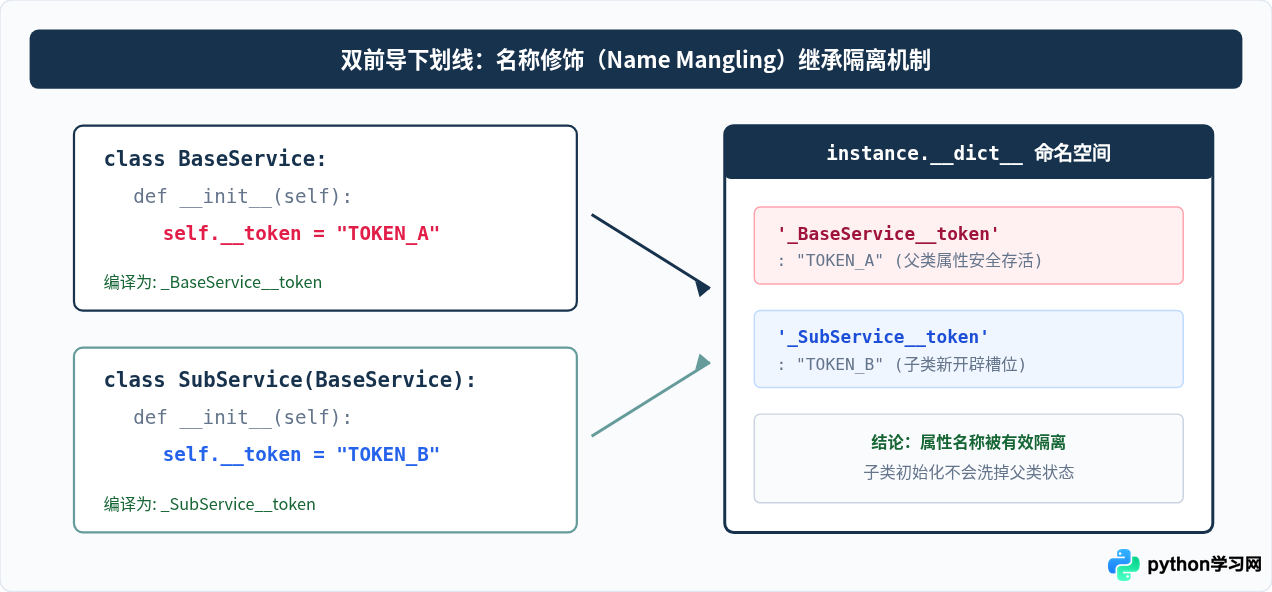
如果外部直接调用 service.__service_id,会触发 AttributeError,因为该名字在对象内部已经不存在了。但这并不是安全意义上的私有化,因为外部依然可以通过 service._BaseService__service_id 强行读写它。
2. 前后双下划线 __var__:魔术方法(Dunder)
形如 __init__、__str__、__call__ 的标识符通常被称为“魔术方法(Magic Methods)”或“双下划线方法(Dunder Methods)”。它们是 Python 语言核心协议的接口约定,负责将常规语法行为分发到底层实现。
__my_custom_var__ 这样前后都带双下划线的属性名称。Python 核心开发团队保留未来添加任何此类名字的绝对权力,自定义此类名称极易在未来 Python 大版本升级时发生冲突。
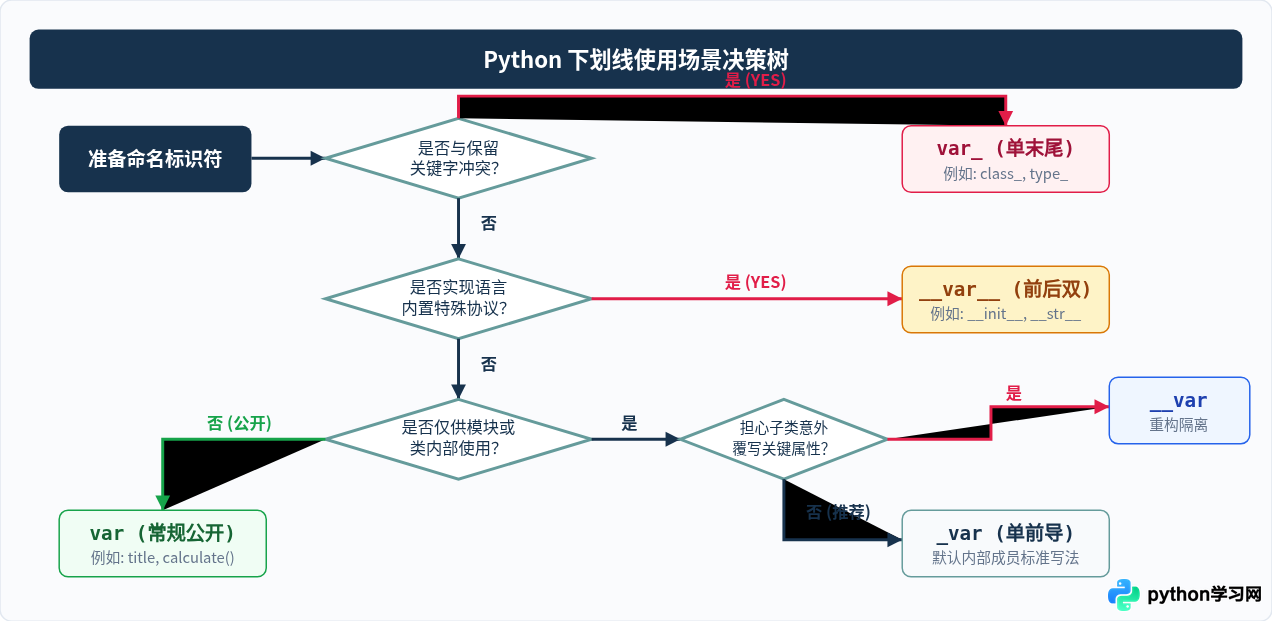
四、单下划线与双下划线的选型决策树
在日常开发与类设计中,面对变量与方法的命名选择,可以通过以下清晰的决策路径进行判断:
五、核心误区与实践建议
- 不要用双下划线当作伪安全防护:很多习惯了其他语言的初学者会给所有私有属性加上
__,以为这样可以彻底“隐藏”数据。然而在 Python 中,这只会给调试、单元测试和热修补(Monkey Patching)带来不必要的复杂性。对于 95% 以上的私有场景,单前导下划线_var就已经完全足够。 - 名称修饰只在类定义体中生效:在模块顶层直接定义全局变量
__global_var = 1,解释器不会对其进行名称修饰,它依然只是一个名为__global_var的普通全局变量。 - 永远不要发明双下划线方法:除非你在自定义 Python 协议扩展并且十分确定自己在做什么,否则请把
__dunder__命名空间留给 Python 官方。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









