

Python搜索元素不存在时怎么避免ValueError报错

index() 或字符串的 index() 等方法查找特定元素时,一旦目标元素在容器中不存在,解释器就会抛出 ValueError 异常并中断程序执行。要彻底避免该异常造成的崩溃,最核心的解决方案包括:使用 in 关键字进行前置成员检查(LBYL 风格)、使用 try...except ValueError 结构捕获异常并实施兜底(EAFP 风格)、针对字符串优先选用返回 -1 的 find() 方法,以及利用字典的 get() 或生成器的 next(..., default)。本文将系统阐述其产生机理与具体实现方案。
一、为什么搜索不存在的元素会触发 ValueError?
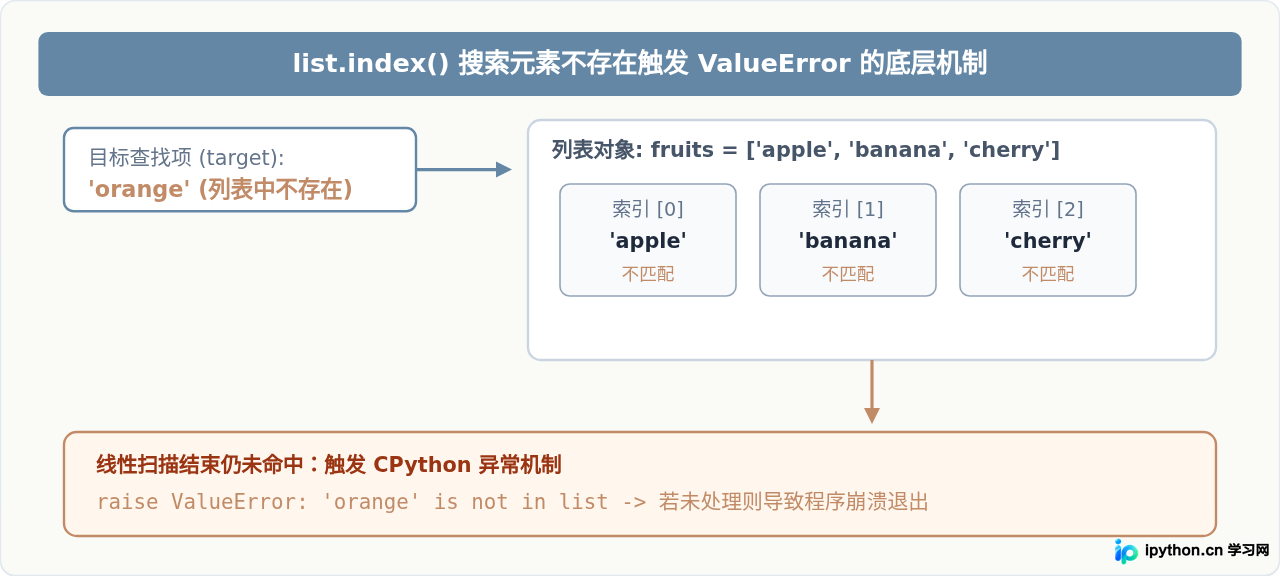
在 Python 的内置容器中,列表(list)、元组(tuple)和字符串(str)均提供了 .index() 方法,用于定位目标元素在容器中首次出现的索引下标。然而,许多初学者经常会遇到如下报错场景:
fruits = ['apple', 'banana', 'cherry']

# 试图检索一个不存在于列表中的水果
target = 'orange'
pos = fruits.index(target)
# 执行将中断并抛出:
# ValueError: 'orange' is not in list
这一报错源于 CPython 底层对序列查找的严格设计。底层实现中,解释器会从索引 0 开始向后逐一比对元素。当线性扫描到达序列末尾依然未命中目标时,CPython 并不像 C 语言或 JavaScript 中的 indexOf 那样返回 -1,而是直接触发 ValueError。
这种设计背后的原因非常明确:在 Python 中,负整数索引具有明确且合法的语义,fruits[-1] 代表访问列表的最后一个元素(即 'cherry')。如果 .index() 在未找到元素时静默返回 -1,后续若直接将返回值用于切片或取值,就会误操作末尾元素,造成极难排查的逻辑静默错误。因此,Python 强制采用抛出异常的形式,促使开发者必须显式处理边界情况。
二、避免报错的两大主流解决方式
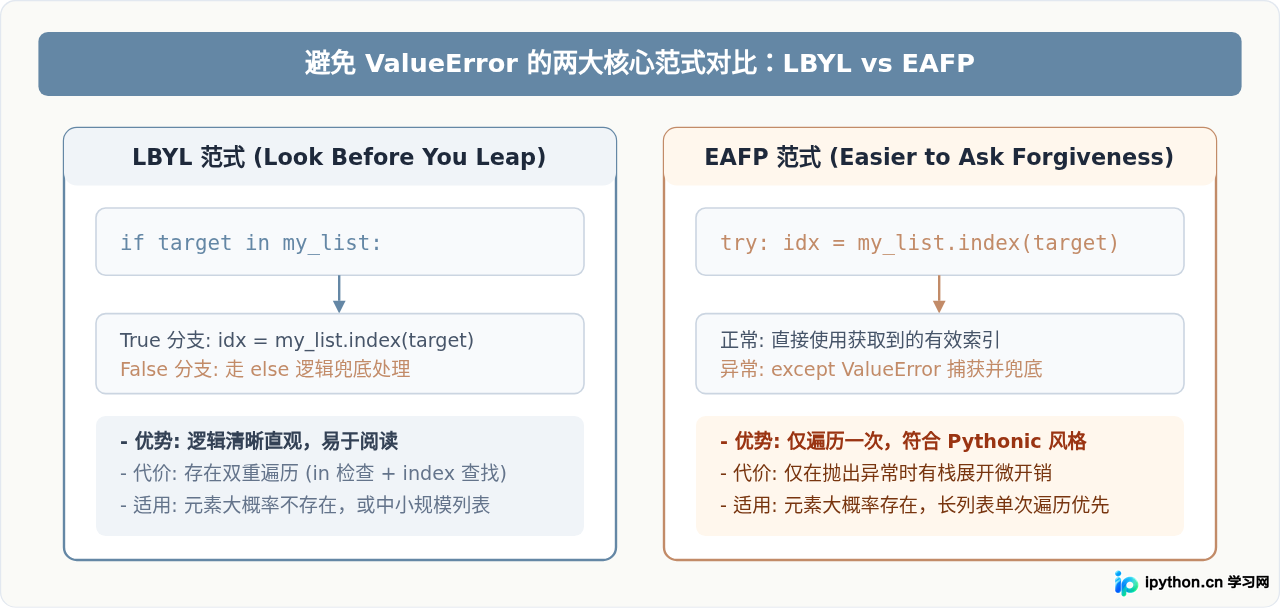
在实际开发中,处理该问题的两大核心路径分别对应 Python 社区的两种经典编程哲学:LBYL(Look Before You Leap,三思而后行)与 EAFP(Easier to Ask for Forgiveness than Permission,先斩后奏)。
1. 使用 in 关键字进行成员预检查(LBYL 风格)
最符合常规思维的方式是在调用 index() 之前,先使用 in 运算符确认目标是否存在于序列中:
fruits = ['apple', 'banana', 'cherry']
target = 'orange'

# 先检查是否存在
if target in fruits:
    pos = fruits.index(target)
    print(f"找到元素 {target},位于索引: {pos}")
else:
    pos = None  # 或者设定为 -1、提供默认处理
    print(f"元素 {target} 不在列表中,执行安全兜底逻辑")
适用场景与注意事项:这种写法结构清晰、语义直观,尤其适用于“目标元素大概率不在列表中”或者需要对存在与缺失走不同分支流程的业务场景。但需要注意性能特征:对于列表容器,target in fruits 本身是一次 \(O(n)\) 的线性搜索,紧随其后的 fruits.index(target) 又是另一次 \(O(n)\) 搜索。如果列表元素规模极大且目标频繁存在,相当于做了两次完整的线性遍历。
2. 使用 try...except 捕获 ValueError(EAFP 风格)
Python 官方极为推崇 EAFP 范式,即假设操作能够顺利完成,直接调用方法,并在抛出异常时精准捕获并妥善处置:
fruits = ['apple', 'banana', 'cherry']
target = 'orange'

try:
    pos = fruits.index(target)
    print(f"找到元素 {target},位于索引: {pos}")
except ValueError:
    pos = -1  # 显式设定未命中标记
print(f"未捕获到元素 {target},已平稳完成兜底")适用场景与优势:这种写法在目标元素大概率存在于容器中时性能最优,因为只需进行单次 \(O(n)\) 扫描。同时,它具备良好的健壮性,能够避免在多线程环境下因成员检查与索引获取之间的数据变动所引发的竞态条件。
三、不同数据结构与复杂查找场景的替代方案
除了通用的列表与元组之外,在不同容器类型或复杂查找条件下,Python 提供了多种原生工具,从根源上避免 ValueError 的发生。
1. 字符串搜索:使用 str.find() 代替 str.index()
在字符串中搜索子串时,str.find() 是最推荐的方案。与列表不同,字符串拥有专门的 find() 方法,在子串不存在时主动返回 -1 而绝不抛出 ValueError:
content = "Hello, Python World"

# 使用 find() 安全查找
idx = content.find("Java")
if idx != -1:
    print(f"找到子串,起始下标为: {idx}")
else:
print("未匹配到子串(find 返回 -1,程序未崩溃)")str.find() 属于字符串独有的方法,列表(list)并不具备该接口。在列表上调用 fruits.find(...) 会触发 AttributeError,切勿混淆。
2. 生成器与推导式:配合 next() 提供默认值
如果需要在列表中根据某种复杂条件查找匹配项,或者希望在单次遍历中兼顾索引获取与默认值兜底,可以使用内置函数 next():
fruits = ['apple', 'banana', 'cherry']
target = 'orange'

# 使用 enumerate 生成器,并在无匹配时指定默认返回值 -1
pos = next((i for i, v in enumerate(fruits) if v == target), -1)
print(f"查找结果: {pos}")  # 输出: -1,完全无需 try-except
这种写法仅进行单次惰性迭代,一旦找到目标就会立刻停止扫描,未找到则直接返回指定的默认值,代码紧凑且极其安全。
3. 字典与映射:使用 dict.get()
虽然字典按键查找失败时抛出的是 KeyError 而非 ValueError,但其避免思路完全一致。应尽量避免使用 d[key] 的直接下表索引,改用 d.get(key, default),在键缺失时平滑返回预设默认值。
四、避免 ValueError 报错的 4 步排查与重构流程
对于已存在项目中频发 ValueError 报错的代码段,可以依照以下标准化四步法进行审查与重构:
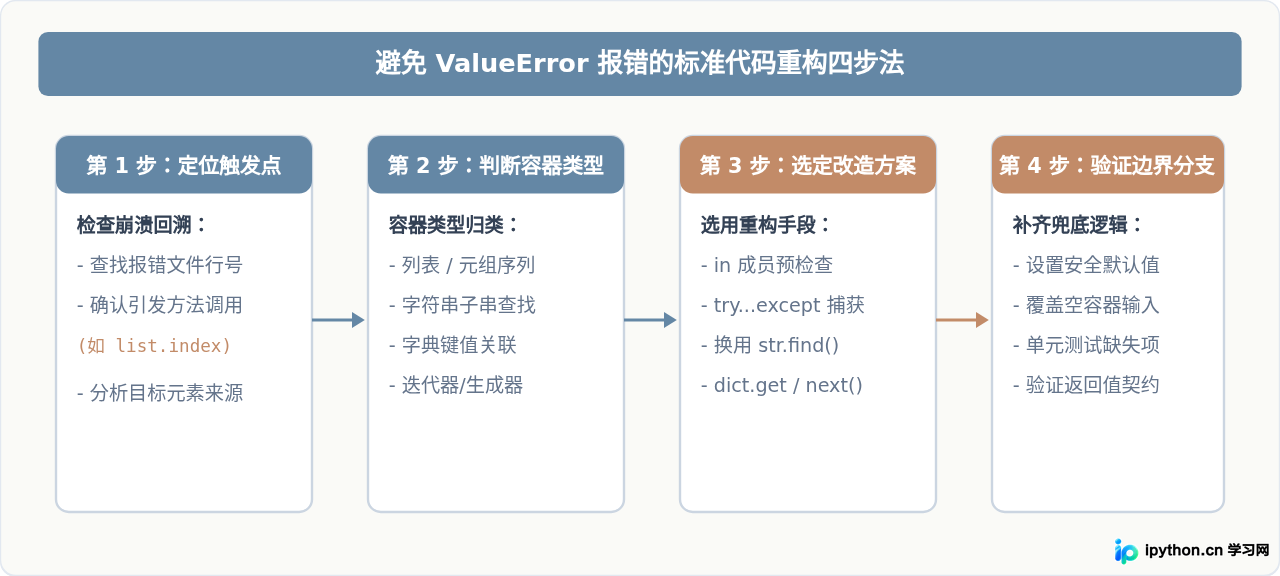
- 定位触发点:检查报错的 Traceback 栈追踪信息,锁定引发异常的文件行号,确认是哪一个序列在调用
.index()时发生崩溃。 - 识别数据结构:辨析当前操作的数据类型是列表、元组、字符串还是其他迭代对象,明确数据规模以及目标存在的概率。
- 选定适配方案:如果是字符串,无条件优先换用
.find();如果是列表且元素常在,采用try...except包装;若业务逻辑需明确分支,则采用in预检。 - 补齐兜底与验证测试:在异常或缺失分支中提供合法的默认值,编写单元测试覆盖“空列表输入”、“目标元素位于首尾”、“目标元素缺失”等边界用例,确保业务连续性。
五、核心方案对比与总结
为了帮助开发者在不同业务场景中做出最合适的选择,下表对各类防报错方案的核心指标进行了横向对比:
| 方案分类 | 适用对象 | 时间复杂度 | 核心优势 | 推荐使用场景 |
|---|---|---|---|---|
if target in lst: |
列表 / 元组 | \(O(n)\) 到 \(2 \times O(n)\) | 语法直观,逻辑分支清晰 | 目标元素大概率缺失的中小规模列表 |
try...except ValueError: |
列表 / 元组 | \(O(n)\) | 单次遍历,符合 Pythonic 规范 | 目标元素大概率存在的生产核心查找 |
str.find(sub) |
仅限字符串 (str) | \(O(n)\) | 原生返回 -1,免去异常处理机制 | 所有纯文本子串位置检索 |
next((...), default) |
任意迭代器 / 列表 | \(O(n)\)(惰性单次) | 支持复杂断言过滤,自动带兜底值 | 基于对象属性或条件的动态搜索 |
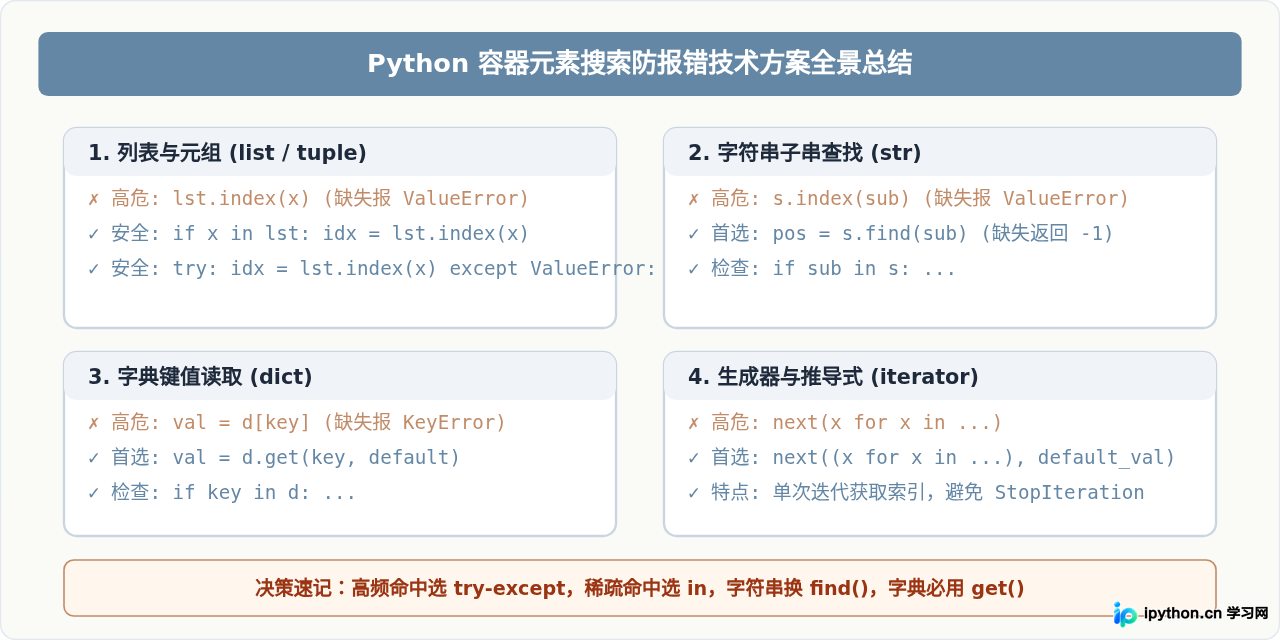
总结而言,Python 搜索元素不存在时报 ValueError 并不是语言缺陷,而是为了杜绝负索引静默取错的故意设计。在实际工程中,只需根据业务场景与数据容器类型,灵活运用 in 预检、try...except 异常拦截或 find() 等替代接口,即可在保证代码可读性与执行效率的同时,彻底消除该报错风险。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









