

Python嵌套列表怎么进行多维切片操作

在处理网格数据、棋盘布局或表格转换时,Python 开发者经常会使用“列表的列表”(List of Lists)来表示二维结构。然而,初学者尝试用 matrix[0:2, 1:3] 进行多维切片时,程序会立即报错并中断。Python 原生列表是一维容器,无法直接识别多维逗号索引;在纯标准库环境下,最清晰可靠的多维切片方案是结合外层切片与列表推导式:[row[col_slice] for row in matrix[row_slice]]。如果数据规模庞大且涉及密集的矩阵计算,则应转换为 NumPy 数组来获取原生的多维切片能力。本文将拆解原生嵌套列表多维切片的实现逻辑、常见陷阱与技术选型。
一、为什么原生嵌套列表不能直接多维切片
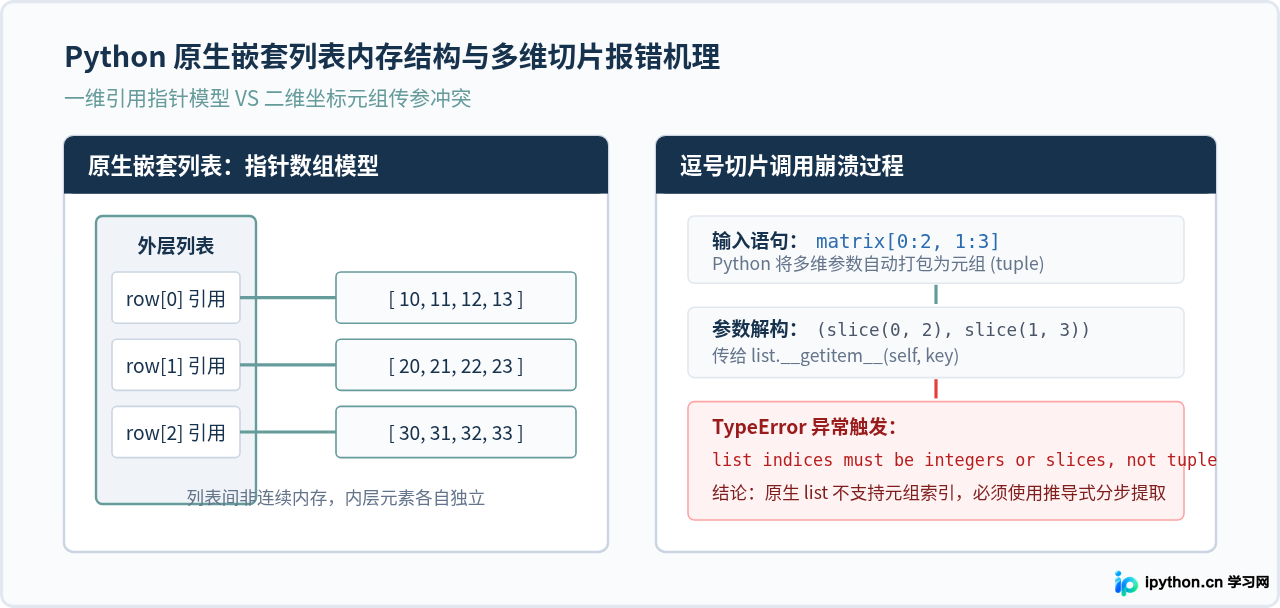
要掌握正确的切片方式,先要理解原生语法的限制所在。在 Python 中,逗号分隔的切片表达式属于元组(tuple)语法。例如,当你书写 matrix[0:2, 1:3] 时,解释器实际上将其翻译为 matrix.__getitem__((slice(0, 2), slice(1, 3)))。传入的参数不是两个单独的切片,而是一个包含两个切片对象的单一元组。
原生 list 的底层数据模型仅支持一维整数索引或单一 slice 对象,其内部并未定义针对元组索引的二维寻址逻辑,因此会直接抛出明确的异常:
# 错误示例
matrix = [
    [10, 11, 12, 13],
    [20, 21, 22, 23],
    [30, 31, 32, 33]
]

# 试图直接进行二维切片
try:
    sub = matrix[0:2, 1:3]
except TypeError as err:
    print(f"报错类型: {err}")
    # 输出: 报错类型: list indices must be integers or slices, not tuple
从内存布局来看,Python 的嵌套列表并不是一块连续的二维矩阵内存,而是一个保存了多个独立列表对象引用地址的指针数组。外层列表只负责管理行对象的指针,它无法直接透传切片指令去截取每个内层列表中的特定字段。
二、原生嵌套列表进行多维切片的核心操作步骤
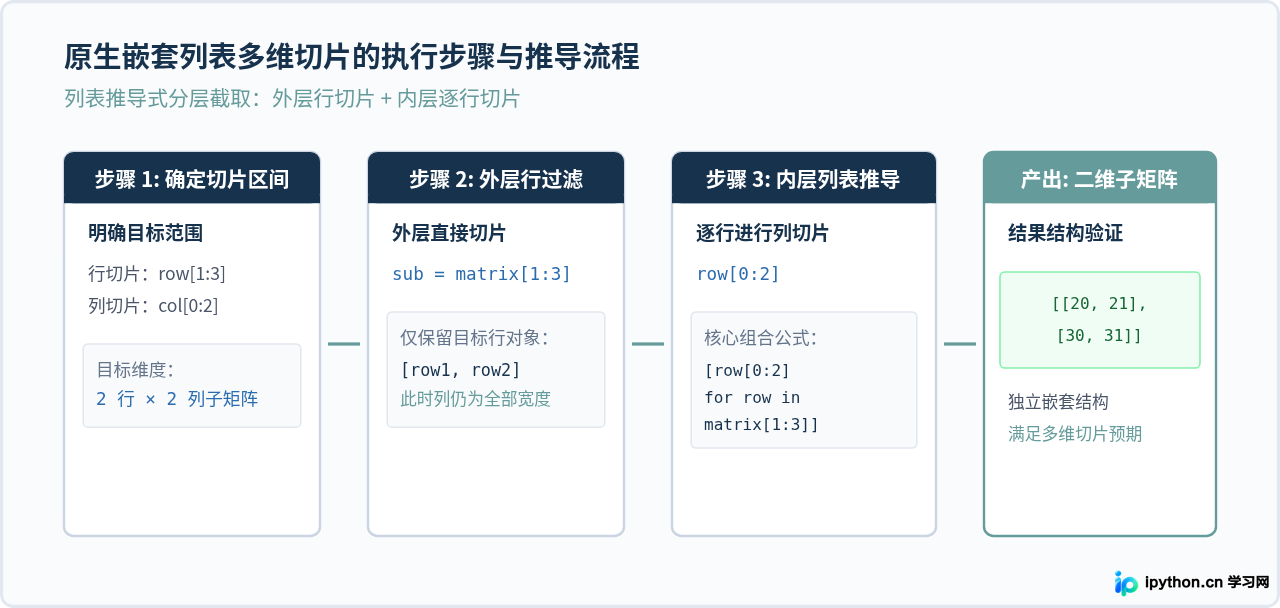
既然外层与内层相互解耦,对嵌套列表进行多维切片就可以自然地拆解为两个基本动作:第一步筛选出目标行,第二步针对这些保留的行分别截取目标列。列表推导式正是将这两个动作合成一行代码的最佳工具。
步骤一:明确行切片与列切片区间
假设我们有一个 4 行 4 列的嵌套列表,希望截取第 1 行至第 2 行(索引 1:3)、第 0 列至第 1 列(索引 0:2)的二维子矩阵。
步骤二:截取外层行集合
通过标准的列表切片 matrix[1:3],我们可以直接得到包含目标行引用的中间列表:
# 示例外层切片
selected_rows = matrix[1:3]
# 此时 selected_rows 为包含原列表第 1、2 行的子列表,但每行内部的列宽尚未缩减
步骤三:内层列表推导式切取列区间
在外层行切片的基础上,对每一个迭代出的 row 应用切片语法 row[0:2],最终组装成全新的二维结构:
# 完整可运行示例:提取子矩阵
matrix = [
    [10, 11, 12, 13],
    [20, 21, 22, 23],
    [30, 31, 32, 33],
    [40, 41, 42, 43]
]

# 核心切片语法:行区间 1:3,列区间 0:2
submatrix = [row[0:2] for row in matrix[1:3]]

print(submatrix)
# 预期输出:
# [[20, 21], [30, 31]]
扩展:提取单一整列与带步长切片
利用同样的推导逻辑,不仅可以切出矩形子区域,还能灵活提取其它多维结构:
- 提取单一整列:例如提取第 2 列数据(索引为 2):
col_2 = [row[2] for row in matrix],结果为一维列表[12, 22, 32, 42]。 - 带步长的二维抽样:行和列各隔一行/一列抽样:
sampled = [row[::2] for row in matrix[::2]]。 - 反转各行顺序或各列顺序:行反转使用
matrix[::-1],列反转则在推导中使用row[::-1]。
三、必须警惕的两个常见操作误区
编写嵌套列表切片代码时,有两个典型误区容易导致逻辑隐患或难以察觉的 Bug。
误区一:连续方括号切片 matrix[:][0]
很多开发者根据“取元素”的习惯,误以为 matrix[:][0] 能够提取所有行的第 0 列。实际上,Python 的表达式计算是从左到右进行的:
- 左侧的
matrix[:]首先执行,它的作用是创建外层列表的一个浅拷贝副本。 - 随后的
[0]作用于这个拷贝出来的外层列表,其含义是“取出第 0 个元素”,也就是完整的第 0 行[10, 11, 12, 13]。
因此,matrix[:][0] 得到的是一个水平行,而不是垂直列。提取整列必须通过推导式遍历每行或使用内置的 zip(*matrix) 转置。
误区二:浅拷贝与元素引用的修改副作用
使用推导式 [row[0:2] for row in matrix[1:3]] 会创建新的外层列表,并且每个 row[0:2] 也会产生新的内层列表。如果列表中的元素是数值、字符串或元组等不可变对象,修改子矩阵的数据完全不会影响原矩阵。
但如果内层元素本身是字典、对象或更深层的可变容器,常规切片只是复制了这些对象的引用。此时直接修改子切片内对象的属性,原矩阵中对应的对象依然会被同步更改。如果需要绝对隔离的数据,可以使用 copy.deepcopy() 进行深度复制。
四、原生推导式与 NumPy 数组切片的对比分析
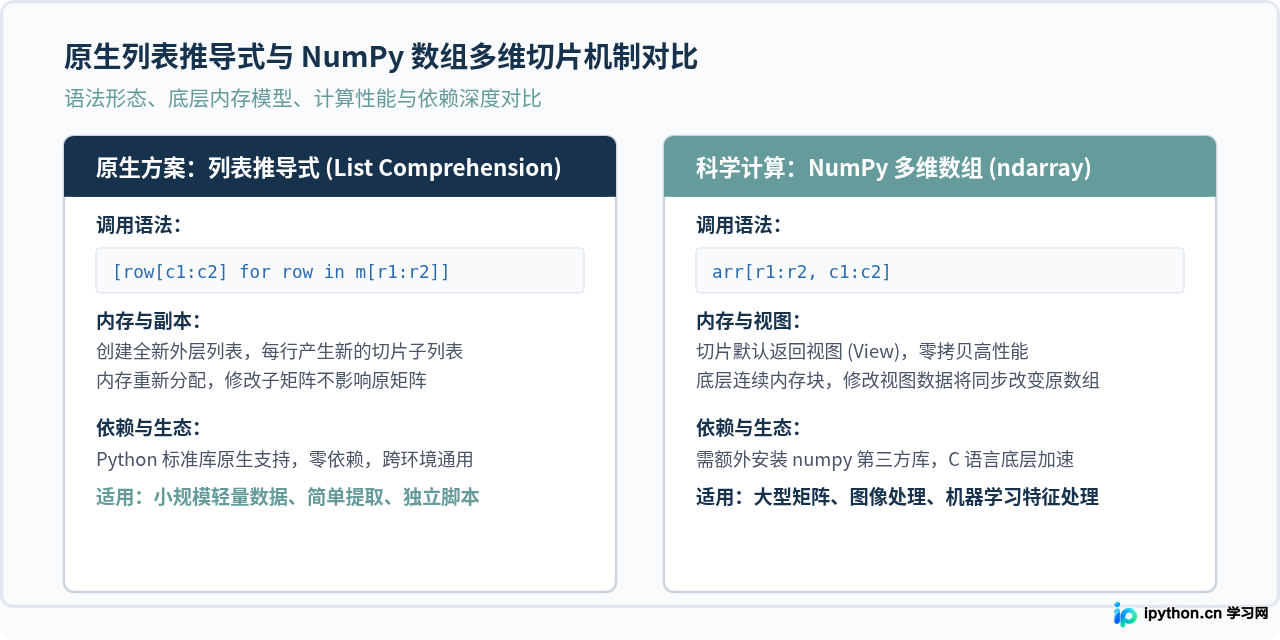
虽然列表推导式解决了多维切片的问题,但随着数据维度增加(如三维、四维张量)或数据行数达到数万行以上,纯 Python 推导式的性能劣势和语法繁琐度就会逐渐显现。在科学计算与数据工程中,更推荐使用专门的多维数组库 NumPy。
# 两种方案的语法对照
import numpy as np

raw_list = [
    [10, 11, 12, 13],
    [20, 21, 22, 23],
    [30, 31, 32, 33]
]

# 方案 A:原生列表推导式
py_sub = [row[1:3] for row in raw_list[0:2]]

# 方案 B:NumPy 数组切片
np_arr = np.array(raw_list)
np_sub = np_arr[0:2, 1:3]

print("原生推导结果:", py_sub)
print("NumPy切片结果:\n", np_sub)
在底层机制上,NumPy 与原生列表推导式存在本质区别:
- 内存模型与连续性:NumPy 的
ndarray在内存中以连续字节块存储,能够利用 CPU 缓存行加速寻址;而原生列表是由散落在堆内存中的指针构成的。 - 视图(View)与副本(Copy):列表推导式每次都会开辟新内存并创建新的子列表;而 NumPy 的常规切片默认返回原数组的视图(View),不发生数据拷贝,计算效率为常数级别 \(O(1)\)。注意:修改 NumPy 视图中的数值会直接改变原数组。
- 依赖开销:列表推导式是 Python 原生语法,无需配置任何第三方环境,适合轻量脚本;NumPy 需要额外安装,更适合密集型计算场景。
五、多维切片方案选型与核心要点总结
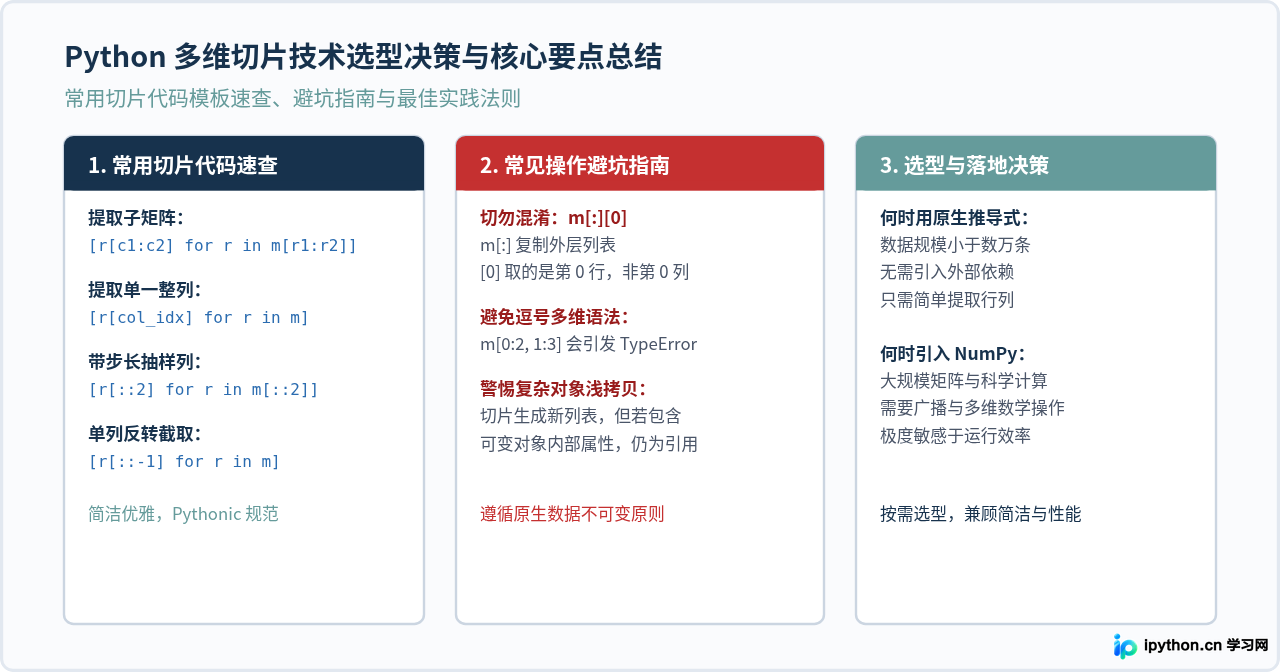
面对具体的项目需求,选择原生列表推导式还是第三方 NumPy 库,取决于数据的体量、计算类型以及对环境依赖的容忍度:
- 优先采用原生列表推导式:当数据行数较少(如数百行以内)、项目处于轻量化脚本阶段、或由于安全合规限制无法安装外部 C 扩展包时。记住标准模式
[row[c_start:c_end] for row in matrix[r_start:r_end]]即可应对绝大多数二维切片需求。 - 优先引入 NumPy 库:当需要处理千万级数值元素、频繁执行三维以上的高阶切片、或者后续紧接着矩阵乘法、傅里叶变换、统计分析等数学运算时。NumPy 的直接切片语法
arr[r, c]不仅运行极快,也能让代码的数学表达更为直观。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









