

Python语言主要应用领域有哪些:从Web开发到人工智能全景解析
全景解析Python语言在现代软件工程中的核心应用领域,涵盖Web全栈与微服务、人工智能与大模型微调、数据科学计算、自动化运维与数据抓取、自动化测试等场景,剖析技术选型依据与边界限制。
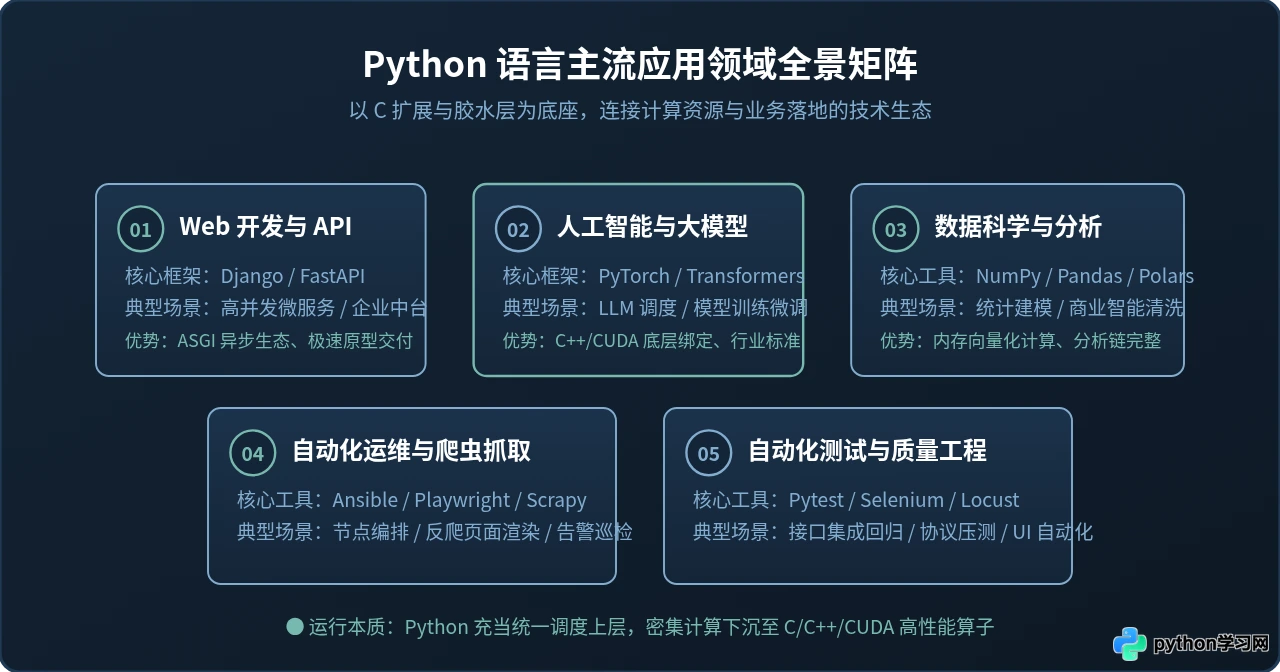
在一套典型的现代化技术系统中,研发团队往往需要同时面对前端页面交互、高性能业务接口、海量日志清洗以及深度学习模型的在线推理。如果针对每一个子系统都完全引入独立的编程语言,团队将面临陡峭的学习成本与协作摩擦。Python 之所以长期在主流开发排行榜中占据核心地位,并非因为它在纯计算性能上超越编译型语言,而是因为它凭借极简的语法表达与无缝挂载 C/C++ 底层算子的胶水机制,在 Web 后端开发、人工智能与大模型、数据科学与分析、自动化运维与数据抓取、质量工程测试 五大领域构筑了极具黏性的技术底座。本文将围绕这五大主流应用领域逐一拆解其核心技术栈、工程运作原理与真实代码范例,并梳理选型时的适用边界与性能限制。
一、Web 后端开发与微服务架构
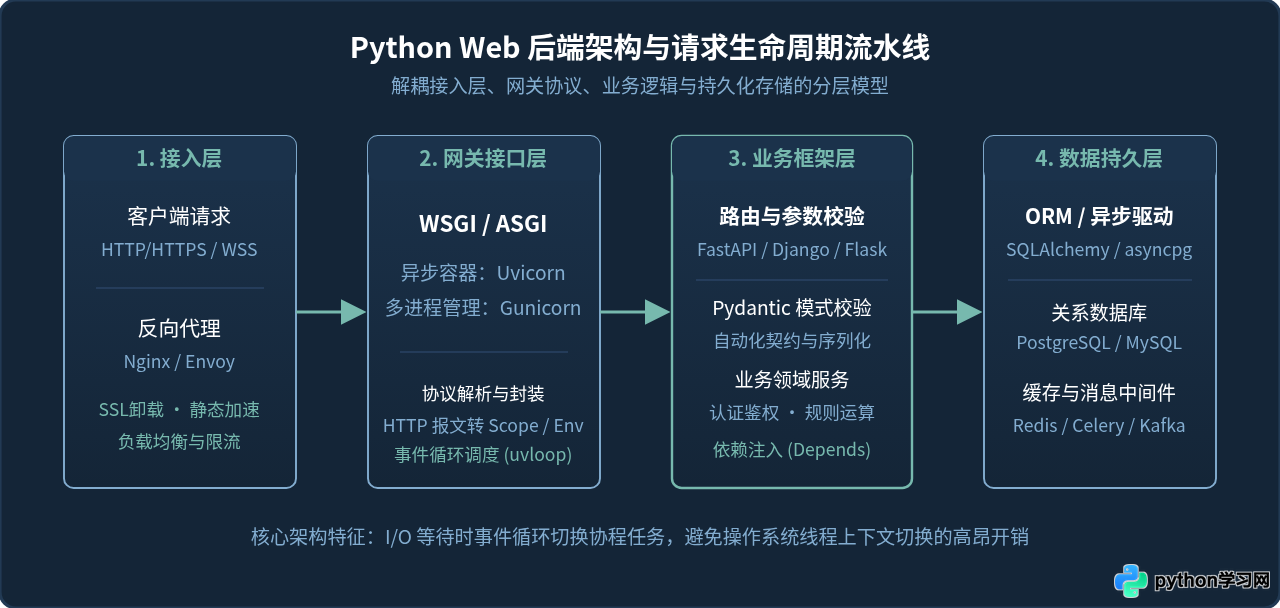
在网络应用服务开发中,Python 承担了从轻量级微服务 API 到大规模企业级内容管理系统的构建任务。与早期单体脚本不同,现代 Python Web 生态已经全面步入基于类型注解(Type Hints)与异步非阻塞网关(ASGI)的高并发时代。
1. 主流框架选型差异与适用场景
开发者在选用 Python 进行 Web 开发时,通常在以下三种范式之间权衡:
- Django:开箱即用的大而全框架。内置了成熟的 ORM、安全防范机制(CSRF、XSS、SQL 注入拦截)、用户认证系统与管理后台。适合业务逻辑复杂、注重敏捷研发与规范约束的企业内部中台或大型门户系统。
- FastAPI:现代高性能异步 API 框架。原生基于 Starlette(ASGI 工具集)与 Pydantic(类型校验器),支持
async/await协程机制,并在服务启动时根据接口函数签名自动生成 OpenAPI (Swagger) 交互式文档。是构建微服务接口、AI 模型对外推理网关的首选。 - Flask:微核心架构。仅提供路由分发与上下文处理,其他如数据库连接、表单验证均交由第三方扩展库自主组装,适合轻量级原型、小型工具接口或对架构有高度定制化需求的场景。
2. FastAPI 异步微服务典型代码实现
下面是一个使用 FastAPI 编写的带类型校验、依赖注入与异步数据库查询模拟的标准接口范例。该示例展示了现代 Python 如何兼顾代码紧凑度与生产级健壮性:
# main.py
from fastapi import FastAPI, HTTPException, status, Depends
from pydantic import BaseModel, Field
from typing import Optional
import asyncio

app = FastAPI(title="用户任务处理服务", version="1.0.0")

# 1. 契约模型定义(Pydantic 自动处理类型转换与异常拦截)
class TaskRequest(BaseModel):
    title: str = Field(..., min_length=3, max_length=50, description="任务标题")
    priority: int = Field(default=1, ge=1, le=5, description="优先级 1-5")
    callback_url: Optional[str] = Field(default=None, description="回调地址")

class TaskResponse(BaseModel):
    task_id: str
    status: str
    processed_priority: int

# 2. 模拟依赖注入:数据库会话管理
async def get_db_session():
    # 模拟获取数据库连接
    session = {"connected": True}
    try:
        yield session
    finally:
        # 退出上下文自动释放
        session["connected"] = False

# 3. 异步路由处理函数
@app.post("/api/v1/tasks", response_model=TaskResponse, status_code=status.HTTP_201_CREATED)
async def create_task(payload: TaskRequest, db=Depends(get_db_session)):
    if not db.get("connected"):
        raise HTTPException(status_code=500, detail="数据库连接池异常")

    # 模拟非阻塞 I/O 操作(网络请求或数据库写入)
    await asyncio.sleep(0.05)

    generated_id = f"task_{abs(hash(payload.title)) % 100000}"
    return TaskResponse(
        task_id=generated_id,
        status="queued",
        processed_priority=payload.priority
    )

# 启动命令示例:
# uvicorn main:app --host 0.0.0.0 --port 8000 --workers 4await 阻塞时立即让出 CPU 调度其他请求,单机并发容量可显著提升一个数量级。二、人工智能与机器学习生态
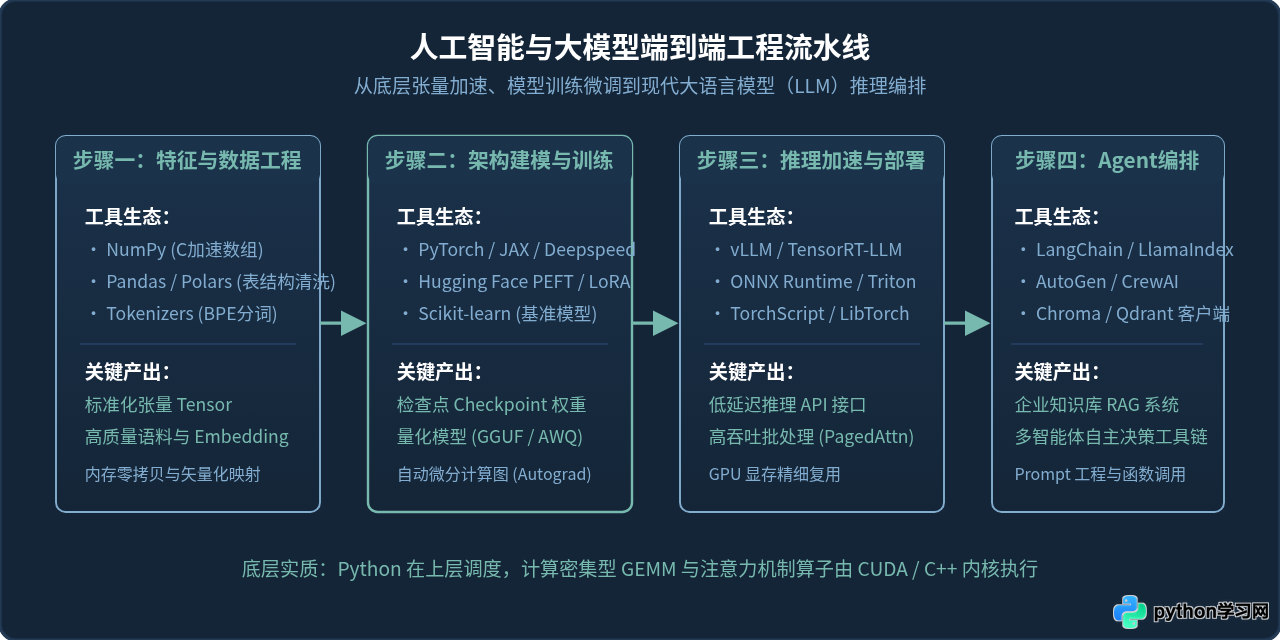
在人工智能领域,Python 事实上已经成为全球研究界与产业界的通用语言。无论是传统的监督学习算法、计算机视觉与自然语言处理,还是目前的大语言模型(LLM)训练与微调,Python 均扮演着顶层调度指挥中心的角色。
1. 关键技术支撑体系
- 经典机器学习:以
scikit-learn为代表,封装了分类、回归、聚类、主成分降维(PCA)等完备的数学模型,统一了fit()与predict()的 API 抽象。 - 深度学习计算框架:
PyTorch凭借动态计算图(Eager Execution)与 Python 原生调试体验,统治了学术界论文发表与前沿大模型架构研发;TensorFlow / Keras在工业级端侧部署中同样具备稳定应用。 - 大语言模型与 Agent 编排:以
Hugging Face Transformers、vLLM、LangChain与LlamaIndex为核心,开发者可以用数十行 Python 代码完成模型权重加载、向量检索增强生成(RAG)以及多智能体自主决策工具链的搭建。
2. PyTorch 模型推理与张量运算代码实现
以下代码演示了如何使用 PyTorch 构建一个基础的前馈神经网络,并在 GPU/CPU 之间智能调度完成前向推理:
import torch
import torch.nn as nn

# 1. 自动选择计算后端(优先使用 GPU CUDA,无显卡回退至 CPU)
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

# 2. 继承 nn.Module 构建多层感知机(MLP)
class ClassifierNet(nn.Module):
    def __init__(self, input_dim: int, hidden_dim: int, num_classes: int):
        super(ClassifierNet, self).__init__()
        self.network = nn.Sequential(
            nn.Linear(input_dim, hidden_dim),
            nn.BatchNorm1d(hidden_dim),
            nn.ReLU(),
            nn.Dropout(p=0.2),
            nn.Linear(hidden_dim, num_classes)
        )

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        return self.network(x)

# 3. 初始化模型并转移至目标设备
model = ClassifierNet(input_dim=128, hidden_dim=64, num_classes=3).to(device)
model.eval()  # 切换至评估模式,关闭 Dropout 随机失活

# 4. 生成模拟特征向量批次 (Batch Size = 4, Dim = 128)
dummy_features = torch.randn(4, 128, device=device)

# 5. 执行前向推理,禁用梯度计算以节约显存开销
with torch.no_grad():
    logits = model(dummy_features)
    probabilities = torch.softmax(logits, dim=-1)
    predicted_classes = torch.argmax(probabilities, dim=-1)

# 输出示例展示
print("输入张量尺寸:", dummy_features.shape)
print("推理类别结果:", predicted_classes.cpu().numpy())三、数据科学、统计分析与科学计算
在企业商业智能决策、金融量化风控以及科研数据推演中,Python 取代了以往昂贵且封闭的专用软件(如 MATLAB、SAS),形成了全开放的数据科学标准生态。
1. 核心数据分析组件矩阵
| 工具名称 | 底层实现 | 核心数据抽象 | 主要应用场景 |
|---|---|---|---|
| NumPy | C 语言连续内存块 | ndarray(多维同质数组) | 向量化代数运算、傅里叶变换、随机抽样模拟 |
| Pandas | Cython / C | DataFrame / Series(异构二维表) | 数据预处理、透视表分析、缺失值填充、时序重采样 |
| Polars | Rust 原生多线程 | DataFrame(基于 Apache Arrow) | 十亿级以上超大规模数据集的高性能清洗与懒加载计算 |
| SciPy | C / Fortran | 科学算法集成库 | 常微分方程数值求解、稀疏矩阵代数、高维空间积分 |
| Matplotlib / Seaborn | Python / Agg渲染器 | Figure / Axes 图表画布 | 学术论文图谱绘制、业务探索性数据分析(EDA)可视化 |
向量化计算的性能关键:传统 Python 代码通过 for 循环遍历数组会产生动态类型检查开销;而 NumPy 将数组保存在连续物理内存空间中,底层直接通过单指令多数据流(SIMD)指令集或多核并行加速,计算吞吐量相比纯 Python 循环可实现数十至数百倍的提升。
四、自动化运维、网络数据采集与系统治理
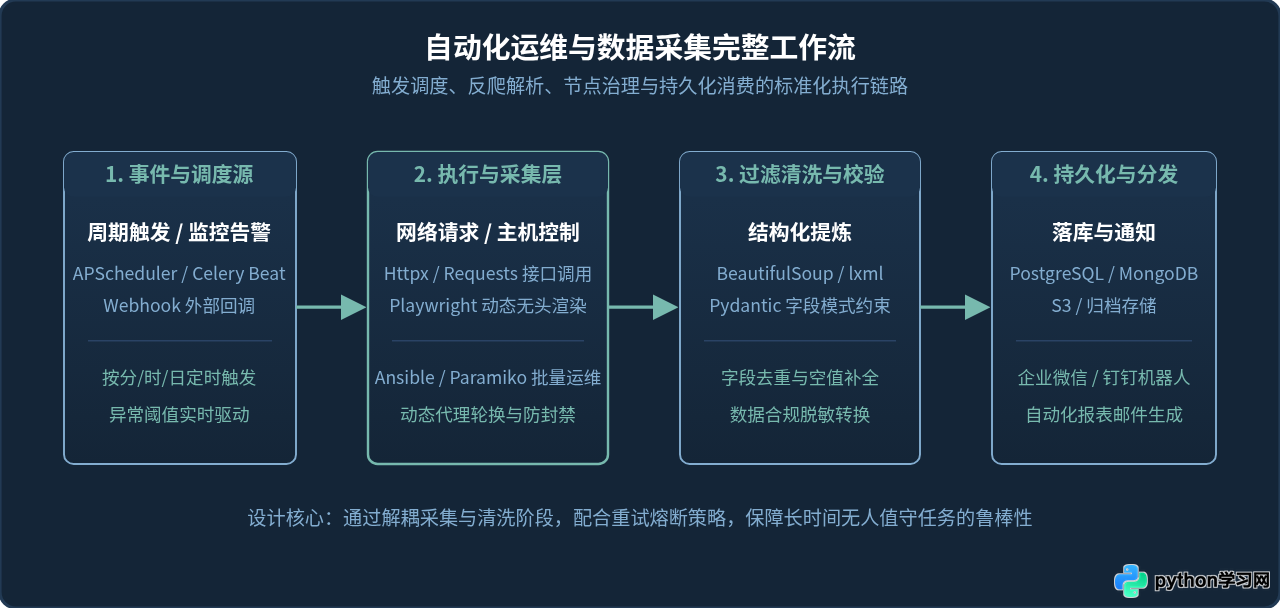
在日常的基础设施治理与外部互联网公开信息采集中,开发人员最需要的是能够在极短时间内编写出具备网络容错与流程编排能力的执行脚本,Python 的标准库与第三方工具包在此场景下表现出极强的生产力。
1. 自动化运维与节点治理
在 DevOps 领域,Ansible 采用无代理(Agentless)模式,通过 SSH 协议与 Python 解释器协同,利用声明式 YAML 脚本实现成千上万台云主机的自动化批量配置与软件部署;Fabric 和 Paramiko 则允许工程师在轻量级场景下通过纯 Python 脚本批量执行远程 Shell 命令、分发密钥文件和收集系统指标。
2. 网络数据采集(爬虫)演进路径
- 轻量级静态采集:
Requests或支持 HTTP/2 的Httpx搭配BeautifulSoup / lxml,能够以毫秒级速度解析服务端渲染(SSR)的网页源码与 JSON 接口。 - 现代动态单页渲染:面对使用 React/Vue 构建的复杂前端单页应用(SPA),传统 HTTP 库无法获取 DOM,行业已转向使用
Playwright for Python或Selenium驱动无头浏览器(Headless Chromium),直接模拟用户滚动、点击、等待网络空闲并提取计算后 DOM。 - 分布式抓取框架:
Scrapy提供了包含下载器中间件、爬虫引擎、管道清洗与去重器的完整架构,能够与 Redis 结合搭建高容错的分布式抓取集群。
五、自动化测试与质量工程
在现代化持续集成与交付(CI/CD)流水线中,软件质量保障不仅依赖手动验证,更依托于完备的自动化测试框架。Python 在测试工程领域的覆盖面涵盖单元测试、接口契约测试与端到端 UI 自动化。
Pytest 已经成为 Python 测试的事实标准。相比传统继承自 Java xUnit 风格的 unittest,Pytest 具有两大显著优势:
- 纯原生 assert 表达式与智能回溯:无需调用繁琐的
self.assertEqual(),直接编写assert result == expected,测试失败时框架会自动解析 AST 语法树并打印局部变量详细上下文对比。 - 强大的 Fixture 夹具系统:通过声明式注入,精确管理测试前置准备(如清空测试数据库、生成鉴权 Token)与后置清理,支持模块级(module)、会话级(session)与函数级(function)的作用域划分。
六、选型考量:Python 的适用边界与性能限制
客观理解一门语言的技术缺陷,与掌握其优势同样重要。在软件架构规划中,必须清楚识别 Python 不适用的业务场景,并在必要时引入混合架构:
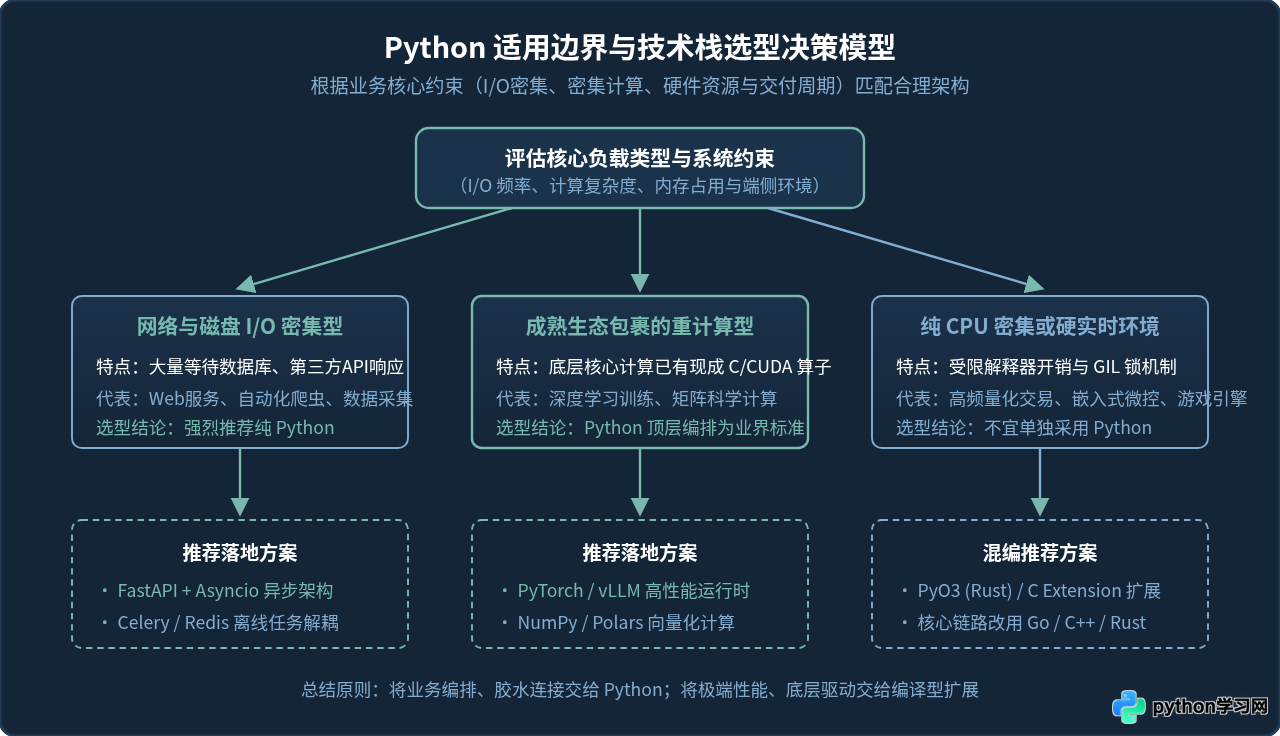
- 全局解释器锁(GIL)的制约:在标准 CPython 解释器中,同一进程内的多个原生线程无法在多个物理 CPU 核心上同时执行 Python 字节码。对于纯 CPU 密集型任务(如大文件加解密、音视频软编解码、几何图形渲染),多线程无法带来线性加速,必须采用
multiprocessing多进程模式,或将核心运算下沉给 C/C++/Rust 扩展模块。 - 移动端与嵌入式系统的局限:在 iOS 和 Android 原生应用开发中,Python 缺乏官方一等公民支持;在几百 KB 内存的超低功耗单片机环境(如传统 MCU),即便有 MicroPython,其运行开销和垃圾回收暂停(GC Pause)也难以满足硬实时控制要求,该领域依然属于 C、C++ 与 Rust 的阵地。
- 现代工程的最佳实践:语言混编:大型科技互联网企业在架构设计上普遍遵循“分层治理”原则——将业务快速变动、逻辑频繁调整的上层业务网关、流程编排、调度系统交给 Python 保障交付效率;而底层超高频次网络网关、核心存储引擎或交易撮合系统,则由 Go、Rust 或 C++ 实现,二者通过 gRPC 协议或 FFI(如 PyO3、ctypes)紧密协作。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









