

Python爬虫工程师主要做什么:岗位职责与工作内容解析
深入解析Python爬虫工程师的核心岗位职责、日常工作内容与全链路工程流程。涵盖目标协议逆向、反爬攻防突破、分布式采集架构设计、数据清洗入库及自动化运维监控,全面揭示现代化爬虫岗位的真实工作面貌与核心技术要求。
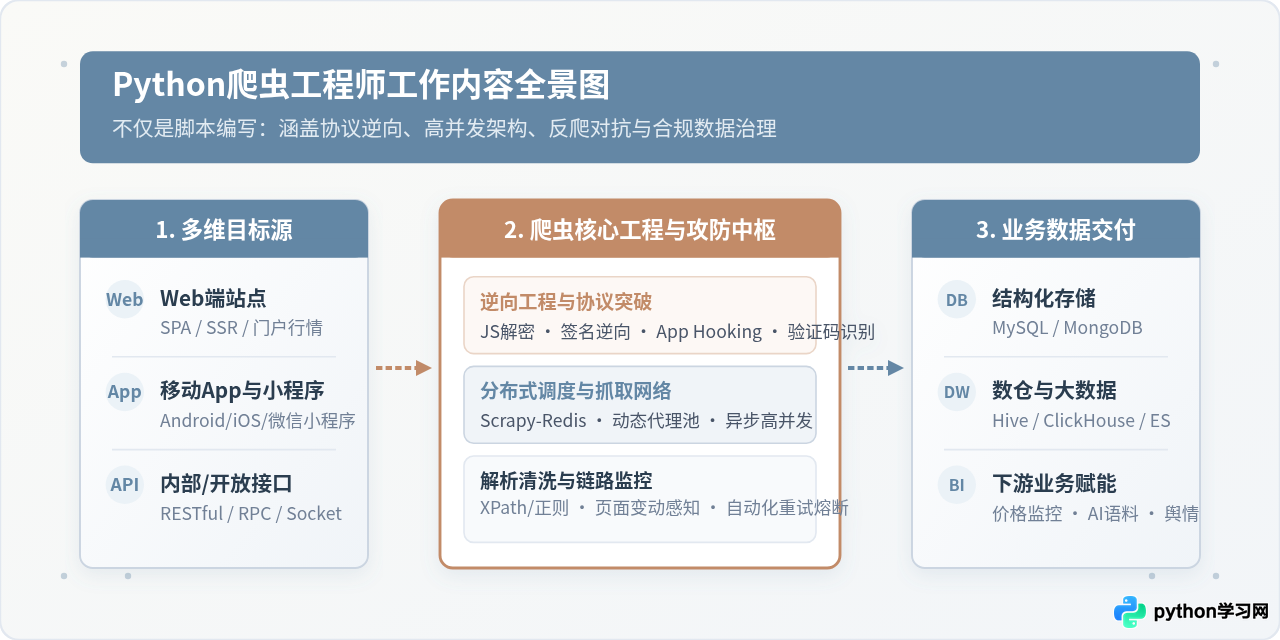
requests.get() 下载网页,而是融合了深度的底层协议抓包与逆向攻防、分布式集群调度、动态代理治理、海量并发流转、数据清洗建模以及 7×24 小时链路监控运维的系统级工程。
一、核心定位:从单机脚本到生产级数据工程
初学者对爬虫的认知往往停留在“发送一个HTTP请求、用BeautifulSoup挑几个标签、保存成CSV文件”。但企业真实业务场景中,面对的数据规模通常在千万级到数十亿级,面对的抓取目标则具备完善的风控防护墙(WAF防火墙、JS动态混淆、设备指纹追踪、移动端加密签名)。
在企业技术架构中,爬虫工程师是连接“外部互联网公网数据”与“企业内部数据仓库/业务决策系统”的核心桥梁。如果爬虫采集出现单点中断、数据漏采或延迟,下游的竞品行情监控、大模型训练语料库、舆情分析大盘或风控知识图谱就会陷入“数据断流”。因此,爬虫工程师的岗位要求始终围绕着“高可用、高对抗、高并发、高准确”四大核心展开。
二、四项核心岗位职责与工作内容拆解
在日常工作中,Python爬虫工程师的工作内容主要分为四个紧密相连的技术版块:
1. 目标分析与协议逆向突破(攻防对抗)
这是爬虫工程师技术门槛最高、耗费精力最集中的领域。随着现代Web与移动应用架构的演进,绝大多数有价值的数据均被严格保护在复杂的反爬机制之后:
- 接口逆向与签名破解:使用 Chrome DevTools 分析网络瀑布流,定位关键 XHR/Fetch 请求。逆向分析包含在 URL、Query 参数、Header 中的加密凭据(如
sign、token、nonce、_signature),还原其基于 MD5、SHA256、AES、RSA 或私有哈希算法的计算逻辑。 - 前端 JavaScript 混淆脱壳:面对代码压缩、变量混淆、OB混淆(Obfuscator)、控制流平坦化等反调试代码,利用 AST(抽象语法树)进行语法分析与反混淆,通过断点调试定位核心加密函数,采用 Node.js 本地补环境框架或 RPC 远程调用执行加密逻辑。
- 移动端 App 与小程序逆向:针对仅在移动端放开或防护较弱的数据接口,使用 Charles/Fiddler 搭建中间人代理证书抓包,利用 Jadx/JEB 反编译 APK 源码,结合 Frida、Xposed 框架对 Android 内存函数进行 Hooking,绕过 SSL Pinning(证书绑定)检测与 SO 动态库加密验证。
- 行为式人机验证识别:对滑动拼图缺口、文字点选、空间旋转验证码,运用 OpenCV 计算机视觉边缘检测或轻量 YOLO 目标检测模型完成坐标定位,结合拟人贝塞尔曲线生成自然运动轨迹以通过风控判定。
2. 分布式高并发采集系统研发(架构设计)
突破单点数据接口后,工程师必须将单次验证脚本转变为支撑亿级规模吞吐的分布式采集集群:
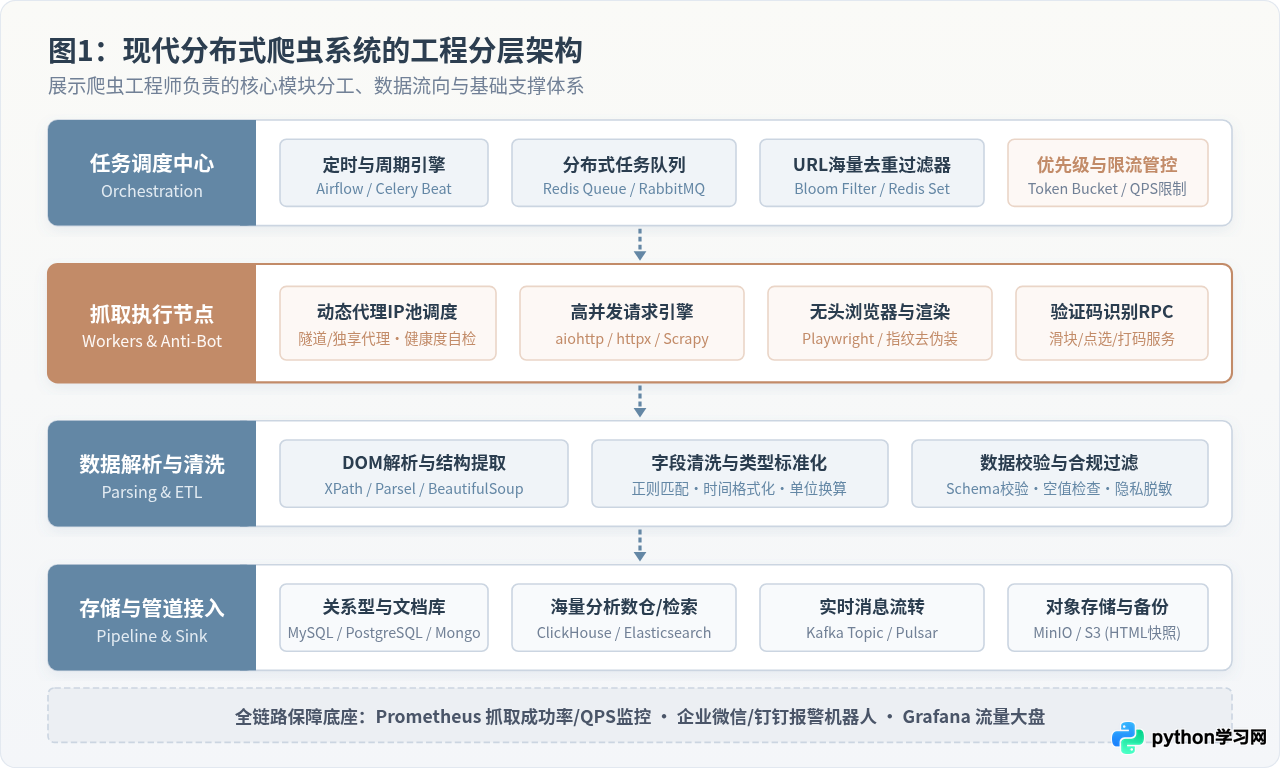
- 分布式任务队列与调度:基于 Redis 或 RabbitMQ/Kafka 构建分布式任务发布与消费机制,利用 Scrapy-Redis、Celery 或自研异步框架实现海量抓取 Worker 节点的横向水平扩展。
- 动态 IP 代理池治理:反爬策略中最基础但最致命的是 IP 频次限制。工程师需要搭建并维护高可用代理池系统,涵盖机房代理、独享隧道代理与全球住宅动态代理,编写自动化探针实时剔除失效节点,实现请求维度的无缝 IP 轮换与失败重试。
- 异步并发与吞吐优化:深入利用 Python 的
asyncio、aiohttp、httpx以及多进程/协程模型,将单节点 QPS 提升数倍至数十倍,优化网络连接池复用与 DNS 解析缓存,大幅压降服务器硬件与网络带宽成本。
3. 数据解析清洗、校验与入库治理(数据生命周期)
采集到的网页 HTML 或二进制数据本身不是可用资产,必须经过严密的数据清洗流(ETL Pipeline):
- 高效解析提取:采用 XPath、CSS 选择器、Parsel 或正则表达式高效解析 DOM 树,对于非结构化正文开发基于文本密度与标签比值的通用提取算法。
- 数据标准化与脱敏:将混乱的时间格式(如“3分钟前”、“昨天 14:20”)转换为标准 ISO-8601 时间戳,清洗货币单位、规格参数,去除 HTML 脏标签与脚本残留,并对涉及合规要求的敏感字段进行哈希脱敏。
- Schema 约束与幂等入库:定义统一的数据模型(Pydantic/Dataclass),在写入 MySQL、MongoDB、Elasticsearch 或 ClickHouse 前进行类型约束与必填项校验。设计稳健的业务唯一键(如 MD5 唯一指纹),确保重复抓取时能够幂等更新而非数据膨胀。
4. 采集链路监控、告警与改版自愈(运维保障)
爬虫系统与常规业务系统最大的区别在于:目标站点不受本公司控制,其代码与风控随时可能无预警变更。因此监控告警与应急自愈是日常维护的重中之重:
- 实时指标大盘:集成 Prometheus 与 Grafana,实时监控每分钟请求数(QPS)、HTTP 状态码分布(200/403/429/502)、解析成功率、入库速率以及代理池存活率。
- 自动化异常探测与自愈:当某一站点解析失败率骤升、字段空值率突破阈值(意味着前端页面改版或改动了 DOM 结构)时,系统自动触发熔断暂停任务,并通过企业微信或钉钉机器人发出高优先级告警通知,防止脏数据污染数据库。
三、典型工作流程:从需求到交付的完整闭环
为了让读者直观理解爬虫工程师在企业中的协作全貌,下图梳理了一个新采集项目从需求提出到平稳运行的标准五步闭环流程:
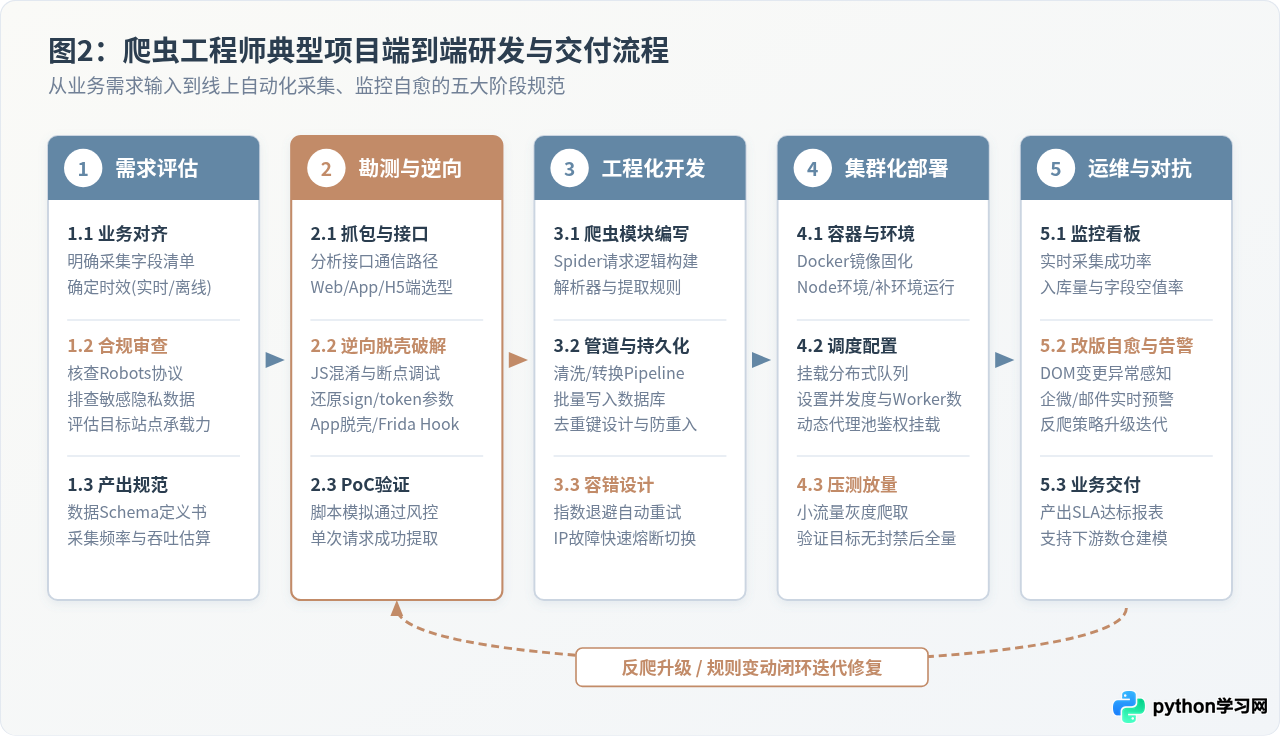
- 阶段一:需求评估与合规审查。与产品经理或数据分析师对齐所需字段、更新频率(实时分钟级、小时级或每日全量离线),评估目标站点的 Robots 协议与访问承载力,严格划定合规红线。
- 阶段二:勘测与逆向工程。分析目标 Web 端、H5 端与移动 App 端三者的接口差异,优先选择数据结构清晰、防护相对薄弱的通信通道。针对加密参数编写逆向解密脚本,输出 PoC(可行性验证)单次抓取用例。
- 阶段三:工程化开发与容错设计。将验证逻辑装载入工程框架,编写 Spider 请求生命周期函数、Pipeline 数据清洗链条,配置基于指数退避(Exponential Backoff)的自动重试策略与 IP 熔断机制。
- 阶段四:集群化部署与放量压测。将爬虫项目构建为标准 Docker 容器镜像,配置分布式任务并发参数与定时触发规则。在小流量灰度阶段验证数据一致性,确认目标站点无风控封禁后全量调度。
- 阶段五:线上监控与对抗维护。接入自动化监控告警体系,日常根据监控反馈修复页面规则变动,与目标站点风控团队的新策略进行动态技术对抗。
四、反爬机制攻坚全景与核心解决方案
反爬虫对抗是检验一位爬虫工程师工程水准的关键试金石。现代商业站点的防御手段已形成网络层、协议层、前端执行层与交互风控层的多维纵深防御:
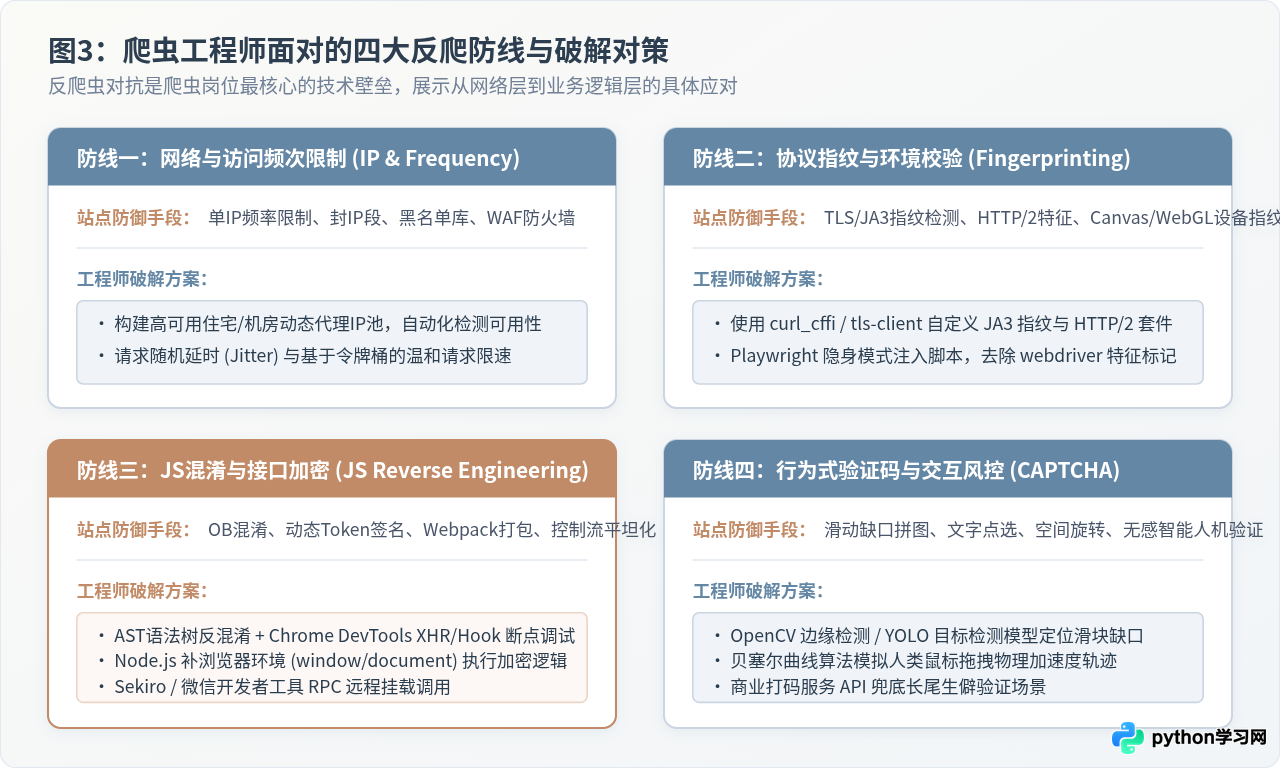
在过去,很多工程师认为修改 User-Agent 就能模拟浏览器。但在现代高防御站点中,服务器会在握手阶段比对客户端 TLS 握手特征(Cipher Suites、Extensions 列表等构成的 JA3 指纹)以及 HTTP/2 首部序列。原生 Python requests 库的 JA3 指纹与标准 Chrome/Firefox 截然不同,极易在握手层被直接断开。使用底层封装 BoringSSL 的 curl_cffi 或 tls-client 库模拟真实浏览器握手特征,是现代爬虫对抗协议风控的必备技能。
五、工程化生产级代码示例:健壮的抓取架构骨架
以下展示了一个基于现代化异步请求库的生产级抓取模块设计骨架。该示例体现了企业级开发中至关重要的协议伪装、动态代理、状态感知与重试熔断规范:
import asyncio
import logging
from typing import Optional, Dict, Any
from curl_cffi.requests import AsyncSession

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")

class ProductionScraper:
    def __init__(self, proxy_pool_url: str):
        self.proxy_pool_url = proxy_pool_url
        self.max_retries = 3
        # 模拟最新真实 Chrome 浏览器的 TLS/JA3 指纹与 HTTP/2 套件
        self.impersonate_target = "chrome120"

    async def fetch_proxy(self) -> Optional[str]:
        """从自建代理池服务获取一个高可用代理 IP"""
        # 实际生产中调用内部代理池微服务接口
        return "http://proxy_user:proxy_pass@10.20.30.40:8080"

    async def fetch_json_data(self, target_url: str, headers: Dict[str, str]) -> Optional[Dict[str, Any]]:
        """带有指数退避、JA3指纹伪装与智能代理轮换的稳健请求方法"""
        retry_delay = 1.0

        for attempt in range(1, self.max_retries + 1):
            proxy = await self.fetch_proxy()
            try:
                async with AsyncSession(impersonate=self.impersonate_target) as session:
                    response = await session.get(
                        target_url,
                        headers=headers,
                        proxy=proxy,
                        timeout=8.0
                    )

                    # 遇到 403 (风控拦截) 或 429 (频次过载) 触发切换代理与退避
                    if response.status_code in [403, 429]:
                        logging.warning(f"触发目标风控拦截 (HTTP {response.status_code}),尝试第 {attempt} 次重试...")
                    elif response.status_code == 200:
                        data = response.json()
                        # 检查业务返回码,防止抓到风控验证码提示包
                        if data.get("code") == 0 and "data" in data:
                            return data["data"]
                        logging.warning(f"HTTP 200 但业务错误码异常: {data.get('msg')}")
                    else:
                        logging.warning(f"服务器返回异常状态码: {response.status_code}")

            except Exception as exc:
                logging.error(f"请求发生网络或协议异常: {str(exc)},正在退避重试...")

            # 递增延时重试,避免瞬时流量压垮目标站点或连续触发风控
            await asyncio.sleep(retry_delay)
            retry_delay *= 2.0

        logging.error(f"目标请求失败,达到最大重试次数: {target_url}")
        return None
六、职业技能矩阵与工具生态
合格的 Python 爬虫工程师通常需要在以下技术维度构建完整的技能壁垒:
| 技术领域 | 主流技术栈与生产工具 | 工程师在岗位上的应用场景 |
|---|---|---|
| 核心开发语言 | Python 3.10+, JavaScript (ES6+), SQL, Go (辅助) | 编写核心爬虫、解密模块、数据清洗流水线及高吞吐服务 |
| 网络通信与框架 | Scrapy, aiohttp, httpx, curl_cffi, Playwright | 构建高并发分布式抓取引擎、无头浏览器动态页面渲染与指纹伪装 |
| 逆向与脱壳工具 | Chrome DevTools, Charles, Fiddler, Jadx, Frida | Web 端断点逆向、App 抓包、Android 签名加密脱壳与 Hooking |
| 调度与流转中间件 | Redis, RabbitMQ, Kafka, Airflow, Celery | 海量 URL 去重(布隆过滤器)、分布式任务队列与削峰填谷 |
| 存储与大数据底座 | MySQL, MongoDB, ClickHouse, Elasticsearch | 清洗后结构化数据入库、海量文本全文检索与 OLAP 聚合分析 |
| 容器与运维监控 | Docker, Kubernetes, Prometheus, Grafana | 爬虫集群标准化打包部署、节点弹性扩缩容与采集 SLA 质量监控 |
七、法律合规红线与职业安全底线
由于爬虫技术直接与公网外部站点交互,合规性与法律安全意识是爬虫工程师最重要的职业红线。在实施任何采集工程前,必须严格遵守以下原则:
- 严格遵守《数据安全法》与《个人信息保护法》:绝对不抓取未经用户授权的公民个人敏感信息(如身份证号、银行卡号、精准手机号、家庭住址、通讯录及私密聊天记录等)。
- 严禁突破计算机信息系统安全防线:不非法侵入需要授权密码或越权获取后台管理数据;严禁利用目标系统的技术漏洞进行脱库操作,防范触犯《刑法》第二百八十五条相关规定。
- 控制请求频率,严守“不造成实质业务影响”原则:始终对采集请求进行温和限速与错峰调度,严禁因过高并发导致目标服务器响应迟缓甚至瘫痪(避免造成拒绝服务 DoS 事实)。
- 尊重公开意图与 Robots 协议:仅采集面向公众合法公开的数据,尊重网站服务条款中的合理限制,对涉及商业版权的核心数据资产建立清晰的使用边界评估。
八、总结与岗位核心价值评估
综合来看,现代 Python 爬虫工程师的价值从来不在于“写代码抓到了几页文字”,而在于“在面对严苛的反爬风控与不稳定的公网环境下,如何持续、低成本、高 SLA(服务等级协议)地将数据稳定供给给业务侧”。
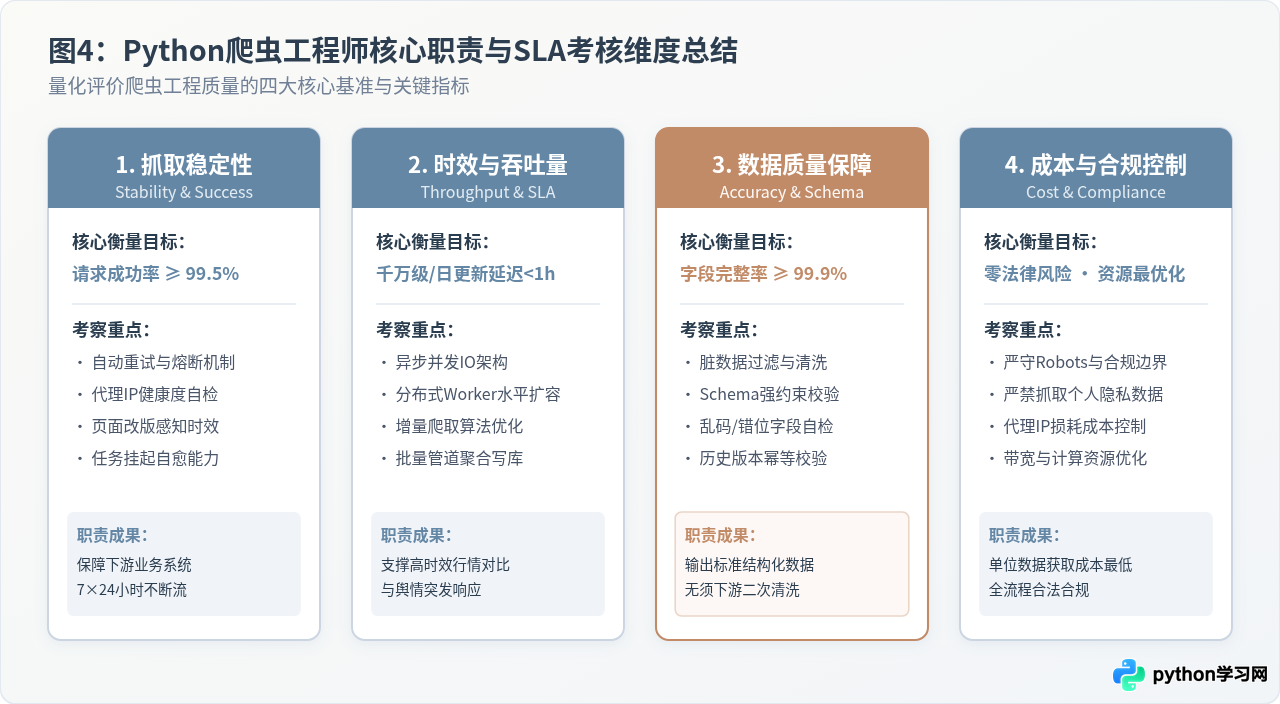
随着大数据分析与人工智能大语言模型的发展,高质量的外部数据成为企业算法迭代与商业智能决策的关键燃料。具备深厚逆向攻防能力、分布式架构经验并时刻坚守法律合规底线的爬虫工程师,在金融投研、商业分析、电商比价、搜索引擎以及 AI 数据工程等领域,始终具备不可替代的专业工程价值。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









