

什么叫Python编程:语言定义与核心特点
本文系统解析什么叫Python编程,深入剖析Python的高级解释型语言定义、底层运行机制、四大核心特点、执行流程与实际适用边界,帮助初学者建立清晰准确的技术认知。
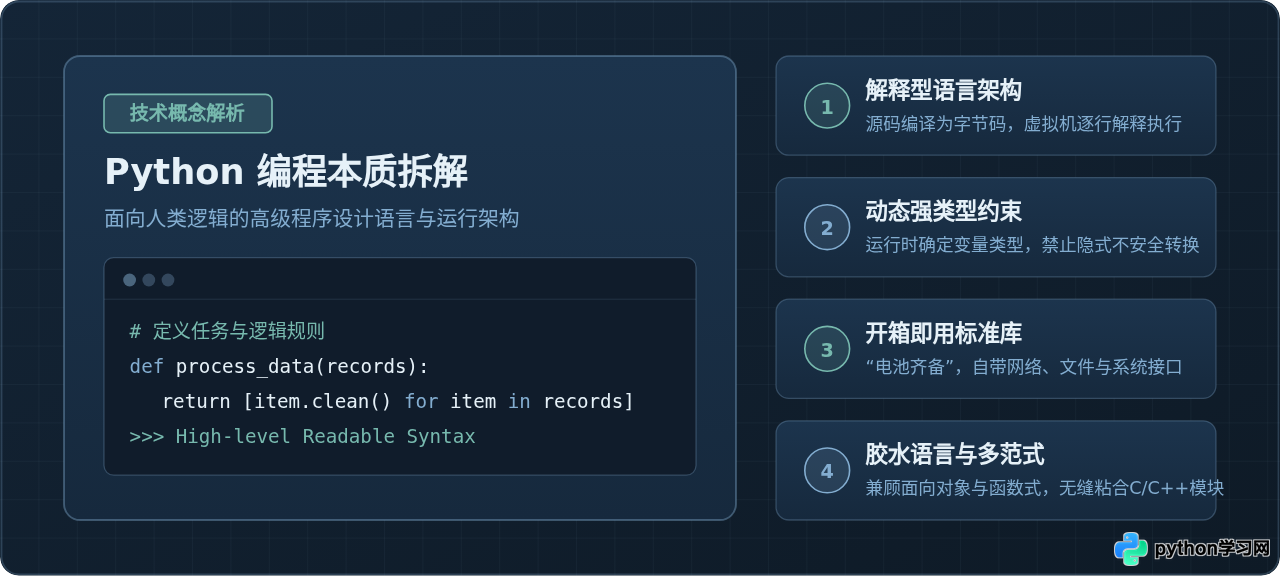
假设你在日常办公中需要从几十个结构各异的 Excel 表格中抓取销售明细并生成统一的汇总清单,如果依靠人工逐个打开、复制粘贴,需要耗费数小时且极易出现数字错漏;而如果编写一段程序,让计算机按照预设的逻辑规则在数秒内自动读取、清洗和导出结果,这个指挥计算机自动执行逻辑的过程就是编程。所谓 Python 编程,就是使用 Python 这一门语法清晰、接近人类自然语言的高级程序设计语言,按照特定语法规范组织逻辑指令,解决计算、数据处理与软件系统开发任务的过程。
很多初学者在初次接触时,容易将“学习语法规则”等同于“编程的全部”,或者对“解释型”、“动态类型”等专业名词感到困惑。本文将从 Python 的官方语言定义入手,深入分析它的底层运行机制与四大核心特点,辅以具体代码示例与适用边界说明,帮助读者建立系统、准确的认知。
一、Python的语言定义:本质与四重属性
根据 Python 官方规范与计算机工程学定义,Python 是一门高层次的、解释型的、动态强类型的多范式通用程序设计语言。这四个定语构成了 Python 区别于其他编程语言的本质属性:
- 高级语言(High-level Language):相较于直接操作寄存器和内存地址的机器码或汇编语言,Python 高度抽象了底层细节。开发者无需手动管理内存申请与释放,也无需关注 CPU 指令集架构,代码风格贴近英语表达,专注解决业务问题。
- 解释型语言(Interpreted Language):Python 代码在运行时不需要像 C 或 C++ 那样预先将全部源码编译为机器目标文件,而是由解释器在执行时将源码翻译为中间字节码,并由虚拟机逐行解译执行。这种方式赋予了它优秀的跨平台性与交互式调试能力。
- 动态强类型(Dynamic & Strongly Typed):这是初学者最容易产生误解的概念。“动态”指的是变量的类型是在运行期间被赋值时自动确定的,无需在写代码时声明
int a = 10;而“强类型”则指语言对类型转换有严格约束,不允许隐式发生不合法的类型突变(例如在 Python 中数字1与字符串"2"相加会直接抛出类型错误,而不会像 JavaScript 那样隐式隐式拼接为"12")。 - 多范式支持(Multi-paradigm):Python 支持面向对象编程(OOP)、面向过程编程以及函数式编程。你可以把它当作编写几行脚本解决单次计算的自动化工具,也可以组织起包含复杂类继承体系的企业级大型系统。
二、底层如何运作:Python代码的执行生命周期
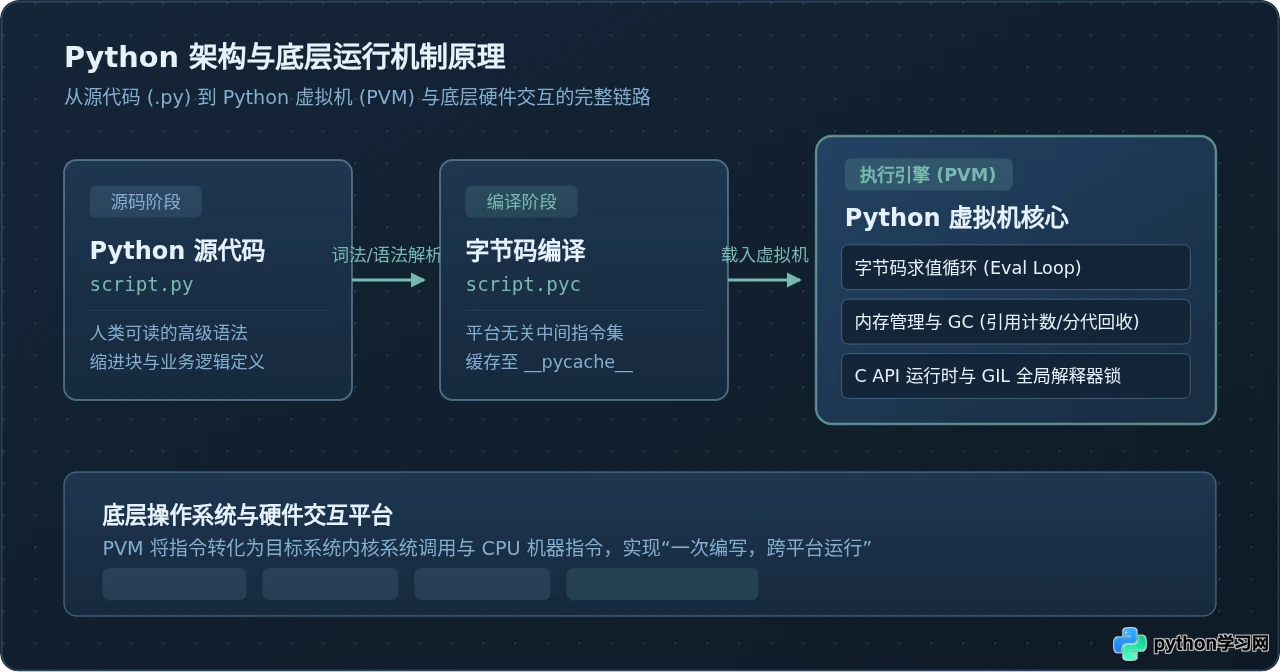
当我们写下一段 .py 脚本并在终端输入 python main.py 时,操作系统与 Python 解释器(默认也是最主流的 CPython 解释器)经历了怎样的数据流转?
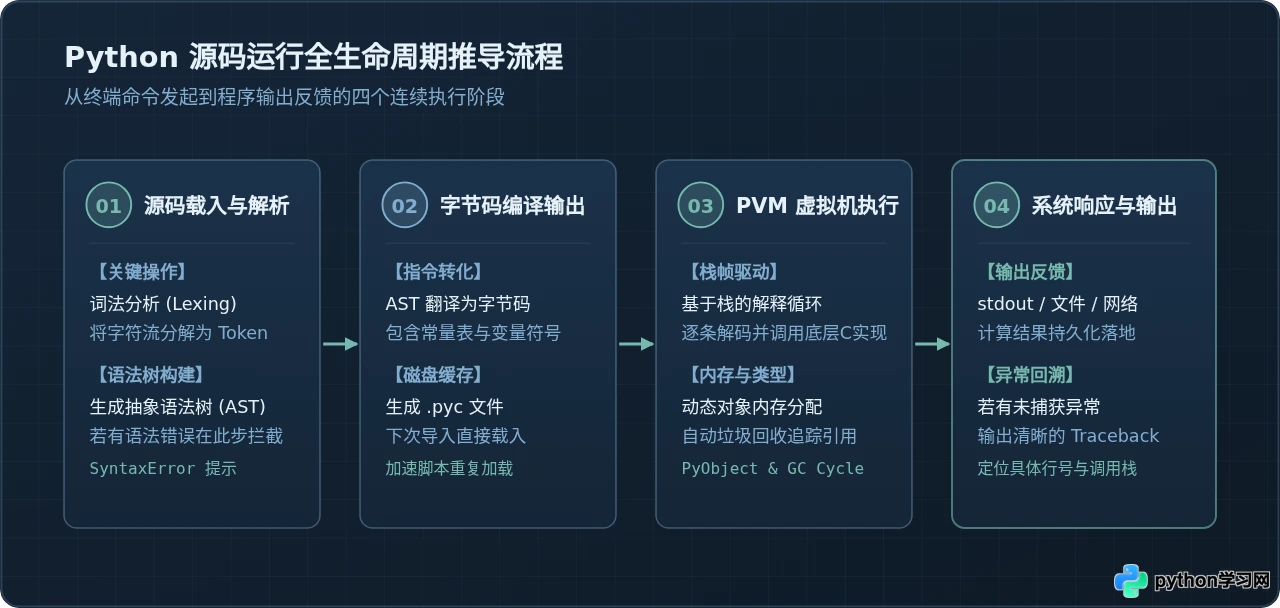
很多初学者以为“解释型”意味着解释器直接读取英文字符串执行,这是一种误解。Python 实际采用了“源码先编译为字节码,再由虚拟机运行字节码”的双层架构:
- 语法与抽象语法树(AST)构建:解释器先对
.py文件进行词法分析(Lexing)与语法解析(Parsing),拆解关键词、标识符与表达式,构建出 AST。如果在这一阶段遇到缺少冒号或缩进不规范,将立即触发SyntaxError。 - 生成平台无关的字节码(Bytecode):AST 经过编译器处理生成一组紧凑的二进制指令集,即字节码。每个指令对应 Python 内置的一个底层操作操作码(Opcode)。若当前脚本作为模块被其他文件导入,解释器会自动将编译好的字节码缓存到
__pycache__目录下的.pyc文件中,下次导入时便可跳过解析阶段,大幅提升加载速度。 - Python虚拟机(PVM)调度执行:PVM 是 Python 运行时的核心引擎。它是一个基于栈(Stack-based)的循环求值引擎,逐条读取字节码指令,分配内存空间,并调用 C 语言编写的底层例程与操作系统进行系统调用。
- 垃圾回收与内存安全管理:PVM 实时维护每个对象的引用计数(Reference Counting)。当一个对象的引用计数归零时,内存立即被回收;对于复杂的循环引用对象,则由分代垃圾回收器(Generational GC)定期扫描释放,杜绝常见的内存泄漏隐患。
三、Python的四大核心特点
在了解了定义与运作机制后,我们可以更深刻地理解 Python 为何能在数据科学、人工智能、网络后端与自动化脚本领域占据核心地位。其核心竞争优势主要体现在以下四个方面:
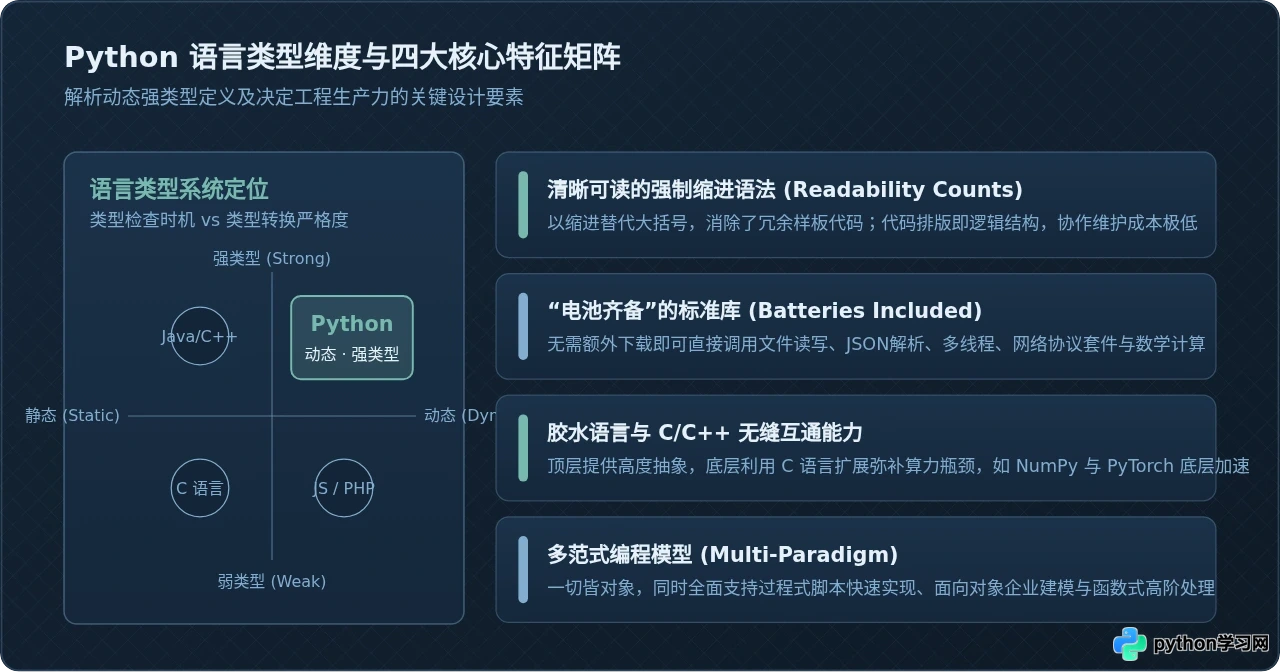
1. 强制缩进与高可读性:代码即设计
在绝大多数传统编程语言(如 C、Java、C++)中,代码块由花括号 {} 界定,缩进仅仅是程序员个人的排版习惯。而在 Python 中,缩进直接代表语法层级(PEP 8 规范推荐使用 4 个空格缩进)。这种设计强制消除了由于格式混乱导致的阅读歧义,使团队协作和代码评审变得极其直观。《Python之禅》(The Zen of Python)中明确写道:“可读性也算数(Readability counts)”。
2. 开箱即用的“电池齐备(Batteries Included)”哲学
安装 Python 解释器后,系统便随附了一套功能完备的标准库。开发者无需配置第三方依赖,即可完成绝大多数通用任务:
math与random:高精度数学计算与随机数生成;os与sys:与操作系统接口、环境变量及文件路径交互;json与csv:解析与序列化结构化数据文件;urllib与http:原生网络通信与请求处理;datetime:时间戳与日期的复杂加减计算。
3. 强大的“胶水语言”属性与 PyPI 生态
Python 具备天然的 C 语言扩展接口(C-API)。当某些算法对计算性能有极高要求(如矩阵乘法、音视频编解码、深度学习神经网络张量计算)时,核心计算模块通常由 C/C++ 或 Rust 编写,而 Python 作为顶层调用接口与逻辑胶水层。官方包仓库 PyPI 拥有海量的第三方开源库,例如科学计算的 NumPy、数据分析的 Pandas、深度学习的 PyTorch 以及高性能 Web 框架 FastAPI,开发者无需重复造轮子。
4. 跨平台兼容与开发敏捷度
同一套 Python 源码,可以在 Windows、macOS、Linux 以及主流云原生容器环境中完全一致地运行。由于省去了冗长的编译与链接步骤,开发团队可以快速编写原型、即时修改并快速验证逻辑,开发迭代速度相比静态编译语言有数倍的提升。
四、实操演练:从编写源码到运行推导的全过程
为了让读者直观感受 Python 编程的操作流程,下面以一个具体场景为例:从一个原始成绩列表中筛选合格数据并计算加权平均分。我们将通过四个明确的推导步骤来观察完整的执行过程。
推导步骤与完整代码示例
在操作系统的任意工作目录中创建一个名为 score_calc.py 的文件,并写入以下完整代码:
# 1. 数据准备:定义学生姓名与成绩字典列表
students = [
    {"name": "张三", "score": 88, "weight": 0.4},
    {"name": "李四", "score": 52, "weight": 0.3},
    {"name": "王五", "score": 95, "weight": 0.3},
    {"name": "赵六", "score": 45, "weight": 0.2},
]

def calculate_qualified_stats(data_list):
    """
    筛选成绩及格(>=60)的学生并计算加权平均分
    """
    # 使用列表推导式高效筛选
    qualified = [item for item in data_list if item["score"] >= 60]

    if not qualified:
        return 0, []

    total_weighted_score = sum(item["score"] * item["weight"] for item in qualified)
    total_weight = sum(item["weight"] for item in qualified)
    average_score = total_weighted_score / total_weight

    return round(average_score, 2), [item["name"] for item in qualified]

# 2. 执行函数调用与打印输出
avg, names = calculate_qualified_stats(students)
print(f"及格学生名单: {names}")
print(f"及格群体加权平均分: {avg}")
在终端环境中,切换至该文件所在目录,输入执行命令:
python3 score_calc.py及格学生名单: ['张三', '王五']
及格群体加权平均分: 91.0
calculate_qualified_stats 函数直接展示了 Python 的动态解包特性(avg, names = ...)与高表达力的列表推导式(List Comprehension)。对比传统语言需要声明多个循环变量与临时数组,Python 仅需数行即可完成数据流的过滤与聚合。
五、技术边界与常见认知误区
任何编程语言都有其适用的场景和工程局限性。客观了解 Python 的边界,能够避免在技术选型中走弯路:
| 特性维度 | 技术现状与原因 | 工程应对策略 |
|---|---|---|
| 单线程执行速度 | 由于字节码解释与动态类型安全检查,原生纯 Python 代码循环执行速度慢于 C/C++ 与 Rust。 | 将密集循环交给 C 扩展库(如 NumPy),或使用 PyPy JIT 编译器加速,或重构关键性能路径。 |
| 全局解释器锁 (GIL) | CPython 内部的 GIL 机制限制了同一时刻只有一个原生线程执行字节码,导致多线程无法充分利用多核 CPU 进行计算密集型任务。 | 计算密集型任务采用 multiprocessing(多进程)充分利用多核;I/O 密集型任务采用 asyncio 协程。 |
| 移动端与原生界面 | iOS 与 Android 官方原生生态以 Swift/Kotlin 为主,Python 打包原生移动应用的体验与性能相对受限。 | 专注于服务端 API 接口开发或桌面轻量运维工具开发,移动端采用专业原生或跨端方案。 |
初学者常误以为 Python 中可以随意乱赋类型。虽然 Python 允许变量重新指向不同对象,但在大型项目中滥用动态特性会导致运行时难以排查的 Bug。现代 Python(从 Python 3.5 起)全面支持类型提示(Type Hints),例如编写
def greet(name: str) -> str:,结合 mypy 静态检查工具,可以在开发阶段就捕获大部分类型不匹配问题。
六、知识全景总结与能力演进路线
理解了“什么叫 Python 编程”,接下来的关键是如何建立合理的学习路径与实践节奏。掌握 Python 并非死记硬背每个内置函数,而是逐步掌握从语法、工程结构、高阶并发到产业生态的阶梯式能力:
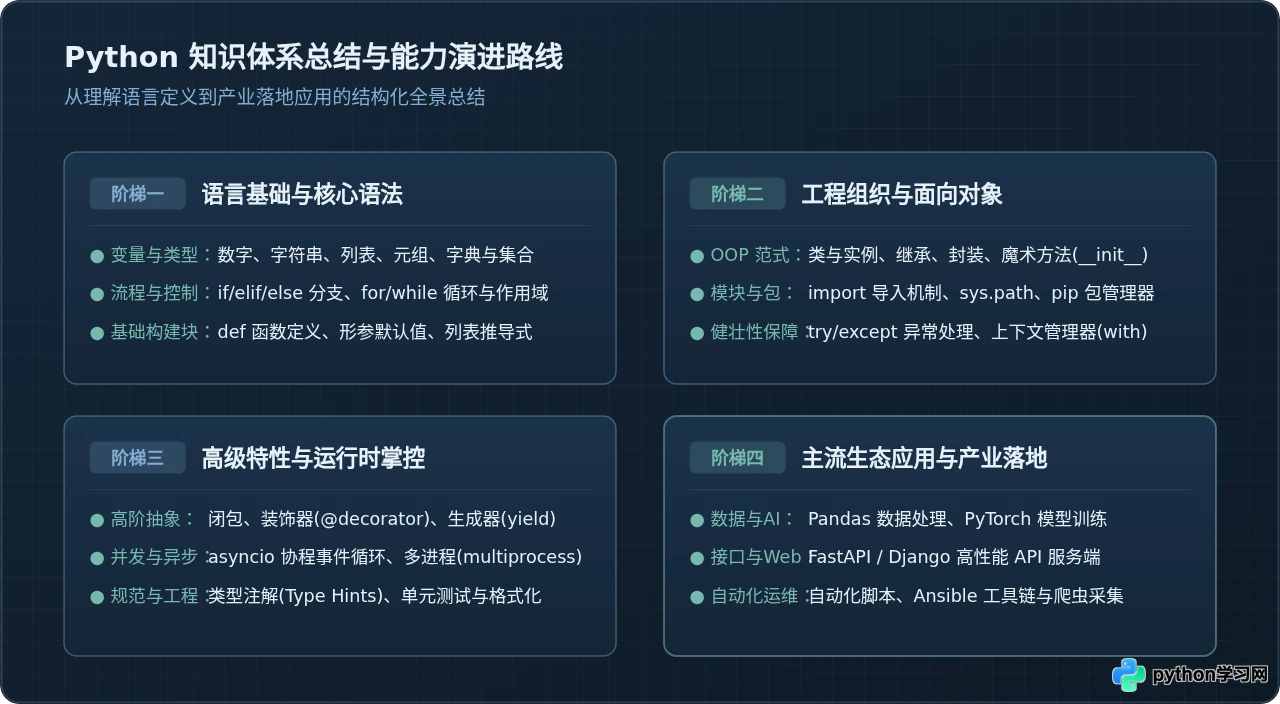
总体而言,Python 编程的核心价值在于以尽可能低的心智负担,快速、精准地将人类思维中的业务逻辑转化为计算机的执行能力。对于初学者来说,从简单的自动化脚本切入,逐步熟悉函数封装、模块拆分与面向对象思维,再结合具体行业领域(如数据分析、AI 建模或自动化运维)深入实践,是掌握 Python 编程最务实高效的路径。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









