

菜鸟教程Python实例解析:文件读写与简单计算入门
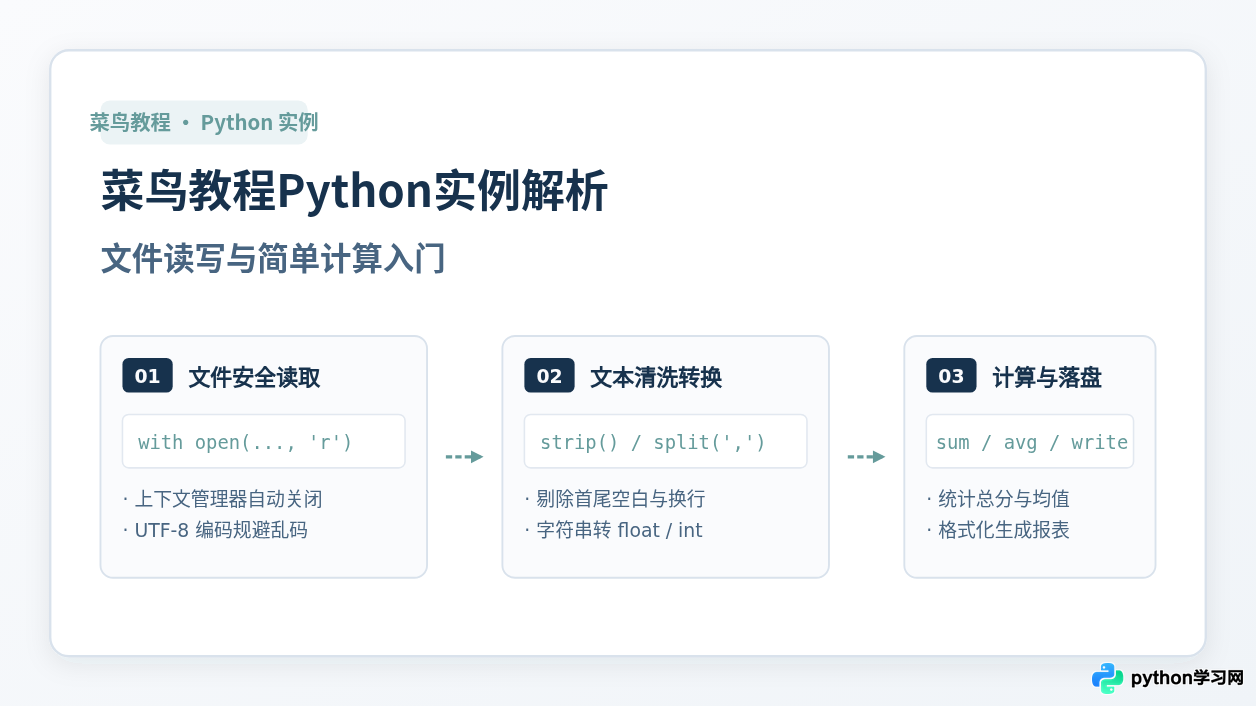
本教程面向初学者,系统解析Python文件读写与简单计算的核心操作。通过具体实例剖析open模式、with语句安全机制、逐行数据清洗、数值转换、累加与均值计算,最终生成结构化报表。
open() 模式解析与 with 上下文生命周期管理讲起,拆解字符串拆分、类型转换、求和均值计算到格式化输出落盘的完整流程,帮助读者掌握文件数据处理与简单计算的核心操作。
一、理解文件读写基础:open 函数与 with 上下文管理
在 Python 中操作文件,核心是使用内置的 open() 函数建立程序与操作系统底层文件系统的连接。该函数返回一个文件对象(File Object),通过该对象可以执行读取或写入操作。
1.1 常见文件访问模式的区别
调用 open(file, mode) 时,mode 参数决定了文件的打开方式与权限边界:
'r'(只读模式):默认模式。文件必须已经存在于目标路径,否则操作系统会立即抛出FileNotFoundError。读取指针初始位于文件最开头。'w'(覆盖写入):用于创建或写入文件。若目标文件已存在,系统会在打开的瞬间清空文件原有内容;若文件不存在,则会自动新建一个空文件。'a'(追加写入):用于在文件末尾追加新数据。原有内容得到保留,写入指针直接移至文件末尾;若文件不存在,也会自动新建。'r+'(读写模式):允许同时执行读写操作,但需要精确管理文件指针位置(配合seek()),初学者建议先掌握单向的读写分离。
1.2 为什么必须使用 with 上下文管理器
在早期的代码示例中,常能看到类似 f = open('data.txt') ... f.close() 的写法。这种写法存在严重的安全隐患:如果中间的数据转换或数学计算代码抛出异常,程序就会中断,后续的 f.close() 将永远不会被执行。这会导致系统文件句柄无法释放、内存泄漏,甚至导致缓冲区中的写入数据丢失。
Python 提供了 with open(...) as f: 上下文管理器语法。它基于 Python 的上下文协议,进入代码块时自动执行 __enter__() 获取句柄,无论代码正常执行完毕还是中途抛出任何异常退出,底层都会自动触发 __exit__() 确保文件被安全关闭。
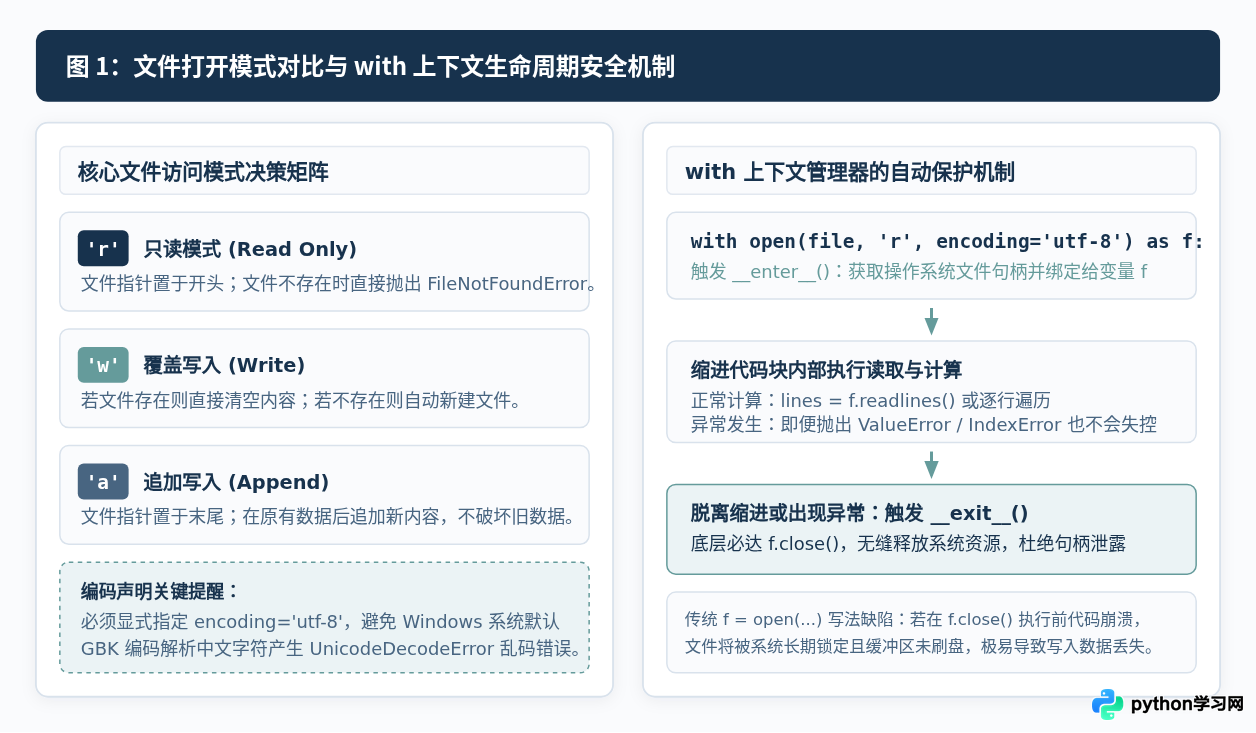
open() 默认采用系统的 ANSI/GBK 编码,如果文件保存为 UTF-8 格式,读取包含中文的文件时极易触发 UnicodeDecodeError。因此,无论读写文本文件,都应养成显式声明 encoding='utf-8' 的好习惯。
二、四种文件读取方式与内存机制解析
打开文件后,如何把文件内容读取到 Python 变量中?Python 提供了四种常见的读取方式,它们在数据返回类型与内存占用特征上存在显著差异。
| 读取方式 | 返回数据类型 | 内存占用特征 | 典型应用场景 |
|---|---|---|---|
f.read() |
str(单个完整字符串) |
一次性将全文件加载至内存,大文件易耗尽内存 | 小型配置、短文本内容一次性加载 |
f.readline() |
str(单行字符串,包含 \n) |
极低,仅在内存中保留当前单行内容 | 逐行协议解析、跳过第一行表头 |
f.readlines() |
list[str](由各行组成的列表) |
全量读取并创建列表,存在列表元数据开销 | 中小型文件需要根据索引随机切片 |
for line in f: |
迭代器流式产出 str |
极低且恒定,底层基于缓冲区惰性加载 | 推荐规范:各种规模文件的逐行清洗与计算 |
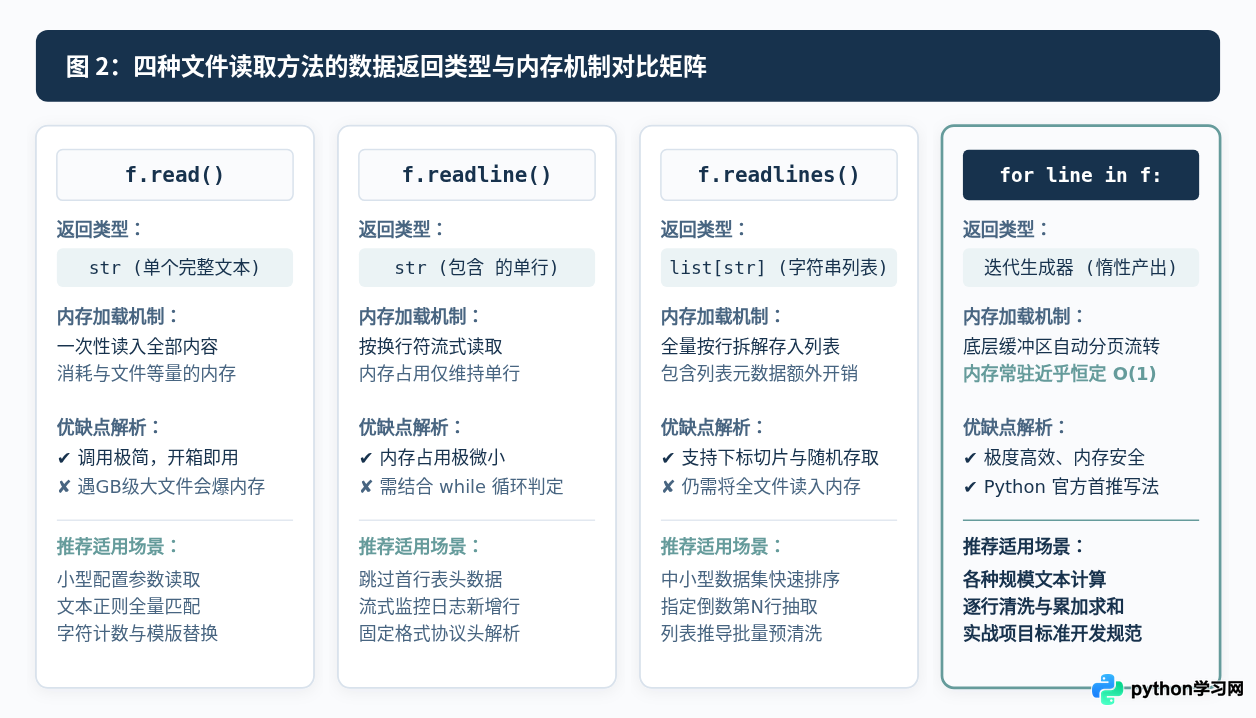
对于初学者进行数据清洗和简单计算,直接使用 for line in f: 进行遍历是最优选择。它不仅语法极其优雅,而且即使面对几百兆的大型数据文本,也不会出现内存飙升的问题。
三、结合简单计算的实战实例解析
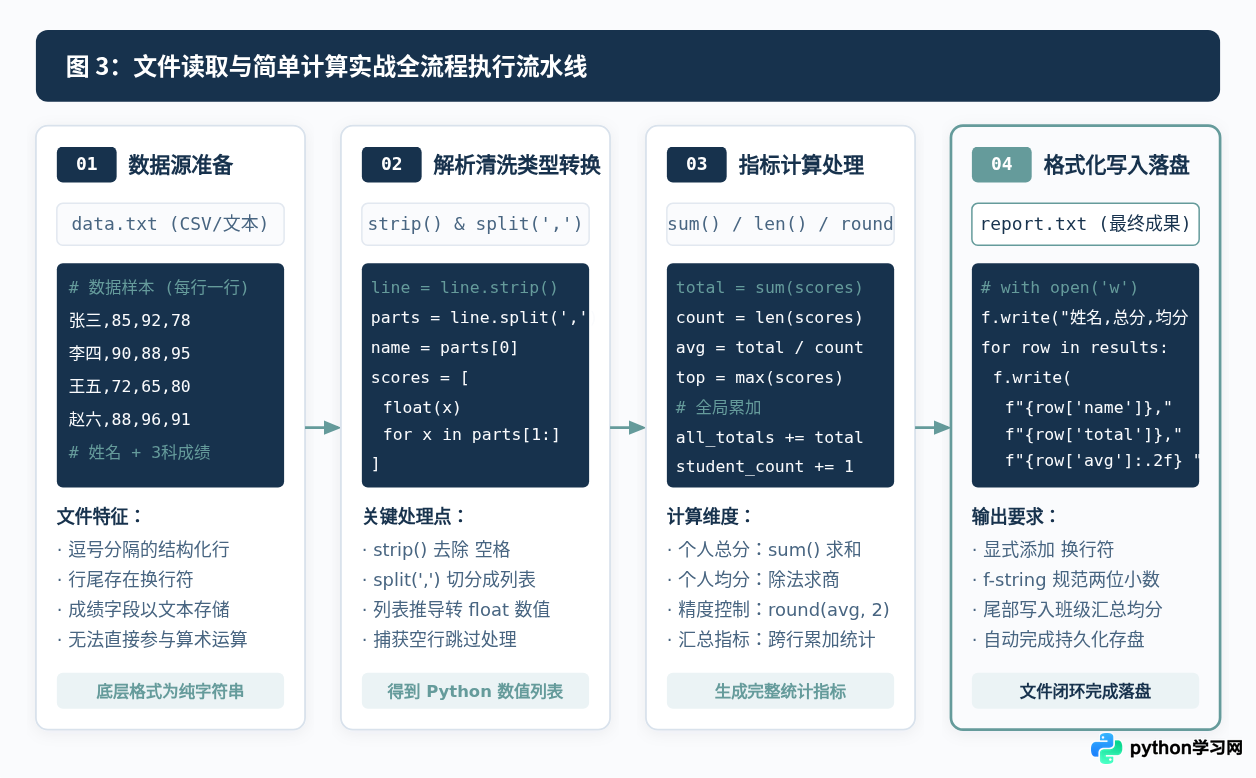
下面我们通过一个完整的真实实例,演示如何从文本文件中读取多名学生的各科成绩,进行去噪清洗、转换为浮点数,计算个人总分、平均分以及全班总均分,并最终输出一份格式化的统计报表。
3.1 准备测试数据文件(scores.txt)
首先,在当前工作目录下准备一个名为 scores.txt 的纯文本文件。每行记录一名学生的姓名及语文、数学、英语三门科目的成绩,字段间使用英文逗号隔开,并夹带少量空行作为实际业务中的干扰数据:
张三,85,92,78
李四,90,88,95

王五,72,65,80
赵六,88,96,91
钱七,60,70,68
3.2 完整处理与计算代码
编写以下 Python 脚本,完成数据读入、去空行、切分字段、类型转换、累加均值计算以及格式化写盘:
# -*- coding: utf-8 -*-
"""
Python 文件读写与简单计算实战实例
功能:读取 scores.txt 成绩数据,计算个人总分、均分及班级统计指标,输出至 report.txt
"""

input_path = "scores.txt"
output_path = "report.txt"

# 存储解析后的学生统计结果
student_records = []
class_total_score = 0.0
total_score_items = 0

# 第一步:安全打开并读取源文件
with open(input_path, mode="r", encoding="utf-8") as file:
    for line_num, line in enumerate(file, start=1):
        # 1. 清理首尾多余空白字符与换行符
        cleaned_line = line.strip()

        # 2. 防御性检查:跳过空行
        if not cleaned_line:
            continue

        # 3. 按照逗号拆分字段
        parts = cleaned_line.split(",")
        name = parts[0]
        score_strings = parts[1:]

        # 4. 字符串类型转换为浮点数值进行数学计算
        try:
            scores = [float(s.strip()) for s in score_strings]
        except ValueError as err:
            print(f"第 {line_num} 行数据存在非数值异常,已跳过:{err}")
            continue

        # 5. 执行简单数学计算:求和、计数、计算平均分
        personal_total = sum(scores)
        subject_count = len(scores)
        personal_avg = personal_total / subject_count if subject_count > 0 else 0.0

        # 收集个人结果
        student_records.append({
            "name": name,
            "total": personal_total,
            "avg": personal_avg,
            "top": max(scores)
        })

        # 累加班级整体指标
        class_total_score += personal_total
        total_score_items += subject_count

# 计算全班整体平均分
class_avg_score = class_total_score / total_score_items if total_score_items > 0 else 0.0

# 第二步:将计算结果格式化写入目标报表文件
with open(output_path, mode="w", encoding="utf-8") as out_file:
    # 写入表头
    out_file.write("=" * 46 + "\n")
    out_file.write(f"{'姓名':<8}\t{'总分':>8}\t{'平均分':>8}\t{'单科最高':>8}\n")
    out_file.write("-" * 46 + "\n")

    # 循环写入每个学生的明细行
    for record in student_records:
        line_str = (
            f"{record['name']:<8}\t"
            f"{record['total']:>8.1f}\t"
            f"{record['avg']:>8.2f}\t"
            f"{record['top']:>8.1f}\n"
        )
        out_file.write(line_str)

    # 写入班级汇总统计行
    out_file.write("=" * 46 + "\n")
    out_file.write(f"学生总数: {len(student_records)} 人\n")
    out_file.write(f"全科总分: {class_total_score:.1f} 分\n")
    out_file.write(f"全班均分: {class_avg_score:.2f} 分\n")

print(f"数据处理完成,统计报表已成功生成至 {output_path}")
3.3 运行结果验证
执行上述脚本后,在同一目录下会生成一份排版整齐的 report.txt 文件。打开该文件,内容展示如下:
==============================================
姓名      	      总分	     平均分	    单科最高
----------------------------------------------
张三      	   255.0	   85.00	    92.0
李四      	   273.0	   91.00	    95.0
王五      	   217.0	   72.33	    80.0
赵六      	   275.0	   91.67	    96.0
钱七      	   198.0	   66.00	    70.0
==============================================
学生总数: 5 人
全科总分: 1218.0 分
全班均分: 81.20 分
通过对比可以看到,原本零散的纯文本数字,经过 Python 的逐行遍历、类型转换和简单算术计算,被准确加工成了包含个人总分、平均分、单科极值以及班级宏观统计指标的结构化数据报表。
四、关键细节与避坑指南
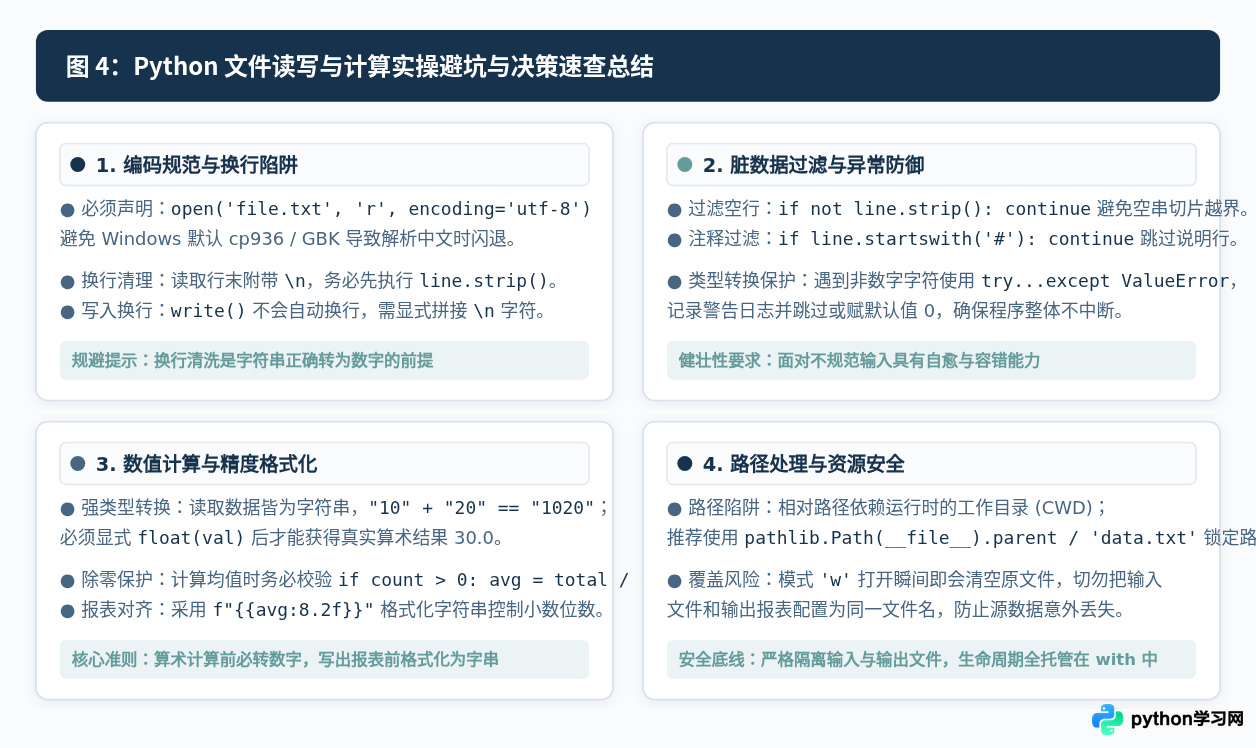
初学者在结合文件读写进行计算时,常常会因为细节问题遇到报错或计算结果不符合预期。以下总结了四处最容易出现问题的关键点。
4.1 字符串加法与数值加法的本质差异
从文件中读取出来的所有内容,其初始数据类型全部是字符串(str)。如果直接执行加法操作:
a = "85"
b = "92"
print(a + b)  # 输出结果是 "8592",发生的是字符串拼接!
必须显式调用 float() 或 int() 完成类型转换,计算机才会按照代数规则进行数值相加:
print(float(a) + float(b)) # 输出结果是 177.0,得到正确的数值和4.2 换行符与空白字符清理
使用 for line in file: 迭代时,line 字符串末尾会保留原文本的换行符 \n(Windows 下可能为 \r\n)。如果直接对其进行切分,最后一个元素会带上换行符。例如 "张三,85,92,78\n".split(",") 得到的最后一个元素是 "78\n"。虽然直接 float("78\n") 在 Python 中能够容错解析,但在进行字符串比对或字典键索引时极易引发隐藏 Bug。因此,先执行 line.strip() 剥除首尾空白与换行,再执行 split(),是严谨规范的操作步骤。
4.3 写入文件时的换行与格式化控制
很多初学者会疑惑:为什么用 print() 可以在控制台自动换行,而用 file.write() 写出来的文件所有内容全部挤在同一行?这是因为 file.write() 不会像 print() 那样默认在行末附加 \n。向文件写入内容时,每写完一行数据,必须在格式化字符串末尾显式加入 \n。
同时,在输出计算结果时,平均值等浮点数可能会出现类似 72.33333333333333 这样的长循环小数。推荐使用 Python 的 f-string 语法控制显示格式:
f"{val:.2f}":将浮点数保留两位小数输出。f"{val:>8.1f}":右对齐且占位宽度为 8 个字符,保留 1 位小数,非常适合用于文本表格对齐。
4.4 路径定位与防覆盖原则
如果在终端运行脚本时提示 FileNotFoundError: [Errno 2] No such file or directory: 'scores.txt',通常是因为命令执行时所在的当前工作目录与数据文件所在的文件夹不一致。在稍复杂的工程中,建议使用标准库 pathlib.Path(__file__).parent / 'scores.txt' 构建绝对路径,确保脚本在任何目录下触发执行都能准确定位文件。
另外务必牢记:以 'w' 模式打开文件是极其不可逆的操作。只要 open('file.txt', 'w') 被执行,原文件的历史数据就会立即被清空。切勿在指定输出文件名时不慎写错成输入数据文件名,造成源数据彻底丢失。
五、总结与核心知识清单
掌握“文件读写”与“简单计算”的结合运用,是 Python 解决日常自动化办公与数据统计需求的关键第一步。本文介绍的核心工作流可以精炼为以下四步口诀:
- 安全开闭:统一使用
with open(path, 'r', encoding='utf-8') as f:,保障资源不泄露、编码不乱码。 - 逐行清洗:采用
for line in f:逐行迭代,结合strip()与split()剔除干扰并分解字段。 - 类型转换:显式将字符串转换为
float或int,配合sum()、len()、max()完成业务指标计算。 - 格式回写:利用
'w'模式与 f-string 规范格式化占位符,手动拼接\n规整输出持久化报表。
读者可在本文代码的基础上,尝试引入更高维度的计算规则,例如判断及格率、给成绩自动划分优良中差等级,或者按总分高低进行排序输出,进一步巩固 Python 的实际应用能力。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









