

想转行做数据分析师或AI工程师,为什么首选Python
针对计划转行数据分析师或AI工程师的学习者,深度解析首选Python的核心原因、技术生态优势、两条职业路线的技能交集、客观局限与完整的阶段化转型学习方案。
对于计划转行进入数据分析或人工智能领域的学习者,选择第一门编程语言的核心原则是:在最短时间内建立对数据结构的直观感知,同时让掌握的技术资产在未来的职业发展中不被轻易淘汰。Python 并不是性能极致的系统级语言,也不是唯一能处理数据的工具,但它是当下唯一能够无缝贯通“业务数据清洗、统计探索、机器学习建模与生产级深度学习”全流程的通用语言。转行首选 Python,本质上是用最低的初期认知摩擦,换取一条进可深造 AI 算法、退可胜任数据分析的最高性价比通路。
一、双轨并进:数据分析与AI工程师的技能交集
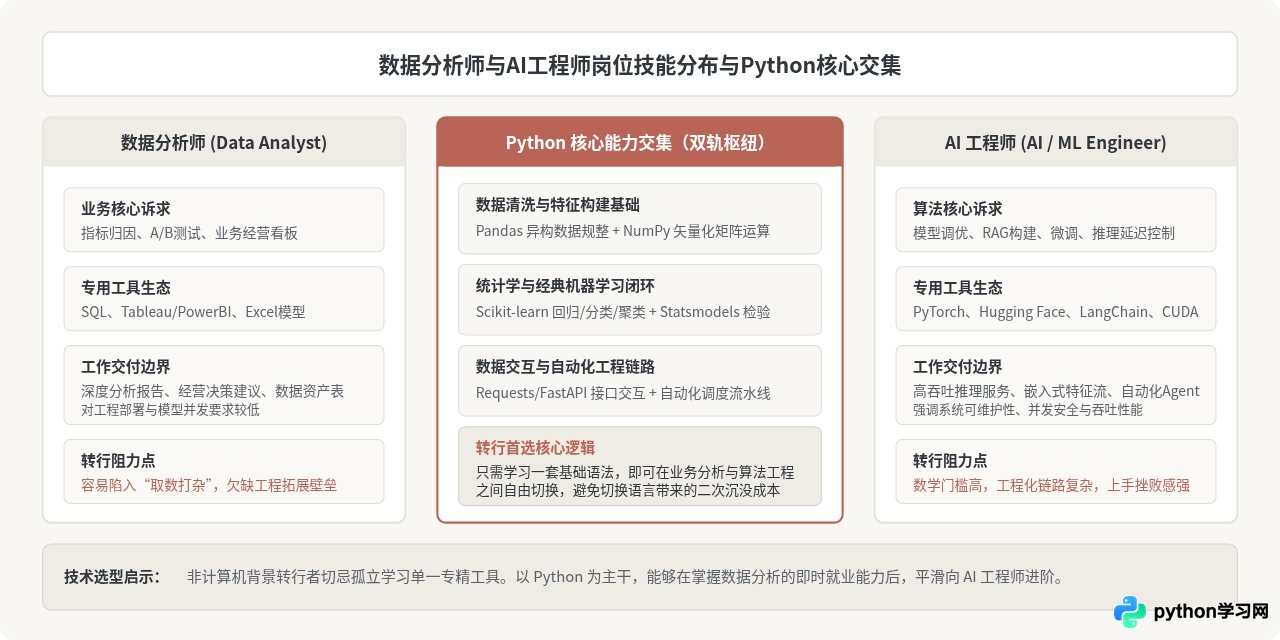
转行者在初期往往面临定位纠结:数据分析师(Data Analyst, DA)重在通过数据解释业务、量化指标并驱动商业决策;而人工智能工程师(AI/Machine Learning Engineer)则聚焦于数学建模、特征管道搭建、模型训练调优与系统工程化部署。尽管二者的最终交付物不同,但在技术底层却共享一套极其关键的“最小公倍数”能力体系:
- 数据塑形与清洗能力:无论是为报表准备干净的时间序列,还是为大模型训练构建高质量的上下文语料,都需要处理缺失值、异常分布、非结构化文本拆解以及特征标准化。
- 矩阵与矢量化运算认知:从基础的多维透视表,到底层张量(Tensor)的前向传播,对高维数据维度的理解是两个岗位共同的技术语言。
- 快速原型验证能力:业务分析需要快速验证因果假设,AI 开发需要在几小时内验证某个预训练模型对私有数据的微调效果。
如果选择专精于单一领域的语言(例如专用于报表分析的 SQL,或专用于统计学术研究的 R),当后续希望向复杂算法或深度学习拓展时,往往需要彻底推翻已有语法重修。而 Python 在两条路线上都拥有官方标准级的工具链支撑,学会一套核心语法,相当于同时持有了通往两个方向的基础门票。
二、为什么是Python:生态护城河与计算架构分层
许多初学者会产生一个技术疑问:Python 作为一门动态解释型语言,存在单线程全局解释器锁(GIL)且运行速度较慢,为什么在对算力要求极高的大数据与人工智能领域反而占据了绝对垄断地位?
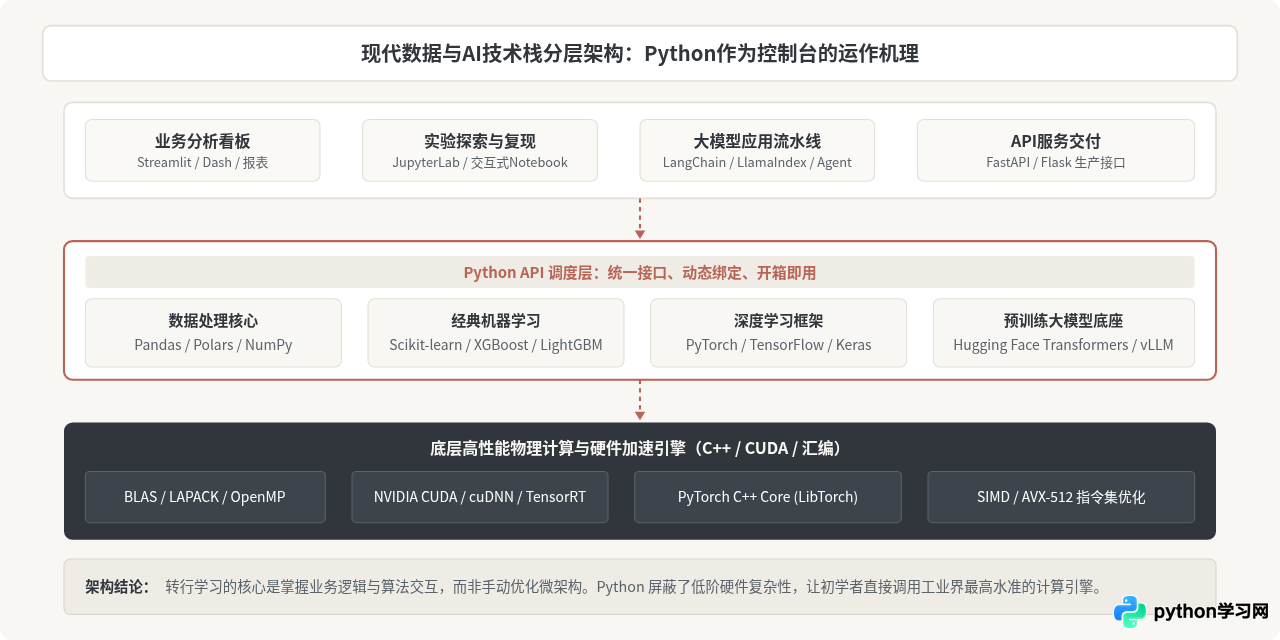
答案在于现代数据科学的架构分层:Python 的角色不是“底层计算引擎”,而是“顶层控制台与黏合剂”。
1. 胶水语言机制:C/C++ 底层加速与 Python 顶层表达
在 Python 中执行一段数值运算时,表面上使用的是易读简洁的 Python 语法,但真正的计算指令已经被下发到底层的 C、C++ 或 Fortran 编译库中执行。例如:
NumPy的核心矩阵操作直接调用高度优化的 BLAS/LAPACK 底层硬件加速库;PyTorch的深度张量运算在底层直接映射为针对显卡架构定制的 NVIDIA CUDA / cuDNN 原生 C++ 内核;Pandas在处理海量表格时,内部也是基于连续内存块的高效指针运算。
这种“底层极致性能 + 上层极致易用”的双层架构,让转行者免于陷入内存手动分配、指针悬挂与繁琐编译检查的泥潭,能够把全部心智模型集中在数据本身的业务逻辑与算法实验上。
2. 现实生态的“单向吸附力”
在技术选型中,生态规模决定了求职市场的容量与遇到问题时的解决成本:
- 顶级开源模型的第一接口:无论是 Meta 发布的 LLaMA 系列、Mistral,还是 Hugging Face 社区中几十万个开源权重,其官方推理代码、微调代码库与微调脚本首发均为 Python。用其他语言不仅缺少直接适配的驱动,还脱离了全球开源研发的第一现场。
- 开箱即用的技术文档与社区问答:当数据清洗遇到异常字符编码、时间戳带时区错位或模型训练梯度爆炸时,Python 在 Stack Overflow 与 GitHub 上的解决方案覆盖率居所有语言之首,极大地降低了转行初期的排错摩擦。
- 标准化的生产流转工具:无论企业后端是用 Java、Go 还是 C++ 编写,算法团队交付的产物(如 ONNX 格式、Pickle 模型文件或独立 Docker 微服务)通常都是由 Python 脚本导出的。Python 已经成为了数据交付的行业通用协议。
三、可落地的四阶段转行实操路径
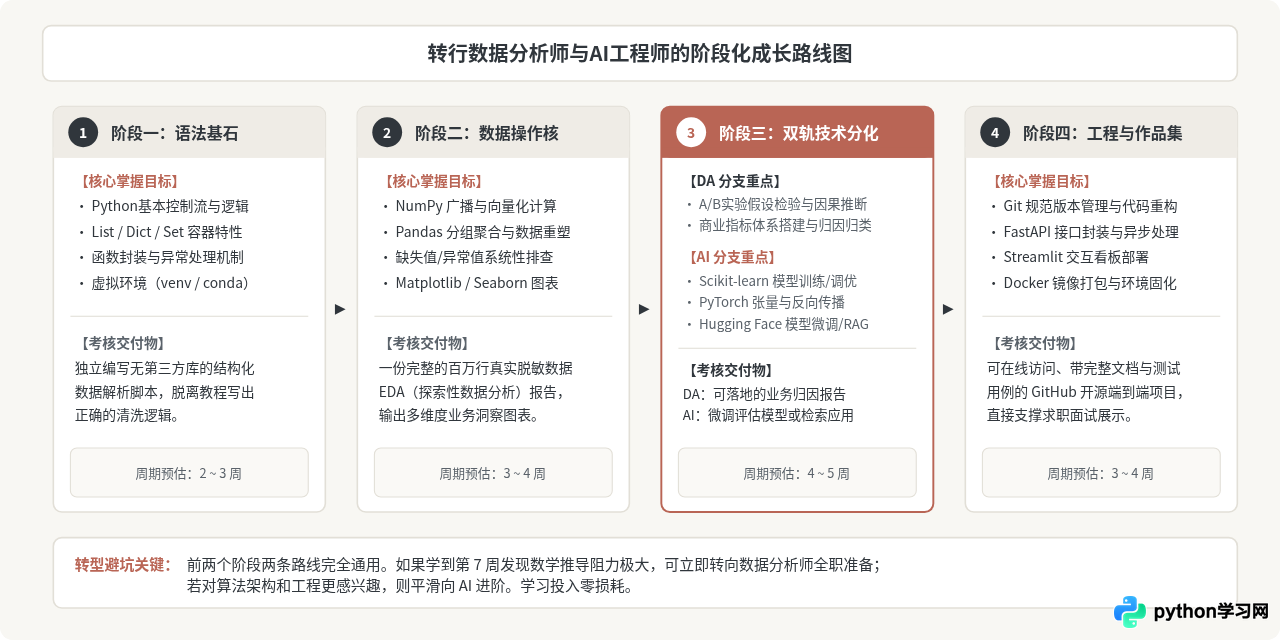
许多转行者在刚接触 Python 时容易陷入“反复背诵基本语法”或“只看教程却不会自己写”的死胡同。高效的学习路径应当以项目输出为导向,分为四个循序渐进的阶段:
阶段 1:核心语法与数据结构(第 1-3 周)
本阶段的目标不是成为全栈软件工程师,而是熟悉数据处理的核心控制流与容器操作。不要花大量时间钻研复杂的类元编程,把精力集中在以下核心点:
- 基础容器类型的使用边界:
list(有序可变列表)、dict(哈希键值对检索)、set(去重与集合运算)、tuple(不可变元组)。 - 列表推导式(List Comprehension)与字典推导式:编写简洁高效的数据预处理代码。
- 函数封装、作用域规则与错误捕获(
try-except):编写具备基本防御性容错能力的处理脚本。
阶段 2:数据清洗与探索性分析(EDA)(第 4-7 周)
这是数据分析师的核心基本功,也是 AI 工程师进行特征工程的前提。必须脱离纯控制台输出,进入 JupyterLab 交互环境:
- Pandas 进阶操作:使用
groupby进行分组聚合统计、merge与concat模拟 SQL 中的多表连接、apply批量转换,以及处理时间序列与缺失值插补。 - 数据可视化:掌握
Matplotlib与Seaborn,能够绘制箱线图排查离群值、热力图观察多变量相关系数、直方图观察特征分布偏度。 - 与 SQL 联动:使用
SQLAlchemy建立数据库连接,直接把 SQL 查询结果流转至 Pandas DataFrame 进行二次计算。
实操代码片段示例:从数据库直接拉取数据并完成特征归一化与分组统计
import pandas as pd
import numpy as np

# 模拟业务原始数据读取
data = {
    'user_id': [1001, 1002, 1003, 1004, 1005],
    'department': ['Sales', 'Sales', 'Tech', 'Tech', 'Operations'],
    'revenue': [45000, 52000, 31000, np.nan, 28000],
    'active_days': [120, 140, 80, 95, 45]
}

df = pd.DataFrame(data)

# 1. 缺失值插补:采用部门中位数填充
df['revenue'] = df['revenue'].fillna(
    df.groupby('department')['revenue'].transform('median')
)

# 2. 特征构造:人均单日创收
df['revenue_per_day'] = df['revenue'] / df['active_days']

# 3. 分组聚合统计
summary = df.groupby('department').agg(
    total_rev=('revenue', 'sum'),
    avg_active_days=('active_days', 'mean'),
    headcount=('user_id', 'count')
).reset_index()

# 示例输出验证
print("=== 处理后业务指标汇总 ===")
print(summary)
阶段 3:职业路径专项分流(第 8-12 周)
在此阶段,学习者应根据个人背景与求职诉求明确侧重点:
- 数据分析方向:深入统计推断假设检验(T 检验、卡方检验、置信区间)、A/B 测试实验设计、漏斗模型与队列留存分析,重点产出具有业务商业洞察的项目分析复盘。
- AI 工程师方向:学习线性代数矩阵运算本质,使用
Scikit-learn掌握特征标准化、交叉验证与经典算法(逻辑回归、随机森林、XGBoost);随后进入PyTorch学习反向传播自动求导与多层感知机(MLP),掌握 Hugging Face Transformers 调用预训练模型与向量数据库检索(RAG)。
阶段 4:工程化交付与作品集封装(第 13-16 周)
求职简历中最容易拉开差距的部分是项目的工程可信度:
- 脱离单一的
.ipynb笔记,将核心逻辑拆分为模块化的.py脚本,编写规范的函数文档与类型注解(Type Hints)。 - 使用
Git记录开发迭代过程,附带清晰的README.md,交代数据来源、环境依赖(requirements.txt或pyproject.toml)、运行步骤与指标评估基准。 - 如果涉及 AI 应用,使用
FastAPI将模型封装为 RESTful 服务,或用Streamlit搭建可交互的演示网页,给面试官最直观的操作入口。
四、客观边界与反例:什么时候Python不是唯一答案?
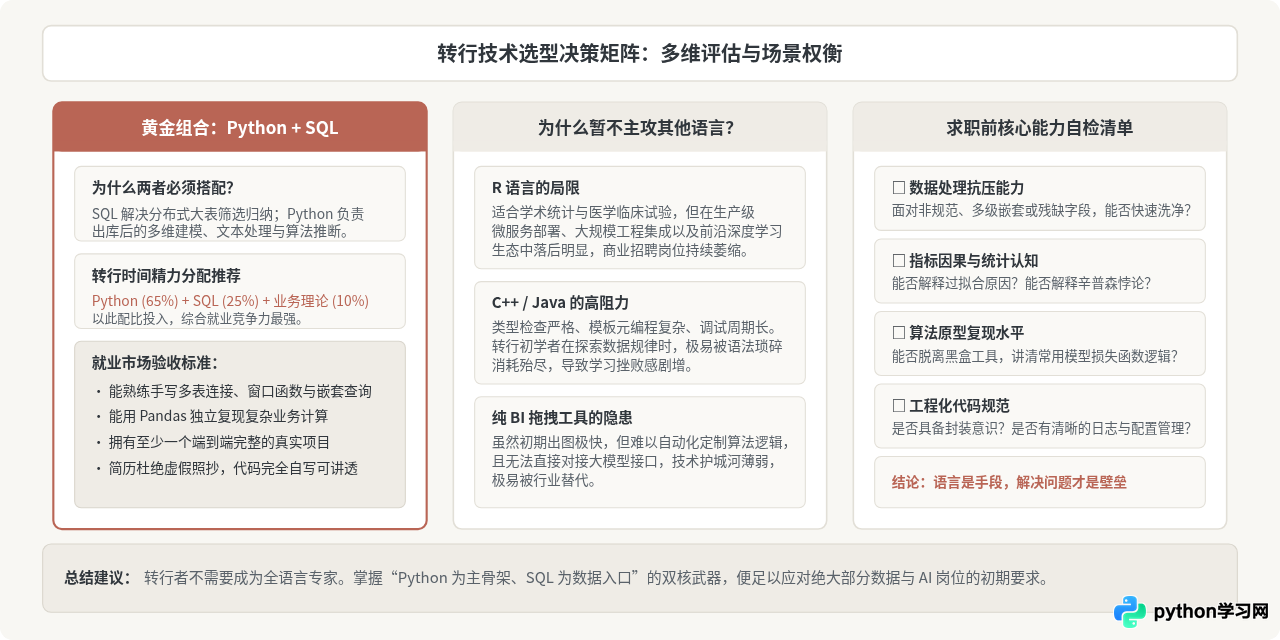
讨论语言优势必须保持客观。Python 是转行切入的极佳起点,但在真实的生产环境中,它并不是无所不能的银弹。清醒认识 Python 的短板,能够避免在求职和实际工作中产生盲目认知:
1. 数据库取数环节:SQL 具有绝对优先权
在数据分析师的日常工作中,数据提取与粗加工通常发生在分布式数据仓库(如 Hive、ClickHouse、Snowflake)中。在 TB 甚至 PB 级数据规模下,永远应当优先使用 SQL 在数据库服务端完成过滤与聚合,而不是把全部海量原始明细拉入本地内存用 Python 循环遍历。Python 的强项在于数据规整后的深度探索、统计测试与复杂算法建模,而非替代分布式查询引擎。
2. 超低延迟与超高吞吐:C++ / Rust / Go 的工程主场
在 AI 模型的生产推理部署环节(例如自动驾驶机载端感知、高频量化交易撮合系统),微秒级的延迟抖动至关重要。虽然模型的训练与权重导出几乎全部在 Python 下完成,但一旦进入高并发生产网关,工程团队往往会将模型转换为 ONNX 或 TensorRT 引擎,并使用 C++ 或 Rust 编写原生常驻服务进行调用。转行初学者无须过早担心该瓶颈,但在涉及系统高并发架构时需明确分工边界。
3. “只会写脚本”与“具备工程素养”的鸿沟
很多转行者误以为把官方文档的十几行模型调用代码抄写一遍并能跑通就代表掌握了技能。但企业招聘更看重的是:
- 代码的可维护性与模块化解耦,是否遵循 PEP 8 规范;
- 对数据分布飘移、异常边界条件的防范处理;
- 在内存受限(OOM)时,是否懂得利用数据生成器(Generator)、按块读取(Chunking)或降精度(FP16/INT8)进行优化;
- 业务理解能力与因果分析逻辑:算法指标提升是否真正能带来业务收入或成本节约。
| 对比维度 | Python | SQL | R 语言 | C++ / Java | 商业 BI (Tableau/PowerBI) |
|---|---|---|---|---|---|
| 转行学习曲线 | 平缓,语法接近伪代码 | 极低,以声明式查询为主 | 中等,偏向统计学思维 | 陡峭,需掌握强类型与内存管理 | 极低,拖拽式可视化为主 |
| 数据清洗与塑形 | 强大,处理半/非结构化数据极佳 | 擅长结构化表关联与分组聚合 | 优秀,数据框操作直观 | 开发效率低,代码冗长 | 仅适合轻量数据规整 |
| AI 与深度学习 | 全球行业标准,垄断级生态 | 仅限简单的库内预测函数 | 支持传统机器学习,DL生态弱 | 底层支撑强,但不适合算法实验 | 不支持深度模型微调与训练 |
| 服务部署与工程化 | 优秀,API生态完备(FastAPI) | 仅作为存储层交互 | 服务化部署方案相对小众 | 极致高吞吐、低延迟高并发 | 仅作为报告呈现端 |
| 求职组合推荐 | 必选主干核心 | 必须搭配掌握(不可替代) | 学术研究/生物医药领域可选 | 中后期系统性能优化深入学习 | 数据分析初级岗位快速上手 |
五、总结:把握转行学习的本质逻辑
转行做数据分析师或 AI 工程师,首选 Python 的终极理由并非“Python 在每一个单独维度都是世界第一”,而是它在学习曲线、生态厚度、应用弹性与职业迁移成本之间取得了完美的平衡。
学习编程语言最忌讳的是“把语言本身当成终点”。对于转行者而言,Python 是一个高容错、强支撑的支点——它让你在极短时间内写出能够实际运转的代码,从数据中获得真实的商业结论,或者让机器学习模型给出精准的预测结果。正是这种正向的正反馈,能支撑你跨越转行过程中最艰难的初期迷茫,最终成长为具备独立解决复杂数据与算法问题能力的专业人才。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









