

Python基础语法详解:变量、函数与控制流入门
深入详解Python核心基础语法,涵盖变量声明与内存引用机制、条件判断与循环控制流、函数定义与参数作用域,配合图解与代码示例帮助初学者建立扎实的编程认知。
学习 Python 编程的核心在于掌握程序如何存储数据、如何根据逻辑做出决定以及如何复用功能单元。变量、控制流与函数是支撑 Python 编程大厦的三大基石:变量负责建立名字与数据的绑定关系,控制流主导代码的执行分支与迭代逻辑,而函数则负责封装可复用的逻辑段落。本文将避开复杂的抽象概念,直奔核心语法与底层原理,通过规范示例帮助初学者建立扎实且清晰的 Python 编码认知。
一、变量与对象引用机制
在许多编译型语言(如 C 或 Java)中,定义变量类似于开辟一个固定规格的“盒子”,并将数据放入其中。但在 Python 中,变量更像是一个贴在数据实体上的“标签”或指针。理解这一引用机制是掌握 Python 变量行为的关键所在。
1. 变量赋值与动态类型
Python 是强类型的动态类型语言。在定义变量时无需声明变量类型,赋值操作会直接在内存中创建对象,并将变量名绑定到该对象上:
# 整数与浮点数赋值
count = 10
price = 99.5

# 字符串与布尔值
user_name = "Alice"
is_active = True

# 动态改变绑定对象
status = "pending"
status = 200  # 变量名 status 现在指向一个整数对象
变量命名需遵循下划线命名法(snake_case),仅能由字母、数字和下划线组成,且不能以数字开头,同时应规避 Python 内置关键字(如 class、def、if 等)。
2. 内存引用的工作模式
当执行 b = a 时,Python 并没有复制 a 所指向的数据内容,而是让 b 同样指向 a 当时所绑定的内存地址。通过内置函数 id() 可以查看对象在内存中的唯一标识符。
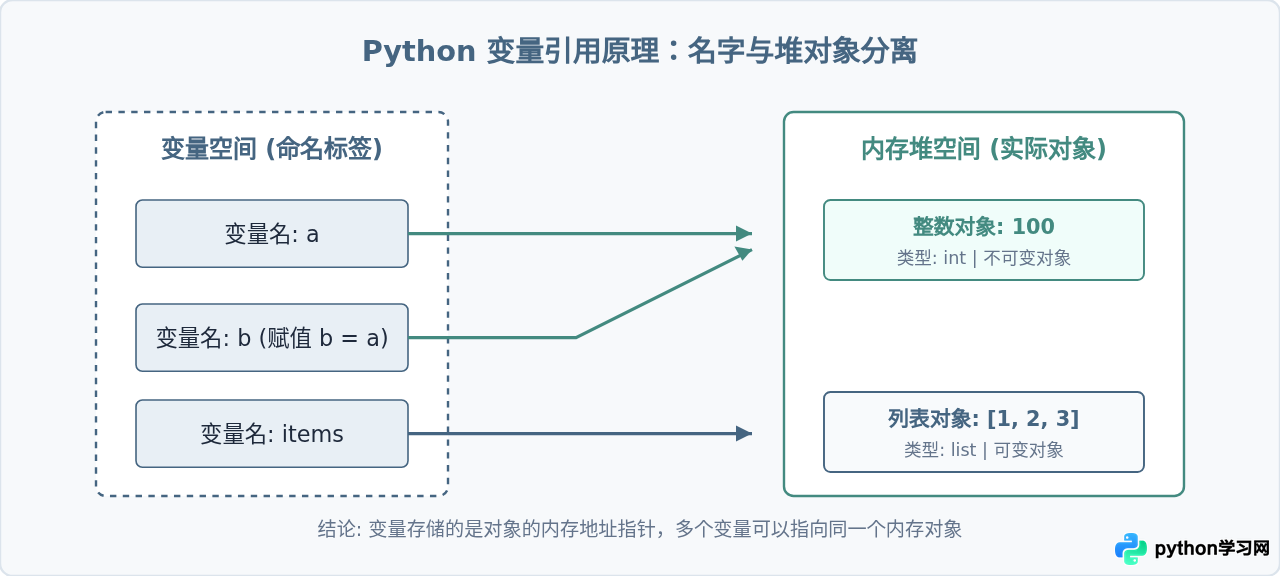
像数字(int, float)、字符串(str)、元组(tuple)属于不可变对象;而列表(list)、字典(dict)、集合(set)属于可变对象。对于可变对象,如果两个变量指向同一个列表,修改其中一个变量的内容,另一个变量也会观察到变化。
二、程序流程控制:条件分支与循环
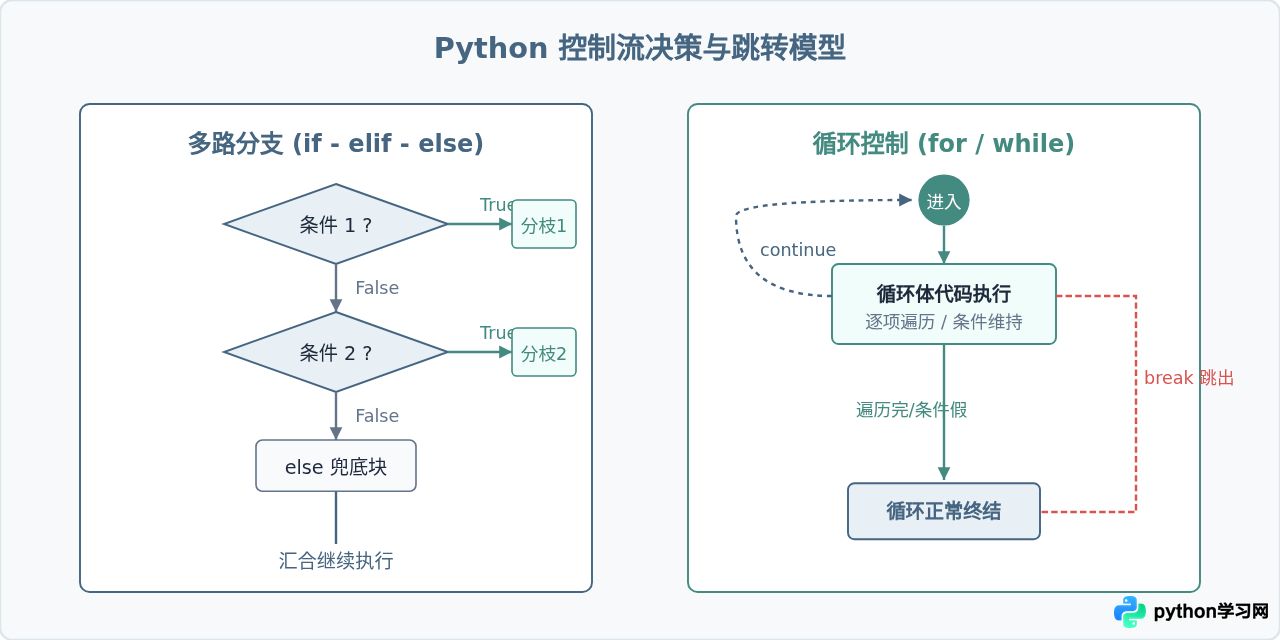
计算机程序的执行默认是自上而下顺序进行的。控制流语句(Control Flow)允许程序在遇到不同数据时选择执行分支,或者重复执行一段运算逻辑直至满足终止条件。
1. 条件判断(if - elif - else)
Python 依靠严格的缩进(通常为4个空格)来界定代码块,替代了传统语言的大括号 {}。条件表达式的结果会被求值为布尔值 True 或 False:
score = 85

if score >= 90:
    grade = "A"
elif score >= 80:
    grade = "B"
elif score >= 60:
    grade = "C"
else:
    grade = "D"

print(f"得分评级为: {grade}")  # 示例输出:得分评级为: B
在判断条件中,常用比较运算符包括 ==、!=、>、<、>=、<=,逻辑组合使用 and、or、not。
2. 循环结构与流向中断
Python 提供了两种核心循环:基于区间的 for ... in 迭代循环,以及基于状态成立条件的 while 条件循环。
- for 循环:用于遍历任何可迭代序列(如列表、字符串、元组)或配合
range()生成数字序列。 - while 循环:只要给定条件保持为真就会持续执行,循环体内必须有促使条件向假转变的变更语句,避免死循环。
- break:立刻终止并跳出当前整个循环体。
- continue:跳过当前这一轮迭代的剩余语句,直接进入下一次循环判断。
# 循环综合示例:结合 continue 与 break
numbers = [12, -5, 8, 0, 15, -3, 20]
valid_sum = 0

for num in numbers:
    if num < 0:
        continue  # 忽略负数,直接开始下一轮
    if num == 0:
        print("遇到终止标记 0,提前结束统计")
        break     # 退出循环
    valid_sum += num

print(f"累计有效和: {valid_sum}")
# 示例输出:
# 遇到终止标记 0,提前结束统计
# 累计有效和: 20
三、函数定义与模块化封装
当一段特定功能的逻辑需要被重复执行时,将其编写为独立函数是最好的工程实践。函数能够消除重复代码、增强程序可读性,并通过输入参数与输出返回值完成清晰的数据交互。
1. 函数定义与参数机制
Python 使用 def 关键字定义函数。函数可以接收位置参数、默认参数、关键字参数以及可变参数:
def calculate_discount(price, rate=0.9, min_threshold=100):
    """
    计算折后价格
    :param price: 原价(必须提供)
    :param rate: 折扣比例(默认 0.9)
    :param min_threshold: 触发门槛(默认 100)
    :return: 最终结算价
    """
    if price >= min_threshold:
        return round(price * rate, 2)
    return price

# 按照位置调用
p1 = calculate_discount(150)             # 使用默认折扣 0.9 -> 135.0
# 按照关键字显式调用
p2 = calculate_discount(80, rate=0.8)     # 未达门槛 100 -> 80
p3 = calculate_discount(200, rate=0.75)   # 200 * 0.75 -> 150.0

print(f"p1={p1}, p2={p2}, p3={p3}")
2. 函数调用与执行生命周期
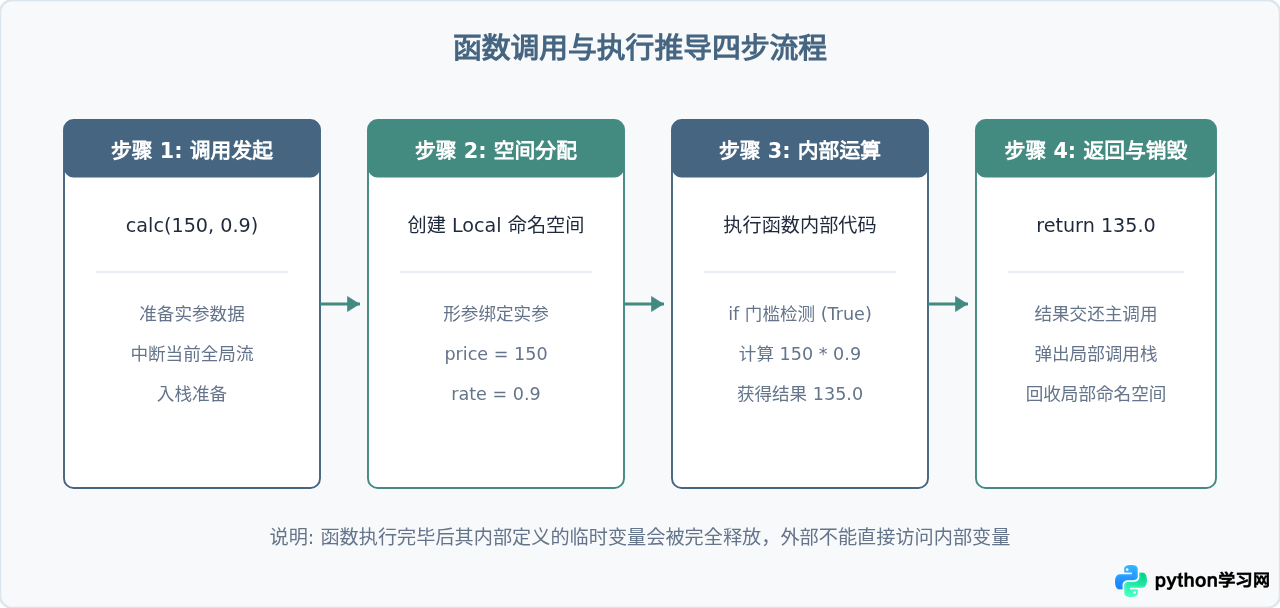
理解函数调用的底层推导过程,能够帮助我们清晰掌握局部变量、作用域隔离与垃圾回收机制。每一次函数调用都会在调用栈中分配独立的局部栈帧(Frame)。
3. 变量作用域:LEGB 查找规则
当在函数内部引用一个变量名时,Python 会按照由内向外的顺序依次检索,该顺序被称为 LEGB 规则:
- L (Local):当前函数内部的局部作用域。
- E (Enclosing):嵌套函数的闭包外层函数作用域。
- G (Global):模块全局作用域(当前 .py 文件的顶层)。
- B (Built-in):Python 内置作用域(如
len,range,print等)。
如果希望在函数内部直接修改全局变量,需声明 global 关键字,但在实际工程中应尽量避免这种破坏纯函数特性的写法。
四、三大基石综合实战:数据清洗与分类处理
为了让读者直观看到变量、控制流与函数是如何协同工作的,我们通过一个具体场景进行演练:编写一个用于清洗订单数据、剔除无效记录并计算分类统计结果的脚本。
# 1. 定义测试数据(列表内嵌套字典)
raw_orders = [
    {"order_id": 101, "amount": 240, "status": "completed"},
    {"order_id": 102, "amount": -20, "status": "completed"},   # 无效负数金额
    {"order_id": 103, "amount": 450, "status": "cancelled"},   # 已取消
    {"order_id": 104, "amount": 510, "status": "completed"},
    {"order_id": 105, "amount": 0,   "status": "completed"},   # 无效 0 金额
    {"order_id": 106, "amount": 120, "status": "completed"},
]

# 2. 封装数据清洗与统计函数
def process_orders(orders, high_value_cutoff=300):
    """
    清洗并统计订单金额
    """
    total_valid_amount = 0
    valid_count = 0
    high_value_orders = []

    for item in orders:
        # 控制流分支 1: 状态过滤
        if item.get("status") != "completed":
            continue

        amt = item.get("amount", 0)

        # 控制流分支 2: 数据合规性校验
        if amt <= 0:
            continue

        # 累加有效数据
        total_valid_amount += amt
        valid_count += 1

        # 高净值订单归类
        if amt >= high_value_cutoff:
            high_value_orders.append(item["order_id"])

    # 计算平均金额(防止除零异常)
    avg_amount = round(total_valid_amount / valid_count, 2) if valid_count > 0 else 0

    return {
        "valid_count": valid_count,
        "total_amount": total_valid_amount,
        "average_amount": avg_amount,
        "high_value_ids": high_value_orders
    }

# 3. 调用函数并验证输出结果
summary = process_orders(raw_orders, high_value_cutoff=300)

print("--- 订单统计结果 ---")
print(f"有效订单数: {summary['valid_count']}")
print(f"有效总金额: {summary['total_amount']}")
print(f"订单均价:   {summary['average_amount']}")
print(f"大额订单ID: {summary['high_value_ids']}")

# 示例输出:
# --- 订单统计结果 ---
# 有效订单数: 3
# 有效总金额: 870
# 订单均价:   290.0
# 大额订单ID: [104]
五、全景总结与初学者避坑指南
为了在编写代码时少走弯路,下表整理了初学者在接触变量、函数与控制流时最容易踩入的三个典型陷阱及对应解决方案:
| 语法范畴 | 典型常见错误 | 错误表现与原因 | 正确编写规范 |
|---|---|---|---|
| 变量与引用 | 多个变量共享可变对象赋值导致连带修改 | b = a; b.append(1) 导致 a 也被意外修改 |
需要独立副本时使用 a.copy() 或 copy.deepcopy() |
| 流程控制 | 循环中缺少递增或终止条件导致死循环 | while count < 5: 内部忘记写 count += 1 耗尽 CPU |
优先使用 for ... in;写 while 时先补齐状态递进 |
| 函数参数 | 使用可变对象(如列表、字典)作为默认参数 | def append_item(x, l=[]) 导致默认列表跨调用常驻共享 |
默认值使用 None,函数内部再通过 if l is None: l = [] 初始化 |
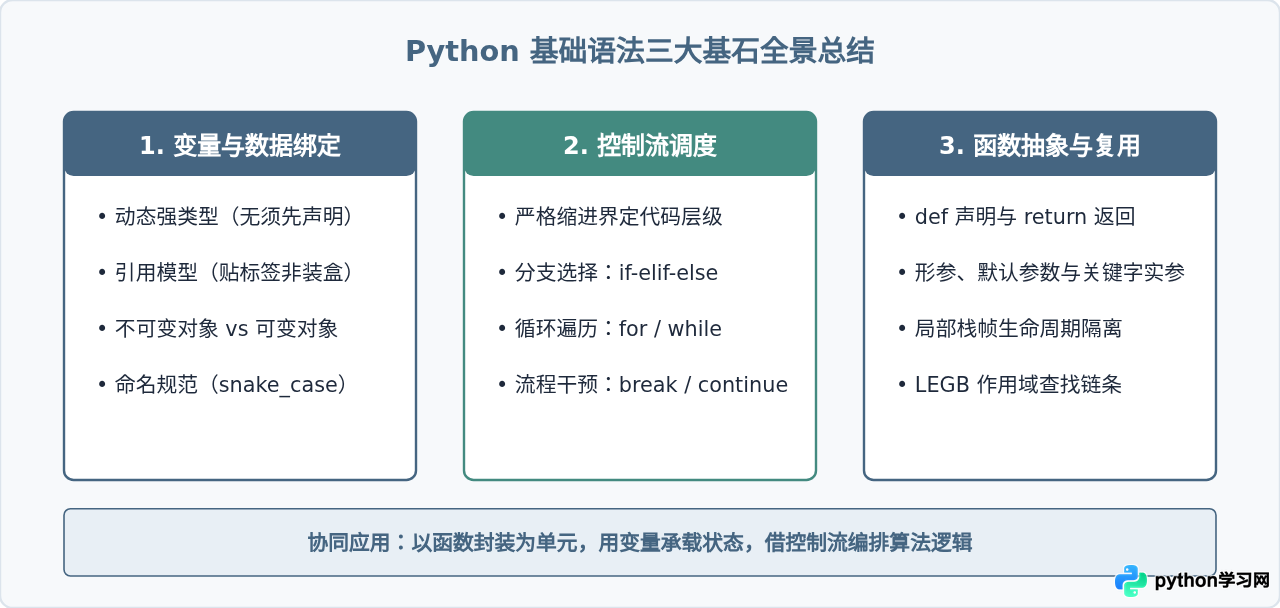
掌握了变量的对象引用机制、灵活的分支循环流程控制以及规范的函数封装后,你就已经具备了编写结构严谨、逻辑清晰的 Python 代码的基础能力。在后续深入面向对象编程(OOP)、文件 IO 及第三方模块开发时,这些基础语法规则将持续发挥关键的支撑作用。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









