

除了做网站,Python编程还能做什么?5个高频实用领域
全面盘点除Web开发之外Python的5个高频实用领域:办公自动化、数据分析与可视化、网络数据采集、自动化测试与运维、人工智能与机器学习工程,提供清晰的应用场景、代码思路与选型建议。
提到 Python 编程,很多人第一反应是 Django 或 FastAPI 这类 Web 后端框架。然而,Web 开发只是 Python 庞大版图中的一角;凭借简洁易读的语法表达、开箱即用的标准库以及高度成熟的第三方生态,Python 在办公自动化、数据分析、网络数据采集、自动化测试与运维以及人工智能等领域,已经成为工程师与业务人员解决具体高频问题的首选工具。
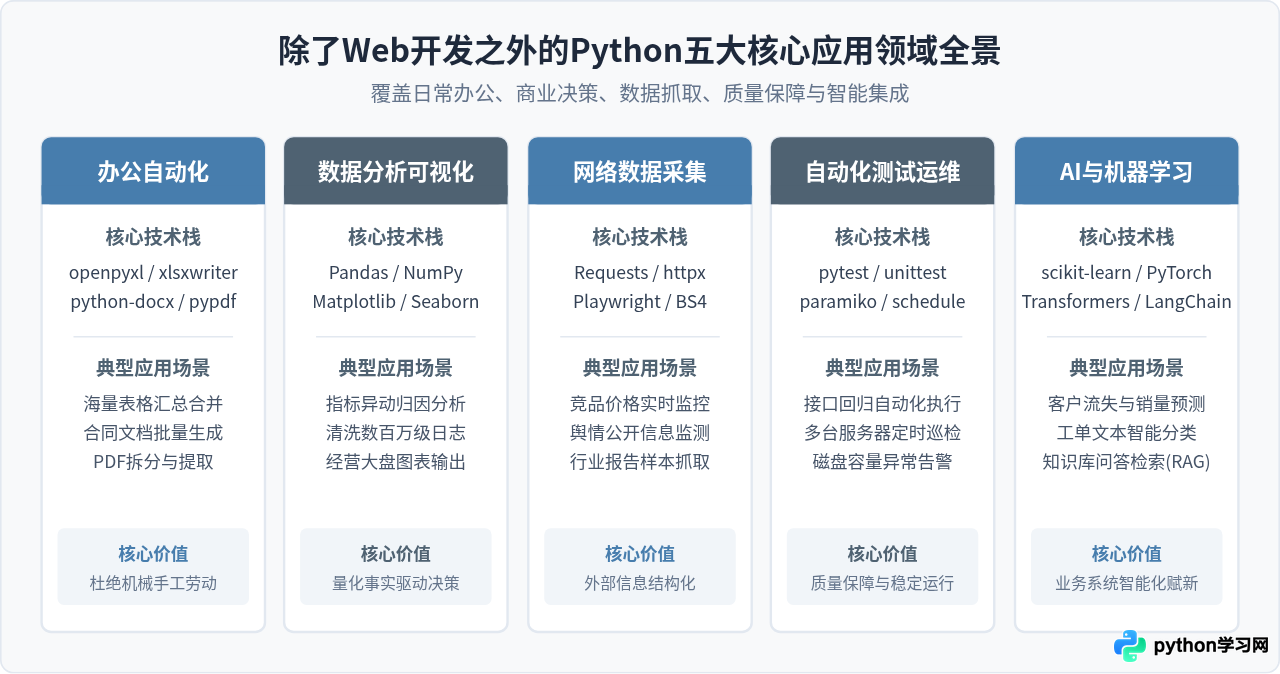 图1:Python 在 Web 之外的五大核心实用领域全景对照
一、办公自动化:处理海量重复性表格与文档
在大多数企业的行政、财务、运营和销售流程中,最耗费精力且容易出错的工作往往是“机械搬砖”:例如将几十个部门提交的 Excel 表格汇总成一张总表、为上百家客户批量替换合同条款并生成 Word 文档,或者从数百页扫描 PDF 中提取指定单据编号。
Python 对文件格式的操控能力极强。利用 openpyxl 或 xlsxwriter,你可以直接用代码读取单元格数值、修改公式、格式化字体边框;配合 python-docx 可以实现段落级模板替换;而借助 pypdf 或 pdfplumber 则能精准完成页面拆分与文本提取。
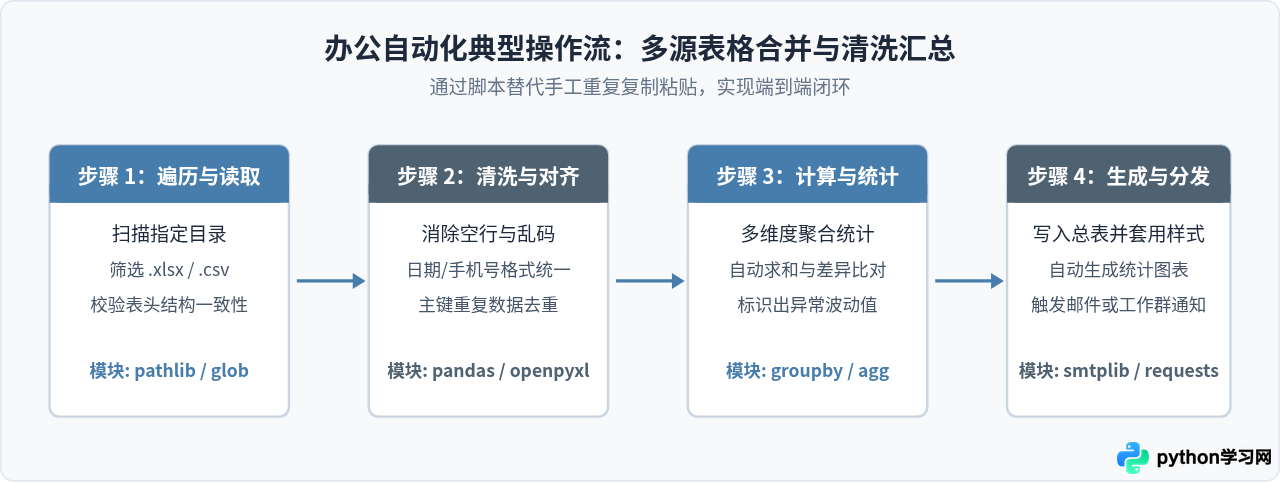 图2:通过 Python 脚本实现多部门表格自动合并的标准步骤
下面是一个使用 openpyxl 批量扫描目录下所有销售明细并提取关键行的基础示例:
from pathlib import Path
from openpyxl import load_workbook, Workbook

def merge_sales_reports(source_dir: Path, output_file: Path):
    target_wb = Workbook()
    target_ws = target_wb.active
    target_ws.title = "汇总明细"
    target_ws.append(["部门", "销售员", "订单号", "销售额", "提交日期"])

    for file_path in source_dir.glob("*.xlsx"):
        if file_path.name.startswith("~$") or file_path == output_file:
            continue  # 跳过临时缓存文件与输出目标
        wb = load_workbook(filename=file_path, data_only=True)
        ws = wb.active
        # 跳过首行表头,从第2行读取有效数据
        for row in ws.iter_rows(min_row=2, values_only=True):
            if any(row):  # 过滤全空行
                target_ws.append(list(row))
        wb.close()

    target_wb.save(output_file)

# 示例调用
merge_sales_reports(Path("./sales_data"), Path("./annual_summary.xlsx"))data_only=True 参数读取含有公式的 Excel 文件时,获取到的是 Excel 上次计算并缓存的值。如果文件是由第三方工具生成且从未在 Excel 软件中打开保存过,公式单元格的值可能返回为 None。
二、数据分析与可视化:从业务指标中挖掘洞察
当数据量超过数十万行时,传统办公软件容易发生卡顿或崩溃。Python 在数据科学领域的统治地位,源于 NumPy 带来的底层高效数组运算,以及 Pandas 提供的强大结构化数据表抽象(DataFrame)。
数据分析的核心任务不是写复杂代码,而是回答业务问题:上个月转化率下降的主要是哪批渠道?不同客单价区间用户的复购周期有何差异?通过几行声明式的 Pandas 代码,即可完成复杂的分组(Groupby)、透视(Pivot Table)、滑动窗口统计以及时序重采样。
import pandas as pd
import matplotlib.pyplot as plt

# 1. 读入用户行为记录
df = pd.read_csv("user_events.csv", parse_dates=["event_time"])

# 2. 提取业务特征:按渠道与月份统计下单金额与转化用户数
df["event_month"] = df["event_time"].dt.to_period("M")
monthly_stats = df.groupby(["event_month", "channel"]).agg(
    total_revenue=("payment_amount", "sum"),
    active_users=("user_id", "nunique")
).reset_index()

# 3. 计算客单价指标
monthly_stats["arpu"] = monthly_stats["total_revenue"] / monthly_stats["active_users"]
print("统计汇总结果预览:")
print(monthly_stats.head())
在分析完成后,配合 Matplotlib、Seaborn 或交互式库 Plotly,可以一键输出趋势折线图、分布箱线图或热力图,直接嵌入到商业分析报告中。
三、网络数据采集:系统化获取公开市场信息
无论是分析竞争对手的价格动态、搜集行业公开招聘要求,还是跟踪政府招标采购公告,人工逐页浏览复制的效率极低。利用 Python 编写网络爬虫(Web Scraping),能够将分散在网页上的非结构化信息自动解析为干净的数据库记录。
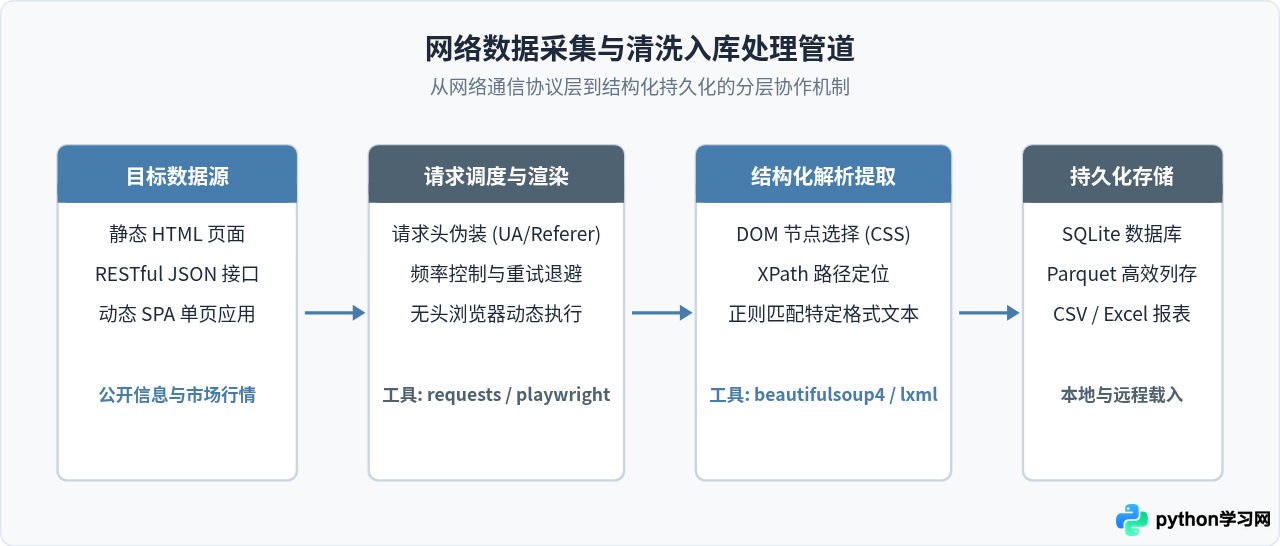 图3:网络数据采集工程的分层流水线架构
技术选型上一般遵循“由简入深”原则:
- 静态内容与常规API:直接使用
requests或异步库httpx发送 HTTP 请求,配合BeautifulSoup或lxml解析 HTML 标签。这种方式资源消耗最低、抓取速度最快。 - 高度依赖前端 JavaScript 渲染的页面:使用现代无头浏览器驱动如
Playwright或Selenium,模拟真实用户滚动、点击、等待网络请求返回后再提取 DOM 树。
robots.txt 文件,合理设置访问间隔(如设置延时与限流),严禁抓取涉及用户隐私、版权保护或登录授权后的受限资产。
四、自动化测试与系统运维:保障服务质量与巡检效率
在软件质量工程与基础设施运维中,Python 是事实上的通用粘合语言。它既不需要复杂的编译过程,又能轻松调用操作系统底层的接口。
1. 接口与端到端自动化测试
现代软件开发要求快速迭代,每次提交代码后人工手动点击所有接口极不现实。借助 pytest 框架与测试驱动思想,测试人员可以用几行代码定义测试夹具(Fixture)、参数化输入组合以及断言逻辑:
import pytest
import requests

BASE_URL = "https://api.example.com/v1"

@pytest.fixture
def auth_headers():
    # 模拟获取测试Token
    return {"Authorization": "Bearer test-token-12345"}

@pytest.mark.parametrize("item_id, expected_status", [
    (101, 200),
    (99999, 404),
    (-1, 400),
])
def test_get_product_detail(auth_headers, item_id, expected_status):
    resp = requests.get(f"{BASE_URL}/products/{item_id}", headers=auth_headers)
    assert resp.status_code == expected_status
2. 服务器日常巡检与环境维护
运维工程师常需要管理数十台 Linux 机器。通过 Python 内置的 subprocess 或第三方 SSH 连接库 Paramiko,可以编写批量巡检脚本,定时收集各主机的 CPU 负载、内存水位与磁盘剩余容量,并在超过阈值时通过企微、钉钉或邮件自动告警。
五、人工智能与机器学习工程:快速构建智能化应用
当前主流的深度学习和人工智能框架(包括 PyTorch、TensorFlow、Scikit-Learn)几乎全部以 Python 作为第一开发交互语言。在实际业务中,并不只有少数顶尖科学家才能使用 AI,普通开发者使用 Python 也能落地许多实用场景:
- 传统机器学习与预测建模:使用
scikit-learn对历史销售数据建立回归模型预测下周订货量,或者使用随机森林算法对信贷风险和客户流失做概率分类。 - 文本情感与内容清洗:在没有复杂模型的情况下,利用结巴分词(
jieba)和 TF-IDF 快速对几十万条用户评论进行关键词提取与主题聚类。 - 大语言模型(LLM)落地集成:通过官方 SDK 或
LangChain构建企业内部检索增强生成系统(RAG)。利用几行 Python 代码将公司文档切片、生成向量嵌入、检索相似片段并传递给大模型,生成准确的客服应答。
总结与技术选型建议
从日常细碎文档的自动化整理,到业务大盘的深度探索,再到智能化模型的快速集成,Python 的实用价值早已超越单纯的 Web 站点构建。面对不同的实际需求,合理匹配技能栈才能事半功倍:
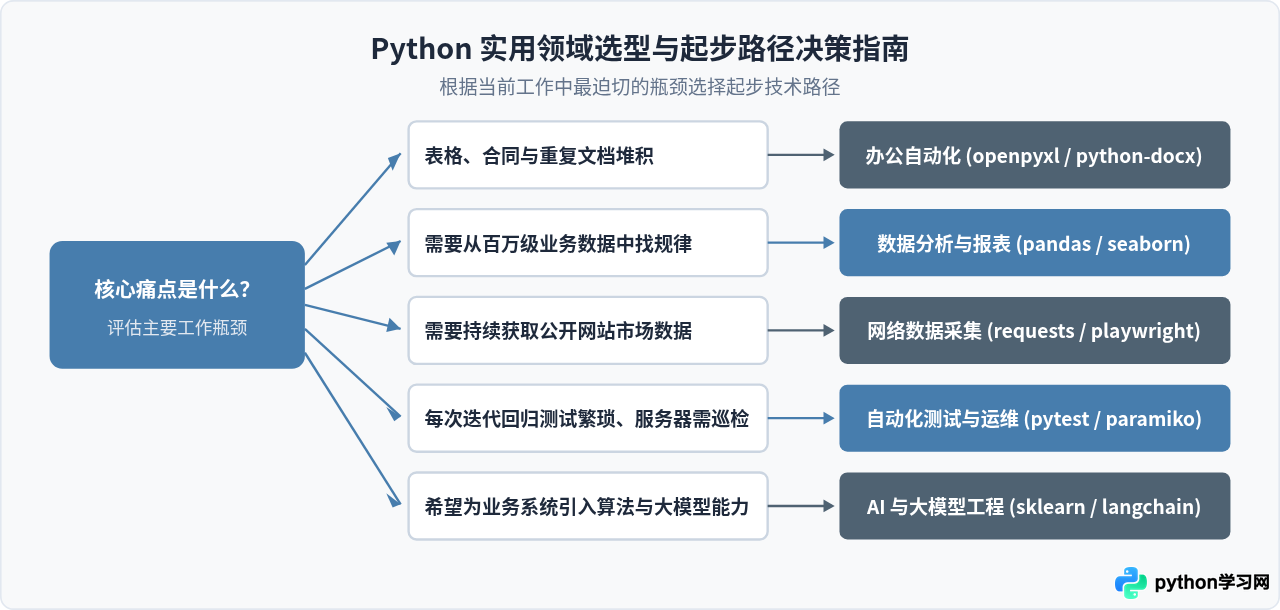 图4:基于当前实际业务瓶颈的 Python 技能树选型决策
| 领域名称 | 初学者推荐起步库 | 典型收益 | 常见难点 |
|---|---|---|---|
| 办公自动化 | openpyxl, pathlib |
即学即用,快速节省日常机械耗时 | 源文件格式不规范、公式缓存缺失 |
| 数据分析 | pandas, seaborn |
掌握多维指标分析与商业大盘洞察 | 复杂多层索引、大数据内存管理 |
| 网络数据采集 | requests, beautifulsoup4 |
低成本沉淀外部公开信息资产 | 动态渲染防爬策略、IP 与请求频控 |
| 测试与运维 | pytest, paramiko |
保障软件发布质量,消除巡查盲点 | 复杂网络环境隔离、异步测试管理 |
| AI 与机器学习 | scikit-learn, 大模型 API |
低门槛赋能业务智能化与预测决策 | 特征工程要求高、数据样本标注成本 |
学习 Python 并不需要一开始就试图掌握所有方向。最行之有效的方法是:先聚焦当前工作中耗时最多、最枯燥的痛点(例如每周耗费两小时的手动报表合并),通过一个几十行的小脚本跑通端到端流程,在切实解决实际问题的过程中逐步拓展对更多工具库的掌握。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









