

Python列表推导式一行代码找出所有重复元素
本文详细讲解如何使用Python列表推导式一行代码找出列表中的所有重复元素,从基础count推导到高效率Counter与seen集合方案,分析算法时间复杂度并提供完备的代码示例。
在 Python 数据处理中,从列表中快速提取重复出现过的元素是一项常见需求。最直观的一行代码是通过列表推导式结合 count() 统计方法或者 collections.Counter 实现快速筛选。掌握一行代码提取重复项不仅能精简逻辑,还能帮助开发者深入理解列表遍历、集合哈希以及时间复杂度权衡。
一、核心答案:两类最实用的一行代码
在不引入额外模块的标准语法下,找出列表中重复元素最经典的一行代码如下:
raw_list = [1, 2, 3, 2, 4, 3, 5, 2]
duplicates = list({x for x in raw_list if raw_list.count(x) > 1})
print(duplicates)  # 示例输出: [2, 3]
如果追求工业级性能,在数据量较大时推荐引入标准库 collections.Counter,同样可以用一行推导式解决:
from collections import Counter

raw_list = [1, 2, 3, 2, 4, 3, 5, 2]
duplicates = [item for item, count in Counter(raw_list).items() if count > 1]
print(duplicates)  # 示例输出: [2, 3]
这两行代码在表现形式上都是一行式推导,但底层运算机制和性能开销截然不同。接下来我们将拆解具体步骤与适用场景。
二、基础列表推导式与 count() 过滤步骤
使用 raw_list.count(x) > 1 作为推导式过滤条件是最符合直觉的写法。它的执行流程包含三个核心动作:循环遍历元素、调用计数方法、最终去重收纳。
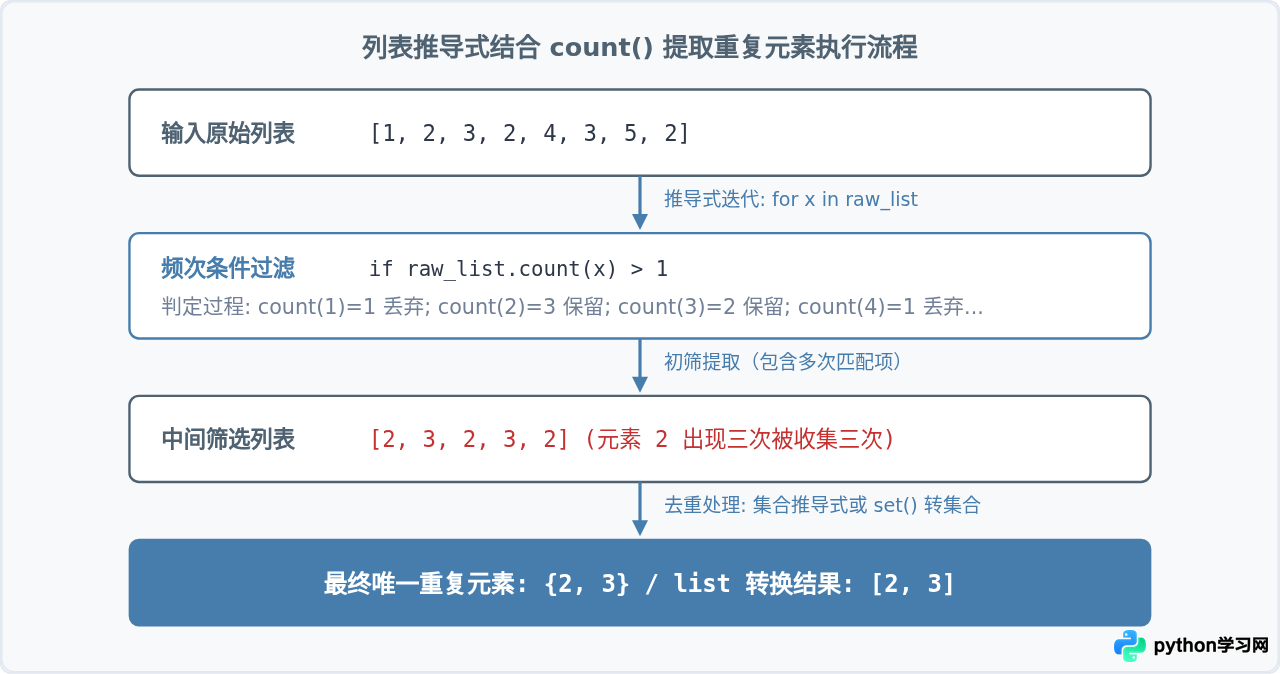
需要特别注意:如果单纯书写 [x for x in raw_list if raw_list.count(x) > 1],返回的列表中,元素 2 会出现 3 次,元素 3 会出现 2 次。因为推导式每遇到一个符合条件的元素就会放入结果。为了得到真正无重复的“所有重复项清单”,必须在外层套用 set() 或直接采用集合推导式语法 {...}。
为了减轻不必要的循环计算,还可以先对遍历源进行一次集合化:
duplicates = [x for x in set(raw_list) if raw_list.count(x) > 1]这一优化避免了原列表中重复元素本身的多次重复遍历,使得外部循环次数降低至不重复元素的数量。
三、时间复杂度分析与计算瓶颈
虽然 count() 写法直观简练,但其底层性能存在显著短板。Python 的 list.count(x) 是线性的全量扫描操作,其时间复杂度为 \(O(N)\)。当它被置于长度为 \(N\) 的推导式内层循环中时,整体算法的时间复杂度将跃升至 \(O(N^2)\)。
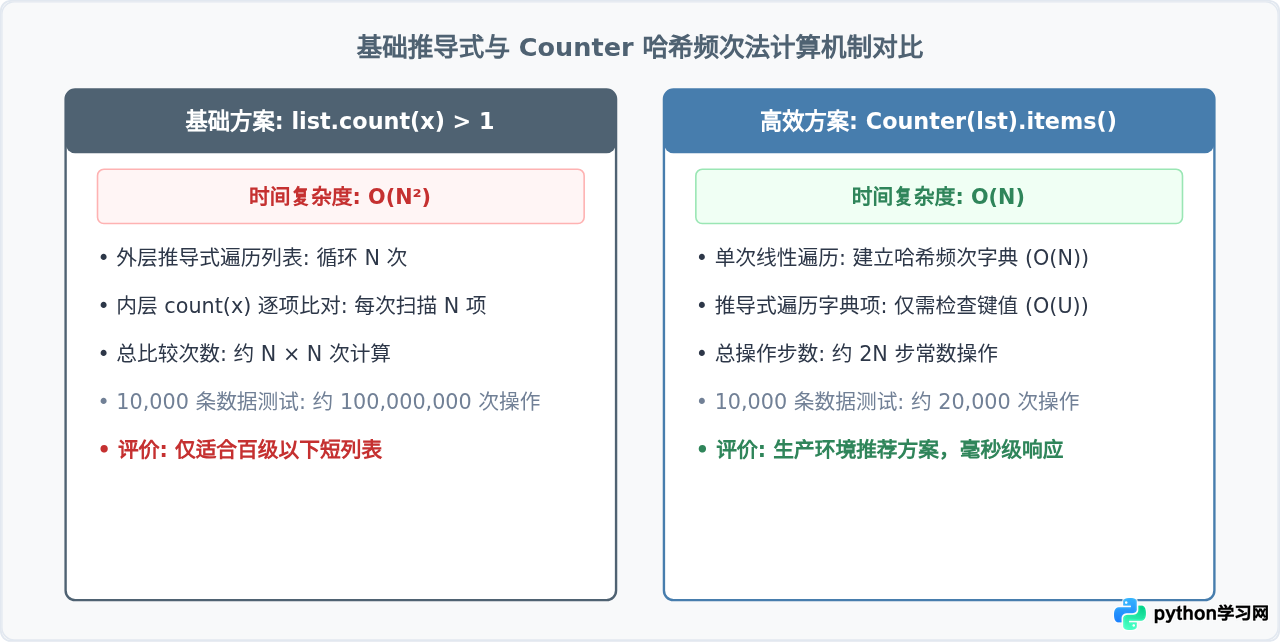
count() 推导式。
四、利用辅助集合实现单次遍历的短路求值法
如果业务环境不允许导入 collections 模块,但又需要在线性时间 \(O(N)\) 内完成查找,可以借助一个外部辅助集合 seen 并结合 Python 的 or 短路求值机制,在单行推导式内完成任务。
raw_list = [1, 2, 3, 2, 4, 3, 5, 2]
seen = set()
duplicates = list({x for x in raw_list if x in seen or seen.add(x)})
print(duplicates)  # 示例输出: [2, 3]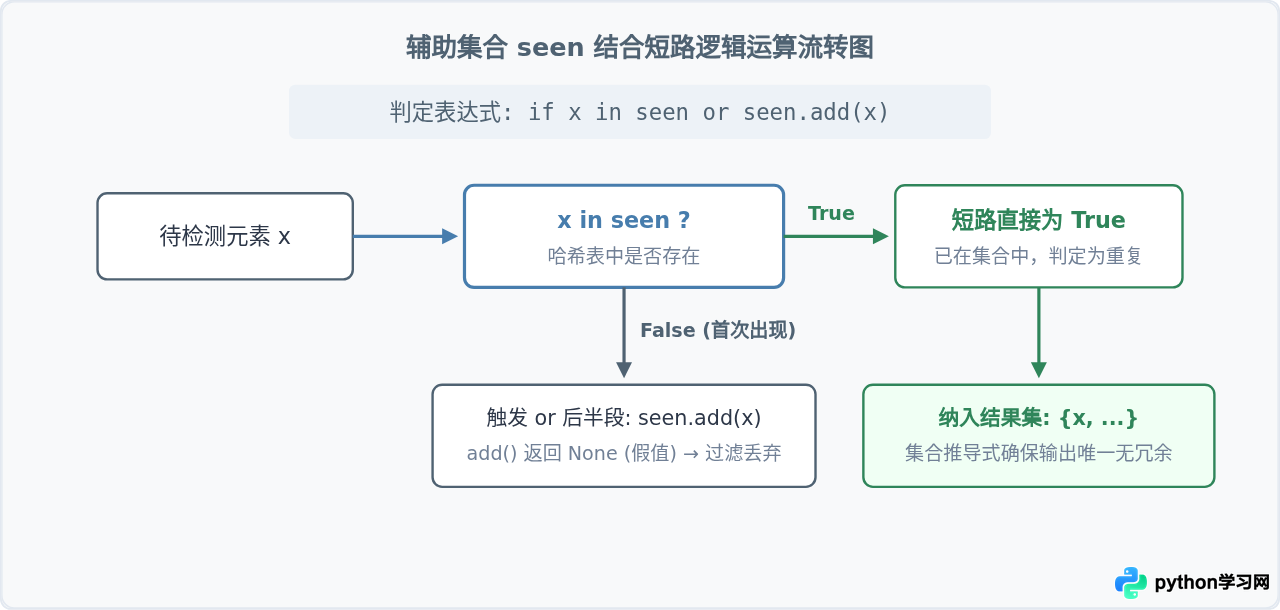
这个写法的核心奥秘在于:
- 首次遇到元素:
x in seen评估为False。逻辑运算符or会继续执行右操作数seen.add(x)。 - 副作用注入:
seen.add(x)成功将当前元素添加进集合,但它的返回值是None。在 Python 条件判定中,None视为假值(Falsy),整条条件最终评估为False,该元素不会被加入推导式结果。 - 二次及以后遇到元素:
x in seen评估为True。由于逻辑短路特性,右侧seen.add(x)不再执行,表达式直接返回True,该元素被作为重复项收集。 - 外层集合推导式:使用
{...}确保如果一个元素出现 3 次以上,仅会在最终结果中保留一份。
五、选型建议与方案对比
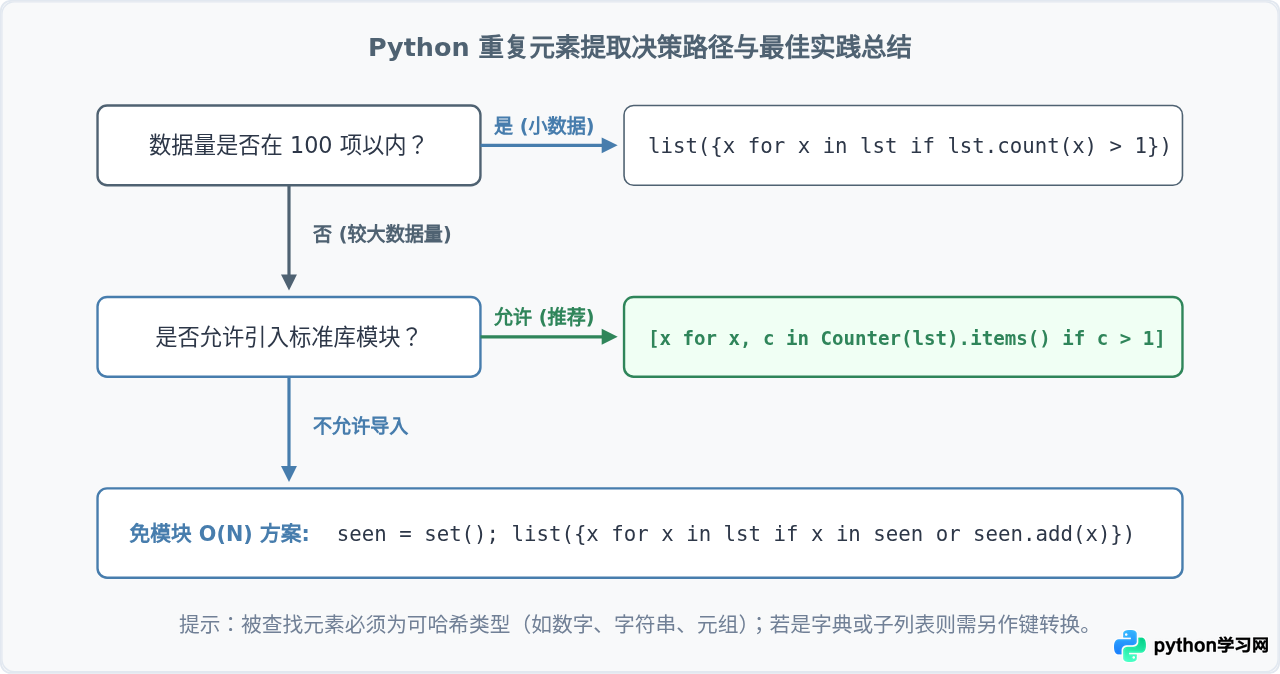
在实际编码中,不同场景对代码可读性、外部依赖以及执行性能有不同偏好。下表给出了三种主要方案的关键属性对比:
| 方案分类 | 一行代码写法 | 时间复杂度 | 是否依赖模块 | 最佳适用场景 |
|---|---|---|---|---|
| 基础集合推导式 | list({x for x in lst if lst.count(x) > 1}) |
\(O(N^2)\) | 否(纯原生) | 数据量极小(几十条内)、快速临时脚本 |
| 标准库 Counter(首选) | [x for x, c in Counter(lst).items() if c > 1] |
\(O(N)\) | 是(需导入) | 通用工程项目、生产数据清洗、大数据列表 |
| 短路集合跟踪法 | list({x for x in lst if x in seen or seen.add(x)}) |
\(O(N)\) | 否(仅需 seen) | 算法竞赛、限制导入模块且要求高执行效率 |
六、边界条件与使用限制
在使用上述推导式时,需要注意以下边界条件:
- 元素哈希性限制:无论基于
set()还是Counter,目标元素都必须是可哈希(Hashable)对象。如果列表中包含可变对象(如嵌套字典或嵌套列表),执行set()或seen.add()将触发TypeError: unhashable type异常。 - 相对顺序保持:集合(
set)具有无序性。如果业务场景需要按原始列表中首次出现重复的顺序排列,应使用保持顺序的字典特性,例如[x for x, c in Counter(raw_list).items() if c > 1](在 Python 3.7+ 中字典及 Counter 保持插入顺序)。
综上所述,对于日常快速交互与教学演示,list({x for x in lst if lst.count(x) > 1}) 足够简洁;而对于正式的工程开发,使用 collections.Counter 的推导式则是兼顾清晰性与 \(O(N)\) 高性能的最佳实践。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









