

Docker与Kubernetes环境下Python微服务集群的部署策略
深入解析在Docker与Kubernetes生产环境下部署Python微服务集群的核心策略,涵盖多阶段镜像构建、PID 1进程管理、K8s调度拓扑、探针精细配置与优雅停机方案。
在云原生体系中,Python微服务因其简洁的语法与庞大的生态被广泛用于业务逻辑和数据处理接口。但在实际生产交付中,Python的动态解释特性、全局解释器锁(GIL)以及独特的进程运行模型,使其不能简单套用编译型语言的容器化方案。要让Python微服务集群在Kubernetes中稳定运行,核心在于解决四个关键环节:通过多阶段构建压制镜像体积与安全攻击面、通过Init进程规避PID 1信号屏蔽问题、通过合理的资源配比匹配K8s弹性扩缩机制,以及通过探针与PreStop钩子杜绝滚动发布中的连接中断。本文将按照从容器构建到集群编排的实施路径,逐一拆解这些部署策略。
一、Docker镜像工程与轻量安全构建策略
Python运行环境天然依赖较多的标准库与C扩展模块(如psycopg2、cryptography、numpy)。许多开发团队直接在Debian完整镜像中运行 pip install,导致构建出的镜像动辄超过800MB,且内置了gcc、make等全套编译工具链,给容器带来巨大的安全暴露面。为了兼顾编译能力与运行时轻量化,生产环境应当采用多阶段构建(Multi-stage Build)。
在基础镜像的选择上,优先采用官方维护的 python:3.11-slim 系列,而非直接使用 Alpine。虽然 Alpine 体积更小,但其基于 musl libc,在安装依赖二进制预编译轮子(manylinux wheels)的 Python 包时经常被迫现场源码编译,反而大幅拉长构建时长并可能引发难以排查的内存分配差异。使用 slim 镜像配合多阶段构建,可以既保留 glibc 的良好兼容性,又将最终镜像体积控制在 120MB 左右。
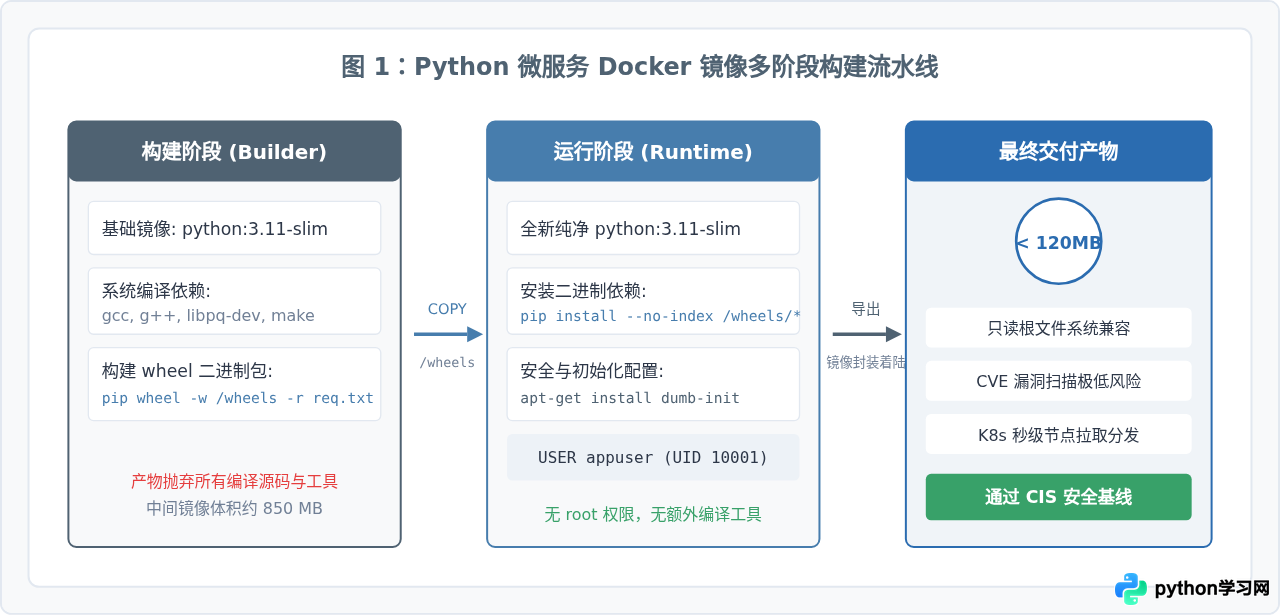
在编写 Dockerfile 时,必须遵守以下三项铁律:
- 使用专用无特权用户: 默认容器内以 root 权限运行,若存在应用逃逸漏洞将危及宿主机。应当在镜像中显式创建系统用户并切换,例如
RUN useradd -u 10001 -m appuser。 - 禁用 Python 缓冲与生成 pyc 文件: 设置环境变量
PYTHONUNBUFFERED=1确保应用 stdout/stderr 实时刷入标准输出,由容器运行时采集;设置PYTHONDONTWRITEBYTECODE=1避免容器镜像层写入冗余字节码。 - 前置复制依赖定义清单: 仅在
requirements.txt发生变动时才重新触发 pip 安装过程,充分利用 Docker 缓存加速 CI/CD 流水线。
下面是一个标准的 FastAPI / Uvicorn 生产级 Dockerfile 示例:
# 阶段一:编译环境 (Builder)
FROM python:3.11-slim AS builder

WORKDIR /build
ENV PYTHONDONTWRITEBYTECODE=1 \
    PYTHONUNBUFFERED=1

RUN apt-get update && apt-get install -y --no-install-recommends \
    gcc \
    libpq-dev \
    && rm -rf /var/lib/apt/lists/*

COPY requirements.txt .
RUN pip install --upgrade pip && \
    pip wheel --no-cache-dir --no-deps --wheel-dir /build/wheels -r requirements.txt

# 阶段二:生产运行时 (Runtime)
FROM python:3.11-slim

WORKDIR /app
ENV PYTHONDONTWRITEBYTECODE=1 \
    PYTHONUNBUFFERED=1 \
    PATH="/home/appuser/.local/bin:$PATH"

# 安装轻量级 init 系统,用于正确的信号转发
RUN apt-get update && apt-get install -y --no-install-recommends \
    dumb-init \
    libpq5 \
    && rm -rf /var/lib/apt/lists/*

# 创建普通系统账户
RUN useradd -u 10001 -m appuser && chown -R appuser:appuser /app
USER appuser

# 从 builder 阶段复制预编译依赖并完成本地安装
COPY --from=builder /build/wheels /wheels
RUN pip install --no-cache-dir --no-index --find-links=/wheels /wheels/* && \
    rm -rf /wheels

# 拷贝应用代码
COPY --chown=appuser:appuser . /app

EXPOSE 8000
ENTRYPOINT ["/usr/bin/dumb-init", "--"]
CMD ["uvicorn", "main:app", "--host", "0.0.0.0", "--port", "8000", "--workers", "2"]
二、PID 1 进程模型与 Worker 规格调优
在 Docker 容器内部,主进程默认作为 PID 1 运行。根据 Linux 进程模型,PID 1 进程承担着信号转发以及收割僵尸进程(Zombie Processes)的特殊职责。当没有额外配置时,常规 Python 解释器在作为 PID 1 时会忽略默认的 SIGTERM 信号。当 Kubernetes 发起 Pod 终止通知时,Python 应用无法捕捉停机信号,只能被动等待 30 秒超时后被宿主机 SIGKILL 强制杀死,这会导致正在处理中的长连接或事务发生硬截断。
引入 dumb-init 或 tini 能够彻底解决这一问题。Init 进程作为 PID 1 启动,在接收到容器停止信号后,能够准确且完整地将 SIGTERM 向其所有子进程(即 Uvicorn 或 Gunicorn 的 Worker 进程)分发,确保 Python 应用触发预设的停机钩子。
关于并发模型的选型,通常有两种典型配置路径:单 Pod 多进程(Gunicorn 挂载多个 Uvicorn Worker)以及单 Pod 单进程(多副本水平伸缩)。在 Kubernetes 体系中,强烈建议采用“单 Pod 运行 1 到 2 个 Worker 进程,通过 K8s HPA 实现弹性伸缩”的策略,原因如下:
- 指标透明度: 当一个 Pod 内运行过多 Worker 时,Kubernetes 的 CPU 与内存指标是整组 Pod 的加总,无法反映单个 Python 进程的死锁或阻塞状态。
- 故障隔离范围: Python 应用由于 GIL 存在,或者某些原生模块未释放 GIL 时,会造成单个进程假死。将容器做小,单个 Pod 故障仅影响极少量的并发请求,K8s 健康检查能够快速将其剔除并漂移调度。
- 内存泄漏防护: Python 垃圾回收机制在长期运行高并发接口后容易产生堆内存碎片。配置单 Pod 小粒度规格(如 Request: 0.5C / 512Mi),配合
--max-requests定期轮转 Worker,可以大幅降低内存溢出(OOM)风险。
三、Kubernetes 编排策略与高可用拓扑分布
在将 Python 微服务部署到 Kubernetes 集群时,如果单纯依赖 replicas: 4 这样的基础声明,调度器很可能会因为节点资源碎片,将多个副本集中调度在同一台物理宿主机或同一个可用区(Availability Zone)内。一旦该节点发生硬件故障或网络抖动,整个微服务将面临服务中断。
在生产环境中,必须通过配置 topologySpreadConstraints(拓扑分布约束)或 Pod 反亲和性(podAntiAffinity),强制让 Python 微服务副本在区域(zone)和节点(node)维度上均匀散开。
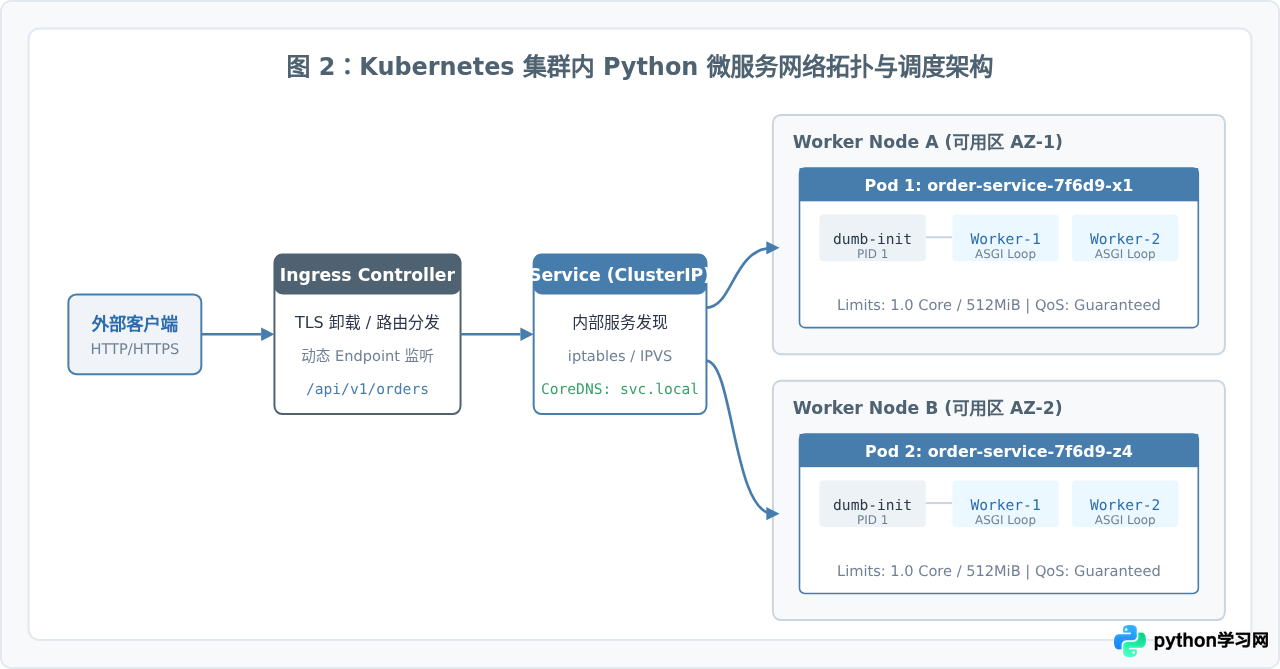
在资源分配上,需要格外重视 CPU Throttling(CPU 节流) 与 OOMKilled 问题。在 Linux CFS 调度器下,如果为 Python 容器配置了严格的 CPU limits(例如 0.5 核),Python 的多线程垃圾回收或短时高并发反序列化容易打满当前周期配额,导致容器遭遇严重节流,接口延迟出现剧烈毛刺。因此在核心高并发服务中,推荐将 CPU Requests 与 Limits 保持宽松,或者在允许超卖的环境中不设上限仅设 Requests;而对内存(Memory),则必须严格设置 Limits,防止单节点上某个微服务内存无限制膨胀引发宿主机内核级别的 OOM 崩溃。
四、探针精细配置与零宕机优雅停机策略
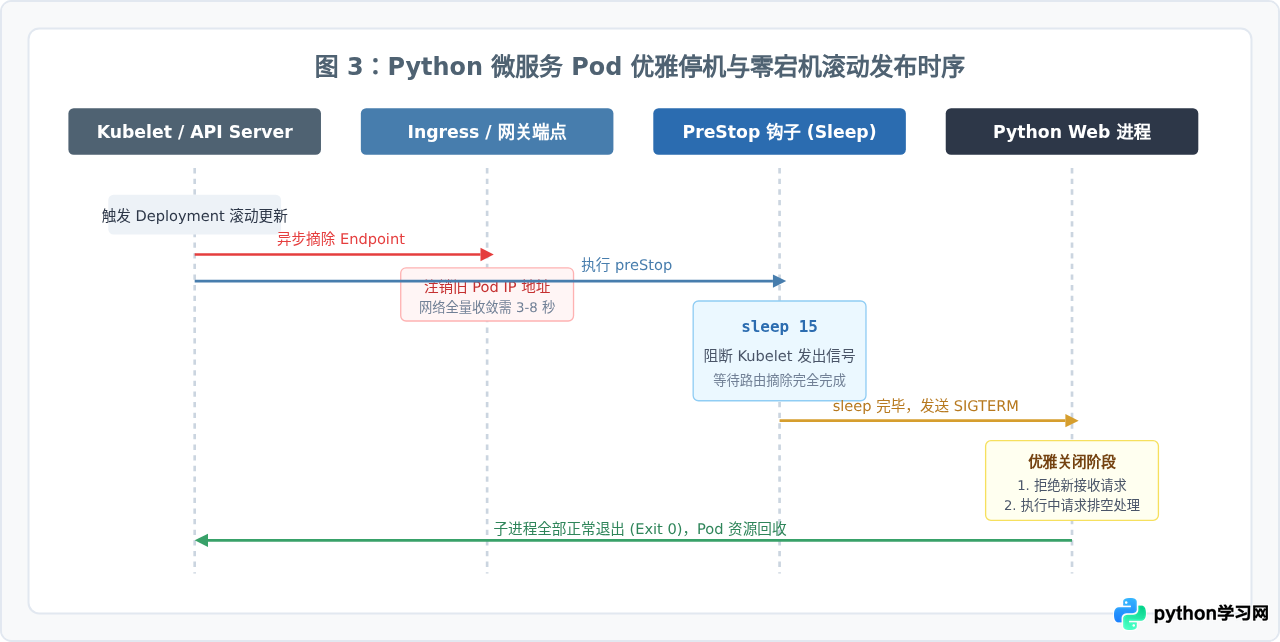
在微服务集群滚动发布时,最容易出现偶发性的 502 Bad Gateway 或连接重置报错。导致这一现象的根本原因在于:Kubelet 执行 Pod 销毁动作与 Ingress/Kube-proxy 摘除后端端点(Endpoints)是异步并行的。
当 Deployment 触发滚动更新时,Endpoint 控制器收到通知并向各个节点同步路由表;与此瞬间,Kubelet 会直接向容器发送 SIGTERM 信号。如果 Python 应用立即停止监听端口,而前端网关尚未完全更新 Endpoint 列表,后续几毫秒至数秒内的流量仍会被转发给旧 Pod,直接造成 502 错误。解决这一问题的标准手段是加入 PreStop 睡眠等待。
在探针设计上,不能将所有探针简单指向同一个 /healthz。针对 Python 应用必须三层分立:
- 启动探针 (StartupProbe): Python 微服务在冷启动时往往需要加载大型第三方包、建立 ORM 映射或初始化数据库连接池,冷启动耗时可能达到 10~30 秒。配置
failureThreshold: 30与periodSeconds: 2的 StartupProbe,能给容器预留最长 60 秒初始化宽限,避免其在启动阶段被存活探针误判杀死。 - 就绪探针 (ReadinessProbe): 用于判定当前 Pod 是否能够承接外部业务流量。该探针应检测应用与关键基础设施(如 Redis、PostgreSQL)的连通性。一旦连接池耗尽,就绪探针将返回 503,K8s 会立即从 Service 中切除该 Pod 流量,避免错误扩散。
- 存活探针 (LivenessProbe): 用于判定应用进程是否出现死锁或僵死。该探针必须是极简、非阻塞的内存检查接口(如直接返回 200 OK 的
/ping),切忌在该探针内执行慢查询或远程 RPC 调用,否则当外部依赖抖动时,会导致整个集群的 Pod 被全部级联杀除。
五、完整的生产级 Kubernetes 部署清单
结合上述策略,以下给出完整的 Python 微服务生产级 Deployment 与 Service 配置示范:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: py-order-service
  namespace: microservices
  labels:
    app: py-order-service
spec:
  replicas: 4
  revisionHistoryLimit: 5
  strategy:
    type: RollingUpdate
    rollingUpdate:
      maxSurge: 25%
      maxUnavailable: 0
  selector:
    matchLabels:
      app: py-order-service
  template:
    metadata:
      labels:
        app: py-order-service
    spec:
      # 优雅停机宽限期:大于 preStop (15s) + 应用处理耗时 (30s)
      terminationGracePeriodSeconds: 60

      # 拓扑分布约束:跨可用区打散
      topologySpreadConstraints:
        - maxSkew: 1
          topologyKey: topology.kubernetes.io/zone
          whenUnsatisfiable: ScheduleAnyway
          labelSelector:
            matchLabels:
              app: py-order-service

      # 反亲和性:避免同服务副本挤占同一物理宿主机
      affinity:
        podAntiAffinity:
          preferredDuringSchedulingIgnoredDuringExecution:
            - weight: 100
              podAffinityTerm:
                labelSelector:
                  matchExpressions:
                    - key: app
                      operator: In
                      values:
                        - py-order-service
                topologyKey: kubernetes.io/hostname

      containers:
        - name: service
          image: registry.example.com/services/py-order-service:v1.4.2
          imagePullPolicy: IfNotPresent

          # 优雅注销钩子:预留 15 秒供 Endpoints 在网关与各节点完全同步
          lifecycle:
            preStop:
              exec:
                command: ["/bin/sh", "-c", "sleep 15"]

          ports:
            - name: http
              containerPort: 8000

          # 资源限制策略
          resources:
            requests:
              cpu: "500m"
              memory: "512Mi"
            limits:
              cpu: "1000m"
              memory: "1024Mi"

          # 启动探针:应对 Python 冷启动与连接池初始耗时
          startupProbe:
            httpGet:
              path: /health/startup
              port: 8000
            initialDelaySeconds: 3
            periodSeconds: 2
            failureThreshold: 30

          # 就绪探针:判定是否接纳流量
          readinessProbe:
            httpGet:
              path: /health/ready
              port: 8000
            periodSeconds: 5
            timeoutSeconds: 2
            failureThreshold: 2

          # 存活探针:极简心跳,检查 EventLoop 是否存活
          livenessProbe:
            httpGet:
              path: /health/live
              port: 8000
            periodSeconds: 10
            timeoutSeconds: 2
            failureThreshold: 3

          envFrom:
            - configMapRef:
                name: order-service-config
            - secretRef:
                name: order-service-secret
---
apiVersion: v1
kind: Service
metadata:
  name: py-order-service
  namespace: microservices
  labels:
    app: py-order-service
spec:
  type: ClusterIP
  ports:
    - name: http
      port: 80
      targetPort: 8000
  selector:
    app: py-order-service
六、生产级全景决策与校验体系
为了保障 Python 微服务在容器云平台上的长期稳定,团队在上线交付前应当依据全生命周期的四个关键层级进行对照复查。
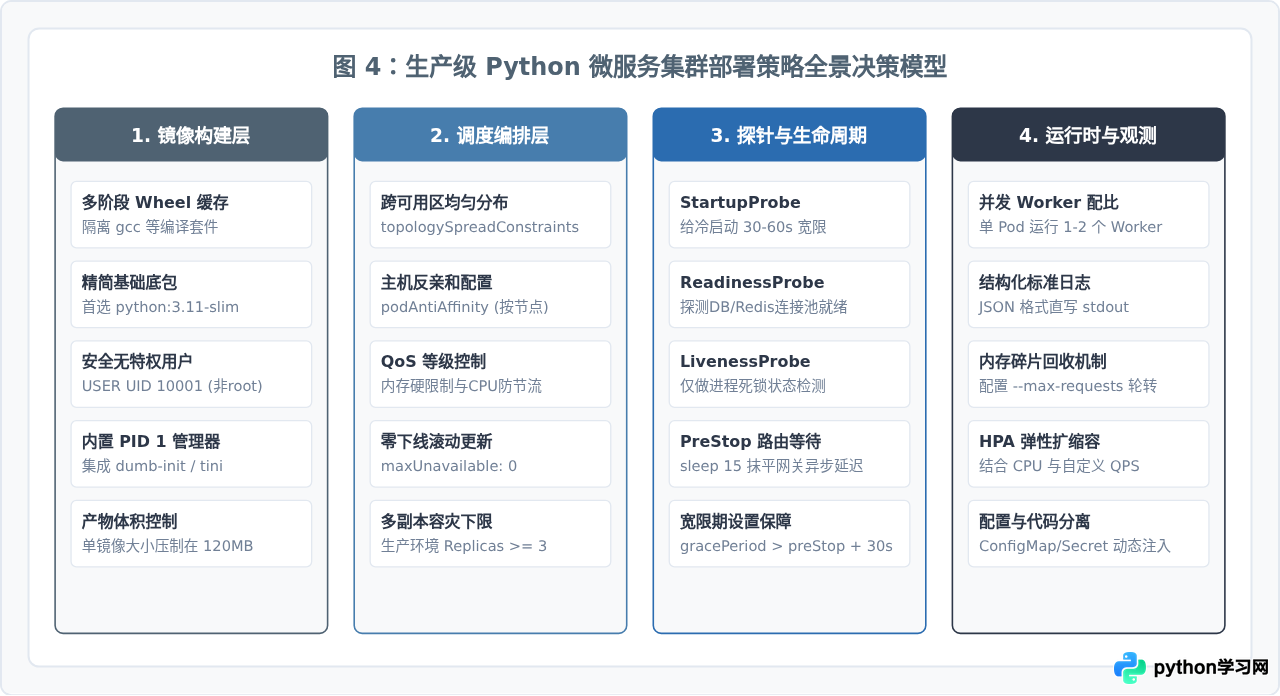
综上所述,在 Docker 与 Kubernetes 环境下部署 Python 微服务,不应仅仅将其视为一个静态文件的容器打包过程。只有将多阶段构建的体积优化、Init 进程的信号代理、集群维度的拓扑打散、生命周期内的延迟缓冲以及分立探针机制深度整合,才能充分发挥 Python 敏捷开发的优势,并在高并发与频繁发布的生产环境下保障集群的高可用与业务韧性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









