

为什么大模型需要RAG?解决幻觉与知识滞后问题
RAG(检索增强生成)通过将外部知识库与模型生成结合,解决大模型的知识滞后和部分幻觉问题。本文解析RAG的工作机制,指出错误可能沿检索链路传递的风险,并提供基于Python的最小化验证示例,强调在落地时需先确保证据的准确性与时效性,再约束模型的生成行为。
大模型需要 RAG,通常不是因为它不会组织语言,而是因为业务答案不能只依赖训练时学到的知识。让它回答刚修改的产品规则、内部文档或具体故障记录时,先检索证据再生成,比直接要求它‘认真回答’更有针对性。但 RAG 只能减少部分错误,不能保证消除幻觉。
假设一个内部系统把附件上限从 10MB 改成了 20MB。模型不知道这次变更,即使语气非常肯定,也不代表它掌握了当前规则。更麻烦的是:接上知识库以后,如果检索到的仍然是旧文档,答案依然可能错。
问题不只是模型记得不够多
RAG 是 Retrieval-Augmented Generation,中文通常叫‘检索增强生成’。它把回答分成两个相连的环节:先从外部资料里寻找相关内容,再把检索结果连同问题交给模型生成答案。
普通对话主要依靠模型参数中的知识和当前上下文。参数并不是一个随时更新、逐条可查的业务数据库。训练结束之后发布的新规则,不会因为用户多问一次就自动进入模型参数;内部资料没有提供给模型时,它也无从知道。
这解释了知识滞后,却还不能解释全部幻觉。模型生成的是符合上下文的后续文本,不是逐项执行事实核验。问题包含错误前提、证据缺失,或者几个相近概念混在一起时,它可能补出看似合理但没有依据的细节。流畅只是表达特征,不是证据。
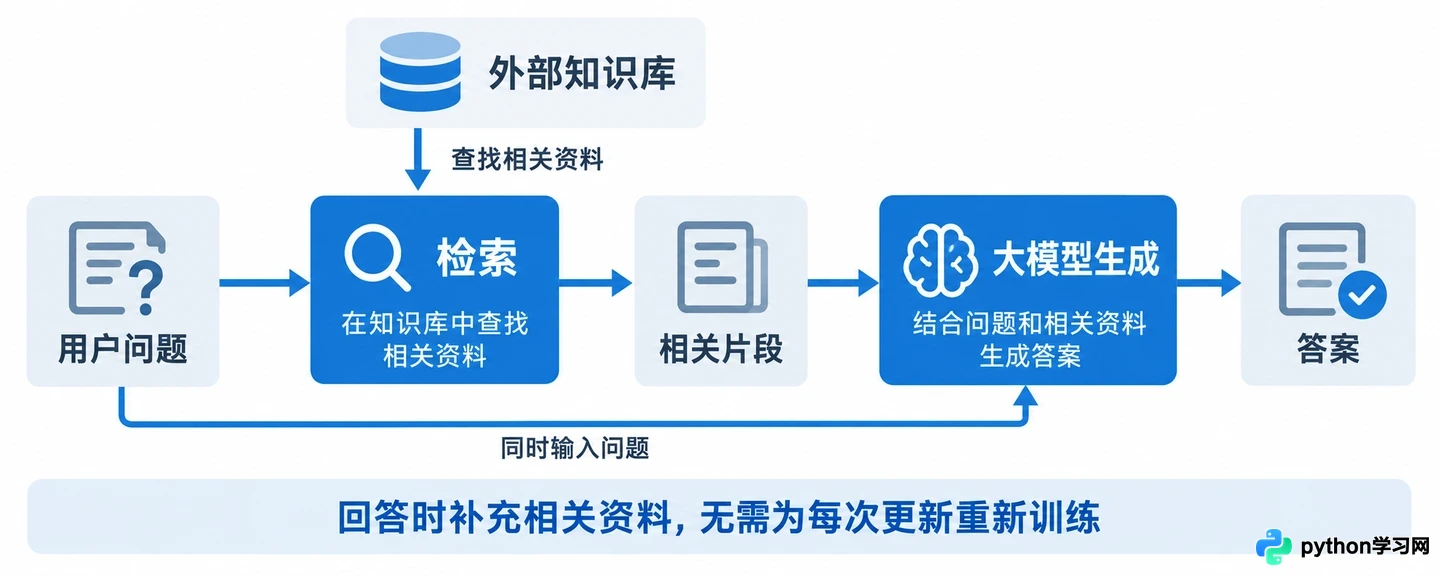
RAG 将检索与生成分离,通过外部知识库补充模型缺失的最新信息
RAG 改变的是回答时能看到什么。模型原先只能凭已有知识推断,现在多了一份与问题相关的材料。因此它可以利用训练之后的新资料,也可以回答原本不在训练数据中的内部问题。更新外部知识库,通常不需要为每次业务变更重新训练模型。
不过,资料写入数据库不等于立即能被搜到。文件解析、分块、索引更新和缓存都会影响新内容什么时候进入检索结果。知识更新的问题没有凭空消失,而是转成了一条可以检查的资料更新链路。
错误会沿着检索结果继续传递
常见流程是:把文档拆成片段,为片段建立索引;收到问题后检索候选片段,必要时重排;把选中的证据放进上下文,要求模型据此作答。向量检索是常用方法,但不是 RAG 的必要定义。关键词检索、混合检索以及结构化查询,也可以承担寻找证据的工作。
每一环都有自己的失误方式。分块切掉了条件,模型看到的规则就不完整;只做语义相似匹配,可能找不到精确的错误码或型号;旧版与新版同时入库,没有版本筛选,就可能把过期规定排在前面。重排改善的是候选资料的顺序,不能替不存在的原始资料补出事实。
下面用 Python 3 演示一个最小问题。资料与数值均为虚构,仅模拟‘旧资料排在第一条’的选择逻辑,不调用模型,也不模拟完整的向量检索。代码输出已实际执行核对。
docs = [
    {"version": 1, "current": False, "text": "单个附件上限为10MB"},
    {"version": 2, "current": True, "text": "单个附件上限为20MB"},
]

# 错误:直接采用第一条候选资料
print("未筛选:", docs[0]["text"])
输出:
未筛选: 单个附件上限为10MB
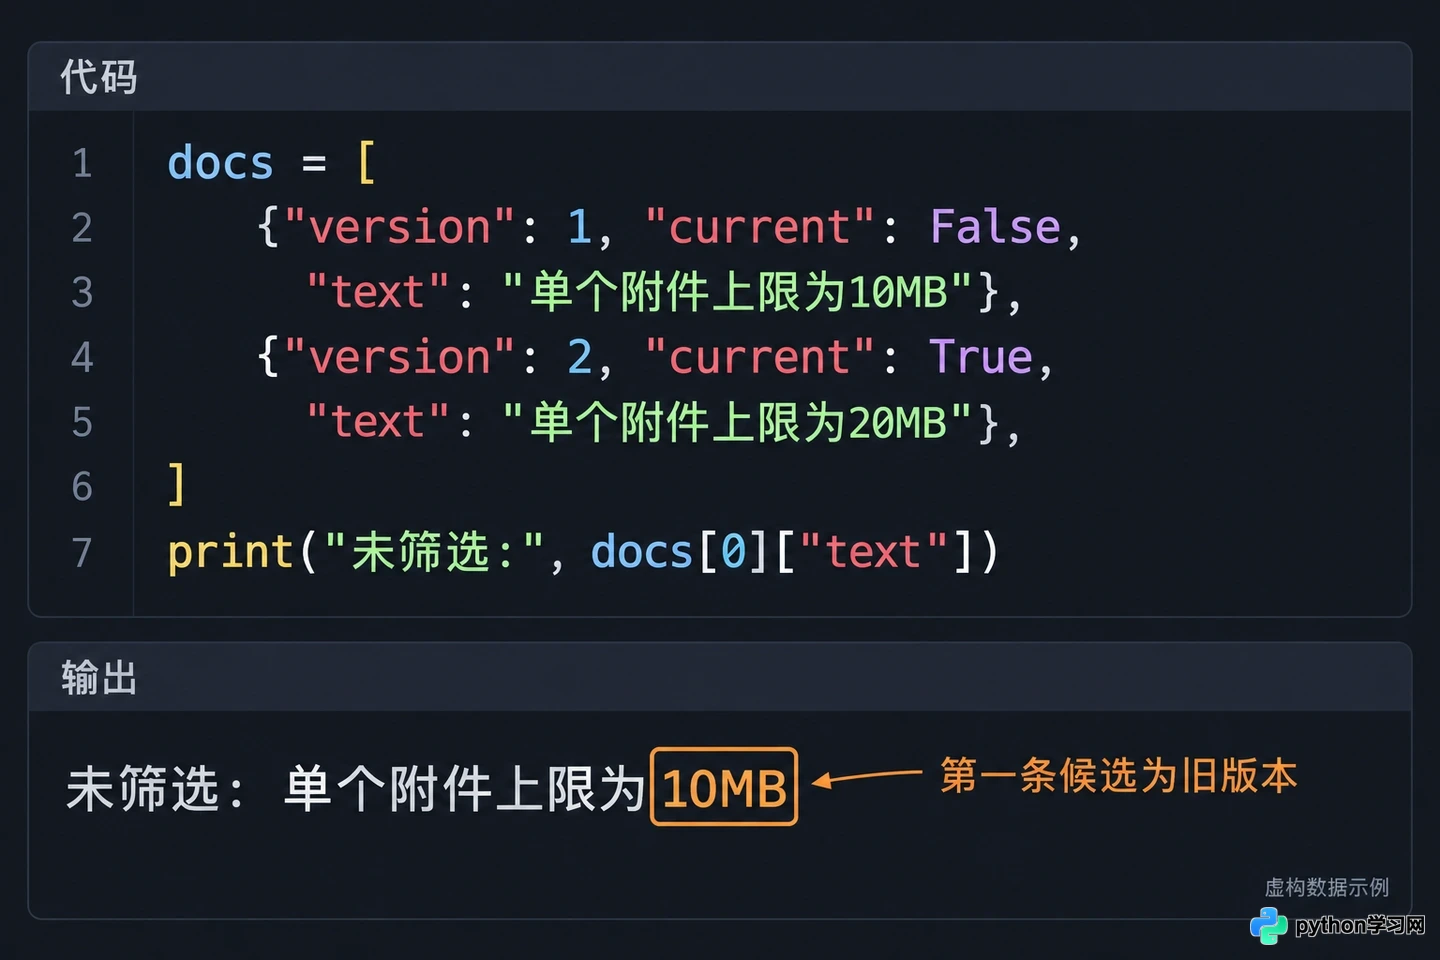
直接取用第一条检索结果可能导致引用过期数据
模型即便忠实概括这条资料,也会给出过期答案。这不是一句‘请勿编造’就能修正的:提供给它的事实基础已经错了。
沿用上面的 docs,在生成之前排除失效版本:
active = [d for d in docs if d["current"]]
print("筛选有效版本:", active[0]["text"])
输出:
筛选有效版本: 单个附件上限为20MB
这个修正只说明有效版本过滤改变了选中的证据,不能证明模型一定答对。示例还假定维护者正确标记版本,而且至少存在一条有效记录。实际系统必须处理零结果、多条冲突记录和规则适用范围,不能照搬第一条索引访问。
如果同一问题对不同用户、产品版本或地区有不同答案,筛选条件还要包括这些范围。权限也必须在可信的检索链路里落实,不能先把不该看的资料交给模型,再指望提示词替系统保密。
先修证据,再约束生成
落地 RAG 时,先确定问题需要哪一类事实。精确数字、库存或订单状态,往往适合查询受控数据库或业务接口;长篇操作文档和故障说明,才更适合分块检索。不要把所有数据都转成向量后,就认为查询问题已经解决。
接着检查资料本身。每个片段应保留来源、版本、生效状态,以及解释该片段所必需的标题和上下文。更新文档时同步处理旧版本与索引。遇到特定错误码、产品编号这类精确标识,可以结合关键词与语义检索,避免只凭‘意思相近’选资料。
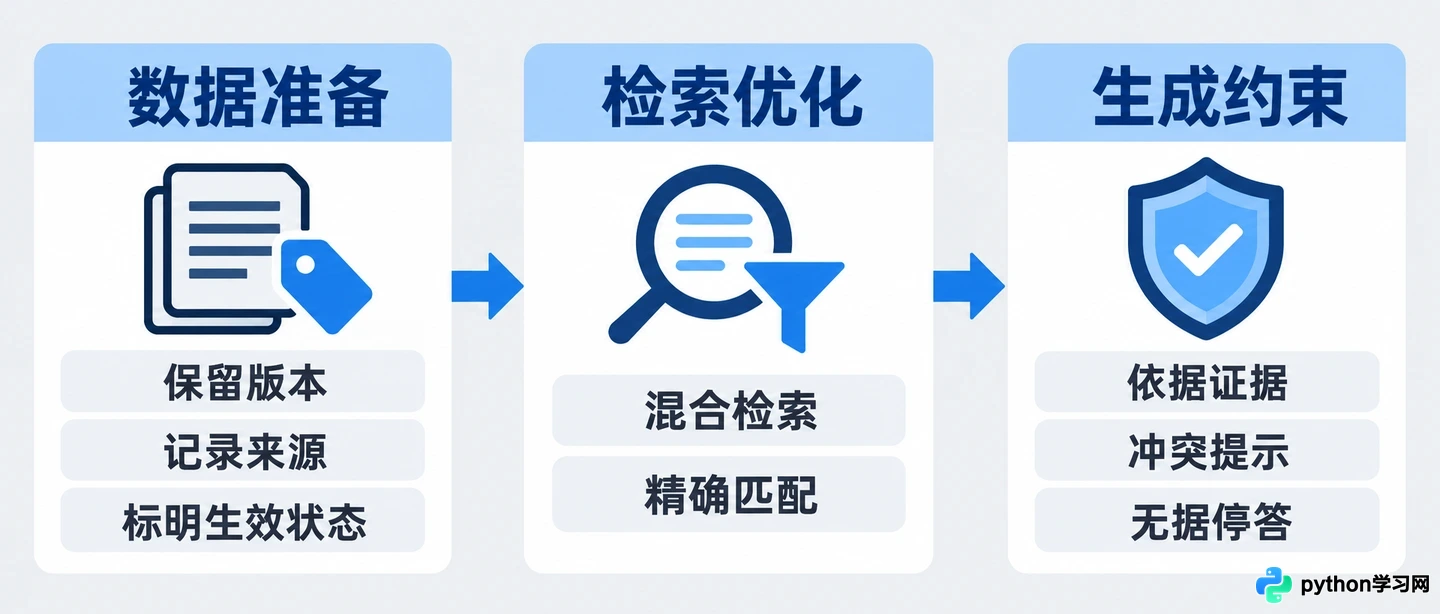
从数据清洗到生成约束的全链路质量控制
生成阶段则需要清晰边界:只依据给出的证据回答;证据不足就说明缺什么;资料冲突就指出冲突,不擅自拼成一个确定结论。需要可追溯时,保存回答与来源片段的对应关系。引用存在并不代表引用支持结论,还要检查答案有没有把条件、时间或对象改掉。
验证也要分开做。如果正确文档没有被检索到,应先检查检索与索引;如果正确证据已经进入上下文,模型仍然改写错条件,则检查生成约束与答案核验。把所有错误都归咎于‘模型不够强’,会错过真正能修的环节。
可以准备一组有标准答案的测试问题,覆盖新旧规则、缺失资料、冲突资料、精确编号和权限隔离。分别记录正确证据是否被找到、答案是否受证据支持、无依据时是否停止回答。不要只看回答是否顺口,也不要用单个成功案例代替整条链路的验证。
RAG 同样有成本:检索增加等待时间,索引需要维护,过多片段会占用上下文并引入干扰。翻译一段已给出的文字、整理当前对话或做不依赖外部事实的表达任务,通常不必额外接知识库。资料量很小时,直接提供必要材料也可能更简单。
让大模型接上 RAG 的关键,不是让它‘知道一切’,而是让答案有可检查的事实输入。证据先可靠,生成才有可靠的起点;证据不足时停止推断,比把空白补成确定结论更重要。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









