

pip卸载PyTorch:标准命令与依赖清理步骤
系统介绍如何使用pip完整卸载PyTorch,涵盖torchvision与torchaudio协同卸载、NVIDIA CUDA运行时Wheel依赖清理、pip缓存释放及多环境排查验证步骤。
在配置深度学习工作流时,我们常需要因显卡驱动升级、CUDA版本调整或模型兼容需求,对现有的 PyTorch 进行重新安装。很多读者在终端直接输入 pip uninstall torch,看到执行成功提示后便以为卸载完成。然而,再次通过 pip list 检查或尝试重装时,往往会发现磁盘空间几乎未见释放,甚至在调用视觉或音频模型时抛出版本不匹配的动态链接库错误。这是因为现代 PyTorch 并非单一独立包,安装时随同引入的官方配套扩展、GPU 编译中间件、多达数 GB 的 NVIDIA CUDA 运行时二进制包以及本地 pip 缓存依然大量遗留在系统中。本文将详细讲解使用 pip 规范卸载 PyTorch 的完整路径与深度依赖清理步骤。
一、标准协同卸载:同步移除核心配套库
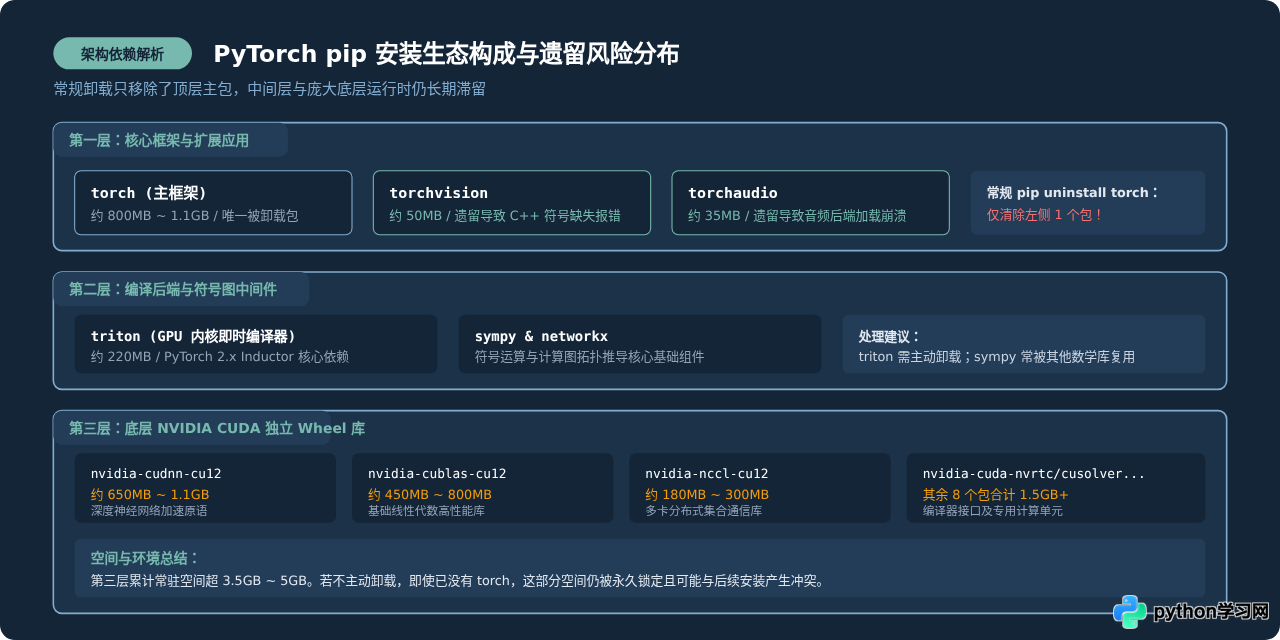
深度学习项目通常不会只安装 torch 核心库,官方的计算机视觉库 torchvision 与音频库 torchaudio 会随主版本严格绑定。如果仅卸载 torch 而保留另外两者,残留的扩展库在后续环境导入时极易引发 C++ 符号找不到(Undefined Symbol)等崩溃错误。
卸载的首要原则是将三者同时标记并协同移除。为确保精确操作目标环境的解释器,推荐显式调用对应 Python 解释器的 -m pip 语法,并加入 -y 参数跳过多次手动确认交互:
# 规范卸载 PyTorch 核心及其官方配套拓展库
python -m pip uninstall -y torch torchvision torchaudio
如果你早期曾使用过自然语言处理配套库 torchtext 或图像库 torchdata,同样建议一并加入卸载列表中:
python -m pip uninstall -y torch torchvision torchaudio torchtext torchdata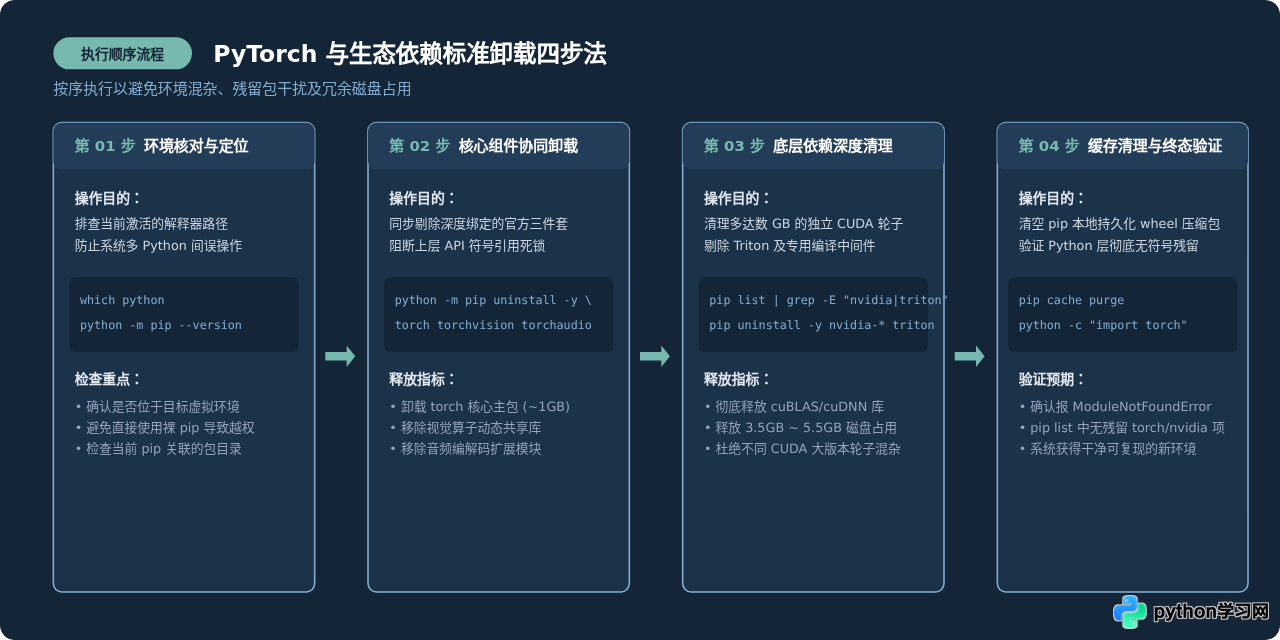
二、识别并清理底层 CUDA 运行时与伴生依赖
自 PyTorch 2.0 时代起,通过官方 pip 源(如 download.pytorch.org/whl/cu118 或 cu121)安装 GPU 版本时,PyTorch 默认采用了分拆打包方案。它不再将 CUDA 核心库全部打包在单个体积超大的 torch 安装包中,而是自动作为依赖引入一系列独立的 nvidia-* Python Wheel 包。
当你执行 pip uninstall torch 时,根据 pip 的标准依赖处理行为,它仅会卸载被指定的目标包,绝不会自动反向递归卸载为其安装的从属依赖。这正是“为什么卸载了 torch 磁盘却依然被占用数 GB”的根本技术原因。
1. 查看当前环境残留的底层包
在执行后续清理前,先执行下列命令列出所有残留的 NVIDIA 运行时包和伴生工具:
# 检索环境中的底层运行时包及编译器
pip list | grep -E "nvidia-|triton"
在安装过 PyTorch GPU 版本的环境中,通常能看到如下典型输出示例:
nvidia-cublas-cu12        12.1.3.1
nvidia-cuda-cupti-cu12     12.1.105
nvidia-cuda-nvrtc-cu12     12.1.105
nvidia-cuda-runtime-cu12   12.1.105
nvidia-cudnn-cu12          8.9.2.26
nvidia-cufft-cu12          11.0.2.54
nvidia-curand-cu12         10.3.2.106
nvidia-cusolver-cu12       11.4.5.107
nvidia-cusparse-cu12       12.1.0.106
nvidia-nccl-cu12           2.19.3
nvidia-nvtx-cu12           12.1.105
triton                     2.2.0
2. 彻底清理 NVIDIA 运行时与 Triton
若当前虚拟环境专用于 PyTorch,且你准备换装其他版本的 PyTorch 或切换为纯 CPU 环境,应当彻底清理这些运行时库。手动指定关键包的卸载命令如下:
# 手动精准卸载全套底层 NVIDIA 依赖包及 Triton
pip uninstall -y \
  nvidia-cublas-cu12 \
  nvidia-cuda-cupti-cu12 \
  nvidia-cuda-nvrtc-cu12 \
  nvidia-cuda-runtime-cu12 \
  nvidia-cudnn-cu12 \
  nvidia-cufft-cu12 \
  nvidia-curand-cu12 \
  nvidia-cusolver-cu12 \
  nvidia-cusparse-cu12 \
  nvidia-nccl-cu12 \
  nvidia-nvtx-cu12 \
triton注意:如果当前 Python 环境中还同时安装了如 TensorRT、ONNX Runtime GPU 版或其他深度学习框架,请在批量清理前确认其他框架是否同样依赖这些 nvidia-* 运行时包。如果处于专用独立的 virtualenv 或 Conda 环境中,全部清理是最安全、最彻底的做法。
三、释放磁盘空间:清除 pip 下载与构建缓存
完成 Python 虚拟环境内部的模块卸载后,很多人会发现整机磁盘可用容量依然没有显著提升。其关键原因在于 pip 的自动缓存机制。
当通过 pip install torch 从 PyTorch 专用源下载包时,pip 会默认在操作系统的用户主目录下缓存下载下来的 .whl 完整二进制归档文件。PyTorch 的单个 wheel 包通常在 1.5GB 到 2.5GB 之间,配套的 CUDA 库也有数 GB。即使虚拟环境被删除或包被卸载,这些缓存文件依旧会常驻磁盘。
1. 查看当前 pip 缓存占用
通过内置缓存管理命令,可以查看当前 pip 缓存的所有 wheel 文件:
# 列出当前 pip 缓存目录中与 torch 相关的 wheel 归档
pip cache list torch*
2. 执行缓存清理
若要安全释放所有由 pip 缓存的安装归档,可使用 purge 子命令:
# 完全清空本地 pip 缓存目录,立即回收数 GB 磁盘空间
pip cache purge
如果希望仅针对性地清除 PyTorch 相关的缓存而不影响其他已缓存的日常轻量库,可以指定匹配模式:
# 仅移除名称以 torch 开头的本地缓存轮子
pip cache remove torch*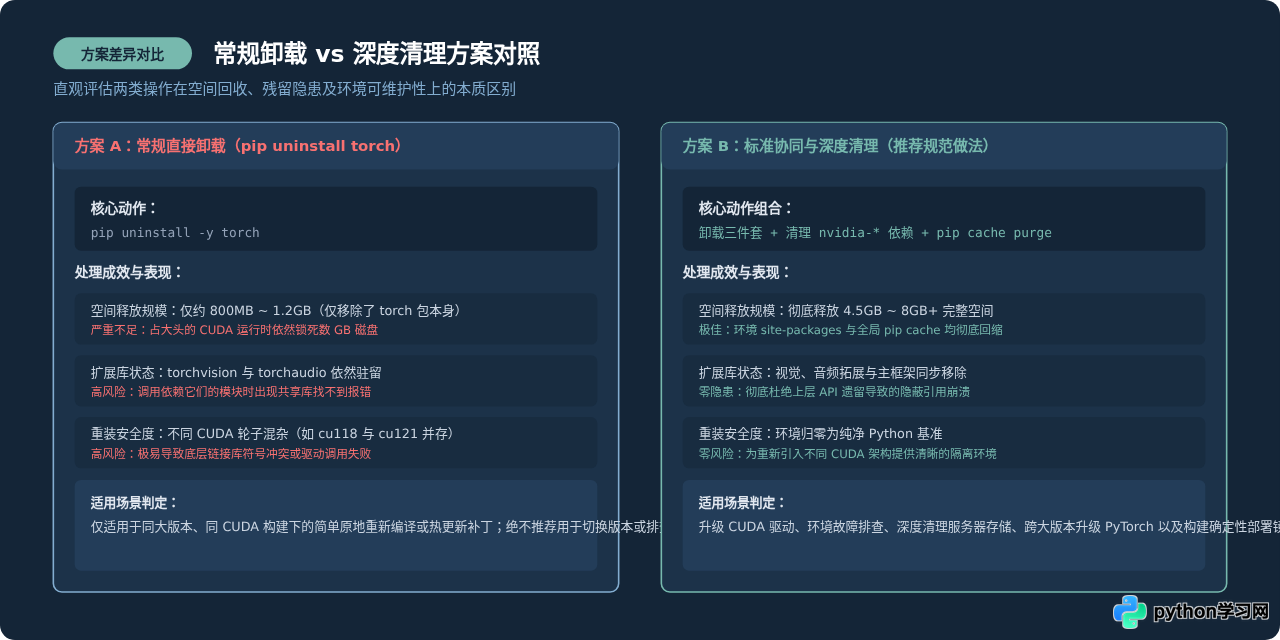
四、卸载后的环境验证与常见排查
命令执行完成后,切忌仅凭终端没有报错就判定卸载成功。通过标准脚本与检查列表验证环境的终态,是确保环境纯净的关键步骤。
1. Python 导入终态验证
在当前激活的环境中执行一行 Python 验证语句:
python -c "import torch"如果卸载成功且没有其他路径干扰,系统必须且应当明确抛出 ModuleNotFoundError:
Traceback (most recent call last):
  File "<string>", line 1, in <module>
ModuleNotFoundError: No module named 'torch'异常警示:如果输入上述命令后依然能打印出版本号,或者抛出的是 ImportError: DLL load failed 或 symbol lookup error,说明当前执行的 Python 解释器并非你刚刚执行卸载的环境,或者当前目录下存在名为 torch.py 的文件产生了命名覆盖。
2. 常见问题与避坑指南
- 多 Python 环境混淆:在配置了 Conda、virtualenv 或系统 Python 的开发机上,直接在终端执行
pip可能会调用到/usr/bin/pip而非虚拟环境内的 pip。务必养成使用python -m pip的习惯,它能绝对保证操作的是当前python命令对应的虚拟环境。 - User 目录残留(--user 安装):如果你此前曾使用过
pip install --user torch,包会被安装在个人家目录的~/.local/lib/pythonX.Y/site-packages下。此时如果在虚拟环境中执行卸载,可能不会触碰该目录。可使用python -m pip uninstall --user -y torch定向清理。 - 残留的 .dist-info 伪装文件:偶发情况下,若此前通过强制中断(Ctrl+C)终止了安装或卸载过程,site-packages 目录下可能残留空的
torch-*.dist-info文件夹。这会导致pip list依然显示包名,但无法被导入。手动进入 site-packages 路径删除该残留元数据文件夹即可。
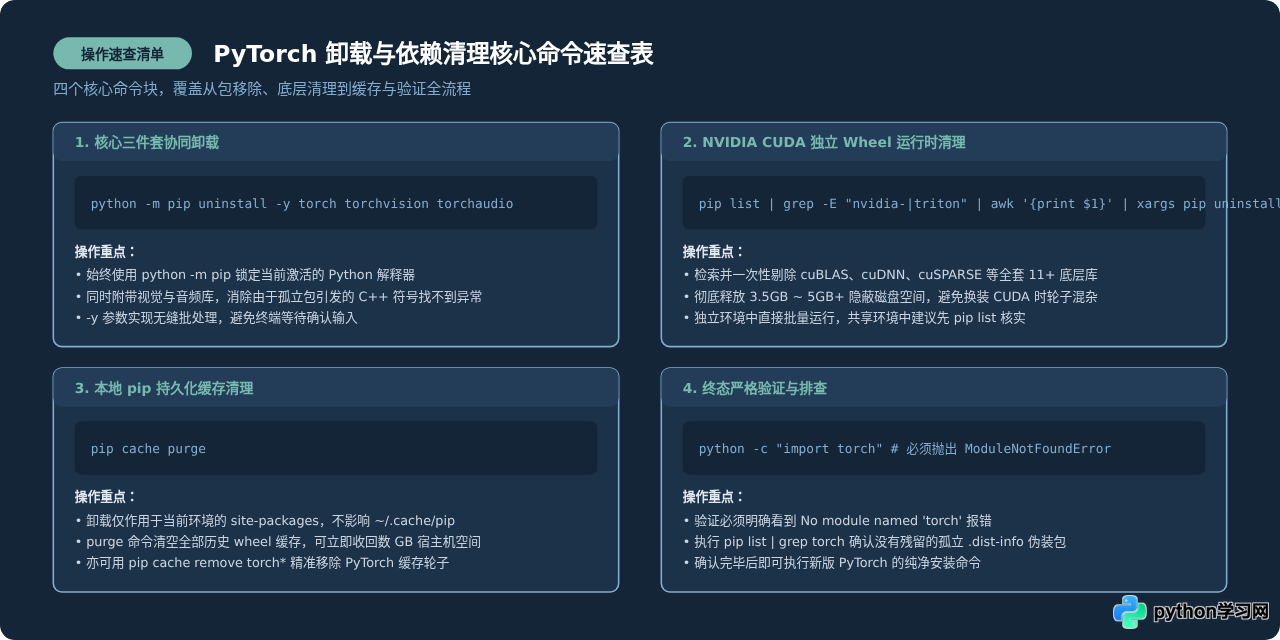
五、总结
通过 pip 卸载 PyTorch 的核心要点在于打破“单包卸载”的惯性思维。在现代深度学习软件栈中,PyTorch 已经形成了一个高度协同的体系。完整的清理需要完成三件事:
- 使用
python -m pip uninstall -y torch torchvision torchaudio实现核心库协同卸载; - 针对 GPU 安装环境,排查并移除
nvidia-*系列的独立 CUDA 运行时 Wheel 包及triton; - 通过
pip cache purge清理本地持久化缓存,彻底回收宿主机磁盘空间。
完成这三步后,再通过 python -c "import torch" 验证模块丢失状态,你的 Python 环境便回到了真正干净的基础状态,可以放心进行下一步的模型迁移或依赖重装。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









