

怎么使用len、max、min和sum函数统计Python列表数据
详细讲解如何使用Python内置的len、max、min和sum函数对列表数据进行统计分析,涵盖基础求值、均值与极差计算、空列表防御、类型安全以及进阶参数用法。
在 Python 数据处理与日常编程中,统计列表中的核心指标是极为高频的操作。Python 标准库自带的四个内置函数——len()、max()、min() 和 sum(),构成了最基础也最高效的数据统计基石。无需安装任何第三方扩展,仅凭这四个函数即可快速完成样本量计数、极值查找、总量累加以及平均数、极差等衍生指标的推算。本文将直接从具体操作入手,全面剖析这四个函数的调用语法、组合应用流程、边界异常防御以及高级参数技巧。
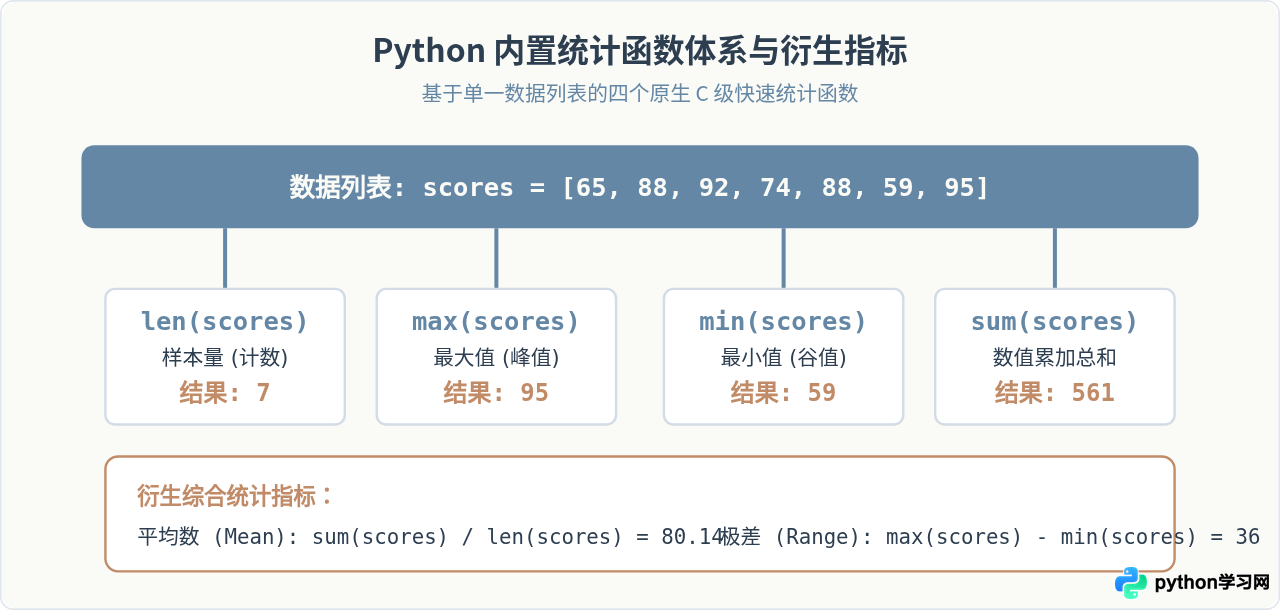
一、四个核心统计函数的基本语法与单项测算
在开始统计之前,我们需要先明确各个函数在底层上的职责定位与入参要求。下面给出一组包含浮点数和整数的销售量记录作为示例:
# 示例数据集:某零售商品过去 8 天的销售数量
sales_data = [120, 145, 98, 160, 210, 185, 130, 150]
1. len() 函数:统计样本数量
len() 用于返回容器中包含的元素个数。对于列表对象,Python 底层直接读取列表结构体中记录的长度字段(Ob_size),因此调用 len(list) 的时间复杂度为 O(1),效率极高。
count = len(sales_data)
print("样本总天数:", count)  # 输出: 样本总天数: 8
2. max() 与 min() 函数:探测极值
max() 和 min() 会线性遍历列表中的每一个元素,通过比较操作符选出当前列表的最大值或最小值。它们的时间复杂度为 O(n),其中 n 是列表长度。
peak_sale = max(sales_data)
valley_sale = min(sales_data)

print("最高单日销量:", peak_sale)    # 输出: 最高单日销量: 210
print("最低单日销量:", valley_sale)  # 输出: 最低单日销量: 98
3. sum() 函数:数值累加求和
sum(iterable, start=0) 将传入列表中的数值从左到右依次累加。默认情况下,初始值 start 为 0。要求列表内的所有元素都支持数值加法运算。
total_sales = sum(sales_data)
print("销售总量:", total_sales)  # 输出: 销售总量: 1198
二、统计计算实战流程与组合应用
单一指标往往只能反映数据的某一个截面。在实际业务中,我们通常将 sum() 与 len() 结合求平均值,将 max() 与 min() 结合求离散极差,并通过规范的处理流水线输出格式化统计报告。
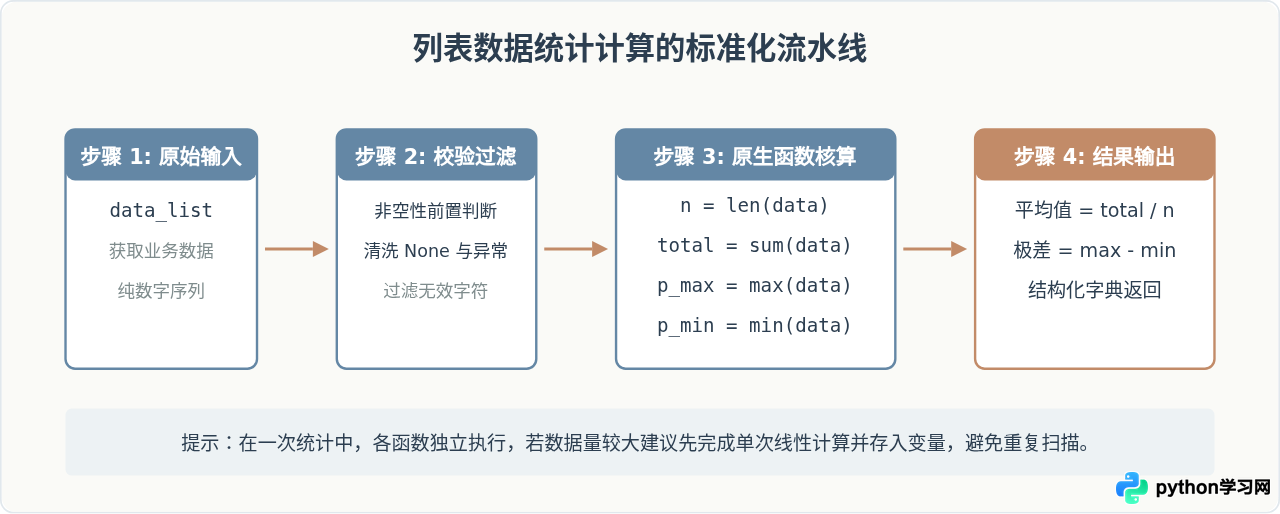
下面是一个封装好的统计分析函数示例,能够对任意数值列表输出完整的统计概览:
def calculate_list_statistics(numbers):
    # 步骤 1 & 2: 验证列表是否包含有效元素
    if not numbers:
        return {
            "count": 0,
            "total": 0,
            "mean": 0.0,
            "max": None,
            "min": None,
            "range": 0
        }

    # 步骤 3: 利用原生内置函数分别计算
    count = len(numbers)
    total = sum(numbers)
    max_val = max(numbers)
    min_val = min(numbers)

    # 步骤 4: 综合推算衍生指标
    mean_val = total / count
    range_val = max_val - min_val

    return {
        "count": count,
        "total": total,
        "mean": round(mean_val, 2),
        "max": max_val,
        "min": min_val,
        "range": range_val
    }

# 执行统计与输出结果展示
records = [82, 90, 78, 95, 60, 88, 92]
report = calculate_list_statistics(records)

print(f"样本总数: {report['count']}")
print(f"累加总分: {report['total']}")
print(f"平均分数: {report['mean']}")
print(f"最高得分: {report['max']}")
print(f"最低得分: {report['min']}")
print(f"离散极差: {report['range']}")
运行结果示例:
样本总数: 7
累加总分: 585
平均分数: 83.57
最高得分: 95
最低得分: 60
离散极差: 35
三、边界陷阱与防御式处理技巧
在实际工程场景中,直接无条件调用这四个函数可能会遭遇运行时崩溃。最主要的风险来自两点:空列表和脏数据类型。
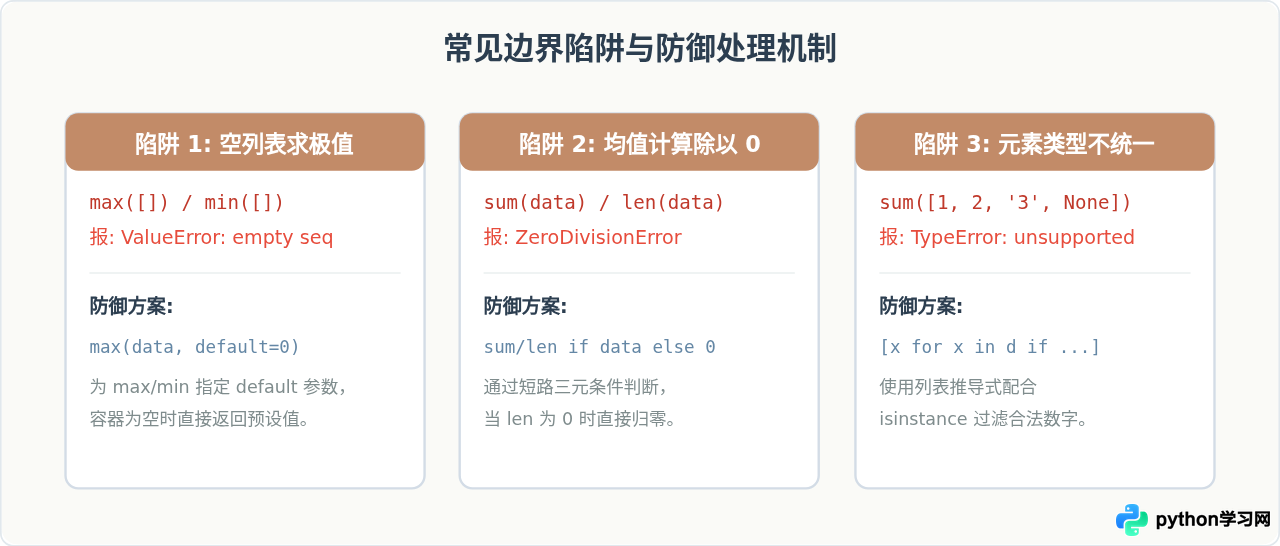
1. 空列表求极值的 default 保护
当传入空列表 [] 时,len([]) 返回 0,sum([]) 返回 0,但 max([]) 与 min([]) 会引发 ValueError: max() arg is an empty sequence。为了防止程序报错中断,可以为 max() 和 min() 传入 default 参数:
empty_data = []

# 安全读取最大值与最小值,若为空则返回 0
safe_max = max(empty_data, default=0)
safe_min = min(empty_data, default=0)

print("安全最大值:", safe_max)  # 输出: 0
print("安全最小值:", safe_min)  # 输出: 0
2. 平均值计算中的零除保护
因为 sum([]) 返回 0,在直接计算 sum(data) / len(data) 时,分母为 0 将触发 ZeroDivisionError。编写时应当使用条件表达式进行阻断:
data = []
average = sum(data) / len(data) if data else 0.0
print("空数据平均值:", average)  # 输出: 0.0
3. 混合类型数据的清洗过滤
如果列表中混杂了 None、字符串等非数值类型,直接调用 sum() 或 max() 会触发 TypeError。在调用统计函数前,应当利用列表推导式提取有效数值:
raw_mixed_list = [10, "20", 30.5, None, 45, "invalid"]

# 清洗出合法的数字(int 与 float)
cleaned_numbers = [
    item for item in raw_mixed_list
    if isinstance(item, (int, float))
]

print("清洗后数据:", cleaned_numbers)          # 输出: [10, 30.5, 45]
print("有效样本量:", len(cleaned_numbers))      # 输出: 3
print("有效求和:", sum(cleaned_numbers))        # 输出: 85.5
四、进阶用法:key 自定义规则与 start 累加偏移
除了纯数字列表的常规求值,max()、min() 和 sum() 还提供了强大的可选参数,用于处理嵌套列表、对象列表和特定基数的累加需求。
1. max() 与 min() 的 key 参数
当列表中包含字典、元组或自定义对象时,可以通过 key 参数指定一个转换函数,告诉 Python 依据哪个属性或字段进行比较:
# 字典列表示例:学生信息与成绩
students = [
    {"name": "张三", "score": 85},
    {"name": "李四", "score": 96},
    {"name": "王五", "score": 72},
    {"name": "赵六", "score": 91}
]

# 找出得分最高的学生字典
top_student = max(students, key=lambda s: s["score"])
# 找出得分最低的学生字典
lowest_student = min(students, key=lambda s: s["score"])

print("最高分学生:", top_student["name"], top_student["score"])   # 李四 96
print("最低分学生:", lowest_student["name"], lowest_student["score"]) # 王五 72

# 结合 sum 和 len 计算全班平均分
all_scores = [s["score"] for s in students]
class_avg = sum(all_scores) / len(all_scores)
print("班级平均分:", class_avg)  # 输出: 86.0
2. sum() 的 start 初始累加值
sum(iterable, start) 允许传入自定义的起始数值。例如在核算总成本时,若存在一笔不可变的基础固定费,可以直接写在 start 参数中:
item_prices = [25.0, 48.5, 130.0]
base_shipping_fee = 15.0  # 基础固定运费

# 以固定运费为基准开始累加
total_cost = sum(item_prices, start=base_shipping_fee)
print("包含运费的总支出:", total_cost)  # 输出: 218.5
虽然字符串也支持加法拼接,但 Python 明确禁止使用 sum(['a', 'b', 'c']) 拼接字符串,因为连续创建不可变字符串的时间复杂度高达 O(n²)。正确的拼接方式是使用字符串内置方法 "".join(list)。
五、四大内置统计函数速查与特性对比
为了在实际编码时快速选择合适的函数和参数,下表与示意图系统归纳了这四个函数的语法规范、复杂度表现与关键应用要点:
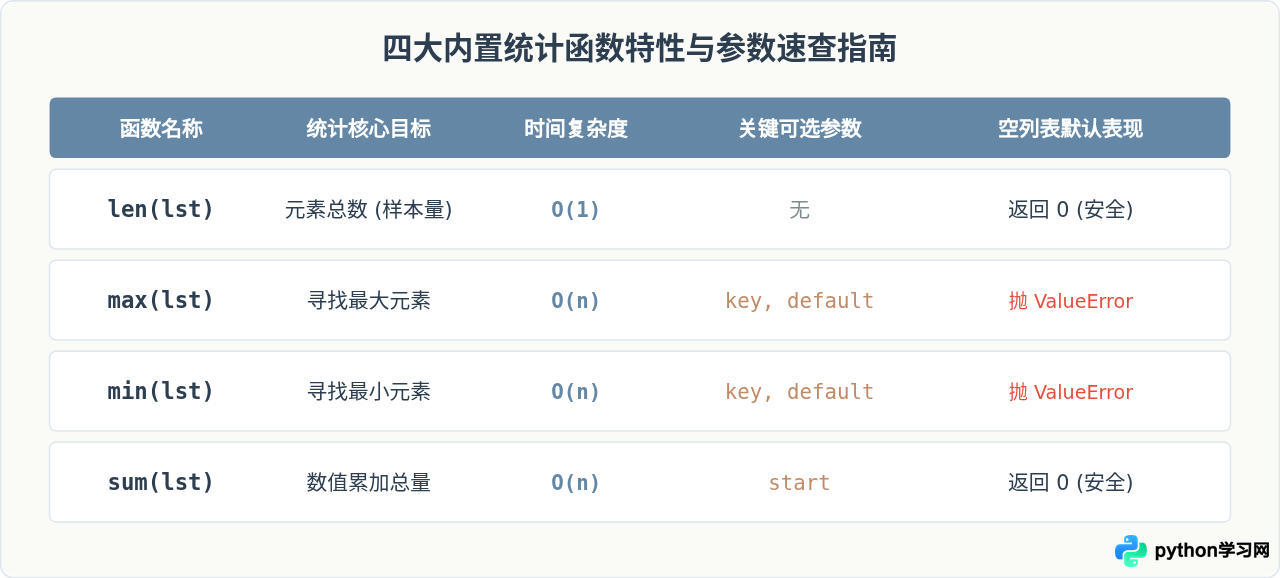
| 函数 | 输入类型要求 | 返回值类型 | 核心注意事项 |
|---|---|---|---|
len(s) |
任意序列或容器 | 整数 int | 内部直接取长度属性,速度最快,不可用于纯生成器迭代器。 |
max(iterable) |
元素间支持 > 比较 |
列表中元素同类型 | 空列表必须指定 default;复杂结构使用 key 映射。 |
min(iterable) |
元素间支持 < 比较 |
列表中元素同类型 | 与 max 一致,若存在并列极值,返回最先遇到的元素。 |
sum(iterable, start=0) |
支持 + 运算的数字序列 |
与元素精度一致 (int / float) | 禁止用于字符串拼接;计算均值必须检查 len != 0。 |
六、总结
使用 Python 原生内置的 len()、max()、min() 和 sum() 统计列表数据,是编写轻量、高效代码的首选方案。在实际开发中,请牢记以下三条最佳实践准则:
- 优先防空:在计算平均值(
sum/len)或调用max()/min()之前,先做好列表非空校验,或显式传入default参数避免程序崩溃。 - 确保类型同质:统计前通过列表推导式剔除非数字类型,保证参与计算的列表数据均为纯数值。
- 善用 key 与 start:处理对象列表或字典列表时,通过
key=lambda x: ...优雅提取比对键;存在固定基础值时,合理利用sum(..., start)简化代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









