

Python字符串判断方法实战:isdigit、isalpha与startswith用法
深入讲解Python中isdigit()、isalpha()与startswith()三大字符串判断方法的核心机制、参数细节、边界陷阱及在用户输入清洗、协议路由中的实战应用。
在编写Python程序处理外部数据时,我们常常需要对用户输入、配置文件路径或网络请求参数进行校验。Python内置了丰富的字符串条件检测方法,其中 isdigit()、isalpha() 与 startswith() 是三项最基础且高频使用的内置方法。本文通过具体的代码实例与场景推演,拆解这三个方法的判定规则、边界陷阱及在业务场景中的配合使用策略。
一、isdigit用法与数字边界解析
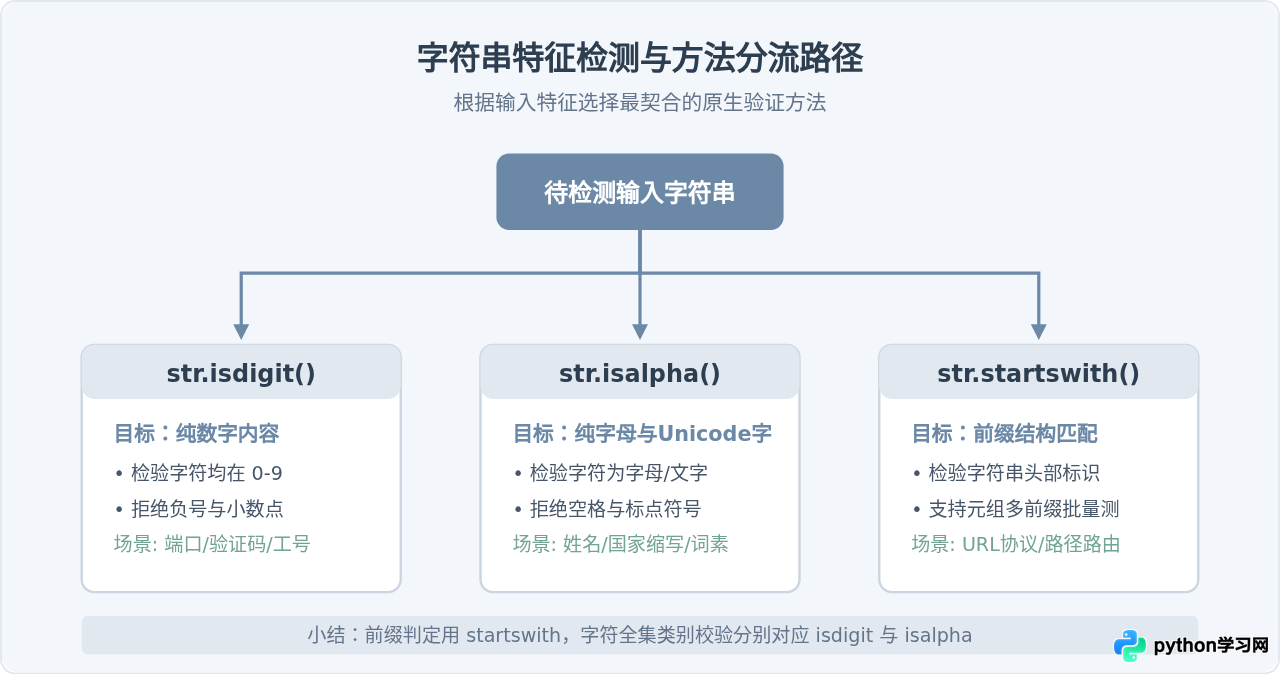
str.isdigit() 用于检测字符串是否只由数字字符组成。如果字符串中所有字符均为数字字符,且字符串非空,则返回 True;只要包含空格、负号、小数点或任何非数字字符,都会返回 False。
# 基础用法示例
code = "9527"
print(code.isdigit())  # 输出: True

price = "99.8"
print(price.isdigit())  # 输出: False,包含小数点不是纯数字

age_input = "-18"
print(age_input.isdigit()) # 输出: False,包含负号不是纯数字True
False
False
许多初学者会尝试直接使用 isdigit() 验证用户输入的金额或者负整数,导致程序误判。这里需要厘清一个概念:isdigit() 校验的是“字符的字符属性是否均为数字”,而不是“数学意义上的数值类型”。若要验证包含负号的整数,应先剔除左侧单负号;若验证浮点数,应借助 try...float() 异常捕获机制。
二、isalpha用法与Unicode特性认知
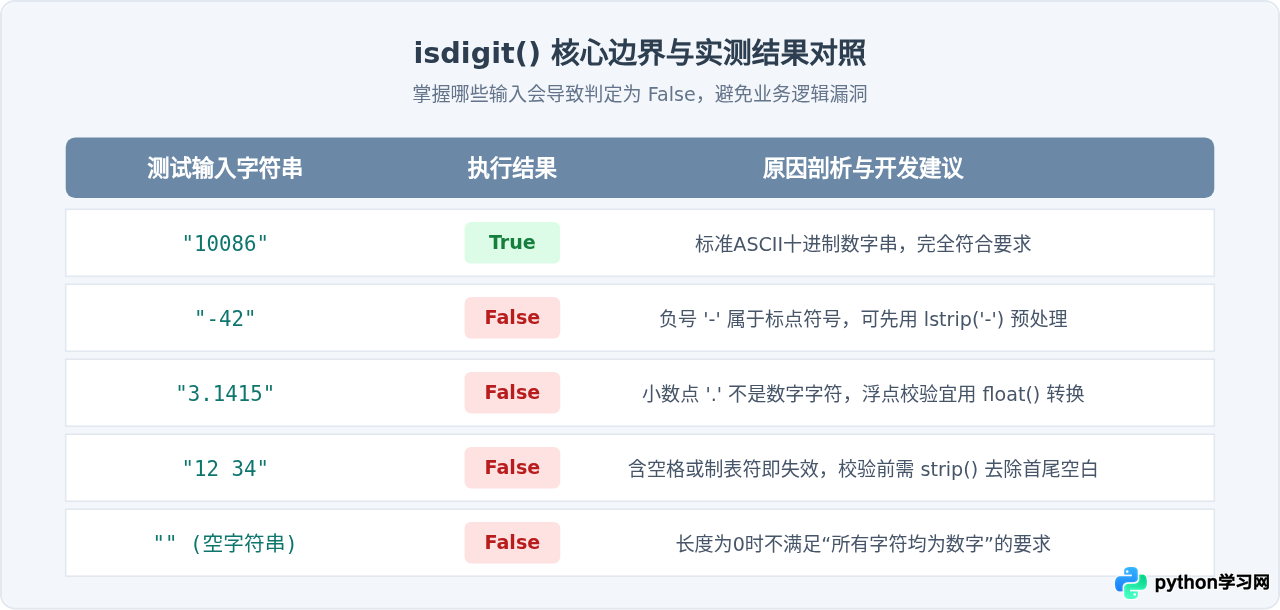
str.isalpha() 用于判断字符串是否全部由字母组成。它要求字符串至少包含一个字符,且内部不含空格、标点符号、数字及控制字符。
# 纯英文字符检测
tag = "python"
print(tag.isalpha())  # 输出: True

mixed = "python3"
print(mixed.isalpha())  # 输出: False,包含数字3

spaced = "hello world"
print(spaced.isalpha()) # 输出: False,包含空格True
False
False
在 Python 3 中,字符串默认采用 Unicode 编码标准。因此,isalpha() 判定的“字母”对应 Unicode 字符分类中的“Letter(L分类)”。这意味着中文字符、日文假名、韩文字符均会被判定为 True!
# 中文字符与混合输入测试
chinese_text = "人工智能"
print(chinese_text.isalpha())  # 输出: True!中文字符属于Unicode Letter

mix_cn_en = "Python教程"
print(mix_cn_en.isalpha())     # 输出: True!中英文字符均为Letter

symbol_cn = "你好,世界"
print(symbol_cn.isalpha()) # 输出: False,因为中文全角逗号属于PunctuationTrue
True
False
如果业务需求严格限定为“纯ASCII英文字母”(仅允许 a-z 与 A-Z),则不能单纯依赖 isalpha()。推荐采用 s.isascii() and s.isalpha() 进行双重判定,或者结合正则表达式 ^[a-zA-Z]+$ 确保符合预期。
三、startswith参数结构与多前缀元组匹配
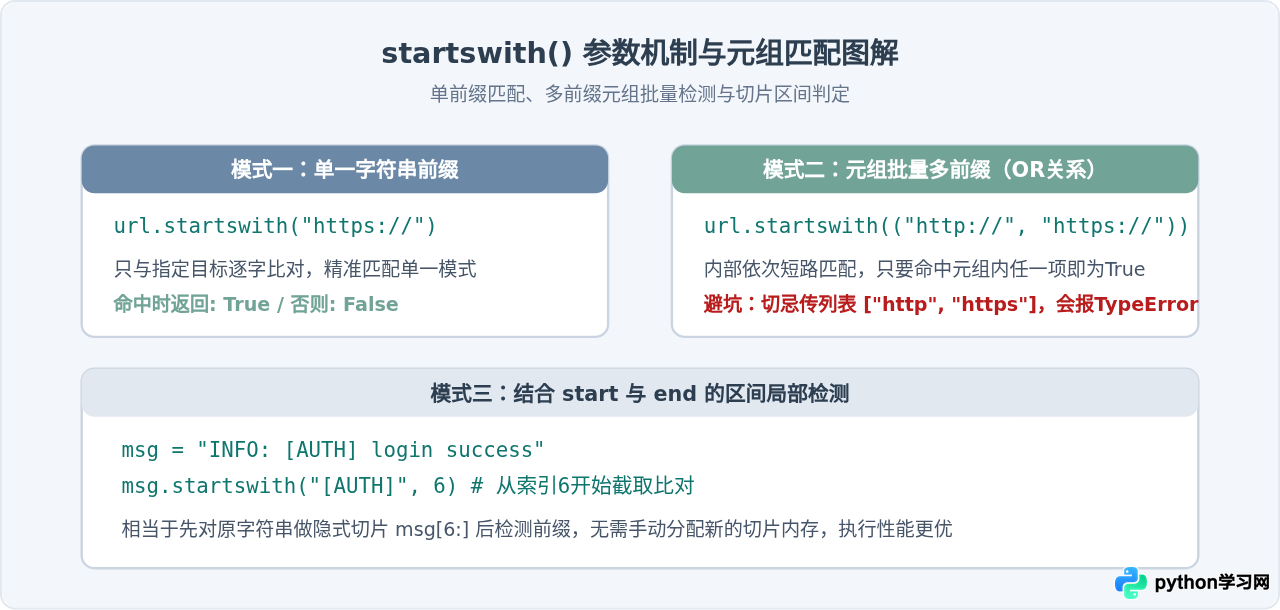
与全量字符类型检查不同,str.startswith() 专注于检查字符串是否以指定的前缀开头。其完整签名如下:
str.startswith(prefix[, start[, end]])参数说明:
prefix:必须传入字符串或由字符串构成的元组(tuple)。当传入元组时,只要字符串满足其中任意一个前缀,即刻返回True。注意:不能传入列表(list)或集合(set),否则会抛出TypeError。start(可选):切片检索的起始索引位置,默认从下标 0 开始。end(可选):切片检索的结束索引位置。
# 常见协议与文件路径判定示例
protocols = ("https://", "http://", "ftp://")

test_url1 = "https://example.com/api"
test_url2 = "sftp://files.org"

print(test_url1.startswith(protocols))  # 输出: True,命中 https://
print(test_url2.startswith(protocols)) # 输出: False,不在允许协议列表中True
False
四、综合实战案例:输入校验与路由分发
在实际工程中,这三个方法往往组合使用,共同构成数据流转的第一道过滤网。下面展示一个清洗用户输入及根据指令前缀分发任务的完整控制函数:
def process_user_command(raw_input: str) -> str:
    """
    清洗并解析用户输入指令
    1. 判断是否以特定指令前缀开头
    2. 判断指令携带的参数类型 (纯数字工号还是字母姓名)
    """
    cleaned = raw_input.strip()
    if not cleaned:
        return "错误:输入为空"

    # 1. 协议或指令前缀检查
    if cleaned.startswith(("/admin", "ADMIN:", "!admin")):
        return f"进入管理员调度流: {cleaned}"

    # 2. 查询类命令前缀检查
    if cleaned.startswith("QUERY:"):
        payload = cleaned[6:].strip()
        if payload.isdigit():
            return f"执行按数字ID检索流程,ID: {payload}"
        elif payload.isascii() and payload.isalpha():
            return f"执行按英文字符名检索流程,名称: {payload}"
        else:
            return f"参数格式无效: {payload}(必须为纯数字ID或纯字母名称)"

    return f"普通文本输入: {cleaned}"

# 验证测试
commands = [
    "  QUERY: 10086 ",
    "QUERY: Alice",
    "QUERY: Admin_99",
    "/admin reboot",
    "hello world"
]

for cmd in commands:
print(f"[{cmd}] => {process_user_command(cmd)}")[ QUERY: 10086 ] => 执行按数字ID检索流程,ID: 10086
[QUERY: Alice] => 执行按英文字符名检索流程,名称: Alice
[QUERY: Admin_99] => 参数格式无效: Admin_99(必须为纯数字ID或纯字母名称)
[/admin reboot] => 进入管理员调度流: /admin reboot
[hello world] => 普通文本输入: hello world
五、三大方法横向对比与选型速查
为了在实际编码中快速选择合适的方法并规避隐蔽的边界Bug,下表对三个方法的关键特性进行了横向归纳:
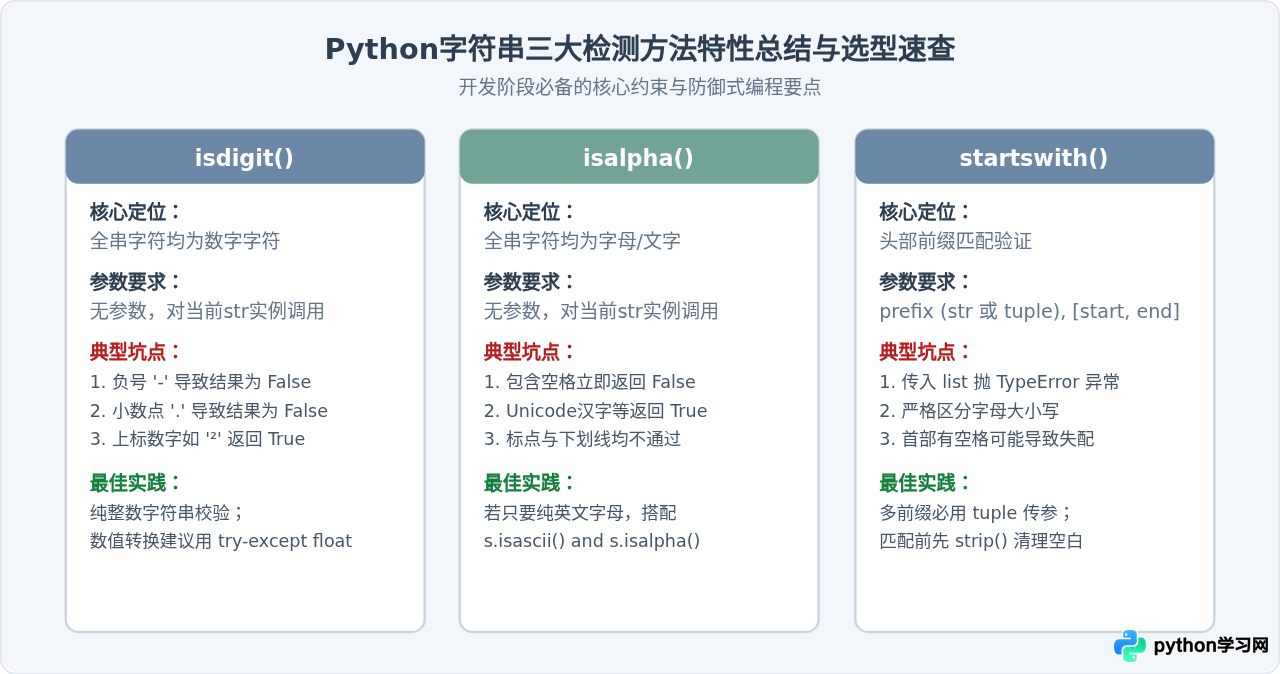
总结而言,在日常开发中,对于前缀识别应优先使用 startswith() 搭配元组参数;对于内容全集校验,要牢记 isdigit() 对负数、浮点数以及 isalpha() 对中文字符的特殊反应,在必要时结合 strip()、isascii() 或显式异常处理,构建健壮严谨的输入校验逻辑。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









