

Python数据结构与算法入门:列表底层原理及手动实现栈和队列
深入解析Python内置列表(list)的底层连续内存与动态扩容机制,剖析尾部与头部操作的性能差异,并通过面向对象方式手动实现栈与队列,帮助初学者跨过数据结构入门门槛。
在 Python 编程中,列表(list)是最常用也是最灵活的数据容器,许多初学者直观地将其当成无所不能的动态数组。然而,列表底层由 C 语言实现的连续指针数组构成,其特殊的内存布局和过度分配(Over-allocation)策略,使得尾部插入与头部插入存在巨大的性能差异。本文将拆解 Python 列表的物理内存机制,并在此基础上手动实现计算机科学中两个最经典的线性结构——栈(Stack)与队列(Queue),厘清算法底层流转与性能优化的关键分水岭。
一、Python 列表底层内存结构与扩容原理
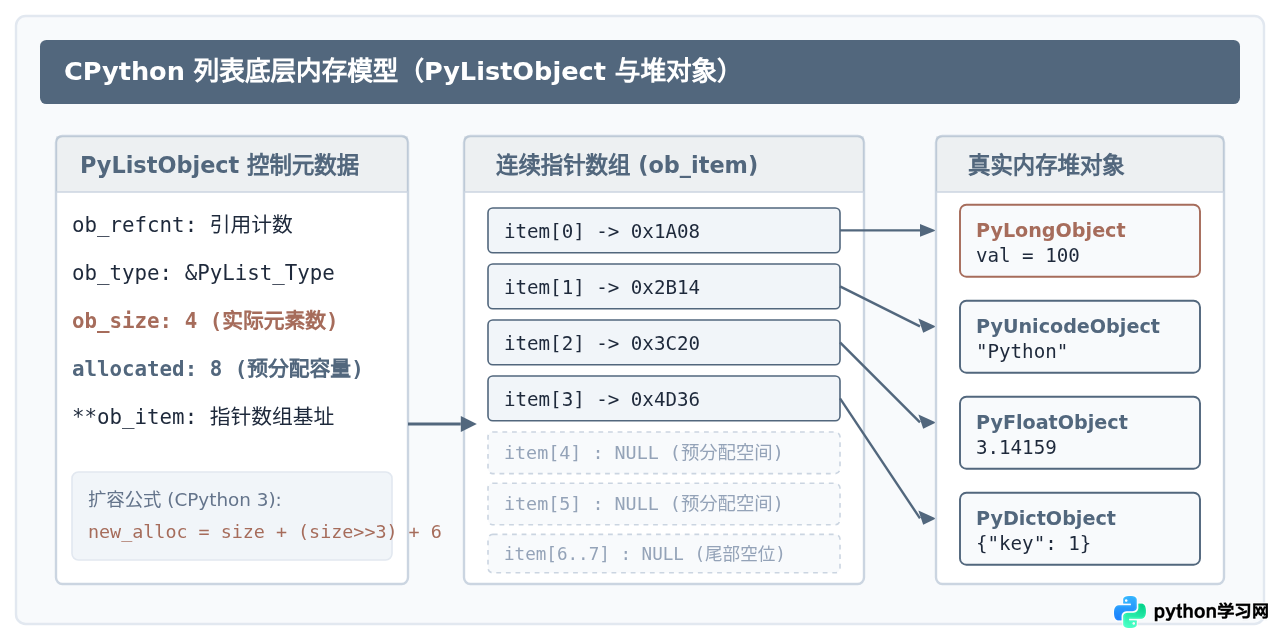
Python 列表并不是直接将数值或字符串等对象并排塞入内存连续块中,而是由 CPython 的 PyListObject 结构体负责管理。其本质是一个存储“对象引用(指针)”的变长连续数组。
当我们在 Python 中执行 lst = [10, "hello", 3.14] 时,系统在内存中分配的是一块连续的指针槽位(在 64 位系统上每个指针占用 8 字节)。这些指针分别指向实际分散存放在内存堆中的整数、字符串和浮点数对象。这种“指针数组”的设计赋予了 Python 列表容纳异构类型的自由,但也带来了两次内存寻址的开销。
1. 动态扩容策略与均摊时间复杂度
为了避免每次执行 append() 时都调用系统底层 realloc 重新分配内存,CPython 采取了“超额分配(Over-allocation)”策略。每次当前空间耗尽时,分配的新容量近似于:
new_allocated = newsize + (newsize >> 3) + (newsize < 9 ? 3 : 6)
这就意味着,每次扩容都会多留出一些连续槽位。当连续调用 append() 时,大部分操作只需要将新对象的地址填入已分配的空闲槽位并递增 ob_size,单次耗时稳定在 O(1)。虽然偶发的扩容会引发整体搬移(复制全部旧指针到新地址块,耗时 O(N)),但分摊到多次追加操作后,其均摊时间复杂度依然是 O(1)。
2. 尾部操作 vs 头部操作的本质差异
指针数组的物理连续性决定了:
- 尾部追加/弹出(
append() / pop()):直接在ob_item[ob_size]处写入或读取,不需要搬移既有元素,平均时间复杂度为 O(1)。 - 头部插入/删除(
insert(0, val) / pop(0)):在索引 0 处插入或移出元素后,后续的所有指针必须整体向右或向左平移一个位置(调用 C 库的memmove)。因此,头部操作的时间复杂度必然是 O(N)。
这个性能特征,正是我们能否直接用列表充当“栈”和“队列”的核心判断依据。
二、手动实现栈(Stack):利用尾部高效性
栈(Stack)是一种典型的后进先出(LIFO, Last In First Out)线性数据结构。现实生活中的立式餐盘架就是最直观的例子:最后放上去的盘子位于最顶层,最先被拿走;最早放进去的盘子垫在最底下。
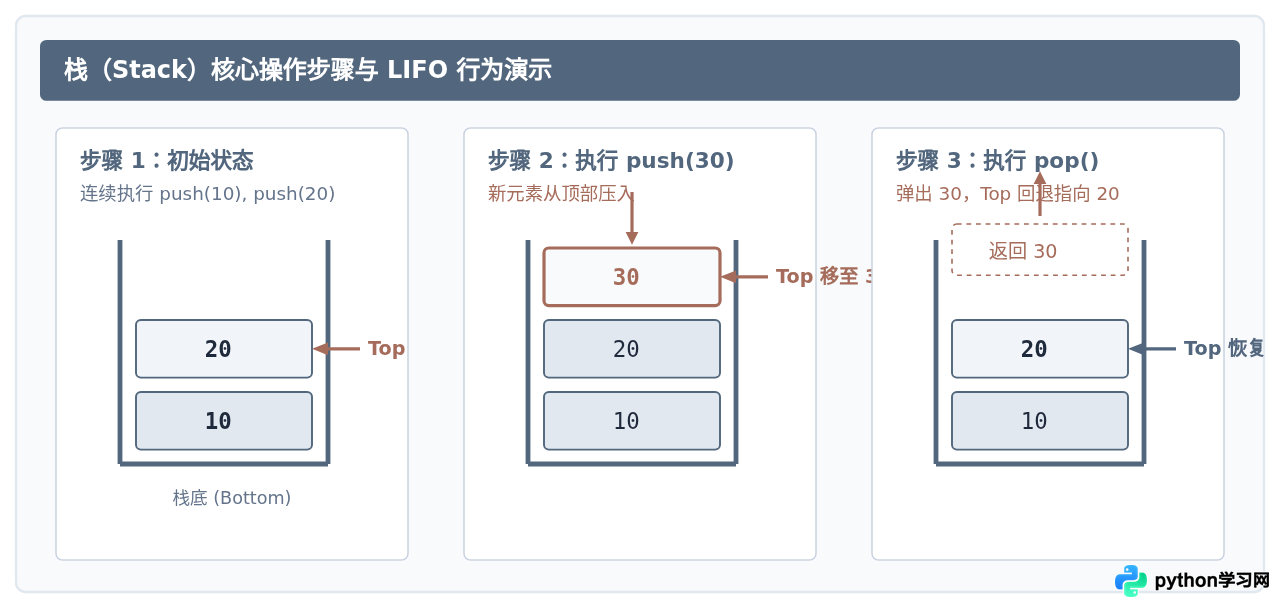
由于栈的所有操作只在“栈顶”发生,如果我们将 Python 列表的尾部作为栈顶,那么:
push(val)对应list.append(val),时间复杂度为 O(1)。pop()对应list.pop(),移出末尾元素,时间复杂度同样为 O(1)。peek()直接通过list[-1]访问,时间复杂度为 O(1)。
手动封装 Stack 类代码
在工程实践中,为了防止外部代码随意利用索引修改栈内元素,通常将列表封装在类中,并限制暴露的接口:
class Stack:
    """基于Python列表尾部高效特性的栈实现"""
    def __init__(self):
        self._items = []

    def push(self, item):
        """入栈操作:均摊 O(1)"""
        self._items.append(item)

    def pop(self):
        """出栈操作:O(1),对空栈弹出抛出 IndexError"""
        if self.is_empty():
            raise IndexError("pop from empty stack")
        return self._items.pop()

    def peek(self):
        """查看栈顶元素,不改变栈结构:O(1)"""
        if self.is_empty():
            raise IndexError("peek from empty stack")
        return self._items[-1]

    def is_empty(self):
        """判断栈是否为空"""
        return len(self._items) == 0

    def size(self):
        """返回栈内元素数量"""
        return len(self._items)

    def __repr__(self):
return f"Stack({self._items})"self._items.insert(0, item) 和 self._items.pop(0) 作为栈顶。虽然逻辑上同样能实现 LIFO,但会导致每次入栈和出栈的时间复杂度从 O(1) 退化为 O(N)。
三、手动实现队列(Queue):性能陷阱与优化方案
队列(Queue)是一种先进先出(FIFO, First In First Out)的数据结构。正如排队购票,先到的人排在队头(Front)最先买票离开,新到的人排在队尾(Rear)等待服务。
1. 朴素列表实现的性能陷阱
如果初学者使用列表简单封装队列:
# 存在严重性能隐患的实现方式
class NaiveQueue:
    def __init__(self):
        self._data = []
    def enqueue(self, val):
        self._data.append(val)  # 队尾追加:O(1)
    def dequeue(self):
        return self._data.pop(0) # 队头移出:O(N) 灾难!
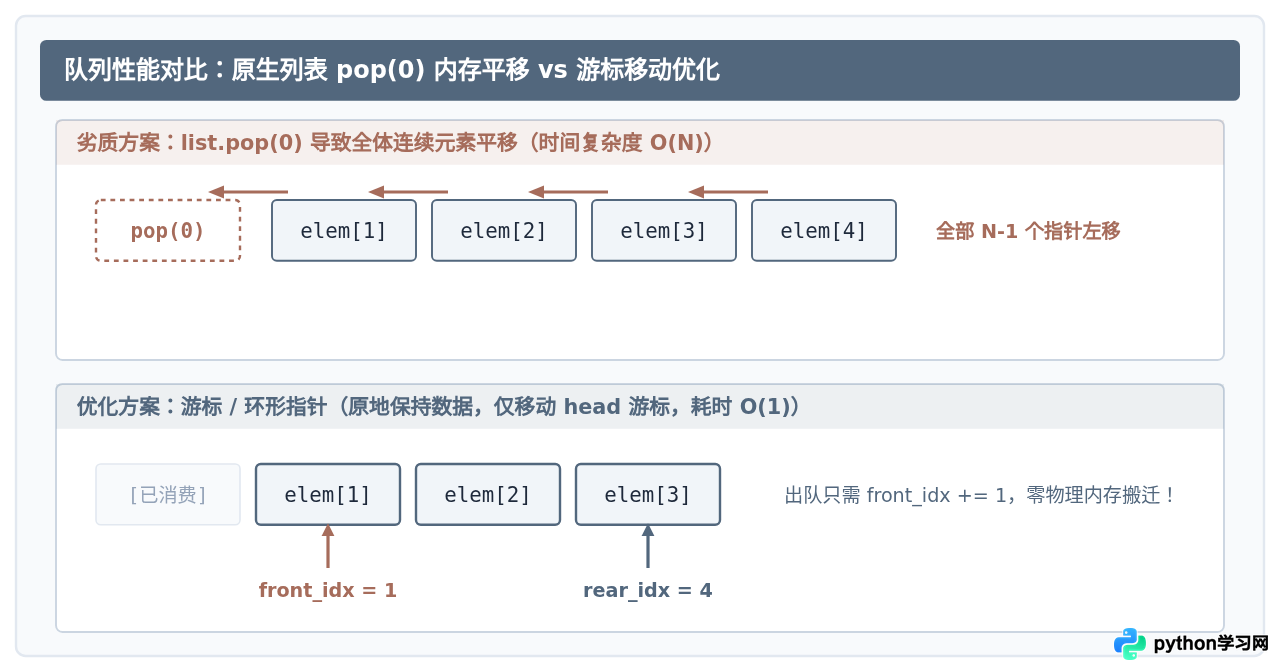
当队列中积累了 10 万个元素时,每一次 dequeue() 都会触发 memmove 将后面 99,999 个指针全部向左平移一个槽位。如果在高吞吐的服务中不断出队,程序将会大量消耗 CPU 资源,运行速度断崖式下跌。
2. 手动实现高性能游标式/环形缓冲队列
为了规避 pop(0) 带来的 O(N) 内存搬移,我们可以维护一个头部游标 _head。每次 dequeue() 时只递增游标并将原槽位置为 None(便于垃圾回收),出队耗时降为 O(1)。同时,为了避免无休止追加造成内存泄漏,当无效空位累积超过一定阈值时,做一次批量的紧凑清理:
class EfficientQueue:
    """基于列表与游标指针实现的高效队列"""
    def __init__(self, compact_threshold=1000):
        self._items = []
        self._head = 0  # 队头指针
        self._compact_threshold = compact_threshold

    def enqueue(self, item):
        """入队操作:O(1)"""
        self._items.append(item)

    def dequeue(self):
        """出队操作:均摊 O(1),无持续内存搬移"""
        if self.is_empty():
            raise IndexError("dequeue from empty queue")

        item = self._items[self._head]
        self._items[self._head] = None  # 释放对象引用
        self._head += 1

        # 当已出队空闲头部超过阈值且占满半数时,执行一次性紧凑裁剪
        if self._head > self._compact_threshold and self._head > len(self._items) // 2:
            self._items = self._items[self._head:]
            self._head = 0

        return item

    def peek(self):
        """查看队头元素:O(1)"""
        if self.is_empty():
            raise IndexError("peek from empty queue")
        return self._items[self._head]

    def is_empty(self):
        """判断队列是否为空"""
        return self._head >= len(self._items)

    def size(self):
        """返回队列真实元素个数"""
        return len(self._items) - self._head
3. Python 标准库首选:collections.deque
在标准库中,Python 专门提供了 collections.deque(双端队列)。它的底层不是单一的连续动态数组,而是基于双向链表管理的定长内存块(Block-based Doubly Linked List)。每个节点内部是一个能存放 64 个指针的小数组,当两端插入或删除时,只需分配新的 Block 或在现有 Block 头尾读写:
from collections import deque

# 标准库的高性能队列实践
queue = deque()
queue.append("A")     # 队尾入队:稳定 O(1)
queue.append("B")
first = queue.popleft() # 队头出队:稳定 O(1),毫无内存整体搬移开销
四、数据结构特性与选型对照总结
理解底层是为了在实际工程中做出正确的选型。下表与图示直观对比了本文涉及的结构在各维度的操作特性:
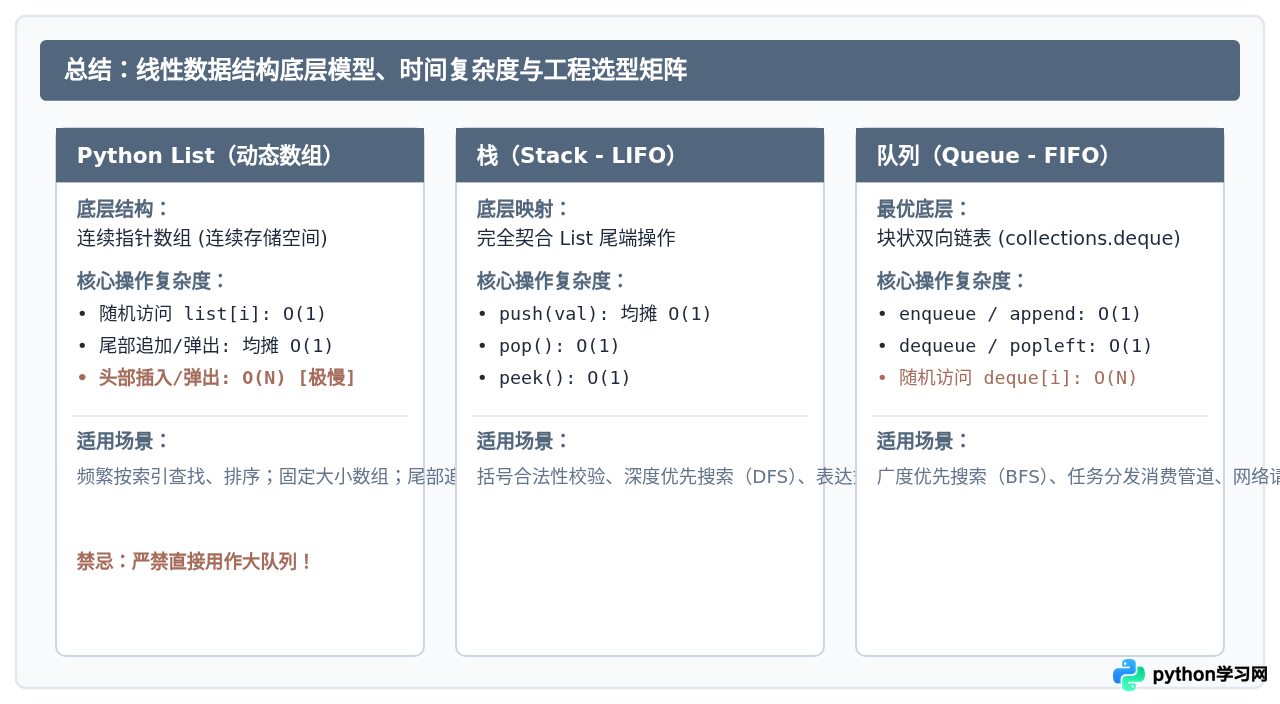
| 数据结构 | 插入元素 | 移出元素 | 索引访问 | 内存特点 |
|---|---|---|---|---|
| Python List | 尾部 O(1) / 头部 O(N) | 尾部 O(1) / 头部 O(N) | O(1) 随机访问 | 连续指针,支持过度分配,存在内存冗余 |
| 手动 Stack (基于列表尾部) | push: 均摊 O(1) | pop: O(1) | 仅开放 peek O(1) | 直接复用列表尾部,无额外节点开销 |
| 朴素 Queue (list.pop(0)) | enqueue: O(1) | dequeue: O(N) [危险] | 不推荐随机访问 | 频繁移动内存指针,性能极低 |
| 优化 Queue (游标/环形) | enqueue: O(1) | dequeue: 均摊 O(1) | 不开放 | 保留连续性,定期裁剪无效空槽 |
| collections.deque | 双端 append: O(1) | 双端 pop: O(1) | 中间访问 O(N) | 分块双向链表,两端性能极其优异 |
掌握 Python 列表的物理内存连续性与动态扩容逻辑,不仅能让我们在实现栈与队列时避开隐藏的性能陷阱,更是理解计算机体系结构、缓存局部性(Cache Locality)以及设计高吞吐服务端系统的关键基石。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









