

Python自定义函数的基本语法结构详解
深入详解Python自定义函数的基本语法结构,系统剖析def声明、参数列表、返回值机制、执行生命周期及变量作用域规则,提供完整代码示例与工程规范总结。
def 关键字声明,将一段具备特定逻辑的代码封装为独立的可调用单元。函数不仅消除了冗余的重复代码,更通过输入参数与返回值建立了清晰的模块契约。理解函数的语法构成、参数绑定机制、返回处理与作用域寻址,是编写高质量、结构化Python程序的必备基础。
一、函数的基本定义与核心语法要素
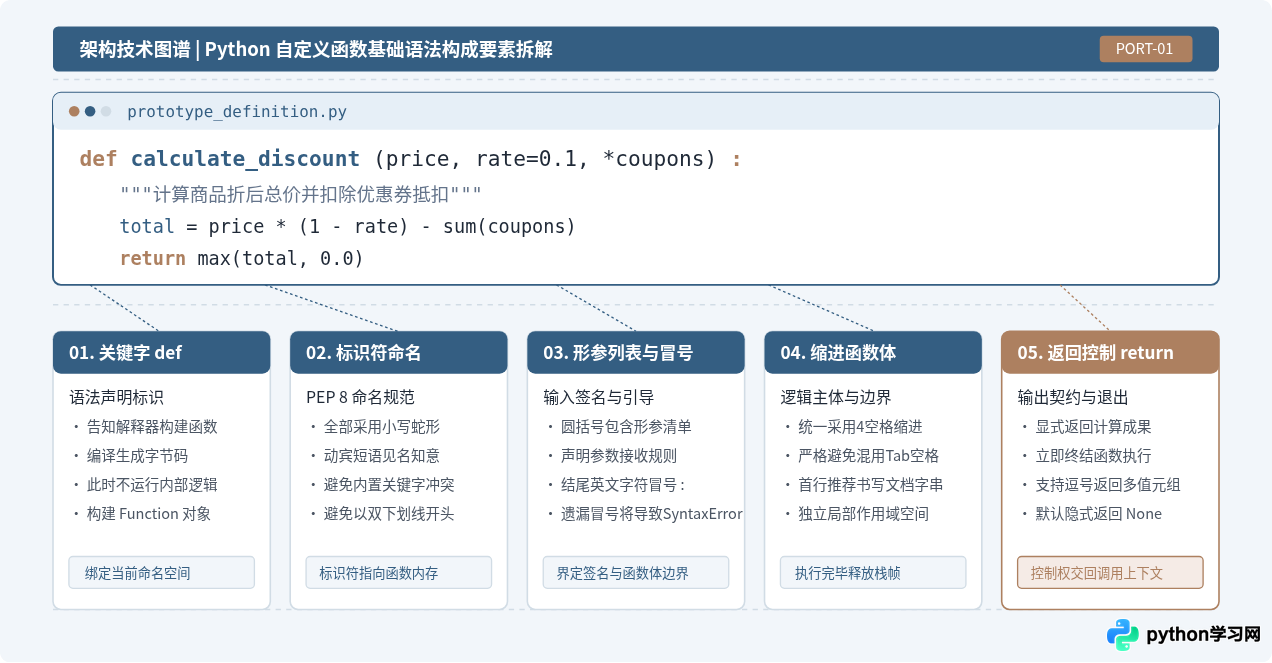
Python使用 def(define的缩写)关键字来声明自定义函数。一个完整的函数定义通常由七个关键部分构成:声明关键字、函数标识符、圆括号形参列表、语句块引导冒号、文档字符串(Docstring)、缩进函数体以及返回值控制语句。
标准函数定义的通用语法模板如下:
def function_name(parameter_1, parameter_2, ...):
    """函数功能与接口简要说明文档(Docstring)"""
    # 缩进4个空格的函数体逻辑代码
    statement_1
    statement_2
    return result_value
针对语法结构中的每一个组成单元,其具体技术规范与设计目的如下:
- def 关键字:告知Python解释器当前语句为函数定义。解释器解析到该关键字时,会构造一个函数对象(Function Object),但不会立即运行函数体内部的运算代码。
- 函数标识符(函数名):函数在当前命名空间中的变量名,遵循PEP 8命名规范,推荐全部使用小写英文字母,单词之间用下划线
_分隔(如calculate_tax、parse_user_data)。 - 形参列表
():位于函数名后的圆括号中,用于接收外部传入的数据。形参可以为空,也可以包含多个不同类型的参数声明。 - 末尾冒号
::标明函数签名部分的终结,引导随后缩进代码块的开始。在Python中,冒号是语法结构的核心分隔符,遗漏会导致SyntaxError。 - 文档字符串(Docstring):紧跟在冒号之后第一行的三引号字符串,用于解释函数的用途、输入输出规格与异常抛出情况,可以通过
function_name.__doc__或内置help()函数提取查看。 - 缩进函数体:Python放弃了大括号
{},完全依赖统一的缩进层级(PEP 8严格规定为4个空格)来界定代码块范围。 - return 语句:指定函数向调用方输出的结果,并立即退出当前函数。如果函数执行完毕未遇到
return,解释器会自动返回None。
下面是一个标准的综合演示代码,展示如何定义并调用一个包含参数默认值与文档注释的函数:
def generate_user_profile(username, role="guest", active=True):
    """
    构造用户属性字典。

    参数:
        username (str): 用户的登录名称
        role (str): 用户角色,默认值为 'guest'
        active (bool): 账户启用状态,默认值为 True

    返回:
        dict: 组装后的标准化用户资料
    """
    profile = {
        "user": username.strip().lower(),
        "role": role,
        "is_active": active
    }
    return profile

# 示例调用与输出
result_1 = generate_user_profile("Alice", role="admin")
result_2 = generate_user_profile("Bob")

print("调用示例 1 输出:", result_1)
print("调用示例 2 输出:", result_2)
控制台示例输出如下:
调用示例 1 输出: {'user': 'alice', 'role': 'admin', 'is_active': True}
调用示例 2 输出: {'user': 'bob', 'role': 'guest', 'is_active': True}
二、函数从定义到调用的完整生命周期流程
初学者容易产生一个认知误区:认为解释器在读取到 def 时就会执行函数内的语句。事实上,Python程序的运行被严格划分为“定义阶段”与“调用阶段”。
完整的生命周期按序包含四个离散步骤:
- 步骤一:定义与编译阶段(Definition Phase)
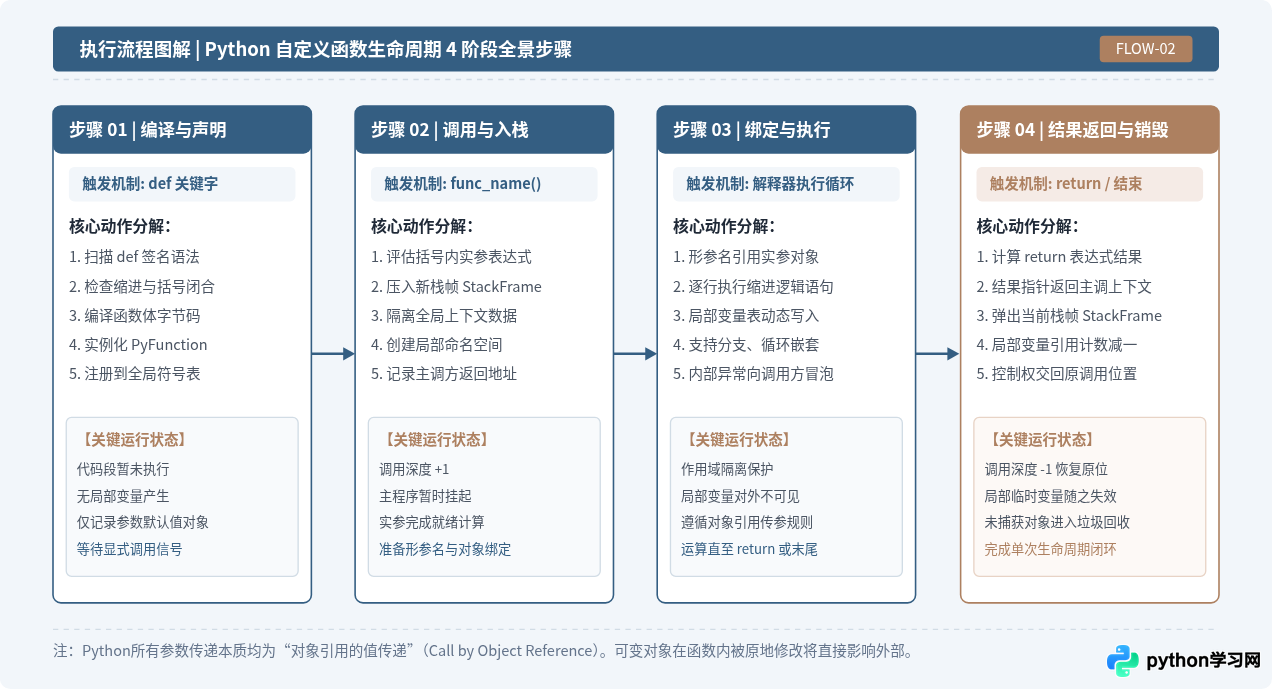
Python解释器从上至下按行读取脚本,当遇到def function_name(...):时,仅进行词法与语法分析,将函数体内的代码编译为字节码对象(Code Object),并在当前的全局命名空间中创建一个名为function_name的变量,使其指向该新建的函数对象。此时函数内部的任何计算语句均被挂起,不会发生实际运算。 - 步骤二:调用触发与参数求值(Invocation Phase)
当代码执行到带有调用操作符圆括号的表达式(如function_name(arg1, arg2))时,调用流程被触发。解释器首先在当前环境中评估实参表达式的具体数值。随后,Python虚拟机在执行调用栈(Call Stack)上为该函数分配专属的局部栈帧(Stack Frame)。 - 步骤三:实参形参绑定与函数体执行(Execution Phase)
进入栈帧后,解释器建立该函数的局部命名空间(Local Namespace),将传入的实参对象指针按匹配规则赋值给形参名称。紧接着,程序计数器跳入函数的字节码指令段,自上而下严格执行缩进代码块。 - 步骤四:返回值传递与栈帧销毁(Return & Cleanup Phase)
当程序遇到return语句(或自然执行完最后一行代码)时,将指定的返回值对象引用交还给调用方的变量接收端。随后,操作系统与虚拟机立即销毁该次调用的局部栈帧,函数内未被外部持有的局部变量引用计数减一,等待垃圾回收,程序控制流返回原调用点继续向下推进。
三、形参定义与实参传递的匹配机制
函数声明时的变量称为形参(Parameter),而调用函数时实际传入的值称为实参(Argument)。Python提供了高度灵活的参数传递机制,包括位置参数、默认参数、可变位置参数与可变关键字参数。
1. 参数的基本分类与声明规则
| 参数类型 | 声明语法形式 | 传参行为特征 | 典型应用场景 |
|---|---|---|---|
| 必须位置参数 | def f(x, y): |
必须传入,按实参出现的前后相对物理位置一一对应赋值。 | 核心关键输入,如计算坐标 x, y |
| 默认参数 | def f(x, timeout=30): |
若未传参则自动使用默认值;若传入实参则覆盖默认值。 | 配置开关、常规阈值、通用连接超时等 |
| 不定长位置参数 | def f(*args): |
接收任意多个额外的位置实参,在函数内自动组装为一个元组(tuple)。 | 不确定数量的数值累加、通用代理包装器 |
| 不定长关键字参数 | def f(**kwargs): |
接收任意多个额外的命名实参,在函数内自动组装为一个字典(dict)。 | 透传配置项、ORM查询条件组装、插件参数 |
2. 参数定义的严格顺序约束
Python语法解析器要求在定义函数时,形参必须遵循严格的先后排列顺序,否则在语法分析阶段就会直接报错 SyntaxError: non-default argument follows default argument:
合法排列顺序:位置参数 → 默认参数 → *args → 仅限关键字参数(Keyword-Only) → **kwargs
默认参数在函数被解释器加载定义时完成实例化求值,并且在后续的整个程序运行期内仅求值一次!如果默认参数被声明为可变对象(如空列表
[] 或空字典 {}),多次调用将共享同一个内存容器,造成灾难性的状态残留隐患。
对比以下错误与正确的默认参数写法:
# 错误示例:默认参数使用了可变列表
def bad_append(item, container=[]):
    container.append(item)
    return container

print(bad_append(1))  # 输出: [1]
print(bad_append(2))  # 意外输出: [1, 2],而不是预期的 [2]!

# 正确示例:使用不可变的 None 作为哨兵值,并在函数体内动态初始化
def safe_append(item, container=None):
    if container is None:
        container = []
    container.append(item)
    return container

print(safe_append(1))  # 输出: [1]
print(safe_append(2))  # 正常输出: [2]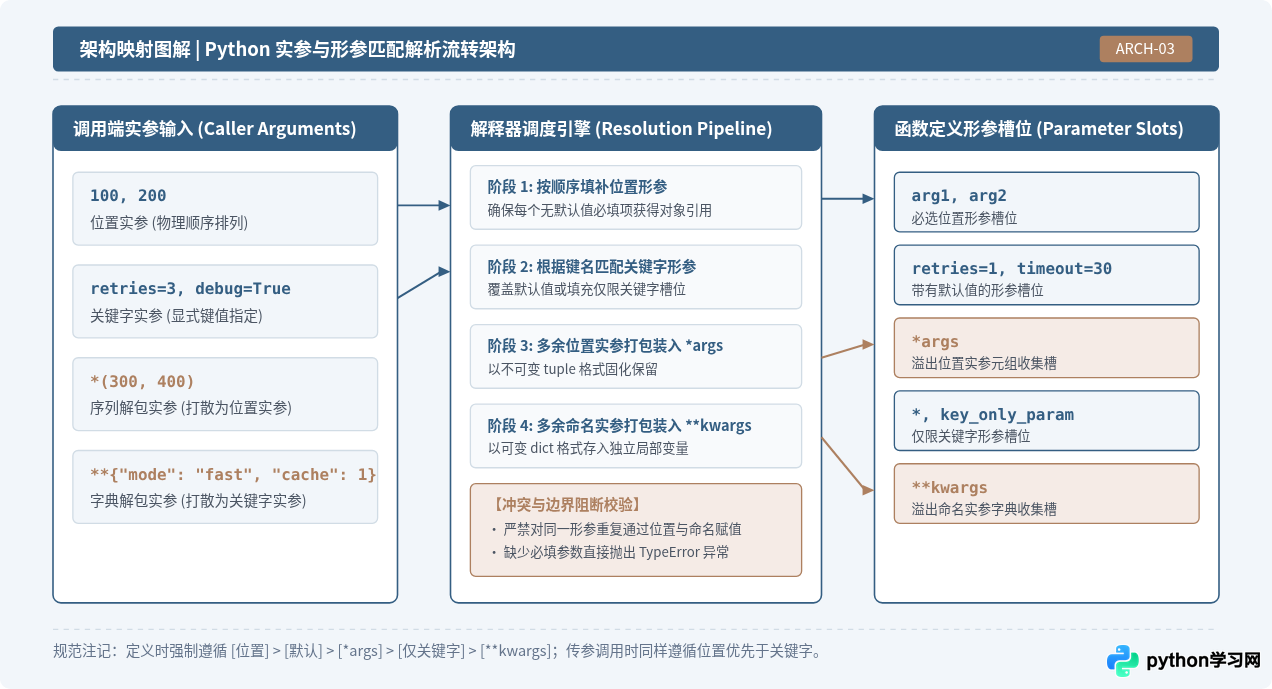
四、返回值处理与变量作用域机制
1. 返回值的行为特征与多值返回原理
在Python中,return 语句承担两个任务:将计算产物交给外部调用者,并强行中断当前函数的后续执行。在函数内部,任何位于 return 之后的同级代码均被视为不可达代码。
许多初学者认为Python支持“同时返回多个独立变量”,例如 return x, y, z。事实上,Python在语法层面上只允许返回单个对象。当用逗号分隔多个表达式时,解释器会自动将其隐式封装为一个元组(Tuple):
def get_dimensions():
    width = 1920
    height = 1080
    return width, height  # 等价于 return (width, height)

# 方式一:接收为单个元组对象
dim = get_dimensions()
print("返回对象类型:", type(dim), dim)  # 输出: <class 'tuple'> (1920, 1080)

# 方式二:利用序列解包直接赋予两个变量
w, h = get_dimensions()
print(f"解包赋值: 宽度={w}, 高度={h}")  # 输出: 解包赋值: 宽度=1920, 高度=1080
2. 变量作用域与 LEGB 寻址法则
在函数内创建的变量均为局部变量(Local Variable),仅在函数执行期间的栈帧中存活,外部无法直接访问。当在函数内部引用一个变量名时,Python解释器严格遵循 LEGB 寻址链条 自内向外检索:
- L (Local) 局部作用域:当前函数体内定义的形参及内部赋值变量。
- E (Enclosing) 嵌套闭包作用域:若当前函数是内嵌函数,则检索外层包裹函数的局部变量。
- G (Global) 全局模块作用域:当前
.py脚本模块的最外层顶格定义的全局变量。 - B (Built-in) 内置作用域:Python运行时预先加载的内置函数和异常名(如
len,range,print,ValueError)。
在默认情况下,函数体只能只读访问外层作用域变量。如果试图在函数内部直接通过
var = value 对外层全局变量重新赋值,Python会默认将该变量判定为当前函数的“新局部变量”。如果在该赋值语句之前就尝试读取该同名变量,会导致典型的 UnboundLocalError: local variable referenced before assignment。若确实需要在函数内修改全局或外层变量,必须显式声明 global var_name 或 nonlocal var_name。
五、常见语法错误排查与最佳实践全景总结
在编写自定义函数的工程实践中,以下四类典型错误发生频率最高,开发者可根据其报错特征进行针对性排查:
- IndentationError(缩进异常):函数体代码未能统一保持4个空格缩进,或在团队协作中混合了Tab制表符与空格。
- SyntaxError: non-default argument follows default argument(形参定义次序颠倒):错误地将带有默认值的参数放置在必须位置参数之前。
- TypeError: function() missing required positional argument(实参缺失或超量):调用方传入的位置参数个数未能覆盖函数声明的必选形参要求。
- UnboundLocalError(变量未绑定先引用):在函数体内对一个与外部同名的变量进行了赋值操作,但在赋值语句之前执行了读取操作。
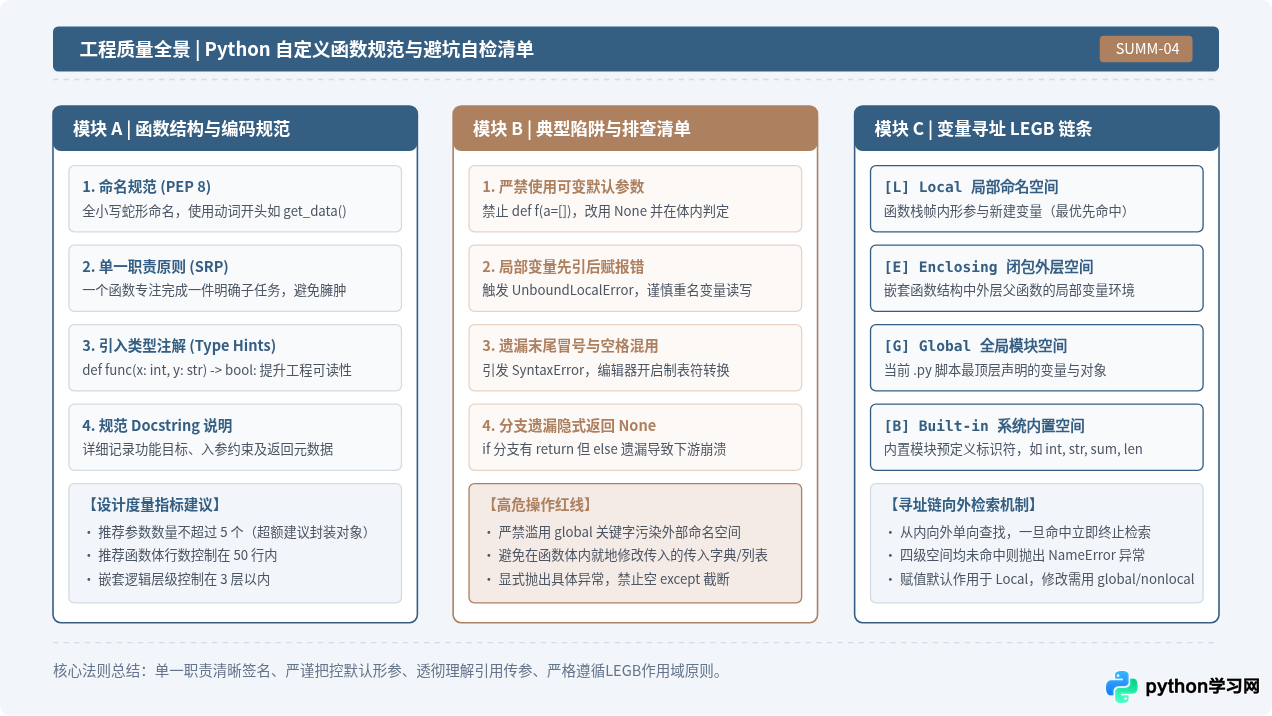
掌握自定义函数的基本语法结构,是掌握Python工程化开发的分水岭。在日常编码中,严格遵循 def 声明格式、正确处理参数传递顺序、规避可变默认参数陷阱,并利用 return 明确输出接口,将使代码具备高度的健壮性与可复用性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









