

怎么解决Python定时任务重复执行或不执行的竞态条件
针对Python定时任务在多实例与长耗时场景下出现的重复执行与漏执行竞态问题,从触发根源、单机调度配置、Redis原子分布式锁、看门狗自动续期及业务幂等控制提供完整落地的解决方案与实战代码。
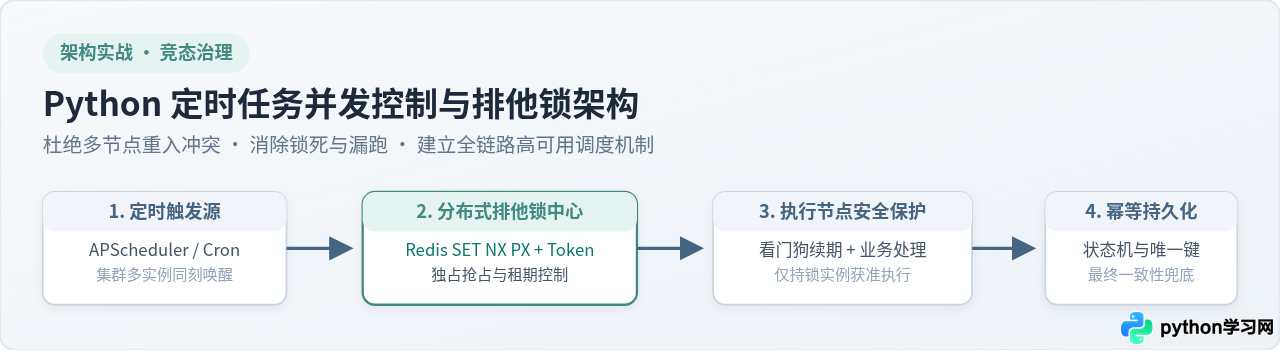
max_instances=1 与 coalesce=True);多节点集群利用具备原子租期控制的分布式排他锁(如 Redis 的 SET NX PX 配合 Lua 释放与看门狗自动续期);业务末端辅以防重流水号和状态机幂等设计。本文将从具体故障表现展开,逐项讲解成因排查与工程落地方法。
一、竞态条件的双重极端表现与诱因剖析
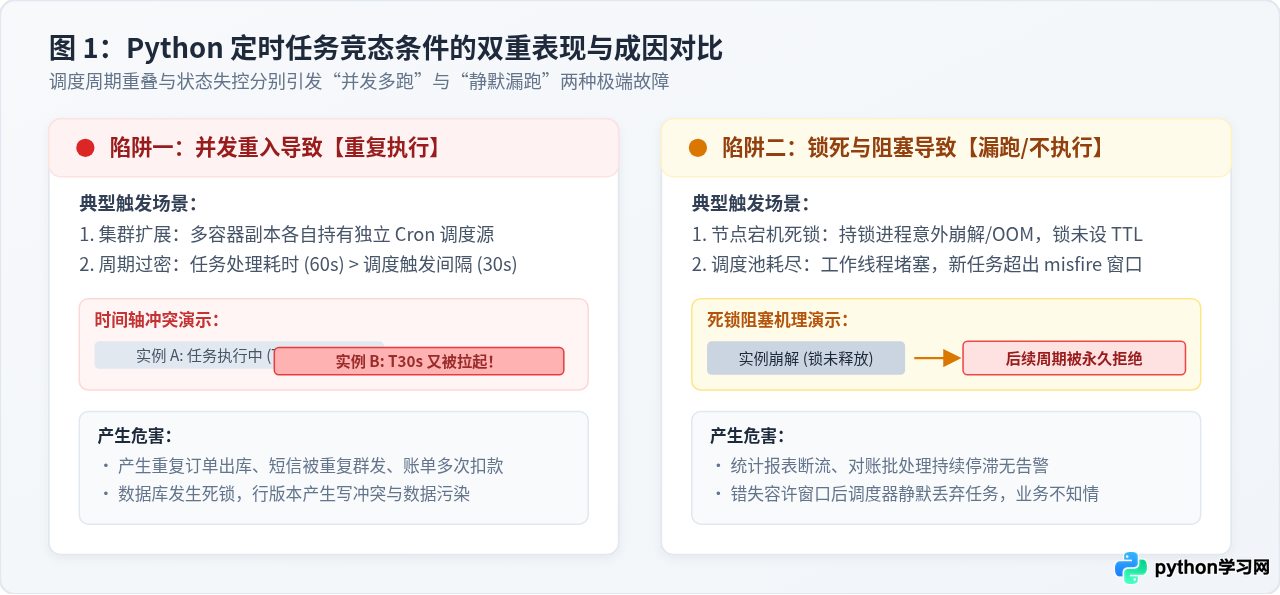
在很多开发团队的生产环境中,定时任务往往从单机单进程的脚本起步。随着业务吞吐量增加和系统架构容器化,原本看似稳定的任务会突发两类极端故障:一是数据被重复生成(如重复发送结算通知、重复扣款出库),二是任务静默停止(如每日财务对账表没有生成,系统却没有任何崩溃报警)。这两种现象均属于竞态条件(Race Condition)的不同侧面。
1. 重复执行的根源:并发重入与多源触发
“重复执行”通常发生于以下两种典型场景:
- 微服务/多副本水平扩展:当项目采用 Kubernetes 或多台云主机部署时,每个容器副本内部都独立运行了一套定时任务(如 APScheduler 或本地 Crontab)。每到整点,所有副本在同一毫秒感知到触发时间,彼此之间毫无察觉地同时开始拉取并处理相同批次的未处理数据。
- 任务执行耗时超越调度间隔:系统设定每 30 秒执行一次同步批处理,但当遇到大促或第三方 API 网络波动时,某次任务执行耗费了 70 秒。若调度引擎默认允许多实例并行,第 30 秒和第 60 秒触发的新任务线程会同时注入运行,与尚未结束的旧任务争抢同一张数据库表,产生并发写冲突。
2. 不执行或漏执行的根源:锁死与超时丢弃
“不执行或漏跑”往往是对并发防御不当带来的副作用:
- 互斥锁产生死锁:为了防止重复执行,开发者为任务增加了简单的锁标志(例如在数据库建一个
is_running状态或执行简单的 RedisSETNX)。若某个持有锁的进程在执行期间发生 OOM(内存溢出)被系统强杀,或者抛出未捕获的异常提前退出,该锁没有设置自动过期时间(TTL),导致后续每一个周期的任务检查时均判定“已有任务正在运行”,从而永久跳过。 - 调度器工作池耗尽与错失时间窗口:在 APScheduler 这类框架中,调度工作线程池(ThreadPoolExecutor)容量是有限的(默认仅为 10)。当多个耗时任务占满工作线程后,按时到来的新定时事件会进入排队等待。框架内置了
misfire_grace_time(错失容许窗口,默认往往仅几秒)。若队列排队时间超过该阈值,调度器会认定该任务“已严重迟到”,直接将其从执行队列中抹去,造成任务静默漏执行。
二、单机环境下的调度配置治理
如果你的服务仅部署在单台服务器或单个容器内,且调度器运行在单一进程中,解决竞态问题不需要过早引入复杂的外部中间件,优先调优调度器本身的线程模型和并发策略是成本最低且最轻量的方案。
1. APScheduler 核心参数的防御性配置
使用 APScheduler 时,必须显式约束以下三个核心调度参数,以杜绝同名任务重叠和错失漏跑:
max_instances=1:强制该任务在当前进程内任何时刻至多只能有 1 个实例处于运行状态。若前一轮未完成,新一轮触发会被拦截。coalesce=True:当进程发生短暂卡顿、GC 或由于max_instances限制导致连续错过了数次执行时,将多次错过的运行合并为一次执行,避免一旦排队恢复后产生短时间内井喷式重跑。misfire_grace_time=300:根据业务容忍度将错过执行的宽限期显式放宽(例如放宽到 300 秒),防止线程池短暂繁忙时调度器直接丢弃任务。
# 运行环境:Python 3.8+ / apscheduler 3.10+
from apscheduler.schedulers.background import BackgroundScheduler
from apscheduler.executors.pool import ThreadPoolExecutor
import time
import logging

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")
logger = logging.getLogger("task_runner")

def heavy_sync_task():
    logger.info("【任务开始】正在处理数据...")
    time.sleep(12)  # 模拟偶发耗时超过调度间隔(例如耗时 12 秒,而触发周期为 5 秒)
    logger.info("【任务结束】数据处理完毕")

if __name__ == "__main__":
    # 独立工作线程池配置
    executors = {
        "default": ThreadPoolExecutor(max_workers=5)
    }
    job_defaults = {
        "coalesce": True,               # 错失的任务自动合并
        "max_instances": 1,            # 同一任务严格只允许单一实例运行
        "misfire_grace_time": 60       # 宽限 60 秒,避免线程排队造成丢任务
    }

    scheduler = BackgroundScheduler(executors=executors, job_defaults=job_defaults)
    scheduler.add_job(heavy_sync_task, "interval", seconds=5, id="sync_job")
    scheduler.start()

    try:
        while True:
            time.sleep(1)
    except KeyboardInterrupt:
        scheduler.shutdown()
2. 单机多进程/Gunicorn 场景:系统文件排他锁
当 Web 服务以 Gunicorn 或 uWSGI 多进程模式启动时,每个 Worker 进程都会实例化一份调度器,上述代码的 max_instances=1 仅在各自进程内生效。在 Linux/macOS 环境下,可使用操作系统内核级别的 fcntl.flock 文件排他锁,其最大优势在于:哪怕某个 Worker 进程由于段错误或 OOM 突然崩溃,操作系统会自动关闭文件描述符并强制释放文件锁,天生具备防死锁特性。
import fcntl
import os

def execute_with_file_lock():
    lock_file_path = "/tmp/py_cron_sync.lock"
    lock_file = open(lock_file_path, "w")
    try:
        # LOCK_EX: 排他锁; LOCK_NB: 非阻塞,抢不到立即抛 BlockingIOError
        fcntl.flock(lock_file, fcntl.LOCK_EX | fcntl.LOCK_NB)
    except (BlockingIOError, IOError):
        logger.warning("检测到同机其他 Worker 进程正在运行该任务,本轮跳过")
        lock_file.close()
        return

    try:
        # 执行实际业务代码
        heavy_sync_task()
    finally:
        fcntl.flock(lock_file, fcntl.LOCK_UN)
        lock_file.close()
三、集群环境治理:构建高可靠 Redis 分布式排他锁
在多机器、多 Pod 的生产集群中,文件锁和进程内部锁完全失效。必须引入外部集中式锁服务。构建分布式锁看似简单,但在实现中极易踩入两大隐蔽陷阱:
- 死锁陷阱:获取锁后未设置过期时间,或者在设置过期时间前服务挂死,导致该键永久滞留 Redis,任务从此漏跑。
- 误删他人锁陷阱:任务 A 耗时超过了锁的 TTL 自动过期,此时任务 B 顺理成章抢到了新锁并开始执行;紧接着任务 A 执行完毕,调用
redis.delete(lock_key),直接把任务 B 正在持有的锁给抹除了,紧接着任务 C 又被拉起,导致并发彻底失控。
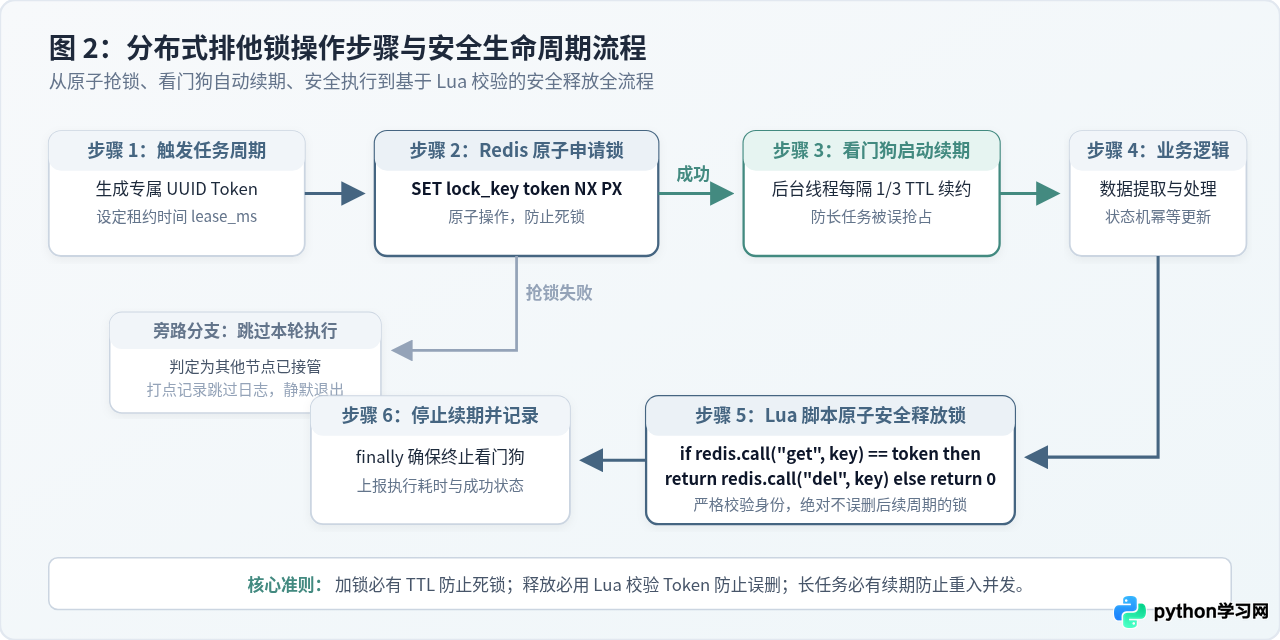
解决这两个陷阱的法定标准是:原子性申请带 TTL 租约的锁 + 携带唯一身份凭据(UUID Token) + 基于 Lua 脚本原子核验并释放。
1. 安全分布式锁的 Python 实现代码
下面是一个完整的、基于上下文管理器的 Redis 分布式排他锁工具类。它不仅封装了原子获取与 Lua 安全释放,还通过上下文管理器保证在任何未捕获异常抛出时依然执行释放逻辑。
# 依赖库:pip install redis
import uuid
import time
import redis
import logging

logger = logging.getLogger("redis_lock")

class DistributedCronLock:
    # Lua 脚本保证:仅当 Redis 中记录的 token 与当前客户端持有时才执行 del
    RELEASE_LUA_SCRIPT = """
    if redis.call("get", KEYS[1]) == ARGV[1] then
        return redis.call("del", KEYS[1])
    else
        return 0
    end
    """

    def __init__(self, redis_client: redis.Redis, lock_key: str, lease_ms: int = 30000):
        self.redis = redis_client
        self.key = lock_key
        self.lease_ms = lease_ms
        self.token = str(uuid.uuid4())
        self._lua_release = self.redis.register_script(self.RELEASE_LUA_SCRIPT)
        self.acquired = False

    def __enter__(self):
        # SET key token NX PX lease_ms 为单命令原子操作
        result = self.redis.set(self.key, self.token, nx=True, px=self.lease_ms)
        if result:
            self.acquired = True
            logger.info(f"成功抢占锁 [{self.key}], 令牌: {self.token}")
            return True
        else:
            self.acquired = False
            logger.info(f"抢占锁 [{self.key}] 失败,其他实例正在执行中,优雅跳过本轮")
            return False

    def __exit__(self, exc_type, exc_val, exc_tb):
        if self.acquired:
            try:
                res = self._lua_release(keys=[self.key], args=[self.token])
                if res == 1:
                    logger.info(f"安全释放锁 [{self.key}]")
                else:
                    logger.warning(f"锁 [{self.key}] 释放失败:租约已过期或已被他人持有")
            except Exception as e:
                logger.error(f"释放锁异常: {e}")
2. 定时任务接入范例
在实际定时任务函数中使用该分布式锁,代码结构清晰,如果获取锁失败直接安全退出,杜绝重复运算:
r_client = redis.Redis(host="127.0.0.1", port=6379, db=0, decode_responses=True)

def scheduled_order_settlement():
    lock_key = "lock:cron:order_settlement"
    # 租约时间 30 秒,超过该时间锁自动失效防死锁
    with DistributedCronLock(r_client, lock_key, lease_ms=30000) as acquired:
        if not acquired:
            return  # 未抢到锁,直接退出

        # 核心业务逻辑
        logger.info("正在执行全量订单结算...")
        process_orders()
        logger.info("订单结算顺利完成")
四、进阶防护:长耗时任务的看门狗自动续期
固定 TTL(如 30 秒)在处理短平快任务时非常有效,但对于数据量波动较大的批处理任务存在致命短板:如果设定 30 秒,某天数据量大耗时 40 秒,后 10 秒锁被自动释放,第二个实例立刻切入,出现“裂脑并发”;如果为了保险将 TTL 设为 2 小时,一旦容器在第 1 分钟发生断电宕机,整个任务在接下来的 1 小时 59 分钟内都无法被任何副本接管,造成严重漏跑。
工程界通用的解决方案是看门狗(Watchdog)心跳机制:初始锁租约设置一个较小的时间(例如 10 秒),一旦获得锁,启动一个轻量级的后台守护线程,每隔租约的三分之一时间(约 3 秒)向 Redis 发送续期指令;当任务正常完成退出时关闭守护线程,若进程意外暴毙,守护线程同步阵亡,锁将在 10 秒内自动自然消亡,兼顾了杜绝重入与快速自愈。
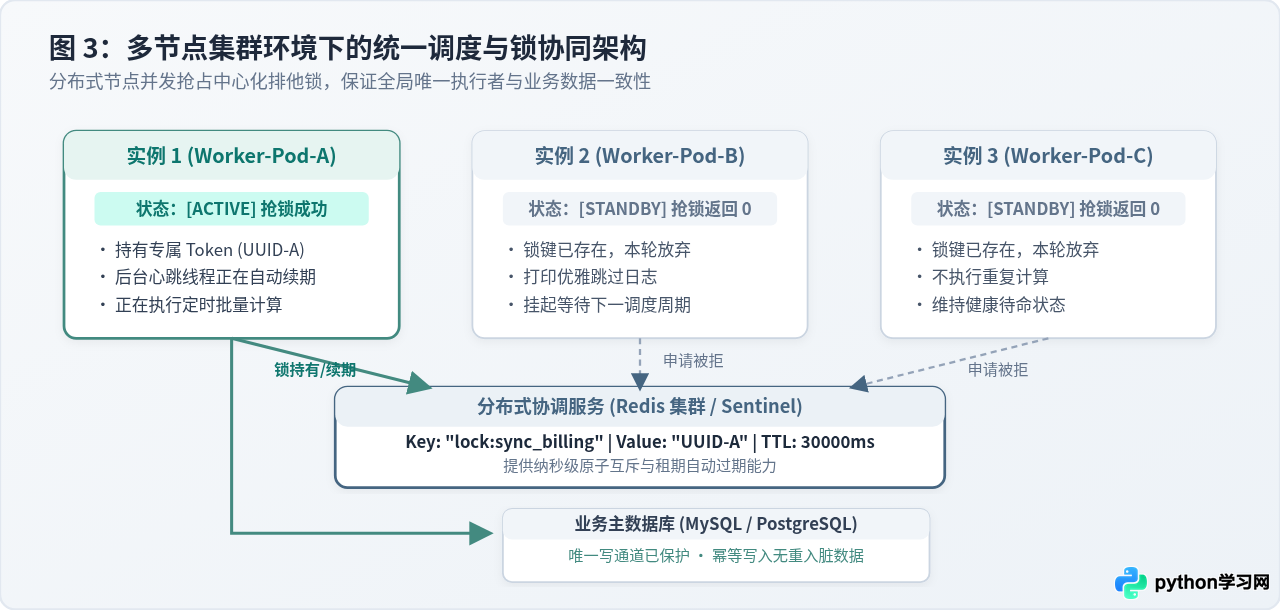
轻量级心跳续期实现
利用 threading 模块,可在上述分布式锁基础上增加心跳续期能力:
import threading

class RenewableDistributedLock(DistributedCronLock):
    RENEW_LUA_SCRIPT = """
    if redis.call("get", KEYS[1]) == ARGV[1] then
        return redis.call("pexpire", KEYS[1], ARGV[2])
    else
        return 0
    end
    """

    def __init__(self, redis_client, lock_key, lease_ms=10000):
        super().__init__(redis_client, lock_key, lease_ms)
        self._lua_renew = self.redis.register_script(self.RENEW_LUA_SCRIPT)
        self._stop_watchdog = threading.Event()
        self._watchdog_thread = None

    def _watchdog_loop(self):
        interval = (self.lease_ms / 1000.0) / 3.0  # 租期的 1/3 时间间隔检查一次
        while not self._stop_watchdog.wait(interval):
            res = self._lua_renew(keys=[self.key], args=[self.token, self.lease_ms])
            if res != 1:
                logger.warning("看门狗续期失败,锁可能已被抢占或连接中断")
                break
            logger.debug("看门狗自动续期成功")

    def __enter__(self):
        acquired = super().__enter__()
        if acquired:
            self._stop_watchdog.clear()
            self._watchdog_thread = threading.Thread(target=self._watchdog_loop, daemon=True)
            self._watchdog_thread.start()
        return acquired

    def __exit__(self, exc_type, exc_val, exc_tb):
        if self.acquired:
            self._stop_watchdog.set()
            if self._watchdog_thread:
                self._watchdog_thread.join(timeout=1.0)
        super().__exit__(exc_type, exc_val, exc_tb)
五、业务层终极兜底:状态机与幂等写入
在分布式系统理论中,没有任何锁是 100% 绝对安全的。长时间的垃圾回收暂停(Stop-The-World)、底层网络物理分区或时钟跳变都可能导致锁短暂漂移。因此,必须将“互斥锁”视为提升效率的第一道防线,而将“业务幂等”作为杜绝破坏的终极防线。
1. 数据库状态机前置校验(CAS 乐观锁)
批处理任务提取待处理数据时,绝不能依赖全表扫描直接写入,而应采用基于行状态的条件更新(Compare-And-Swap):
-- 抢占任务批次:仅当状态为 PENDING 时才能推进到 PROCESSING
UPDATE task_batch_record
SET status = 'PROCESSING', worker_id = 'pod-1', updated_at = NOW()
WHERE id = 1002 AND status = 'PENDING';
若影响行数为 0,说明该批次已在瞬间被其他节点接管,当前执行线程立刻放弃后续操作。
2. 唯一防重流水号约束
对于每日账单、周期报表、资金结算等定时任务,为每次业务生成与时间绑定的全局唯一流水号,并在数据库核心表上建立 UNIQUE KEY 唯一索引。
-- 创建唯一索引保证单周期数据物理唯一
ALTER TABLE financial_daily_report
ADD UNIQUE KEY uk_report_date (report_date, account_id);
当偶发竞态条件绕过了分布式锁时,第二个实例在插入时将直接遭遇唯一键冲突异常(如 IntegrityError),从而保护主数据不受污染。
六、治理总结与选型决策指南
解决 Python 定时任务的竞态条件并非只有一种做法,开发者应当根据当前架构的部署规模、业务重要性与任务周期合理选用方案。
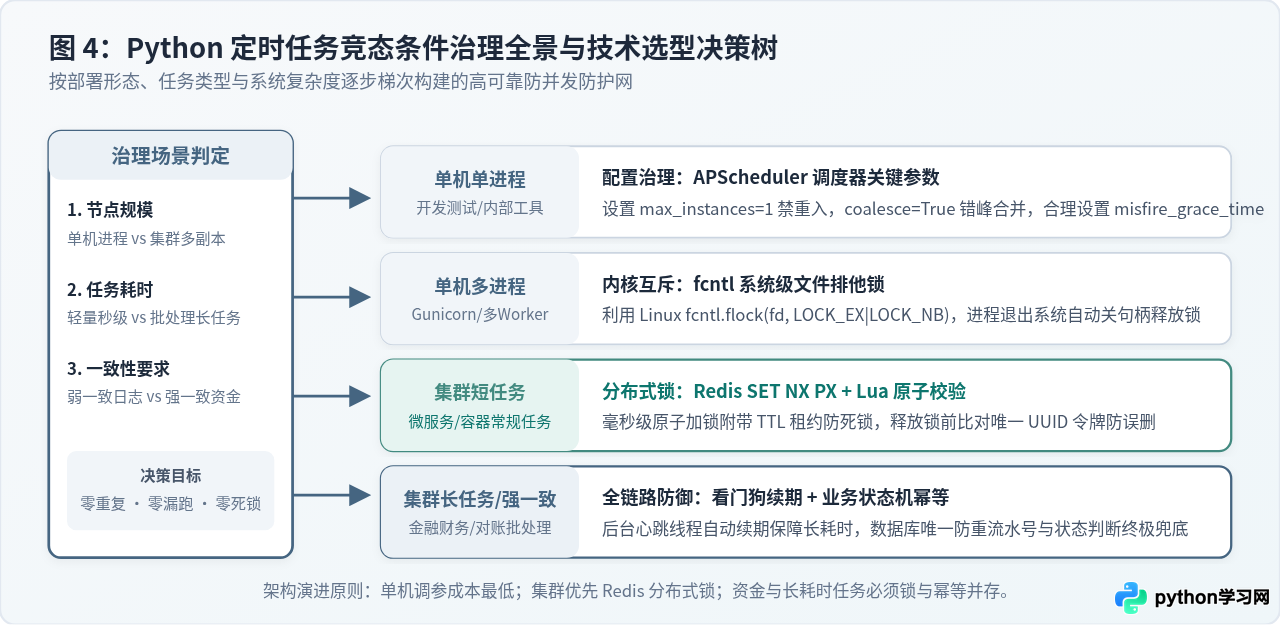
| 架构场景 | 推荐方案 | 关键参数/核心技术 | 优缺点分析 |
|---|---|---|---|
| 单机单进程应用 | 调度器内建并发控制 | max_instances=1coalesce=True |
零外部依赖,极速接入;无法抵御多容器及多实例并发。 |
| 单机多 Worker 部署 | 系统级文件排他锁 | fcntl.flock(LOCK_EX|LOCK_NB) |
内核管理句柄,宕机自动释放防死锁;不支持跨服务器。 |
| 分布式集群(短平快任务) | Redis 原子分布式锁 | SET NX PXLua 安全原子释放 |
纳秒级响应,吞吐量极高;需合理评估 TTL 避免长任务抢占。 |
| 分布式集群(长耗时/强一致) | 看门狗分布式锁 + 数据库幂等 | 心跳续期 + 唯一键约束 状态机 CAS 过滤 |
彻底消除重复执行与漏执行死锁;架构复杂度与开发投入稍高。 |
- 确认调度日志记录:在抢锁失败跳过时务必输出
DEBUG或INFO日志,注明锁名称与持有者,避免因无日志误判为“任务未配置”。 - 防范时钟漂移:多台服务器主机必须配置并开启 NTP 时间同步(如 chrony),防止由于系统时间偏差造成调度提前或延迟。
- 建立死信告警机制:为调度器注册事件监听器(如 APScheduler 的
EVENT_JOB_MISSED和EVENT_JOB_ERROR),一旦发生任务被丢弃或抛出异常立即触发告警。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









