

Python怎么用split和partition按分隔符截取字符串

在 Python 日常开发中,按照指定字符截取或切分字符串是最基础且高频的操作。Python 原生提供了两个核心内置方法:str.split() 和 str.partition()。很多初学者容易将它们混为一谈,或者在所有场景下一律使用 split()。事实上,两者在返回结构、切分机制、分隔符保留方式以及未找到匹配项时的边界表现上存在明显区别:split() 将字符串拆解为可变长度的列表,适合全局切分或按指定次数剥离;而 partition() 始终返回包含“前部、分隔符自身、后部”的固定三元组,非常适合键值对提取、文件名解析等需要二分截取的场景。
一、使用 split() 与 rsplit() 进行灵活切分
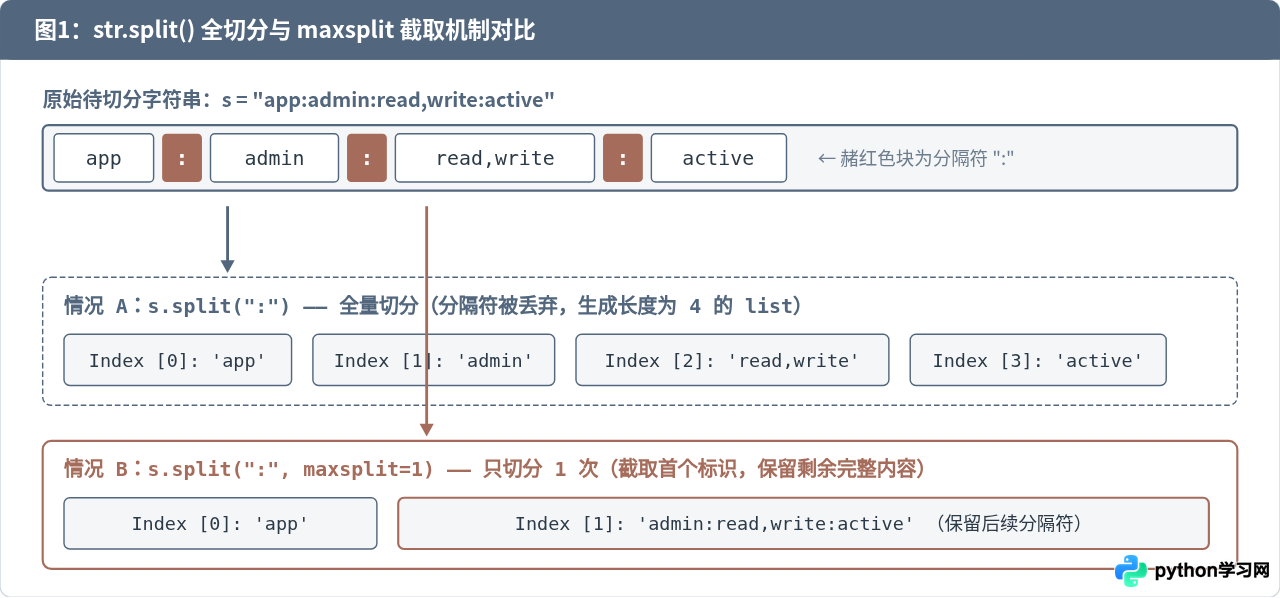
str.split(sep=None, maxsplit=-1) 是 Python 最常用的字符串拆分方法。该方法会根据指定的分隔符 sep,从左往右扫描字符串,将所有切分出来的片段存入一个列表(list)中并返回。分隔符本身不会出现在返回的列表中。
1. 基础切分与默认空白处理
当不传递任何参数(即 sep=None)时,split() 会采用特殊的空白符匹配算法:它会将连续的任意空白字符(包括空格、制表符 \t、换行符 \n)统一视为一个分隔符,并自动过滤掉首尾的空白。
# 示例代码:默认空白切分 vs 指定分隔符切分
text = "  python   split   partition \n demo  "
print(text.split())
# 示例输出: ['python', 'split', 'partition', 'demo']

csv_line = "apple,banana,orange,grape"
print(csv_line.split(","))
# 示例输出: ['apple', 'banana', 'orange', 'grape']
需要特别注意,一旦显式传入 sep=" "(单空格),其切分逻辑就会严格匹配单个空格,连续空格之间会切出空字符串 "",这与 sep=None 的折叠行为完全不同。
2. 控制截取次数:maxsplit 参数
如果只需要截取前几个字段,或者只想将字符串切开一次,可以通过 maxsplit 参数控制最大切分次数。剩余未切分的部分会作为一个完整元素保留在列表末尾。
# 示例代码:使用 maxsplit 控制截取片段
log_entry = "2026-10-20:INFO:disk_usage_high:path=/dev/sda1:usage=92%"

# 只切分前两次,获取日期和日志级别,其余部分保留完整
parts = log_entry.split(":", maxsplit=2)
print(parts)
# 示例输出: ['2026-10-20', 'INFO', 'disk_usage_high:path=/dev/sda1:usage=92%']
3. 从右向左截取:rsplit()
当目标字符串由右向左切分更为自然时(例如从完整文件路径或反向定界中剥离最后几项),应使用 str.rsplit(sep=None, maxsplit=-1)。在未指定 maxsplit 时,rsplit() 与 split() 结果完全一致;但当指定 maxsplit 时,它会从右侧开始消耗切分次数。
# 示例代码:rsplit 从右侧切分
config = "db.cluster.node1.ip"
print(config.rsplit(".", maxsplit=1))
# 示例输出: ['db.cluster.node1', 'ip']
二、使用 partition() 与 rpartition() 进行三元组拆解
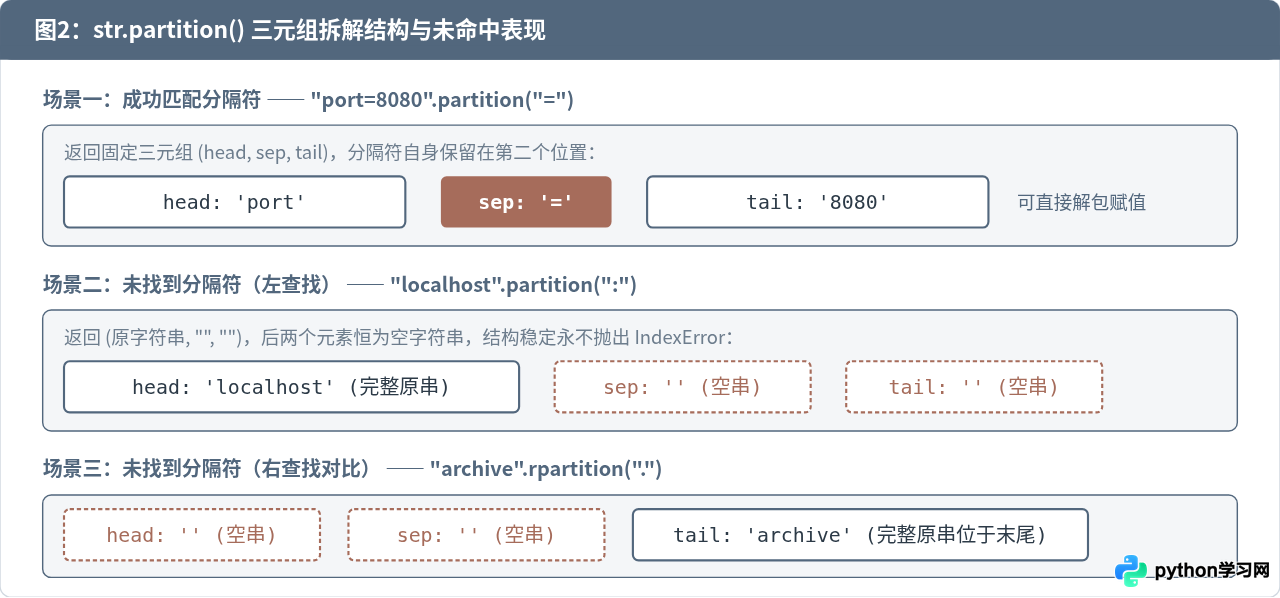
str.partition(sep) 是专门为“二分截取”设计的内置方法。它接受一个必须明确指定的非空分隔符 sep,从左侧开始查找该分隔符第一次出现的位置,并将原字符串切分为严格包含三个元素的元组(tuple):(head, sep, tail)。
1. 结构化解包与分隔符保留
与 split() 会丢弃分隔符不同,partition() 始终将分隔符本身作为元组的第二个元素保留。这一特性在需要判断原字符串是否包含定界符、或者需要原样重新拼接时极为便利。
# 示例代码:优雅的三元组解包
connection_str = "db_host=192.168.1.100"
key, sep, val = connection_str.partition("=")

print(f"键: {key}")
print(f"分隔符: {sep}")
print(f"值: {val}")
# 示例输出:
# 键: db_host
# 分隔符: =
# 值: 192.168.1.100
如果不需要使用中间的分隔符,按照 Python 惯用法可以直接使用下划线 _ 接收:key, _, val = connection_str.partition("="),语义清晰且表达极其紧凑。
2. 从末尾向前二分:rpartition()
同理,str.rpartition(sep) 从右向左寻找最后一次出现的分隔符,返回的同样是 (head, sep, tail)。这在提取文件扩展名、网络域名末级标识或复合键值末尾片段时非常实用。
# 示例代码:提取文件名与后缀名
filename = "backup.2026.tar.gz"
base_name, dot, ext = filename.rpartition(".")

print("文件名主体:", base_name)
print("扩展名:", ext)
# 示例输出:
# 文件名主体: backup.2026.tar
# 扩展名: gz
三、未找到分隔符时的边界行为对比
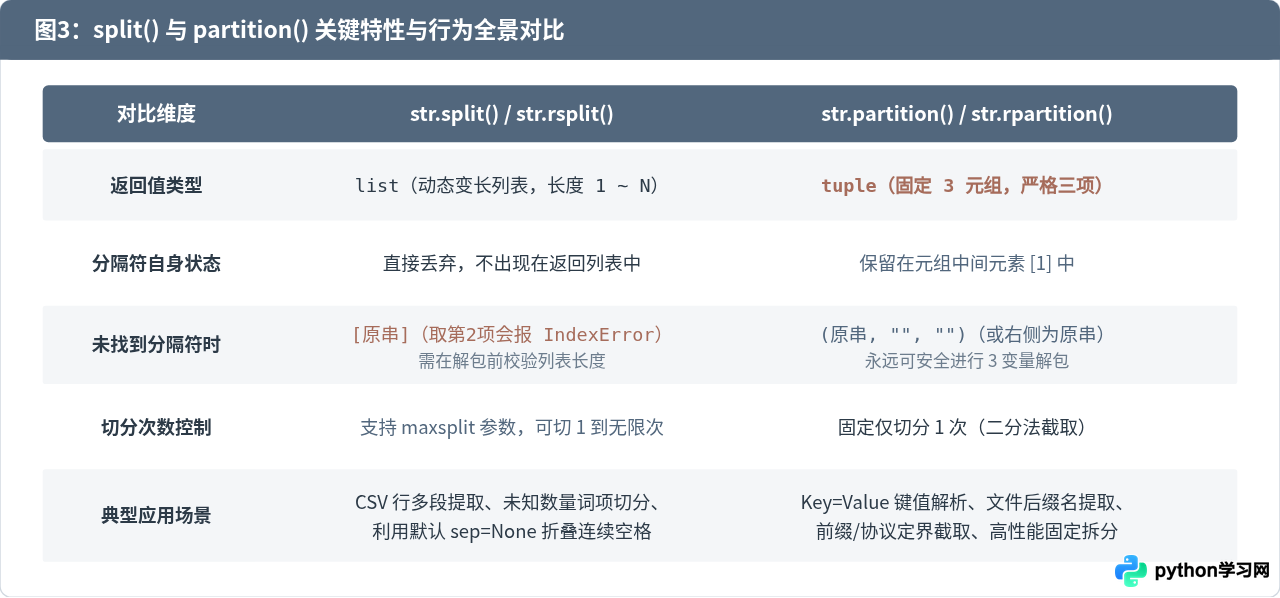
在编写健壮的生产代码时,最容易引发异常的往往是“分隔符不存在”的边界输入。理解两种方法在未命中时的表现差异至关重要。
1. split() 未命中时的隐患
当目标字符串中不存在指定的 sep 时,str.split(sep) 会将整个原字符串作为唯一的元素放入列表,返回单元素列表 [original_str]。
# 常见隐患:直接解包或按索引取值
raw_input = "standalone_token"
parts = raw_input.split("=")

# 如果习惯性解包:k, v = raw_input.split("=") -> 抛出 ValueError: not enough values to unpack
# 如果习惯性取第二项:
try:
    value = parts[1]
except IndexError as e:
    print("捕获错误:", e)
    # 示例输出: 捕获错误: list index out of range
因此,使用 split() 提取指定片段时,必须额外编写代码检查 len(parts) >= 2,否则系统极易遭遇 IndexError 崩溃。
2. partition() 的天然安全性
相比之下,partition() 无论是否找到分隔符,都保证返回长度恒为 3 的元组:
- 若未找到分隔符,
partition(sep)返回(原字符串, "", "")。 - 若未找到分隔符,
rpartition(sep)返回("", "", 原字符串)。
这意味着你永远可以直接进行三变量解包,绝不会抛出 ValueError 或 IndexError。判断是否成功找到分隔符只需检查第二个元素是否非空:
# 示例代码:partition 的安全解包与条件判断
raw_input = "standalone_token"
key, sep, val = raw_input.partition("=")

if sep:
    print(f"成功解析键值对: {key} -> {val}")
else:
    print(f"未包含等号,作为单值处理: {key}")
# 示例输出: 未包含等号,作为单值处理: standalone_token
四、工程实战中的方法选型与最佳实践
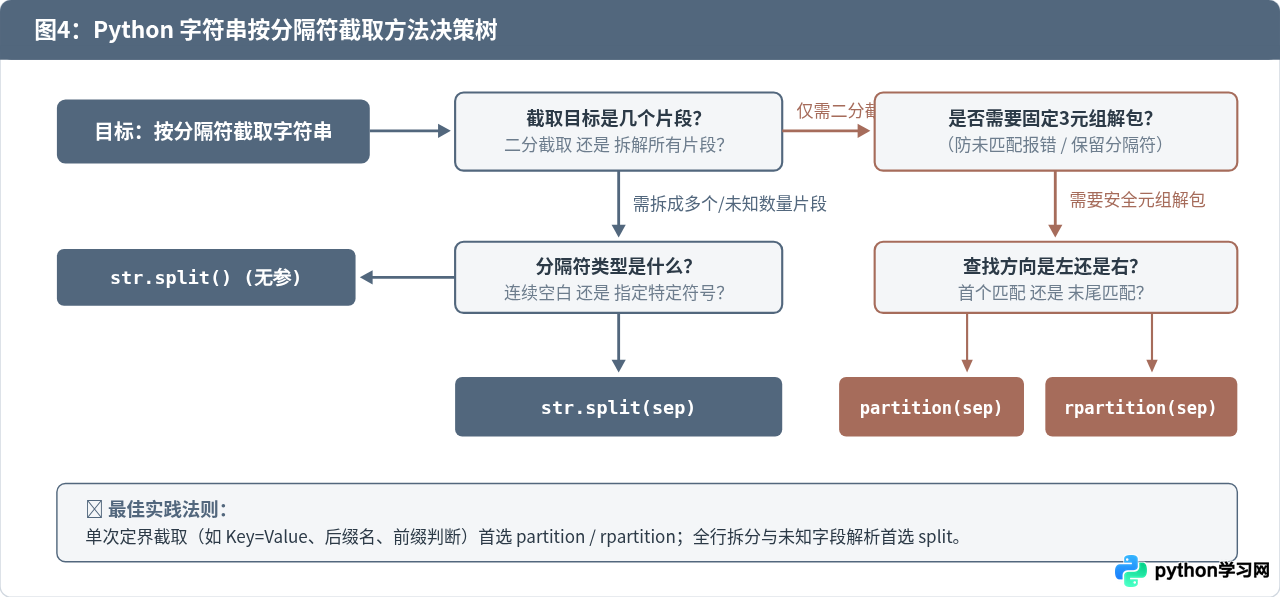
在了解了两者的基本原理后,如何根据具体工程场景选择最恰当的方法?以下总结四种典型场景的实现建议:
场景 1:环境变量或 INI 配置文件中的 key=value 解析
配置项中的值往往也可能包含等号(例如 url=https://api.domain.com?auth=true)。如果单纯用 split("=") 会将查询参数也割裂。虽然可以用 split("=", 1),但一旦某行格式异常缺少等号,就会导致解包抛出异常。此时 partition("=") 是最佳选择:
# 最佳实践:配置解析
line = "url=https://example.com/query?id=123"
key, has_eq, val = line.partition("=")
if has_eq:
    print(f"配置键: {key.strip()}, 配置值: {val.strip()}")
场景 2:URL 协议头或主机端口截取
提取网络地址的前缀或端口时,partition 和 rpartition 能够避免脆弱的索引切片:
# 提取网络协议与主机
address = "https://internal.service.local:9000"
scheme, sep, rest = address.partition("://")
host, colon, port = rest.rpartition(":")

print(f"协议: {scheme}, 主机: {host}, 端口: {port if colon else '80'}")
# 示例输出: 协议: https, 主机: internal.service.local, 端口: 9000
场景 3:日志文件按列切分与未知片段处理
当一行文本由制表符或逗号分隔,且每一列都需要提取并遍历处理时,应当坚决使用 split():
# 最佳实践:表格或日志解析
log_row = "2026-10-20 12:00:00\t10.0.0.1\tGET\t/index.html\t200"
fields = log_row.split("\t")
print(f"共提取到 {len(fields)} 个字段,访问路径为: {fields[3]}")
str.partition() 通常比 str.split(sep, 1) 性能更好。因为 partition() 在 CPython 底层直接分配定长元组并立即返回,省去了动态列表内存分配与额外切分计数器的开销。
五、总结
掌握 split() 与 partition() 的差异是编写简洁、高效且健壮的 Python 代码的基本功:
- 想要将整行字符串按分隔符完全打散、提取多个片段时,使用
str.split()。 - 想要从右向左拆除末尾固定个数的字段时,配合
maxsplit使用str.rsplit()。 - 想要把字符串从首个或末个分隔符处一分为二(如键值对、扩展名提取),且希望获得稳固的三元组解包体验时,优先使用
str.partition()或str.rpartition()。
根据实际需求选择恰当的工具,不仅能使代码意图更加直观,更能从根源上杜绝潜在的越界与解包异常。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









