

怎么给运行的Python脚本传递命令行参数

发布时间:2026-10-22| 4人浏览过
给运行中的 Python 脚本传递命令行参数,核心是在终端启动执行命令时,紧跟在脚本文件名后输入所需的数据或选项,并在脚本内部通过标准接口读取这些内容。Python 提供了两套最核心的标准处理方案:极简场景使用内置模块 sys 的参数列表 sys.argv;生产级任务或多参数场景使用标准库 argparse 模块进行规范解析。
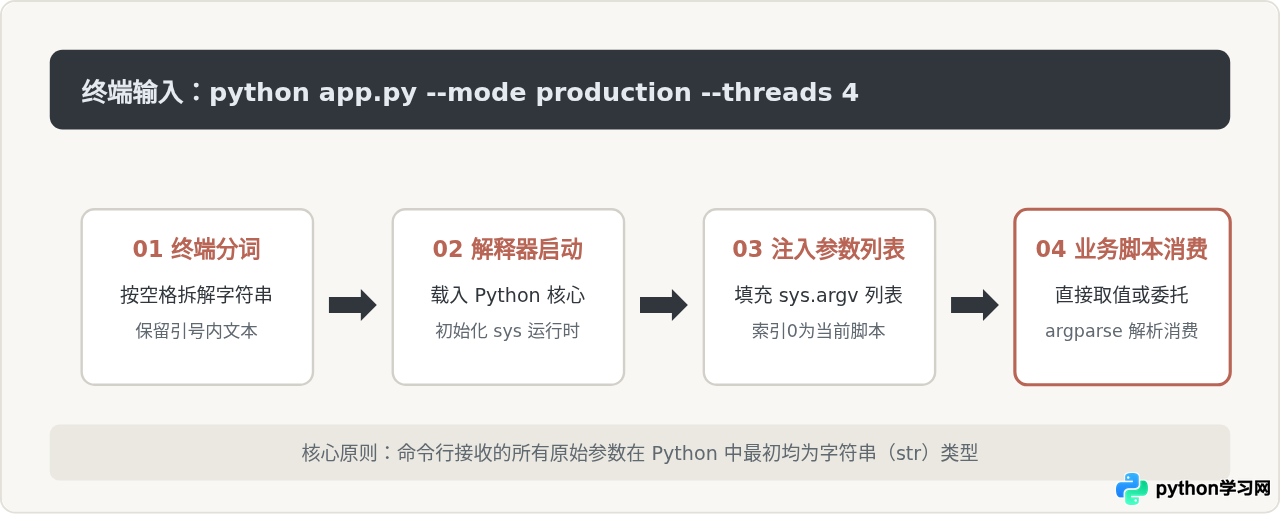
一、命令行传参的基本原理与执行流向
当我们在终端或命令提示符中执行 python main.py arg1 arg2 时,操作系统终端(如 Bash、Zsh 或 PowerShell)会首先依据空格将整条命令切分成独立的字符串数组,然后由 Python 解释器启动并将脚本名及其后续输入作为初始环境变量注入运行上下文。
二、快速上手:使用 sys.argv 接收位置参数
sys.argv 是 Python 最原始也是最轻量的参数获取途径,它本质上是一个普通的 Python 字符串列表(list)。只要导入标准库 sys 即可直接读取。
需要牢记:sys.argv[0] 永远表示被调用的脚本名称或执行路径,而用户从终端键入的第一个业务参数位于 sys.argv[1],第二个参数位于 sys.argv[2],依此类推。
1. 代码实现与执行示例
# demo_sys.py
import sys

def main():
    # 检查传参数量,确保至少传入了1个业务参数
    if len(sys.argv) < 2:
        print("错误:未提供必要的用户名称。")
        print(f"用法:python {sys.argv[0]} <用户名> [重试次数]")
        sys.exit(1)

    username = sys.argv[1]
    # sys.argv 内部所有元素都是字符串,数值需要显式强转
    retry_count = int(sys.argv[2]) if len(sys.argv) > 2 else 3

    print(f"开始处理任务:用户={username},重试上限={retry_count}次")

if __name__ == "__main__":
    main()
在终端中执行并查看输出效果:
# 示例 1:传入用户名和数值参数
$ python demo_sys.py Alice 5
开始处理任务:用户=Alice,重试上限=5次

# 示例 2:未传递任何参数时的保护提示
$ python demo_sys.py
错误:未提供必要的用户名称。
用法:python demo_sys.py <用户名> [重试次数]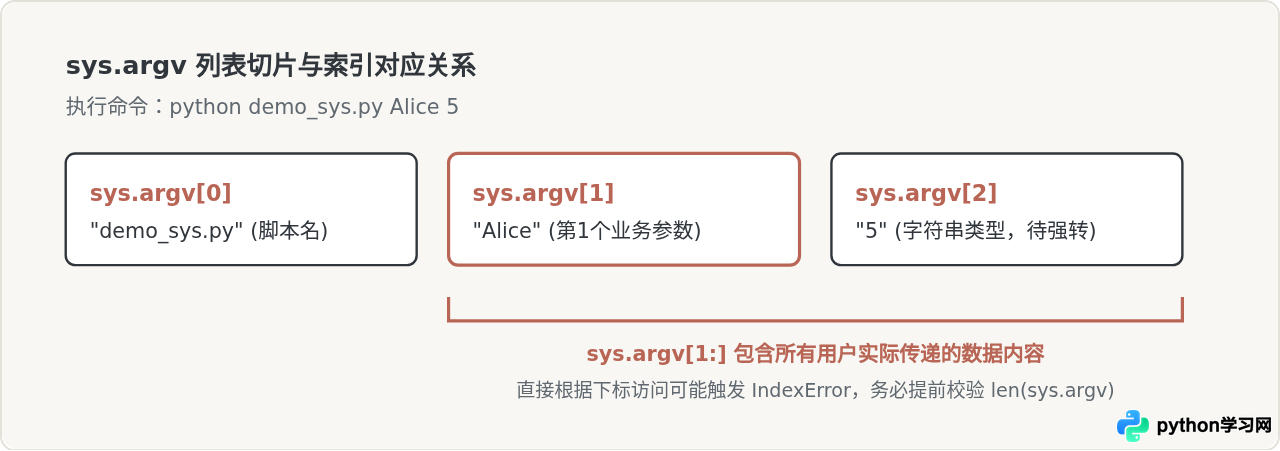
注意:直接通过
sys.argv[i] 获取参数极易因终端漏传导致抛出 IndexError: list index out of range。此外,当参数带有 --output=file.txt 这种键值结构或需要可选开关(flag)时,手工切片和解析会变得繁琐易错。三、规范进阶:使用标准库 argparse
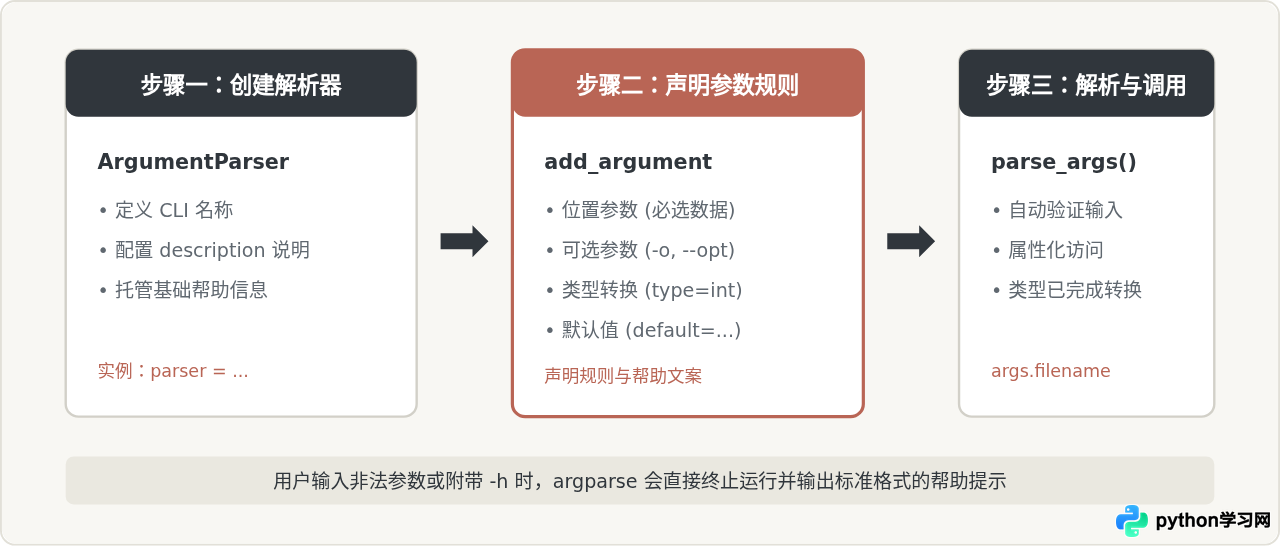
对于大部分正式编写的脚本,推荐使用 Python 官方内置的 argparse 模块。它具备完整的参数类型自动转换、默认值缺省设定、必选与可选分支管理,并且能自动生成标准的 -h/--help 帮助页面。
使用 argparse 遵循清晰的三步流程:
- 创建解析器:实例化
argparse.ArgumentParser对象,配置命令描述。 - 声明参数规范:调用
add_argument()添加位置参数或以-/--开头的可选参数。 - 解析参数:执行
parser.parse_args()获得解析后的命名空间对象。
2. 规范脚本代码示例
# process_data.py
import argparse

def parse_arguments():
    # 1. 实例化解析器
    parser = argparse.ArgumentParser(
        description="数据批处理工具:从输入文件读取数据并导出处理结果。"
    )

    # 2. 添加位置参数(必填项,不带前缀破折号)
    parser.add_argument(
        "input_file",
        type=str,
        help="待处理的输入文件路径"
    )

    # 3. 添加带默认值的可选参数
    parser.add_argument(
        "-o", "--output",
        dest="output_file",
        type=str,
        default="result.csv",
        help="导出文件路径(默认:result.csv)"
    )

    # 4. 添加强制整型的可选参数
    parser.add_argument(
        "-b", "--batch-size",
        type=int,
        default=64,
        help="每次处理的批次大小(默认:64)"
    )

    # 5. 添加布尔开关参数(存在即为 True,不需要跟具体数值)
    parser.add_argument(
        "--verbose",
        action="store_true",
        help="开启详细日志输出模式"
    )

    # 6. 解析参数
    return parser.parse_args()

def main():
    args = parse_arguments()

    print(f"输入源文件: {args.input_file}")
    print(f"输出目标: {args.output_file}")
    print(f"批次大小: {args.batch_size} (类型: {type(args.batch_size).__name__})")
    print(f"详细日志: {'已启用' if args.verbose else '未启用'}")

if __name__ == "__main__":
    main()
3. 运行与验证
执行该脚本时,可以灵活组合长短参数:
# 查看自动生成的帮助页面
$ python process_data.py --help
usage: process_data.py [-h] [-o OUTPUT_FILE] [-b BATCH_SIZE] [--verbose] input_file

数据批处理工具:从输入文件读取数据并导出处理结果。

positional arguments:
  input_file            待处理的输入文件路径

options:
  -h, --help            show this help message and exit
  -o OUTPUT_FILE, --output OUTPUT_FILE
                        导出文件路径(默认:result.csv)
  -b BATCH_SIZE, --batch-size BATCH_SIZE
                        每次处理的批次大小(默认:64)
  --verbose             开启详细日志输出模式

# 正常调用:传入必选参数和指定选项
$ python process_data.py raw_data.json -b 128 --verbose
输入源文件: raw_data.json
输出目标: result.csv
批次大小: 128 (类型: int)
详细日志: 已启用

# 错误捕获:输入非法数字类型时自动拦截
$ python process_data.py raw_data.json -b not_a_number
usage: process_data.py [-h] [-o OUTPUT_FILE] [-b BATCH_SIZE] [--verbose] input_file
process_data.py: error: argument -b/--batch-size: invalid int value: 'not_a_number'
四、常见问题与注意事项
- 参数中包含空格:在命令行中,若参数值本身包含空格(如文件名
monthly report.csv),必须用双引号包裹(如"monthly report.csv"),否则终端会将其按空格切分为两个独立参数。 - 布尔开关陷阱:不要使用
type=bool来接收开关参数。在 Python 中,非空字符串转布尔值始终为True(即bool("False")的结果仍然是True)。开关参数应使用action="store_true"或action="store_false"。 - 带负号的数值参数:若需要传入负数(如
-5),可能会被误判为未知选项。如果遇到冲突,可以通过python script.py -- --5(使用双连字符阻断选项解析)或在代码中配置prefix_chars。
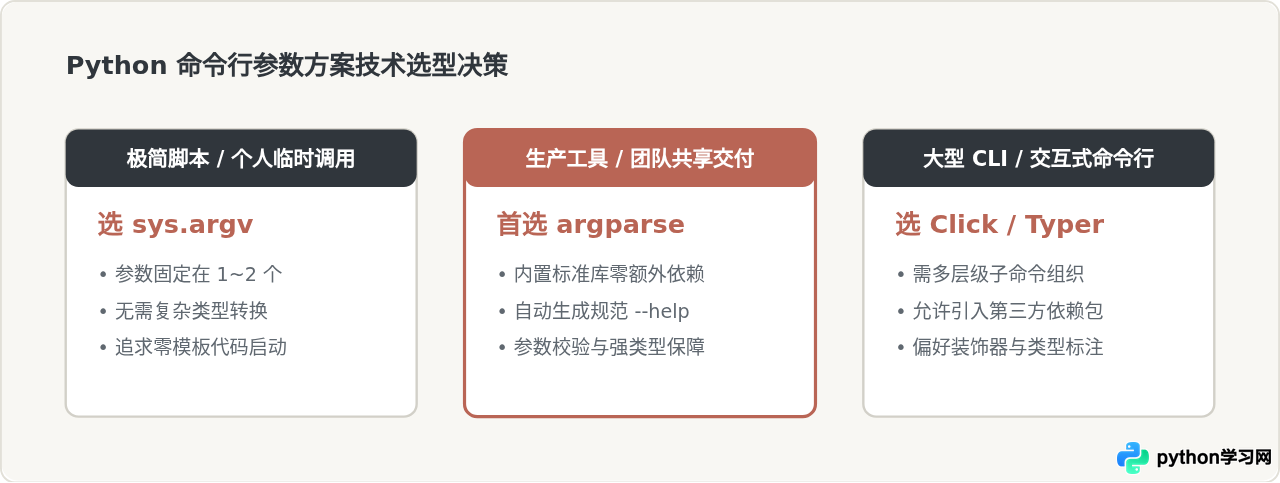
五、参数解析方案对比与技术选型
面对不同的工程要求与复杂度,可以参考以下决策依据选择合适的传参方案:
| 对比维度 | sys.argv | argparse | 第三方库 (Click / Typer) |
|---|---|---|---|
| 依赖情况 | Python 内置模块(无需安装) | Python 内置标准库(无需安装) | 需要外部 pip 安装 |
| 类型支持 | 纯字符串,需自行强转 | 声明式自动类型转换与校验 | 深度集成类型注解与转换 |
| 帮助文档 | 无,需手写打印分支 | 自动生成 -h/--help 格式排版 |
高度美化的自动帮助输出 |
| 最佳适用场景 | 一次性脚本、单入参工具 | 正规生产脚本、多参数运维工具 | 大型 CLI 框架、复杂嵌套子命令应用 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









