

Python定时任务方案对比:time.sleep、APScheduler与Celery选型指南
深入对比Python中time.sleep循环、APScheduler与Celery三种主流定时任务方案的运行机制、代码实现、核心优缺点与工程选型决策路径。
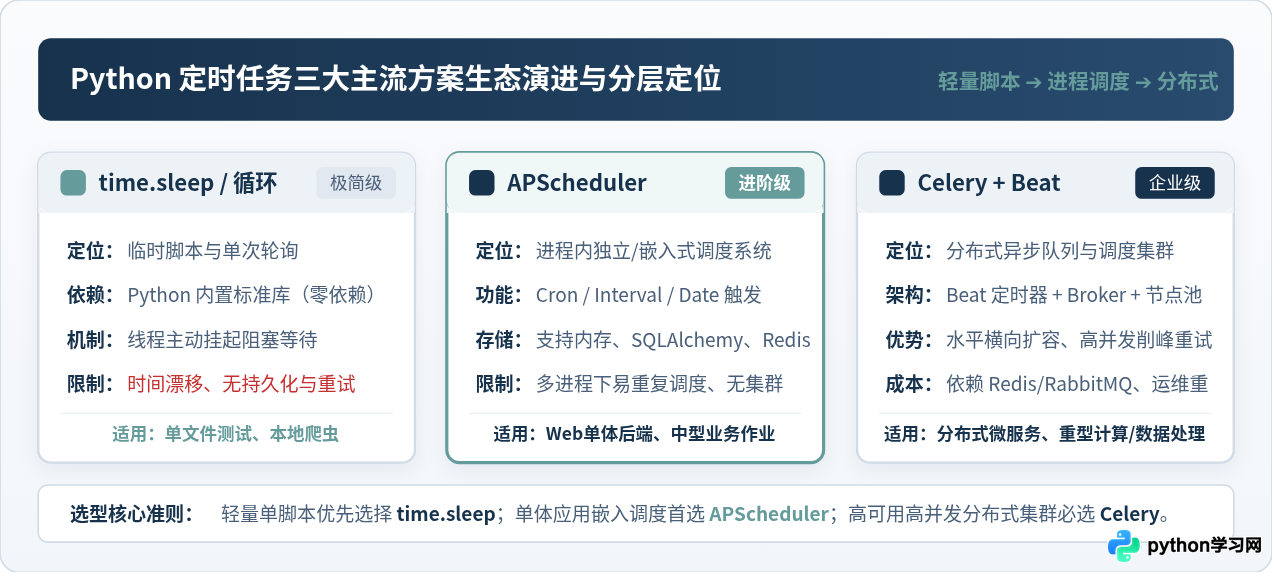
time.sleep 能够做到零依赖开箱即用;如果需要在单体应用内调度具有 Cron 表达式、支持动态管理和多种执行线程的任务,APScheduler 是极其完备的嵌入式调度器;而若面对海量并发计算、需要跨机器节点横向扩容或严格的任务防丢失削峰,则应选用基于消息队列的工业级异步调度方案 Celery。
一、轻量方案:循环与 time.sleep
time.sleep 是初学者和脚本开发者最熟悉的方案。它的本质非常直接:通过调用操作系统的挂起机制,让当前执行线程休眠指定的秒数,在休眠结束后继续执行后续语句。
1. 典型实现与漂移补正
在实际编写轮询脚本时,最基础的写法是直接使用 while True: ... time.sleep(interval)。然而,如果任务函数内部存在网络 I/O 或文件写入,任务本身的耗时会叠加在休眠时间之上,导致任务触发时机产生时间漂移(Cumulative Drift)。为了让间隔尽量准确,应当动态计算实际需要休眠的时间差:
import time
from datetime import datetime

def check_service_status():
    print(f"[{datetime.now().strftime('%Y-%m-%d %H:%M:%S')}] 执行健康检查...")
    # 模拟任务本身执行耗时 0.4 秒
    time.sleep(0.4)

def run_loop_interval(interval_seconds=5):
    next_time = time.time() + interval_seconds
    while True:
        check_service_status()
        sleep_duration = next_time - time.time()
        if sleep_duration > 0:
            time.sleep(sleep_duration)
        next_time += interval_seconds

if __name__ == "__main__":
    # 运行定时间隔循环(示例每 5 秒执行一次)
    try:
        run_loop_interval(5)
    except KeyboardInterrupt:
        print("任务循环已终止")
2. 局限与适用边界
- 阻塞主线程:如果不额外创建独立的子线程(如
threading.Thread),time.sleep会直接冻结整个主线程,导致进程无法同时响应其他请求或信号。 - 无持久化与状态丢失:一旦进程崩溃或服务器重启,休眠计时和调度状态彻底清空,无法记录上一次成功执行的时间戳,也没有失败重试机制。
- 缺乏高阶调度能力:无法原生支持像“每周一早晨 8 点”或“月末最后一天”这样的复杂 Crontab 表达式,强行实现需要手工编写大量日期计算逻辑。
- 适用场景:单文件运维检测脚本、本地爬虫简易定时翻页、测试用例中的简易模拟器。任务数量通常在 3 个以下,且对时间精度及可靠性无严苛要求。
二、进程内全能调度器:APScheduler
APScheduler(Advanced Python Scheduler)是 Python 生态中最成熟的进程内任务调度库。它既可以作为独立守护进程运行,也可以无缝嵌入到 Flask、FastAPI、Django 或 Tornado 等 Web 应用中。
1. 核心四大组件架构
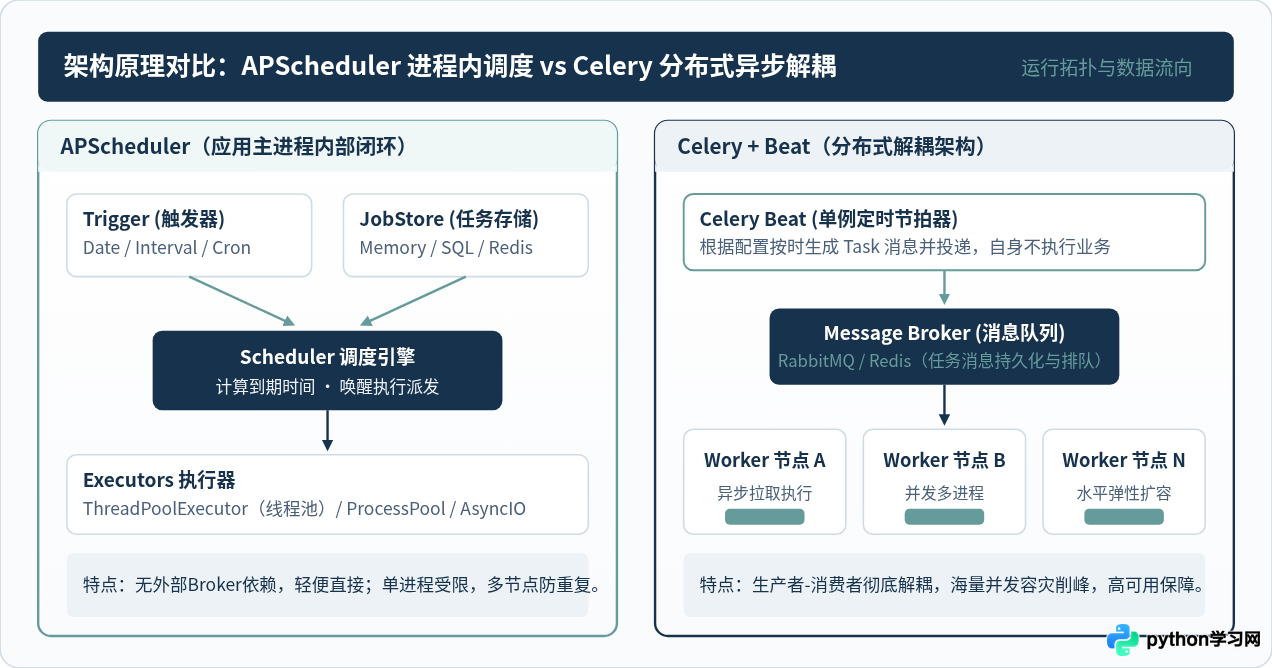
APScheduler 的设计高度模块化,由四个核心部分协同工作:
- Triggers(触发器):负责计算任务下一次执行的精确时间。支持
date(特定时间执行一次)、interval(按固定时间间隔循环)和cron(标准的 Crontab 风格语法)。 - JobStores(任务存储器):负责保存已配置的任务定义及下一次运行时间。默认使用
MemoryJobStore(内存存储,断电丢失),但支持切换为SQLAlchemyJobStore(MySQL/PostgreSQL/SQLite)、RedisJobStore或MongoDBJobStore实现任务持久化。 - Executors(执行器):负责将到期任务派发到实际的并发执行环境中。常见配置包括
ThreadPoolExecutor(默认线程池)、ProcessPoolExecutor(适用于 CPU 密集型)以及AsyncIOExecutor(适用于原生异步代码)。 - Schedulers(调度器):负责统筹协调上述三个组件。常用的调度器实现有
BlockingScheduler(独占主线程的独立脚本)和BackgroundScheduler(后台非阻塞线程,适用于 Web 应用后台)。
2. 生产级完整代码示例
下面的代码展示了使用 BackgroundScheduler 配合 SQLite 持久化任务库、多线程池以及运行时事件监听的典型工程实现:
import time
from datetime import datetime
from apscheduler.schedulers.background import BackgroundScheduler
from apscheduler.jobstores.sqlalchemy import SQLAlchemyJobStore
from apscheduler.executors.pool import ThreadPoolExecutor
from apscheduler.events import EVENT_JOB_EXECUTED, EVENT_JOB_ERROR

# 1. 业务任务定义
def daily_report_task(report_type):
    print(f"[{datetime.now().strftime('%Y-%m-%d %H:%M:%S')}] 正在生成 {report_type} 报表...")

def job_listener(event):
    if event.exception:
        print(f"[告警] 任务 {event.job_id} 执行失败: {event.exception}")
    else:
        print(f"[通知] 任务 {event.job_id} 顺利完成")

# 2. 调度器配置:包含持久化任务存储与并发执行池
jobstores = {
    'default': SQLAlchemyJobStore(url='sqlite:///jobs_store.db')
}
executors = {
    'default': ThreadPoolExecutor(max_workers=10)
}
job_defaults = {
    'coalesce': True,            # 当任务发生积压时,合并为一次运行,避免瞬间并发打满
    'max_instances': 1           # 同一个任务在同一时间只允许运行一个实例,防止重复进入
}

scheduler = BackgroundScheduler(jobstores=jobstores, executors=executors, job_defaults=job_defaults)
scheduler.add_listener(job_listener, EVENT_JOB_EXECUTED | EVENT_JOB_ERROR)

# 3. 注册定时任务:Cron 与 Interval 混合使用
# 每工作日(周一至周五)上午 09:30 执行
scheduler.add_job(
    daily_report_task,
    trigger='cron',
    day_of_week='mon-fri',
    hour=9,
    minute=30,
    args=['工作日核心汇总'],
    id='job_daily_report',
    replace_existing=True
)

# 每 30 秒执行一次快速心跳
scheduler.add_job(
    lambda: print("APScheduler 心跳正常"),
    trigger='interval',
    seconds=30,
    id='job_heartbeat',
    replace_existing=True
)

if __name__ == '__main__':
    scheduler.start()
    print("APScheduler 调度服务已启动,后台持续运行中...")
    try:
        # 主线程维持运行,模拟服务常驻
        while True:
            time.sleep(2)
    except (KeyboardInterrupt, SystemExit):
        scheduler.shutdown()
        print("调度器安全退出")
在将 APScheduler 嵌入 Gunicorn 或 uWSGI 部署的应用中时,若启用了多个 Worker 进程(例如 gunicorn -w 4),每个 Worker 进程都会实例化一份独立的调度器,导致同一个定时任务被重复执行 4 次。解决方案是:将调度器抽离为独立的单例进程,或者在代码中借助文件互斥锁(fcntl.flock)/ Redis 分布式锁确保全局只有一个 Worker 成功启动调度器。
三、企业级分布式方案:Celery + Celery Beat
当业务演进到多台服务器集群、单次任务需要耗时数十分钟、或者任务并发量达到数万级别时,进程内的调度器就无法满足横向扩容与高可用的要求了。此时的标准解决方案是 Celery 配合 Celery Beat。
1. 运作流程与关键角色解耦
Celery 彻底将“时钟定时”与“业务执行”拆解开来:
- Celery Beat(定时事件发生器):作为全局唯一的节拍器,仅负责按时间计划读取任务配置,将需要执行的任务消息封装后推送给消息中间件(Broker),Beat 进程自身从不执行具体耗时的业务代码。
- Broker(消息代理,如 Redis 或 RabbitMQ):作为任务蓄水池,提供消息持久化、队列排队与削峰缓冲能力。即便所有 Worker 暂时不可用,任务也不会丢失。
- Celery Workers(工作节点集群):部署在多台物理机或容器中的 Worker 进程监听 Broker 队列,主动拉取任务并并发执行。通过调整 Worker 副本数即可实现线性的算力扩容。
- Result Backend(结果后端):可选组件(如 Redis/MySQL),用于记录任务的执行状态、返回值以及异常堆栈,便于管理后台追踪。
2. 工程配置与代码结构示例
首先创建 Celery 调度主配置模块 tasks.py:
from celery import Celery
from celery.schedules import crontab

# 初始化 Celery 应用,指定 Redis 作为消息中介和结果存储
app = Celery(
    'task_system',
    broker='redis://localhost:6379/0',
    backend='redis://localhost:6379/1'
)

# 基础性能与稳定性配置
app.conf.update(
    timezone='Asia/Shanghai',
    enable_utc=True,
    task_serializer='json',
    result_serializer='json',
    accept_content=['json'],
    task_acks_late=True,          # 任务执行完成后再发送 ACK,防止 Worker 异常崩溃导致丢任务
    worker_prefetch_multiplier=1  # 每次只预取一条任务,避免长耗时任务分配不均
)

# 周期定时任务列表 (Celery Beat Schedule)
app.conf.beat_schedule = {
    'clean-expired-sessions-every-midnight': {
        'task': 'tasks.clean_expired_sessions',
        'schedule': crontab(hour=0, minute=0),  # 每天午夜 00:00 执行
        'args': (7,)                           # 清理 7 天前过期会话
    },
    'calculate-order-metrics-every-10m': {
        'task': 'tasks.sync_order_metrics',
        'schedule': 600.0,                     # 每 10 分钟执行一次
    },
}

# 具体业务任务实现
@app.task(bind=True, max_retries=3, default_retry_delay=60)
def clean_expired_sessions(self, expire_days):
    try:
        print(f"开始执行历史会话清理,清理阈值:{expire_days} 天前...")
        # 业务逻辑代码
        return "清理成功"
    except Exception as exc:
        # 异常自动重试
        raise self.retry(exc=exc)

@app.task
def sync_order_metrics():
    print("正在聚合最新订单交易指标...")
    return {"status": "ok", "items_processed": 1280}
在生产环境中,需要分别在终端启动 Worker 与 Beat 服务:
# 启动任务消费 Worker(支持设置并发进程数)
celery -A tasks worker --loglevel=info --concurrency=4

# 启动定时节拍器 Beat(全局必须只启动一个实例)
celery -A tasks beat --loglevel=info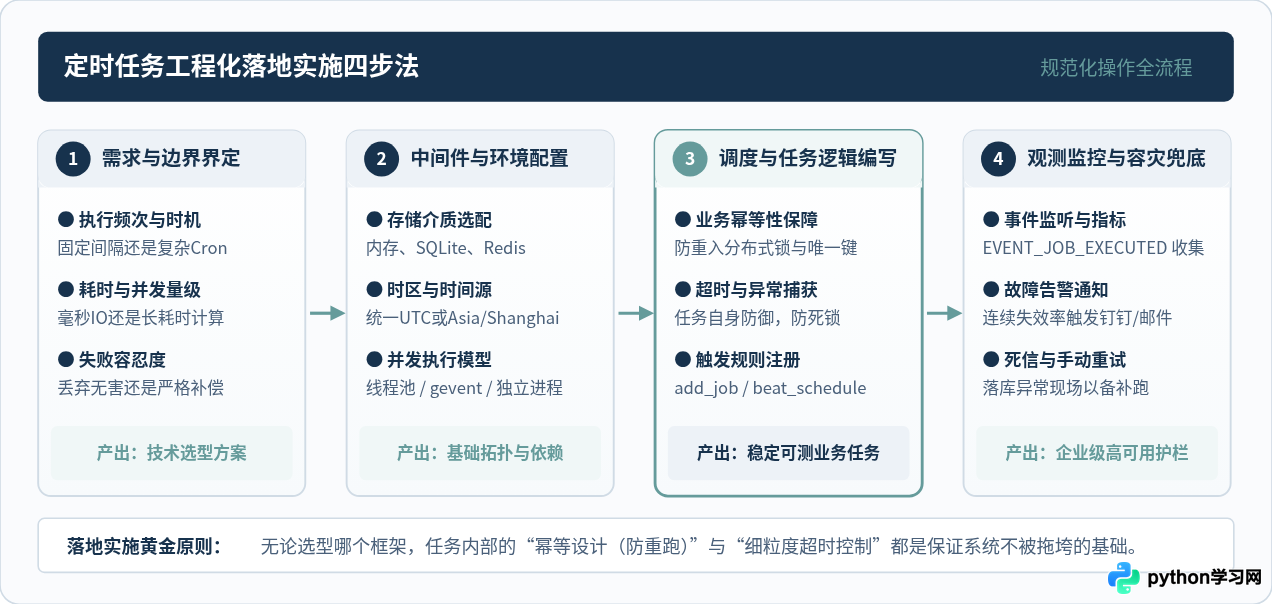
四、核心维度深度对比
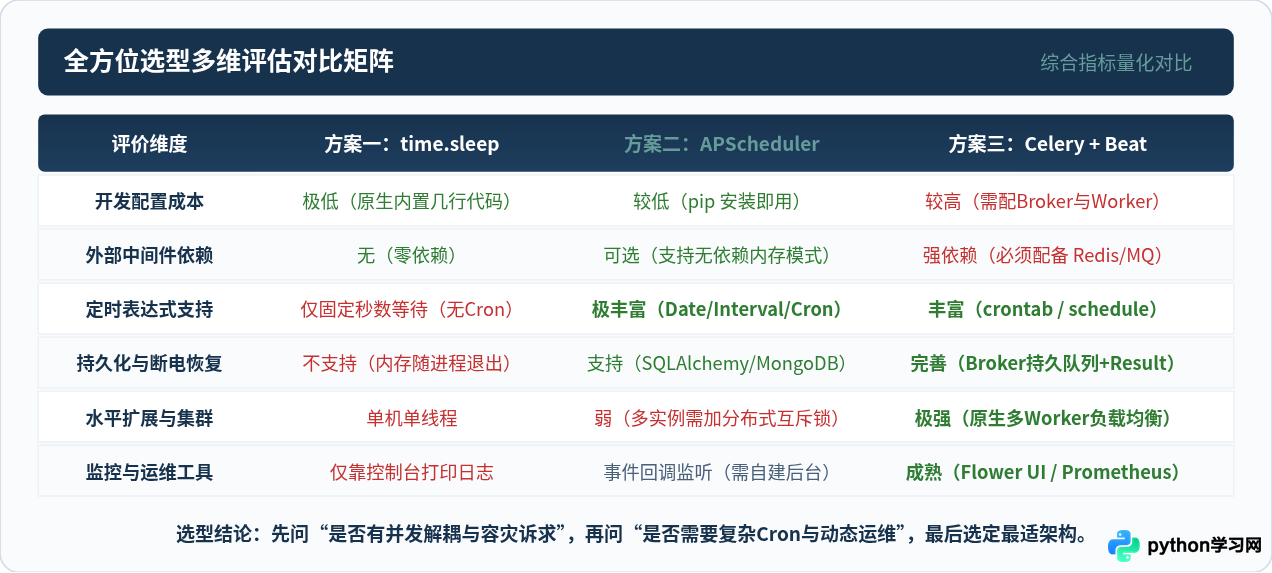
为了更清晰地评估三个方案在工程实际中的权衡关系,下面从开发门槛、运维依赖、触发能力、容灾扩展等核心指标进行横向对比:
| 对比指标 | time.sleep / 原生循环 | APScheduler | Celery + Celery Beat |
|---|---|---|---|
| 上手与配置成本 | 极低,无需安装任何额外第三方库 | 低,仅需 pip install apscheduler |
高,需配置中间件、环境变量与进程监管 |
| 外部中间件依赖 | 无依赖 | 可选依赖(默认纯内存,可选 SQL/Redis) | 强依赖 Redis 或 RabbitMQ 消息代理 |
| 定时触发丰富度 | 仅固定等待秒数,无法原生支持复杂日期 | 支持精确到秒的 Date、Interval 与标准 Cron | 支持固定秒数与标准 Crontab 表达式 |
| 分布式横向扩容 | 不支持,局限于当前进程 | 弱,单实例调度,多实例需自建锁防重复 | 极强,Worker 节点可无缝跨机器弹性扩容 |
| 任务持久化与断点恢复 | 不支持,进程重启状态归零 | 支持,通过 SQLAlchemy/Redis 存储作业 | 原生完善,消息队列持久化 + 结果后端 |
| 异常自动重试 | 需开发者纯手工写 try-except 循环包装 | 可通过事件回调自定义重试逻辑 | 内置 max_retries、退避重试机制 |
| 运维监控工具 | 仅控制台输出日志 | 可通过注册 Listener 收集指标 | 官方 Flower Web 仪表盘、Prometheus 导出 |
五、选型决策指南与落地法则
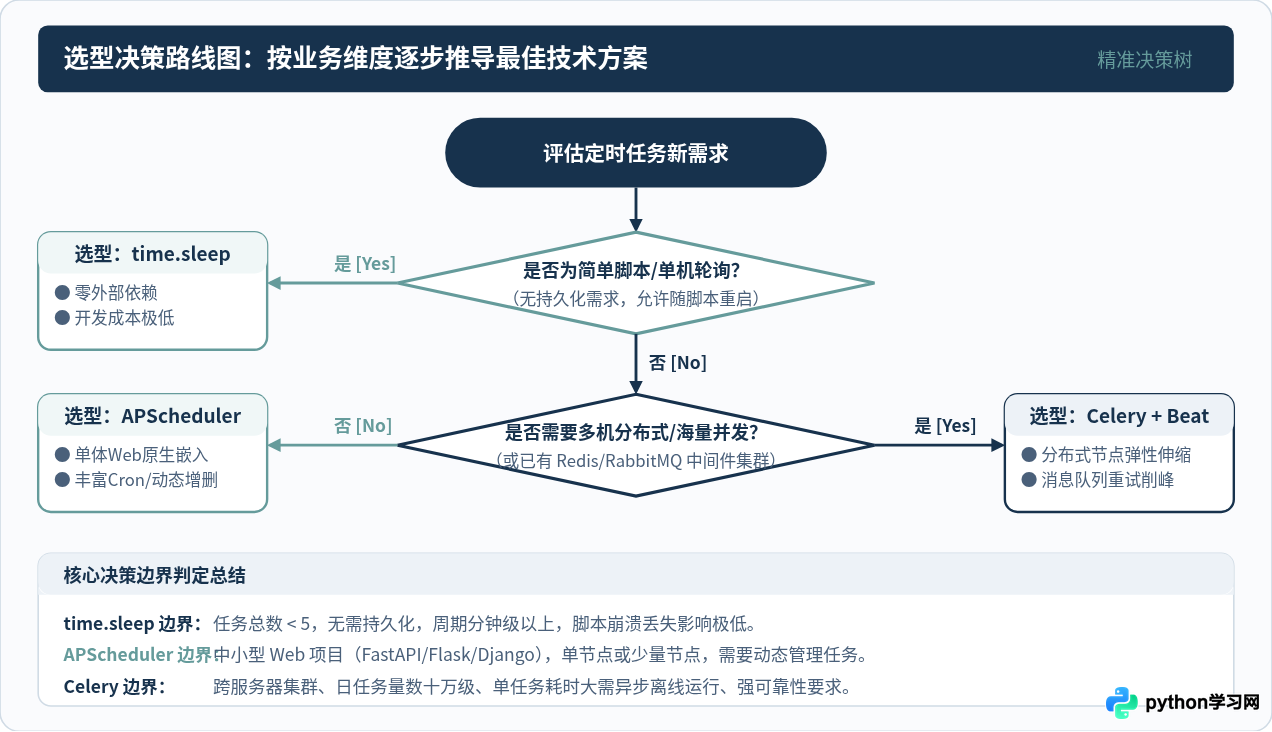
在实际技术选型时,切忌盲目追求重型架构,而应根据当前的业务所处阶段与团队运维能力进行梯级匹配:
1. 选择 time.sleep 的场景
- 整个脚本仅用于个人本地调试、一次性自动化运维或者测试数据的简单模拟。
- 任务数量仅有 1~2 个,且执行间隔大于 10 秒,允许随脚本重启而重置。
- 完全不具备引入任何第三方库或中间件的极简运行环境。
2. 选择 APScheduler 的场景
- 基于 FastAPI、Flask 或 Django 的单体 Web 项目,需要随 Web 服务一起启动一些后台维护工作(如每天清理一次临时文件、每小时同步一次外围接口数据)。
- 需要在运行时通过管理后台动态添加、修改、暂停或删除定时任务(APScheduler 的
modify_job、pause_job接口极为好用)。 - 项目处于初期或中型阶段,没有专门的运维团队维护 Redis/RabbitMQ 集群,希望将所有调度收敛在 Python 应用内部。
3. 选择 Celery 的场景
- 定时任务本身是重型计算密集型或网络 I/O 密集型操作(如批量生成 PDF、海量数据清洗、群发数万封营销邮件),耗时从数分钟到数小时不等,必须与 Web 接口服务完全解耦。
- 系统采用微服务或分布式集群架构部署,单个 Worker 节点挂掉时,其他节点必须能自动接管未执行的任务。
- 需要成熟的运维可视化工具(如 Flower)来实时监控每个定时任务的执行耗时、成功率以及重试轨迹。
4. 生产环境通用避坑守则
无论最终选用哪个调度方案,在编写业务定时任务时,都应遵守以下三条底线规则:
- 必须保障任务逻辑的“幂等性”:由于网络超时或重试机制,同一个定时任务有可能在短时间内被触发两次。任务代码内部必须通过业务唯一 ID、数据库唯一索引或分布式互斥锁,确保多次执行产生的结果与单次执行完全一致。
- 所有外围调用必须设置硬超时:定时任务中涉及的 HTTP 请求、数据库查询或第三方 SDK 调用,必须显式指定超时阈值(如
requests.get(..., timeout=10)),防止因下游接口无响应导致工作线程被永久死锁卡死。 - 严格统一时区基准:服务器操作系统时区、数据库时区与定时任务调度框架时区必须严格统一(建议生产环境统一使用
UTC或显式声明Asia/Shanghai),避免在冬令时切换或服务器跨地域部署时出现任务触发时间偏差。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









