

Python split分割后出现空字符串怎么过滤
深入解析在Python中使用split分割字符串后出现空字符串的原因及多种过滤方法,包含列表推导式、filter函数、无参split及正则表达式等方案与选型建议。
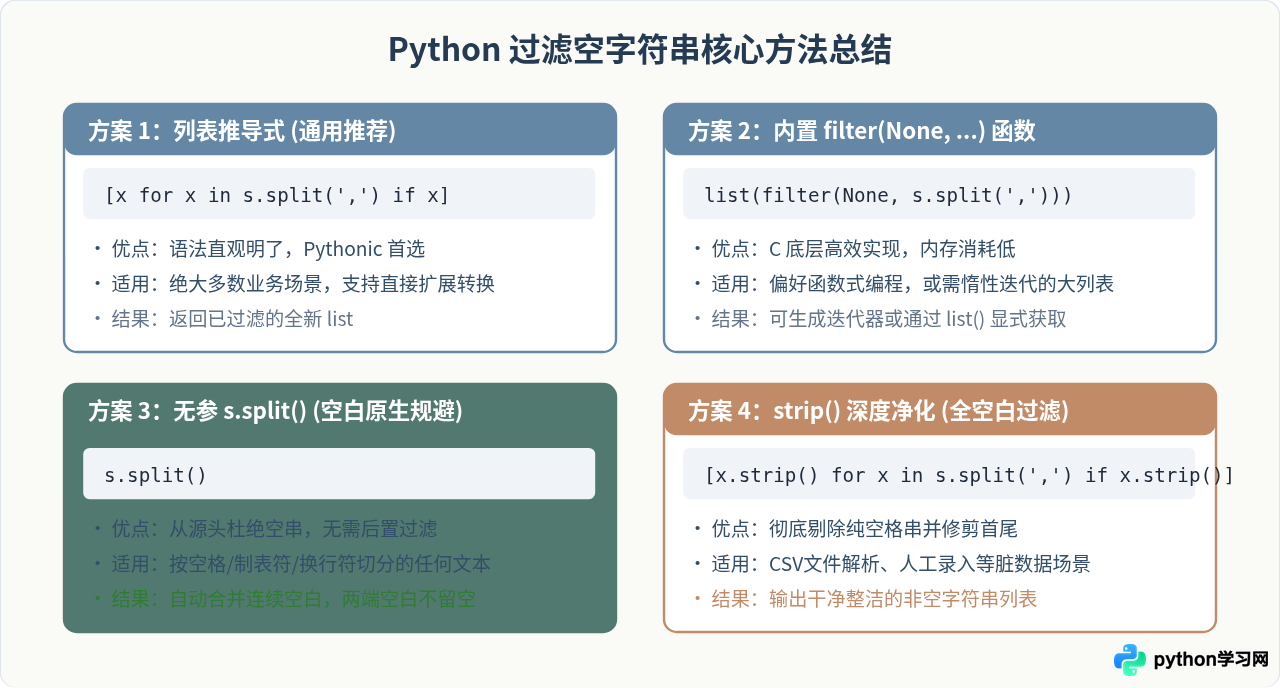
在 Python 中使用 str.split() 分割字符串时,常常会因为连续分隔符或首尾存在分隔符而在结果列表中产生空字符串 ""。最直接有效的通用过滤方案是使用列表推导式 [x for x in s.split(',') if x],或者使用内置函数 list(filter(None, s.split(',')));如果是按空格或换行等空白字符切分,则直接使用不传任何参数的 s.split() 即可在源头自动消除空字符串。本文将详细分析空字符串产生的原因,并逐一介绍不同场景下的过滤方法与选型考量。
一、为什么 split 分割后会出现空字符串
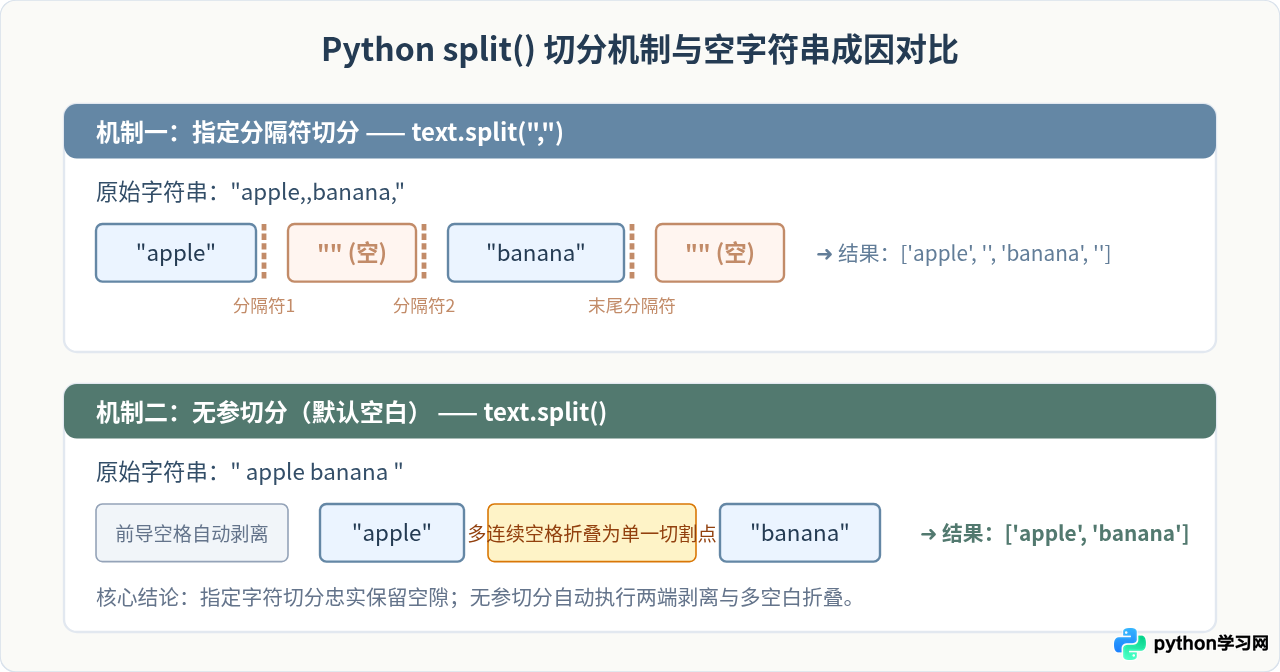
理解空字符串的成因有助于在编写代码时选择最合适的解决路径。当向 split() 传入具体的分隔符(例如逗号 s.split(','))时,Python 会严格执行边界切割规则:
- 首尾存在分隔符:如果字符串以分隔符开头或结尾,分隔符的外侧没有字符,解析器会将其视为空字符,因此生成一个空字符串
""。例如",a,b".split(",")的第一个元素就是""。 - 存在连续分隔符:如果两个分隔符紧挨着出现,两个分隔符之间没有任何字符,切分后两个分隔符中间的位置就会产出一个空字符串。例如
"a,,b".split(",")中间包含了""。
与指定分隔符不同,当调用不带任何参数的 s.split() 时,Python 默认采用“空白字符算法”。该算法会自动忽略首尾的空白字符,并将任意长度的连续空白字符(包括空格、制表符 \t、换行符 \n 等)折叠为一个单一分隔点,因此原生不会产生空字符串。
二、过滤空字符串的常见有效方法
方法一:列表推导式(推荐首选)
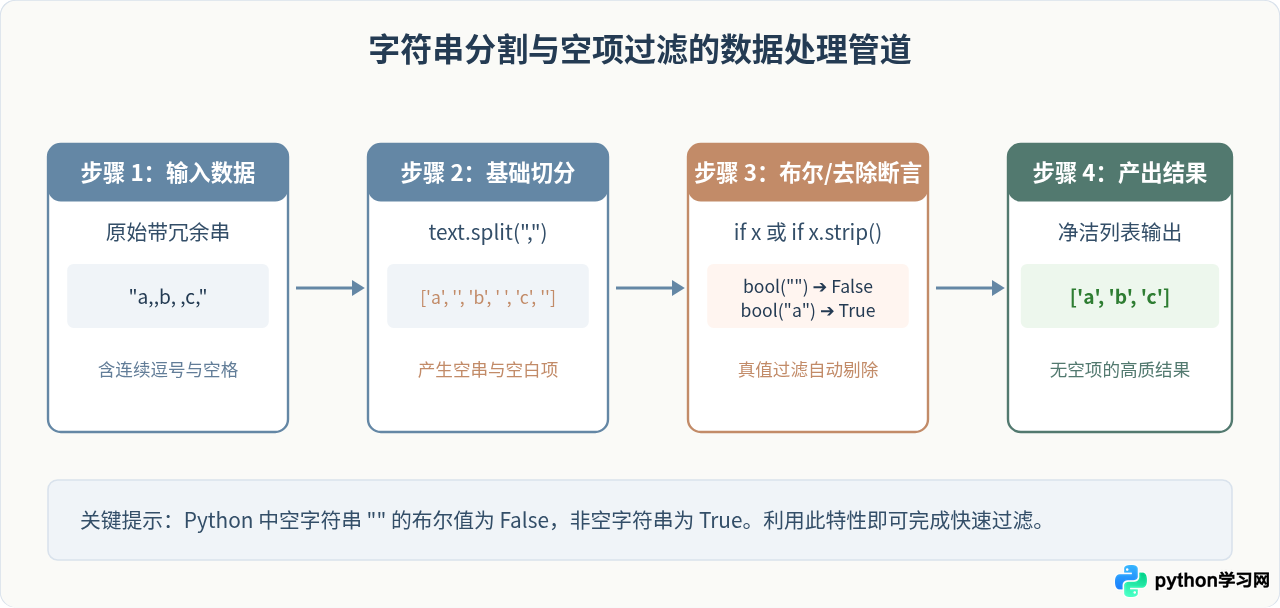
利用 Python 中“空字符串布尔值为 False、非空字符串布尔值为 True”的真值特性,使用列表推导式是最直观、最符合 Pythonic 风格的解决方案:
raw_text = "apple,,banana,,,orange,"
# 切分并过滤纯空字符串
result = [x for x in raw_text.split(",") if x]
print(result) # 示例输出: ['apple', 'banana', 'orange']原理解析:if x 会在遍历每个切分出的元素时隐式计算 bool(x)。当 x == "" 时,结果为 False,该项被舍弃;其余有效字符串得以保留。
方法二:使用 filter(None, ...) 函数
Python 提供了内置函数 filter()。当第一个参数传入 None 时,它会自动以元素的真值(truthiness)作为过滤条件:
raw_text = "apple,,banana,,,orange,"
# 使用 filter 进行过滤,再转换为列表
result = list(filter(None, raw_text.split(",")))
print(result) # 示例输出: ['apple', 'banana', 'orange']原理解析:filter(None, iterable) 在 C 语言底层实现真值筛选,执行速度非常快。在不需要立即展开为列表的大数据流中,直接保留迭代器对象还能节约内存开销。
方法三:无参 split() 从源头规避
如果切分的目标是空格、制表符或换行符,很多开发者会习惯性写成 s.split(" "),这反而导致了空字符串的产生。正确的做法是完全不传参数:
raw_text = "  apple   banana \t orange \n "
# 错误方式:传入单个空格
print(raw_text.split(" "))
# 输出示例包含大量空串: ['', '', 'apple', '', '', 'banana', '\t', 'orange', '\n', '']

# 正确方式:不传参数
print(raw_text.split())
# 输出示例完美干净: ['apple', 'banana', 'orange']
方法四:正则表达式 re.split 一步到位
当文本中包含多个不同分隔符(例如既有逗号又有分号),或者需要将连续分隔符视为单一分隔符时,使用标准库 re 可以直接切分并避免空字符串:
import re

raw_text = "apple,,banana;;;orange,grape"
# 使用正闭包匹配一个或多个连续的逗号或分号
result = [x for x in re.split(r"[,;]+", raw_text) if x]
print(result)  # 示例输出: ['apple', 'banana', 'orange', 'grape']
三、进阶场景:包含“纯空格”字符串的处理
实际开发(如解析 CSV、日志或表单输入)中,往往会遇到元素不仅包含纯空字符串 "",还包含仅含空格的脏项(如 " ")。对于 " ",它的布尔值是 True,简单的 if x 无法过滤它:
raw_text = "apple, ,banana,   ,orange"
# 仅用 if x 无法过滤纯空格字符串
print([x for x in raw_text.split(",") if x])
# 示例输出仍含脏项: ['apple', ' ', 'banana', '   ', 'orange']
此时需要配合 str.strip() 方法同时修剪并断言:
# 方案 A:同时去除有效元素两侧多余空格并过滤全空项
clean_list = [item.strip() for item in raw_text.split(",") if item.strip()]
print(clean_list)  # 示例输出: ['apple', 'banana', 'orange']

# 方案 B:使用两阶段生成器表达式(避免重复调用 strip)
clean_gen = (item.strip() for item in raw_text.split(","))
clean_list = [item for item in clean_gen if item]
print(clean_list)  # 示例输出: ['apple', 'banana', 'orange']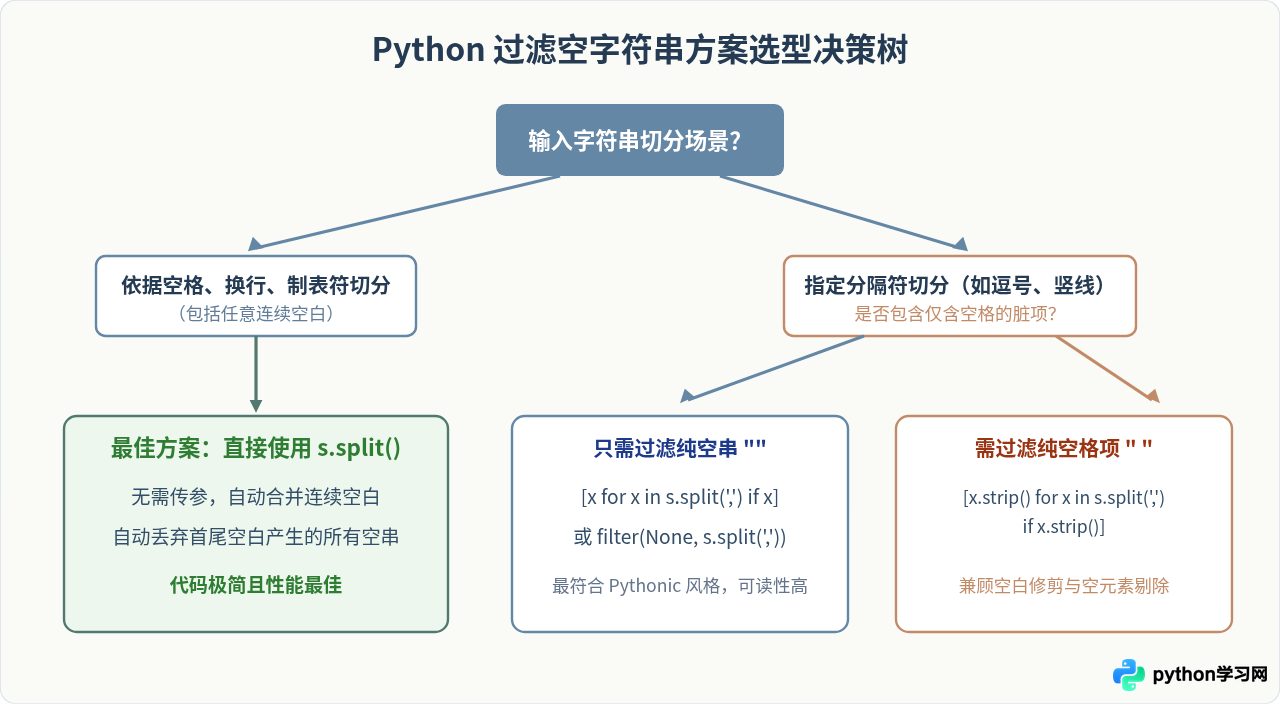
四、常见问题与注意事项
陷阱提醒:在 Python 中,None 作为 filter 参数时只对假值进行过滤。在字符串列表中,假值只有唯一的空字符串 "",因此 filter(None, ...) 可以安全运行,不用担心误删非空内容。
- 内存敏感场景避免一次性建表:如果处理的是数 GB 的巨大单行字符串,先
split()会在内存中一次性分配庞大的中间列表。这种情况下更适合使用正则迭代器re.finditer()边扫描边输出,避免内存激增。 - 避免误写为
s.split(" "):切记split()与split(" ")是两种完全不同的切分逻辑。切分空白时请勿传入" "。
五、各过滤方法特性对比与总结
| 方法 | 代码示例 | 适用场景 | 性能与特点 |
|---|---|---|---|
| 列表推导式 | [x for x in s.split(',') if x] |
通用场景,需后续处理 | 可读性最强,支持同时进行格式变换 |
| 内置 filter | list(filter(None, s.split(','))) |
函数式编程或超大列表 | 底层 C 语言遍历,执行速度略胜一筹 |
| 无参 split | s.split() |
按任意空白字符分割 | 原生自动合并空白并清除首尾空项,最高效 |
| strip 增强过滤 | [x.strip() for x in s.split(',') if x.strip()] |
含纯空格的脏数据 | 不仅去除 "",同时消灭 " " |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









