

Python time.strptime解析时间字符串报错怎么办
全面分析Python中使用time.strptime解析时间字符串报错ValueError的原因,涵盖格式符不匹配、隐藏字符、微秒不支持、语言环境冲突等核心诱因,并给出清晰可执行的排查步骤与完整代码方案。
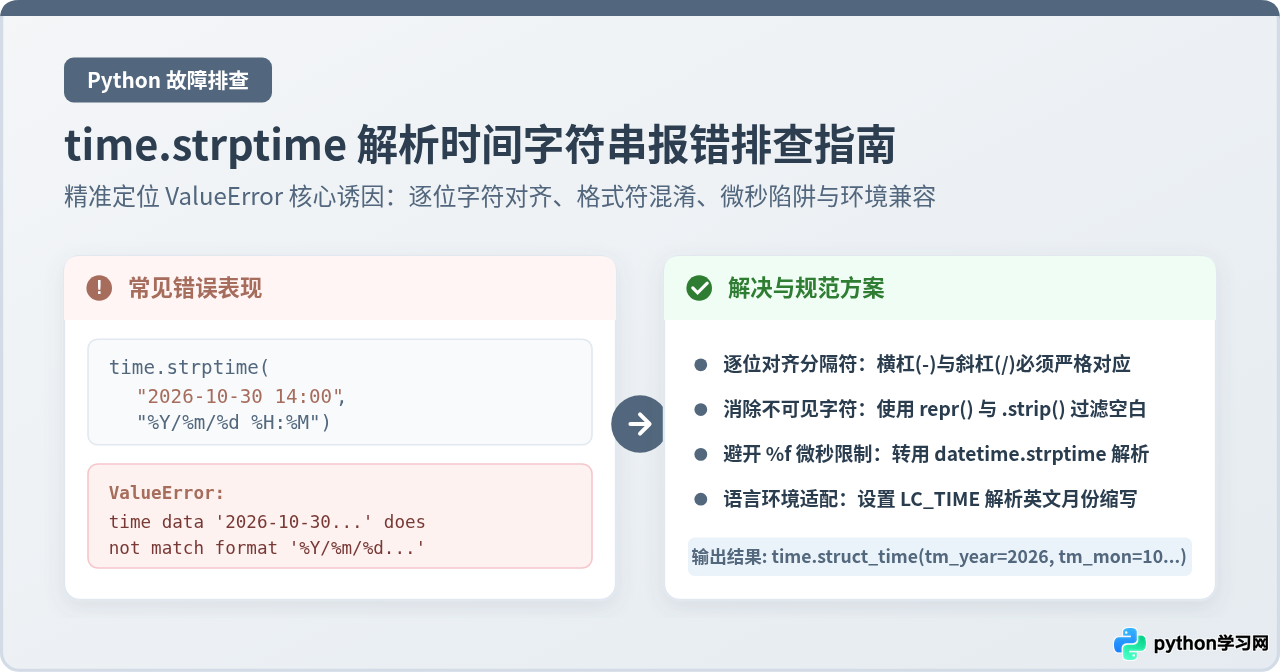
time.strptime(string, format) 函数将时间文本转为时间元组时,如果抛出 ValueError,核心原因无非两类:一是待解析的字符串与给定的格式控制符模板在字符、空格或标点上没有做到“逐位严格吻合”;二是目标字符串包含了当前函数无法处理的特殊数据(例如微秒、时区或特定语言的月份缩写)。解决该问题的标准路径是:先用 repr() 检查并清理字符串中隐藏的不可见空白符,核对占位符大小写及进制规范,遇到微秒时转用 datetime.strptime(),并在多语言场景下指定合适的 LC_TIME 本地化配置。
一、报错的具体表象与底层解析机制
当时间字符串与预设格式不一致时,Python 通常会抛出以下两类最典型的 ValueError 异常:
ValueError: time data '...' does not match format '...':这说明解析器在某个字符位置上发生了断裂,字符串中的字符与格式模板预期的字符无法对应。ValueError: unconverted data remains: '...':这表示格式模板已经从头到尾匹配完毕,但输入字符串尾部依然留有未解析的内容。
要彻底解决报错,需要理解 time.strptime 的底层原理。Python 的 time.strptime 是一个基于严格词法匹配的状态机。它不会像某些高阶外部库那样智能猜测日期的含义,而是要求开发者提供的格式字符串(format)与原始时间文本(string)实现字符级别的一对一映射。
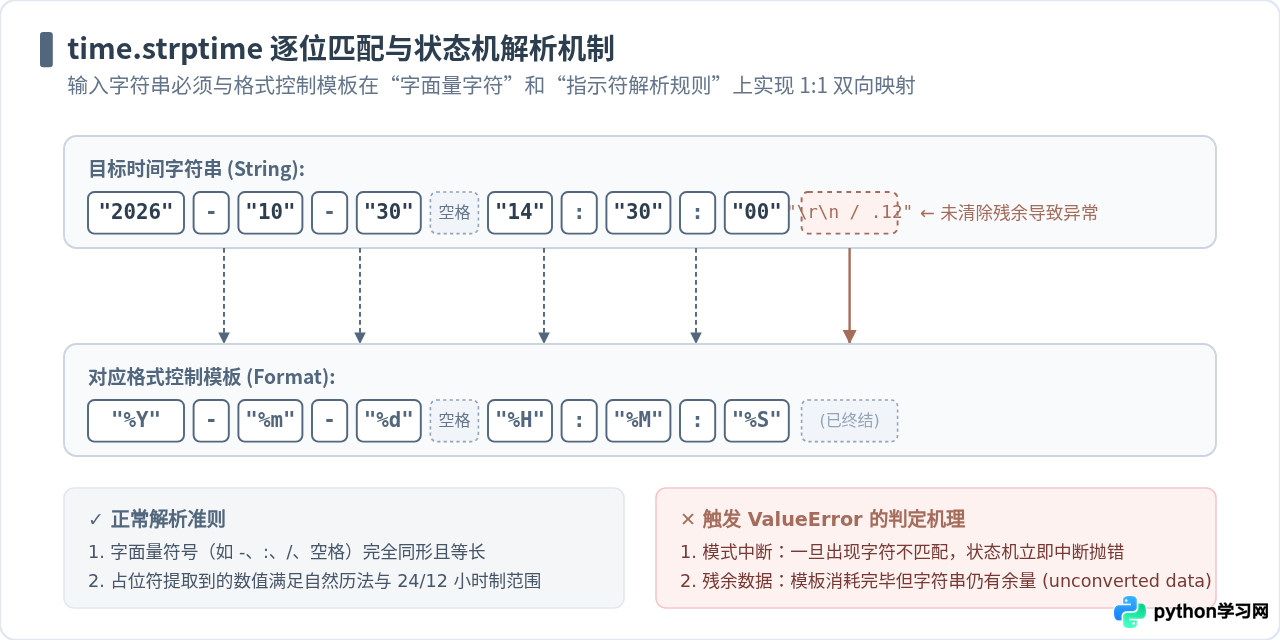
如图 1 所示,解析器从左至右扫描。遇到格式指令(如 %Y)时,它会尝试消费对应规则的字符序列,并检验其数学与历法有效性;遇到普通字符(如连接符 - 或空格)时,它要求字符串必须存在完全相同的字面量。一旦任意一位出现细微偏差,解析过程就会立刻被切断并抛出异常。
二、引发报错的五大高频诱因与实例修复
在实际开发中,引发 time.strptime 解析失败的原因往往集中在以下五个方面。了解这些诱因能帮助我们在排查时迅速定位症结。
1. 格式占位符大小写与位宽混淆
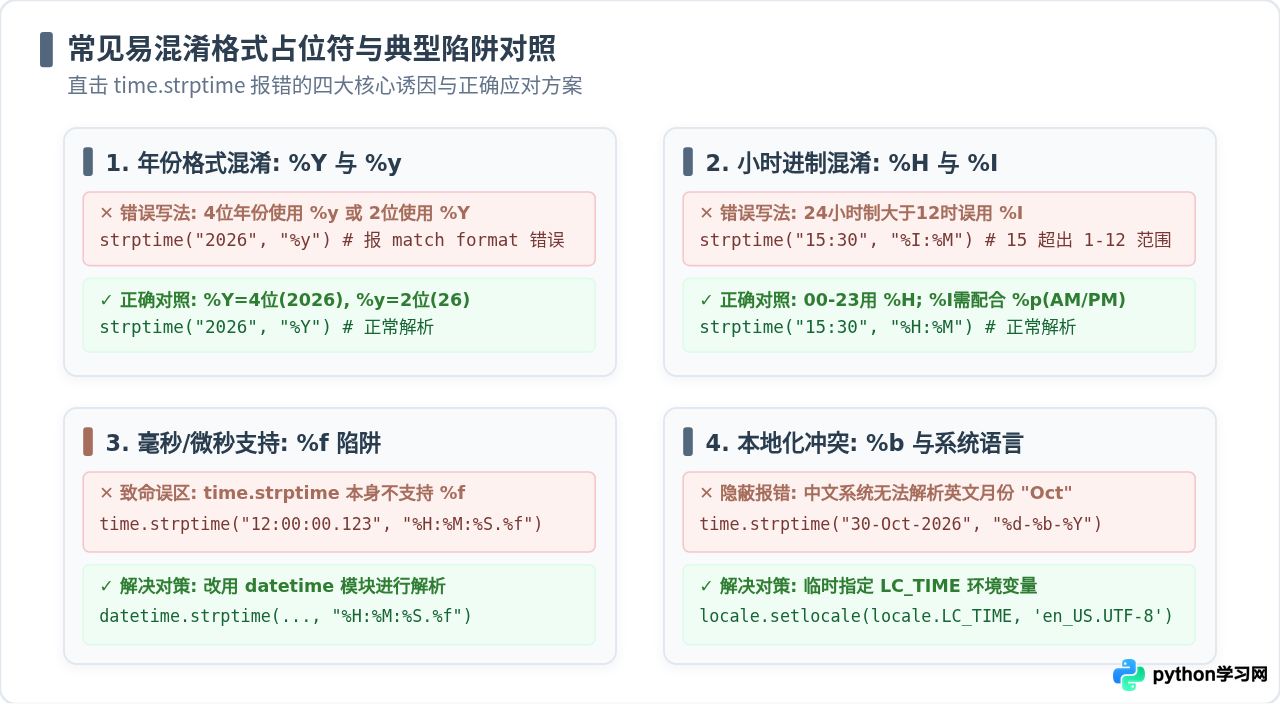
Python 格式化指令对字母的大小写极其敏感。大小写代表截然不同的解析规则,极易因笔误造成解析失败:
%Y(大写)代表包含世纪的 4 位年份(例如2026),而%y(小写)代表不带世纪的 2 位年份(例如26)。如果字符串是"2026-10-30",模板写成"%y-%m-%d"就会报错。%H(大写)代表 24 小时制(范围00至23),而%I(大写字母 I)代表 12 小时制(范围01至12)。当时间是下午两点即"14:30"时,使用"%I:%M"会因为数值超过 12 而报错。%m(小写)代表月份(01至12),而%M(大写)代表分钟(00至59),二者绝不能混淆。
import time

# 错误示例:24小时制的 15点 误用了 12小时制指令 %I
time_str = "2026-10-30 15:30:00"
# time.strptime(time_str, "%Y-%m-%d %I:%M:%S")  # 抛出 ValueError

# 正确示例:将 %I 纠正为 %H
parsed_time = time.strptime(time_str, "%Y-%m-%d %H:%M:%S")
print("解析成功 (struct_time):", parsed_time.tm_hour, "点", parsed_time.tm_min, "分")2. 隐藏空白符与格式分隔符不一致
视觉上看起来完全一致的字符串,在底层可能包含不可见的控制字符。例如从网页爬取或从文件日志中读取的时间串,经常夹带着行尾换行符
、回车符 、制表符 或连续的空格。此外,半角横杠 - 与中文破折号、英文半角空格与全角空格也无法相互匹配。
import time

raw_data = "2026-10-30 08:30:00\n"

# 直接解析会因末尾存在换行符而报错:unconverted data remains: \n
# 修复:先使用 repr 观察,再调用 strip() 清洗首尾空白
clean_str = raw_data.strip()
res = time.strptime(clean_str, "%Y-%m-%d %H:%M:%S")
print("清洗后解析年份:", res.tm_year, "月份:", res.tm_mon)3. time.strptime 无法解析微秒(%f 陷阱)
这是一个非常隐蔽但高频的陷阱。很多有经验的开发者习惯在 datetime.datetime.strptime() 中使用 %f 指令来匹配微秒(如 .123456)。然而在 Python 的内置 time 模块中,time.struct_time 结构体设计之初只支持秒级精度,底层许多系统的 C 实现并不支持 %f。
"2026-10-30 14:30:00.123",直接对 time.strptime 传入 "%Y-%m-%d %H:%M:%S.%f" 会抛出 ValueError: 'f' is a bad directive in format。此时必须改用 datetime 模块,或者先用字符串截断去除微秒部分。
from datetime import datetime

log_time = "2026-10-30 14:30:00.654321"

# 正确方案:对于带有微秒的字符串,使用 datetime 模块解析
dt = datetime.strptime(log_time, "%Y-%m-%d %H:%M:%S.%f")
print("datetime解析成功:", dt)
print("提取微秒部分:", dt.microsecond)提取微秒部分: 654321
4. 英文月份/星期缩写与本地语言环境(Locale)冲突
指令 %b 和 %B 分别用于匹配月份的简写与全称(例如 Oct 或 October)。但是,这些指令是受系统的本地化区域设置(LC_TIME)制约的。在默认中文或非英语环境的操作系统上,time.strptime 期望匹配到的是 "10月" 而非 "Oct",直接传入 "30-Oct-2026" 就会报 ValueError。
import time
import locale

date_text = "30-Oct-2026 10:00"

try:
    # 切换为英文环境以解析英文字符串
    locale.setlocale(locale.LC_TIME, 'en_US.UTF-8')
    res = time.strptime(date_text, "%d-%b-%Y %H:%M")
    print("英文月份解析成功,对应数字月份为:", res.tm_mon)
finally:
    # 恢复系统的默认语言环境,避免对后续业务造成副作用
locale.resetlocale(locale.LC_TIME)5. 非法历法与越界数值
即使格式占位符与字符串位置完全匹配,如果字符串中的数字违反了现实历法规则,同样会报 ValueError。例如平年的 "2026-02-29"、月份写成 "13",或者小时写成 "25:00"。此时问题源头不在格式代码,而在于上游提供的数据源存在脏数据。
三、系统化排查与修复的五步流程
面对控制台的一行 ValueError 报错,不建议盲目修改格式字符串碰运气。按照以下步骤有序排查,能够在两分钟内准确定位问题根源:
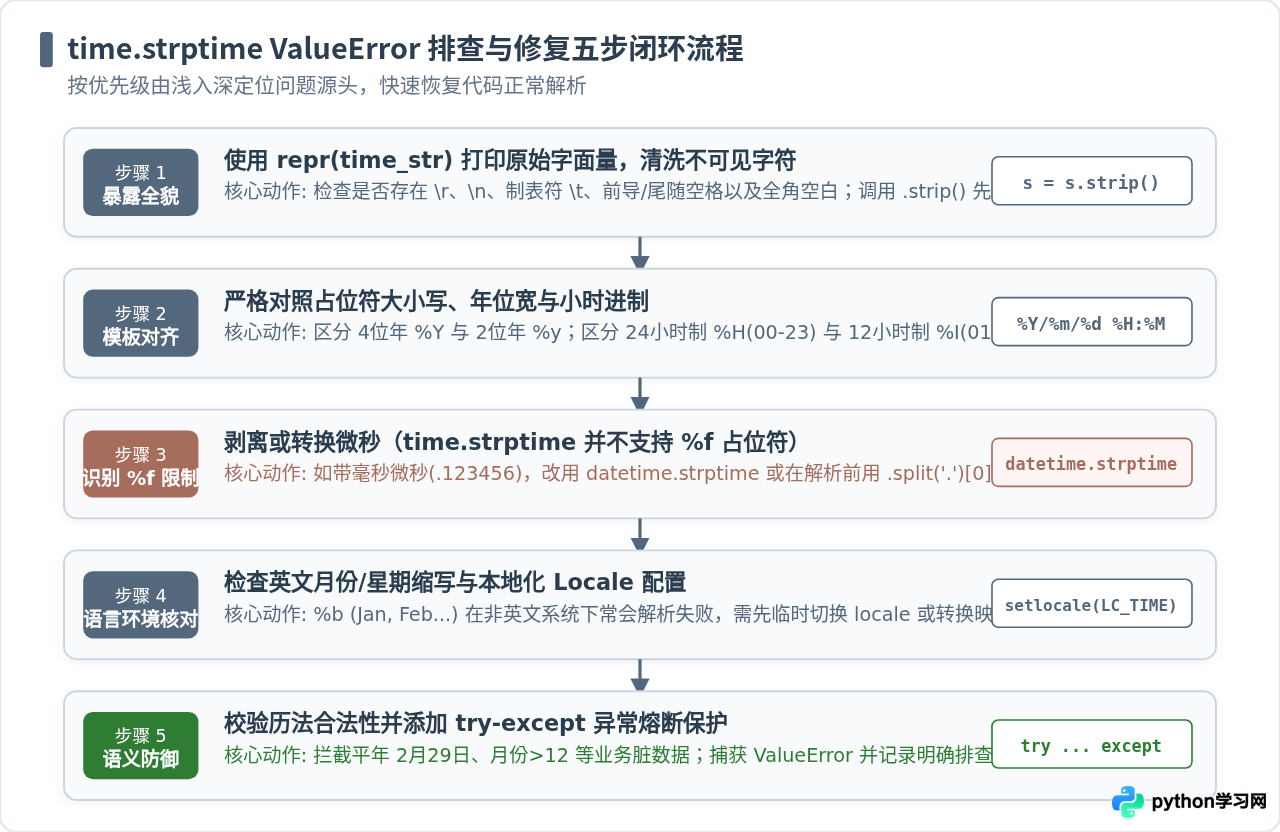
- 第一步:暴露全貌。使用
print(repr(time_str))输出字符串。repr()会显式展示转义字符,立刻让尾随的.strip()。 - 第二步:逐段核对占位符。以连接符号为界,将字符串与模板分为若干小段。核对年份位数(
%Yvs%y)、月份与分钟(%mvs%M)、小时进制(%Hvs%I)。 - 第三步:识别微秒与时区。检查字符串末尾是否有
.123之类的微秒,或者+08:00、Z这类时区标记。如果包含微秒,将解析代码切换为datetime.strptime;如果包含 ISO 8601 时区,建议使用datetime.fromisoformat()。 - 第四步:确认语言环境。如果格式模板使用了
%b、%B、%a、%A或%p,确认操作系统当前的locale是否与时间字符串的语种一致。 - 第五步:验证历法语义并加入异常兜底。检查日期数值是否合理,并在调用处包裹
try...except ValueError结构,输出具体的排错上下文。
四、常见报错特征与解决方案速查矩阵
为了便于快速查找对照,下表将高频出现的报错特征、根本诱因与标准应对方法进行了归纳:
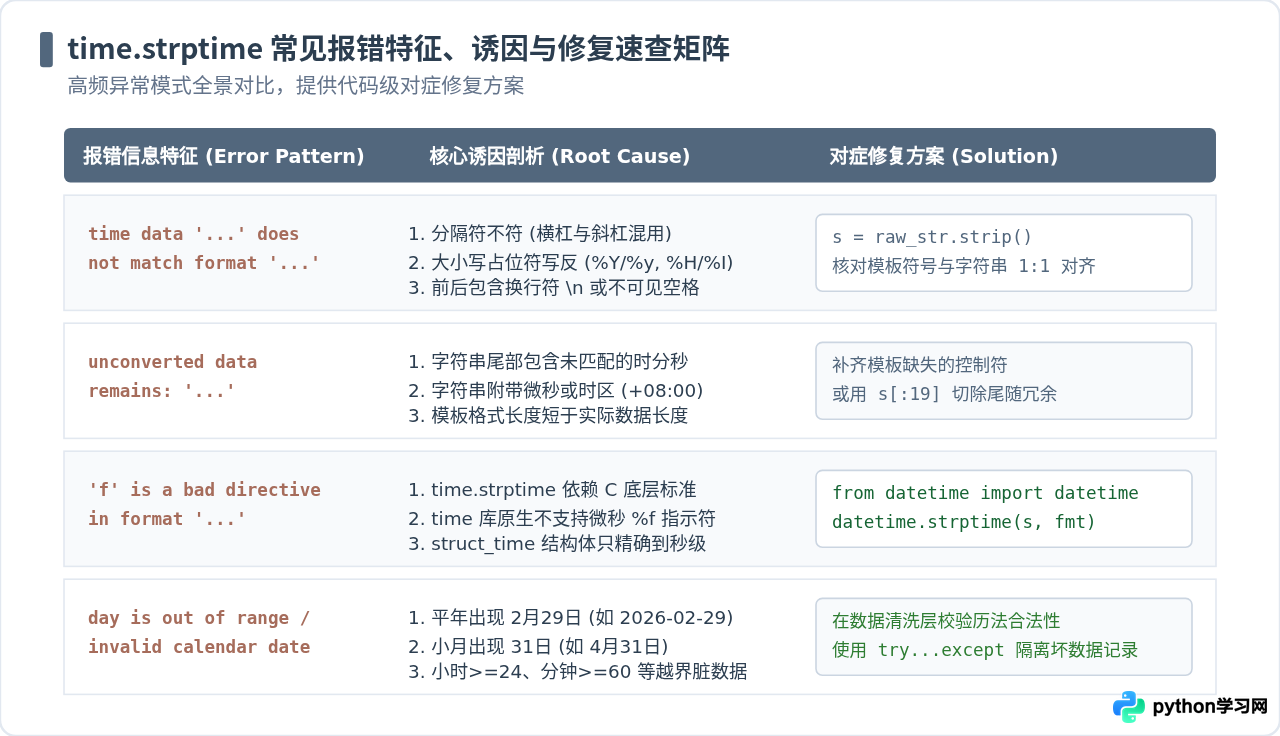
| 报错特征信息 | 主要诱因 | 标准解决代码 |
|---|---|---|
time data '...' does not match format '...' |
1. 分隔符(-、/、空格)不一致 2. 占位符大小写混淆(%y/%Y) 3. 包含首尾多余空白 |
s = raw.strip()time.strptime(s, "%Y-%m-%d %H:%M:%S") |
unconverted data remains: '...' |
模板长度小于输入字符串长度,尾部留存未匹配的字符或微秒 | # 补全模板或截断字符串time.strptime(s[:19], "%Y-%m-%d %H:%M:%S") |
'f' is a bad directive in format |
time.strptime 原生不支持 %f 微秒占位符 |
from datetime import datetimedatetime.strptime(s, "%Y-%m-%d %H:%M:%S.%f") |
day is out of range for month |
平年 2月29日 或 小月 31日 等逻辑日历越界 | # 校验数据源并加入防御性捕获try: ... except ValueError: ... |
五、生产环境中的防御性解析实践
在批量处理用户输入、外部接口调用或日志解析时,无法保证输入时间串永远绝对标准。为了避免单个格式不规范的字符串导致整个服务或批处理任务崩溃,编写具备容错能力的解析函数是标准做法。
import time
from datetime import datetime

def robust_parse_time(time_str):
    """
    稳健解析时间字符串,兼容常见格式并容错防御
    """
    if not isinstance(time_str, str):
        return None

    clean_str = time_str.strip()

    # 候选格式列表:从高精度到低精度逐一尝试
    candidate_formats = [
        ("%Y-%m-%d %H:%M:%S", False),
        ("%Y/%m/%d %H:%M:%S", False),
        ("%Y-%m-%d", False),
        ("%Y/%m/%d", False),
        ("%Y-%m-%d %H:%M:%S.%f", True),  # 带微秒,标记需使用 datetime
    ]

    for fmt, use_datetime in candidate_formats:
        try:
            if use_datetime:
                dt = datetime.strptime(clean_str, fmt)
                return dt.timetuple()
            else:
                return time.strptime(clean_str, fmt)
        except ValueError:
            continue

    # 如果所有候选模板均匹配失败,记录排查上下文
    print(f"[警告] 无法解析的时间格式: {repr(time_str)}")
    return None

# 批量验证不同来源的字符串
test_samples = [
    "2026-10-30 14:30:00",
    "2026/10/30 14:30:00\n",
    "2026-10-30 14:30:00.999",
    "2026-13-40 00:00:00"  # 脏数据
]

for sample in test_samples:
    result = robust_parse_time(sample)
    if result:
        print(f"成功解析 {sample.strip()} -> 年:{result.tm_year} 月:{result.tm_mon} 日:{result.tm_mday}")
    else:
print(f"失败跳过脏数据: {sample.strip()}")成功解析 2026/10/30 14:30:00 -> 年:2026 月:10 日:30
成功解析 2026-10-30 14:30:00.999 -> 年:2026 月:10 日:30
[警告] 无法解析的时间格式: '2026-13-40 00:00:00'
失败跳过脏数据: 2026-13-40 00:00:00
time.strptime 抛出 ValueError 时,先用 repr() 查隐形空白,再逐字比对格式符大小写与横杠斜杠。遇微秒直接换 datetime,遇英文月份先设 LC_TIME。掌握这几项规则,绝大多数时间解析报错都能在短时间内彻底解决。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









