

Python怎么将当前时间格式化为年月日时分秒字符串
详细讲解在Python中使用datetime模块将当前时间格式化为年月日时分秒字符串的完整方法、执行流程、常用占位符对照及中文格式跨平台处理方案。
datetime 模块:调用 datetime.now() 取得当前时间对象,随后执行 .strftime('%Y-%m-%d %H:%M:%S') 即可得到形如 2026-10-29 23:58:12 的标准时间字符串。
一、核心解决方案:两行代码完成格式化
处理时间字符串无需安装任何第三方库。Python 核心库中自带的 datetime 类提供了从时间读取到文本格式化的一整套 API。以下是完整的可运行代码:
from datetime import datetime

# 1. 获取当前系统时间(datetime 对象)
now = datetime.now()

# 2. 将时间对象格式化为指定的年月日时分秒字符串
time_str = now.strftime('%Y-%m-%d %H:%M:%S')

print(time_str)在这个过程中,变量 now 是一个 datetime.datetime 类的实例,保存了当前的年、月、日、时、分、秒及微秒数值;而 strftime 是“string format time”(字符串格式化时间)的缩写,它根据传入的格式指令将时间对象各个字段解析并拼接为纯文本字符串。
二、关键执行步骤拆解
从操作系统底层时间到最终业务字符串,Python 内部经历了三个主要阶段。理解这个流转过程有助于排查格式化错误与时区偏差:
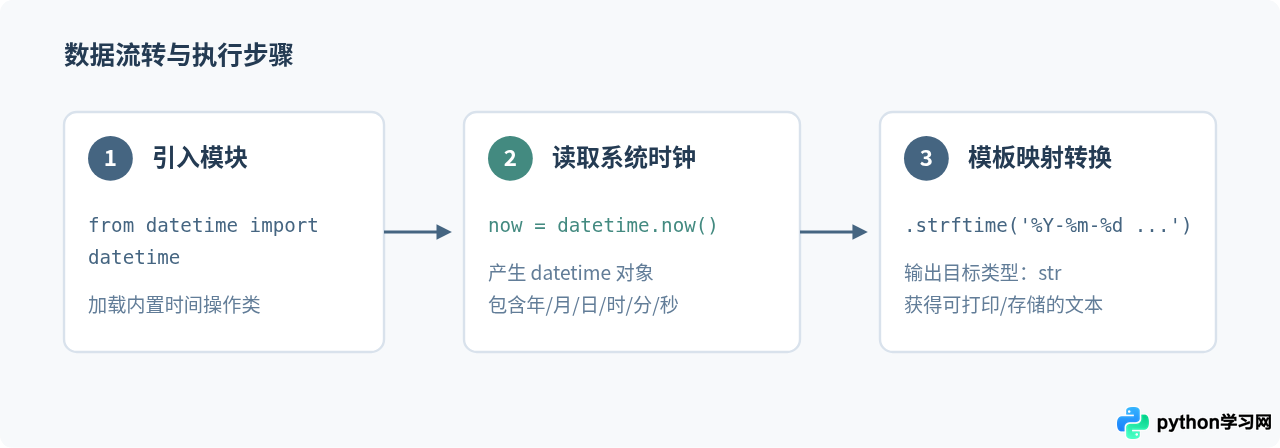
- 引入类定义:注意导入语句是
from datetime import datetime。datetime模块内包含一个同名的类datetime。如果写成import datetime,后续必须使用datetime.datetime.now()调用。 - 获取本地瞬时:
datetime.now()读取当前操作系统的本地时钟。它默认返回一个不包含时区信息(Naive)的时间对象。 - 执行占位符替换:
strftime扫描传入的字符串模板,将以%开头的占位符转换为具体数字,非占位符部分(如-、:和空格)原样保留。
三、占位符语法与时间分量对照
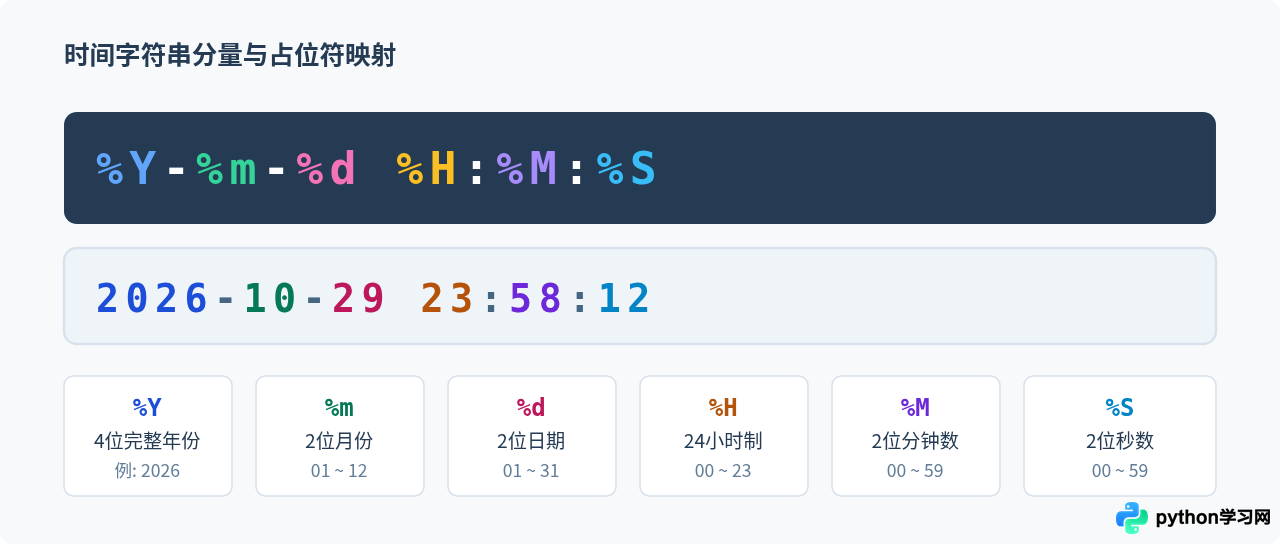
在 '%Y-%m-%d %H:%M:%S' 中,每一个字母代表不同层级的时间维度。大小写严格敏感,一旦写错字母大小写,得到的结果完全不同:
| 占位符 | 含义说明 | 数值范围 / 示例 | 特别说明与常见误区 |
|---|---|---|---|
%Y |
四位完整年份 | 2026 | 大写 Y。若使用小写 %y 则只输出后两位(例如 26)。 |
%m |
月份(前导补零) | 01 ~ 12 | 小写 m。千万不要写成大写 %M(大写代表分钟)。 |
%d |
日期(前导补零) | 01 ~ 31 | 小写 d。若为单数字会自动补 0(如 9 日显示为 09)。 |
%H |
小时(24小时制) | 00 ~ 23 | 大写 H。如果需要 12 小时制请使用 %I。 |
%M |
分钟(前导补零) | 00 ~ 59 | 大写 M。必须与小写 %m(月份)区分开。 |
%S |
秒数(前导补零) | 00 ~ 59 | 大写 S。在润秒时可能出现 60。 |
%f |
微秒数(6位数字) | 000000 ~ 999999 | 用于毫秒/微秒高精度记录场景。 |
四、实际业务中的常见格式需求
除标准 YYYY-MM-DD HH:mm:ss 形式外,实际开发中常遇到中文展示、日志文件名、高精度毫秒记录等不同需求:
1. 输出中文“年月日时分秒”与跨平台兼容写法
很多初学者会直接编写 now.strftime('%Y年%m月%d日 %H时%M分%S秒')。在 macOS 或 Linux 系统上这段代码可以正常运行,但在 Windows 平台上会直接抛出异常:UnicodeEncodeError: 'locale' codec can't encode character...。这是因为底层 C 运行时库在解析中文字符作为格式控制参数时发生了编码冲突。
推荐采用以下两种既安全又优雅的跨平台写法:
# 推荐方案 A:利用 Python 3.6+ 的 f-string 语法(简洁推荐)
chinese_time = f"{now:%Y}年{now:%m}月{now:%d}日 {now:%H}时{now:%M}分{now:%S}秒"

# 推荐方案 B:先生成占位符再通过 .format 替换
chinese_time_b = now.strftime('%Y{y}%m{m}%d{d} %H{h}%M{i}%S{s}').format(
    y='年', m='月', d='日', h='时', i='分', s='秒'
)

print(chinese_time)2. 文件名或数据归档的安全格式(无空格无冒号)
在创建日志文件、备份压缩包或导出 Excel 时,文件名中不能包含冒号(:,在 Windows 下为非法字符)以及空格。通常使用下划线连接年月日与时分秒:
# 文件命名常用格式:年月日_时分秒
filename_time = now.strftime('%Y%m%d_%H%M%S')
file_name = f"backup_{filename_time}.tar.gz"

print(file_name)3. 包含毫秒或微秒的高精度时间戳
在接口日志记录或性能追踪时,通常需要精确到毫秒:
# %f 输出 6 位微秒,切片截取前 3 位即为毫秒
millisecond_time = now.strftime('%Y-%m-%d %H:%M:%S.%f')[:-3]

print(millisecond_time)五、时区意识:Naive(无时区)与 Aware(时区感知)
直接调用 datetime.now() 获取的时间是“无时区(Naive)”的,它仅仅读取了宿主操作系统的本地时刻。在单机脚本中这通常没有问题,但在分布式系统、Docker 容器或与数据库交互时,容器的默认时区可能是 UTC(零时区),从而导致输出的时间比北京时间(UTC+8)慢 8 小时。
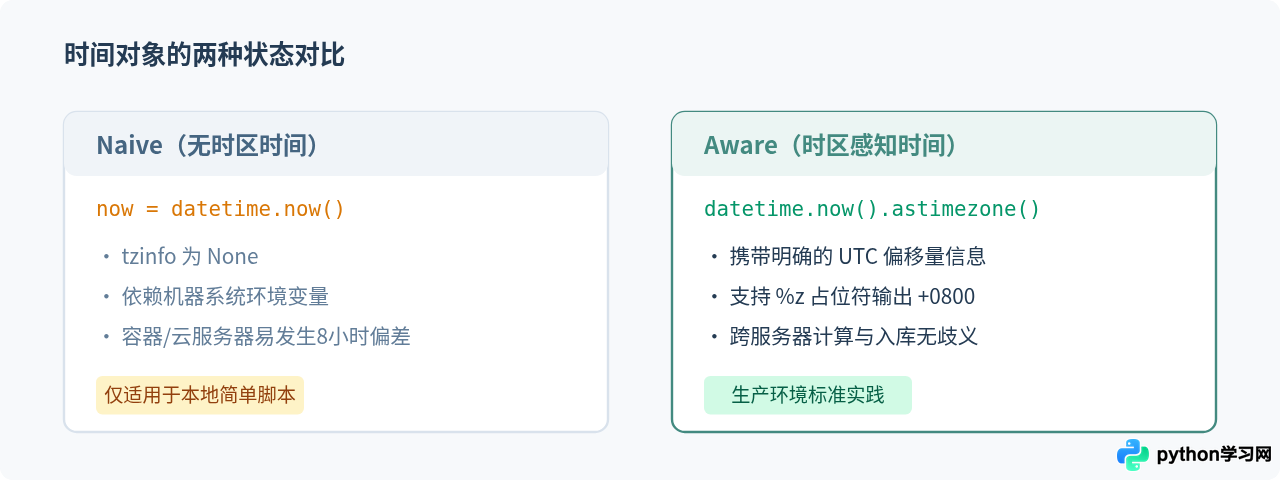
在生产级代码中,建议明确时区。例如通过 astimezone() 附加当前本地时区,或结合 %z 指令打印时区偏移:
from datetime import datetime

# 获取带有时区感知(Aware)的当前时间
aware_now = datetime.now().astimezone()

# 格式化输出包含时区偏移(例如 +0800)
time_with_tz = aware_now.strftime('%Y-%m-%d %H:%M:%S %z')

print(time_with_tz)六、避坑要点与知识速查
总结开发者在格式化时间时最常踩的几类陷阱,供随时查对:
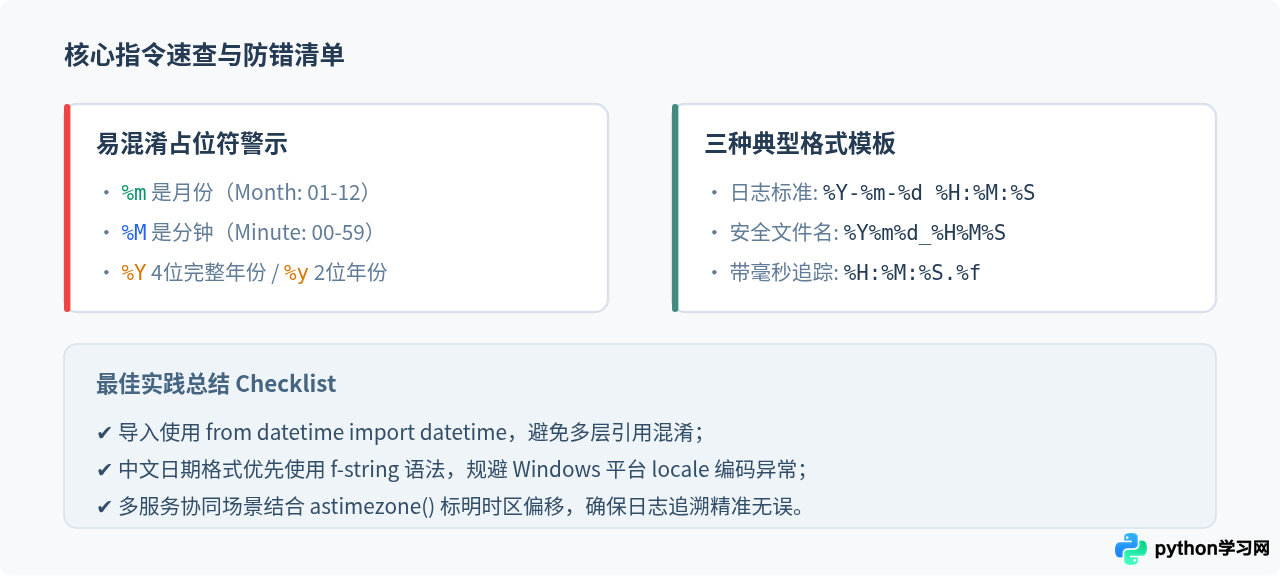
%Y 是四年(完整年),小写的 %m 属于月份(Month),大写的 %M 代表分钟(Minute),大写的 %H 为 24 小时制。按照 now.strftime('%Y-%m-%d %H:%M:%S') 书写即可满足绝大多数日常开发需求。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









